
変更履歴
- 2026-10-17:公開
- 2026-10-17:文言修正
- 2026-10-18:2本目へのリンク追加
- 2026-10-24:文言微修正
- 2026-11-08:文言修正・説明の追加
初めに
これから仕事で AgentCore(AWS のエージェント基盤)に触れる機会がある。ドキュメントを開いても機能が 13 個並んでいて、どれが何を受け持つのか分からない。そこで、まずは自分で動かしてみることにした。
量が多いので 2 本に分けた。この 1 本目では、エージェントが動くところにかかわる機能を動かした。残りの機能は 2 本目 で書いた。
結論
検証用の AWS アカウントにエージェントを 2 つ作り、次の 4 項目をそれぞれ動かして試した。結果は以下。
- Runtime(エージェントを動かす環境):会話(セッション)ごとに、別の環境に分かれるか → 分かれた。別の会話からは、置いたファイルが見えなかった。同じ会話でも、何もしないまま設定した 120 秒を過ぎると(今回は 3 分待った)環境が作り直され、ファイルは消えた
- Memory(会話の記憶):記憶は、利用者(呼ぶときに
--actor-idで渡した名前。今回は alice と bob)ごとに分かれるか → 分かれた。会話から好みや事実が 1〜2 分で取り出されて、利用者ごとの置き場に残った。次の会話の返事は、それぞれの好みに沿っていた(どのメモリレコードを引いたかまでは見ていない) - Code Interpreter(コードの実行)・Browser(ブラウザの操作):インターネットに出られるか → 今回の構成で 1 回試した範囲では、Code Interpreter はつながらないと返した。Browser は出られた
- Observability(観測):何も設定しなくても、エージェントの動きが見えるか → 見えた。今回の CLI(0.31.1)でデプロイしただけで、トレース(処理の記録)を検索できるようにする CloudWatch の設定(Transaction Search)まで有効になった
今回試していて特に気になったのは、モデルの返事と実際の動きがずれていたこと。覚えておけないと答えた好みは Memory に残っていて、モデルが「再度試します」と書いた Browser の操作は、やり直されていなかった。本当に動いたかは、返事からは分からず、Memory の中身とトレースを見て分かった。
本記事の構成
- AgentCore の全体像
- 検証の構成
- Runtime(実行環境)のセッションの隔離
- Memory(記憶)の利用者ごとの分離
- Code Interpreter・Browser からインターネットへの通信
- Observability(観測)の初期設定
- Bedrock Agents(Classic)との違い
- 費用
1. AgentCore の全体像
まずは、機能どうしのつながりを整理した。
ここでいうエージェントは、モデルの返事を受けて、必要ならツールを呼び、その結果をもとに次にすることを決めるプログラム。AgentCore は、エージェントを作って動かし、運用するための AWS の基盤。サーバーなどのインフラは自分で管理しない。
以下は、この記事を読みやすくするための自分の整理。AgentCore が受け持つのは、エージェントを動かす実行環境と、その周りの機能(記憶・ツール・認証・観測など)。エージェントを実際に動かすときに要るものを、AWS 側でそろえている。
エージェントの中身の書き方は縛らない。エージェントを書くためのライブラリ(フレームワーク。Strands Agents・LangGraph・CrewAI など)も、使うモデルも、自分で選べる。今回は Strands Agents と、Bedrock のモデル(Nova 2 Lite)を使った。
大きな流れは、次のとおり。利用者やアプリからリクエストが来ると、Runtime が会話ごとに環境を立ててエージェントを動かす。エージェントはモデルで考え、必要に応じて Memory に残した内容を引き、Code Interpreter や Browser をツールとして使う。図にすると以下。
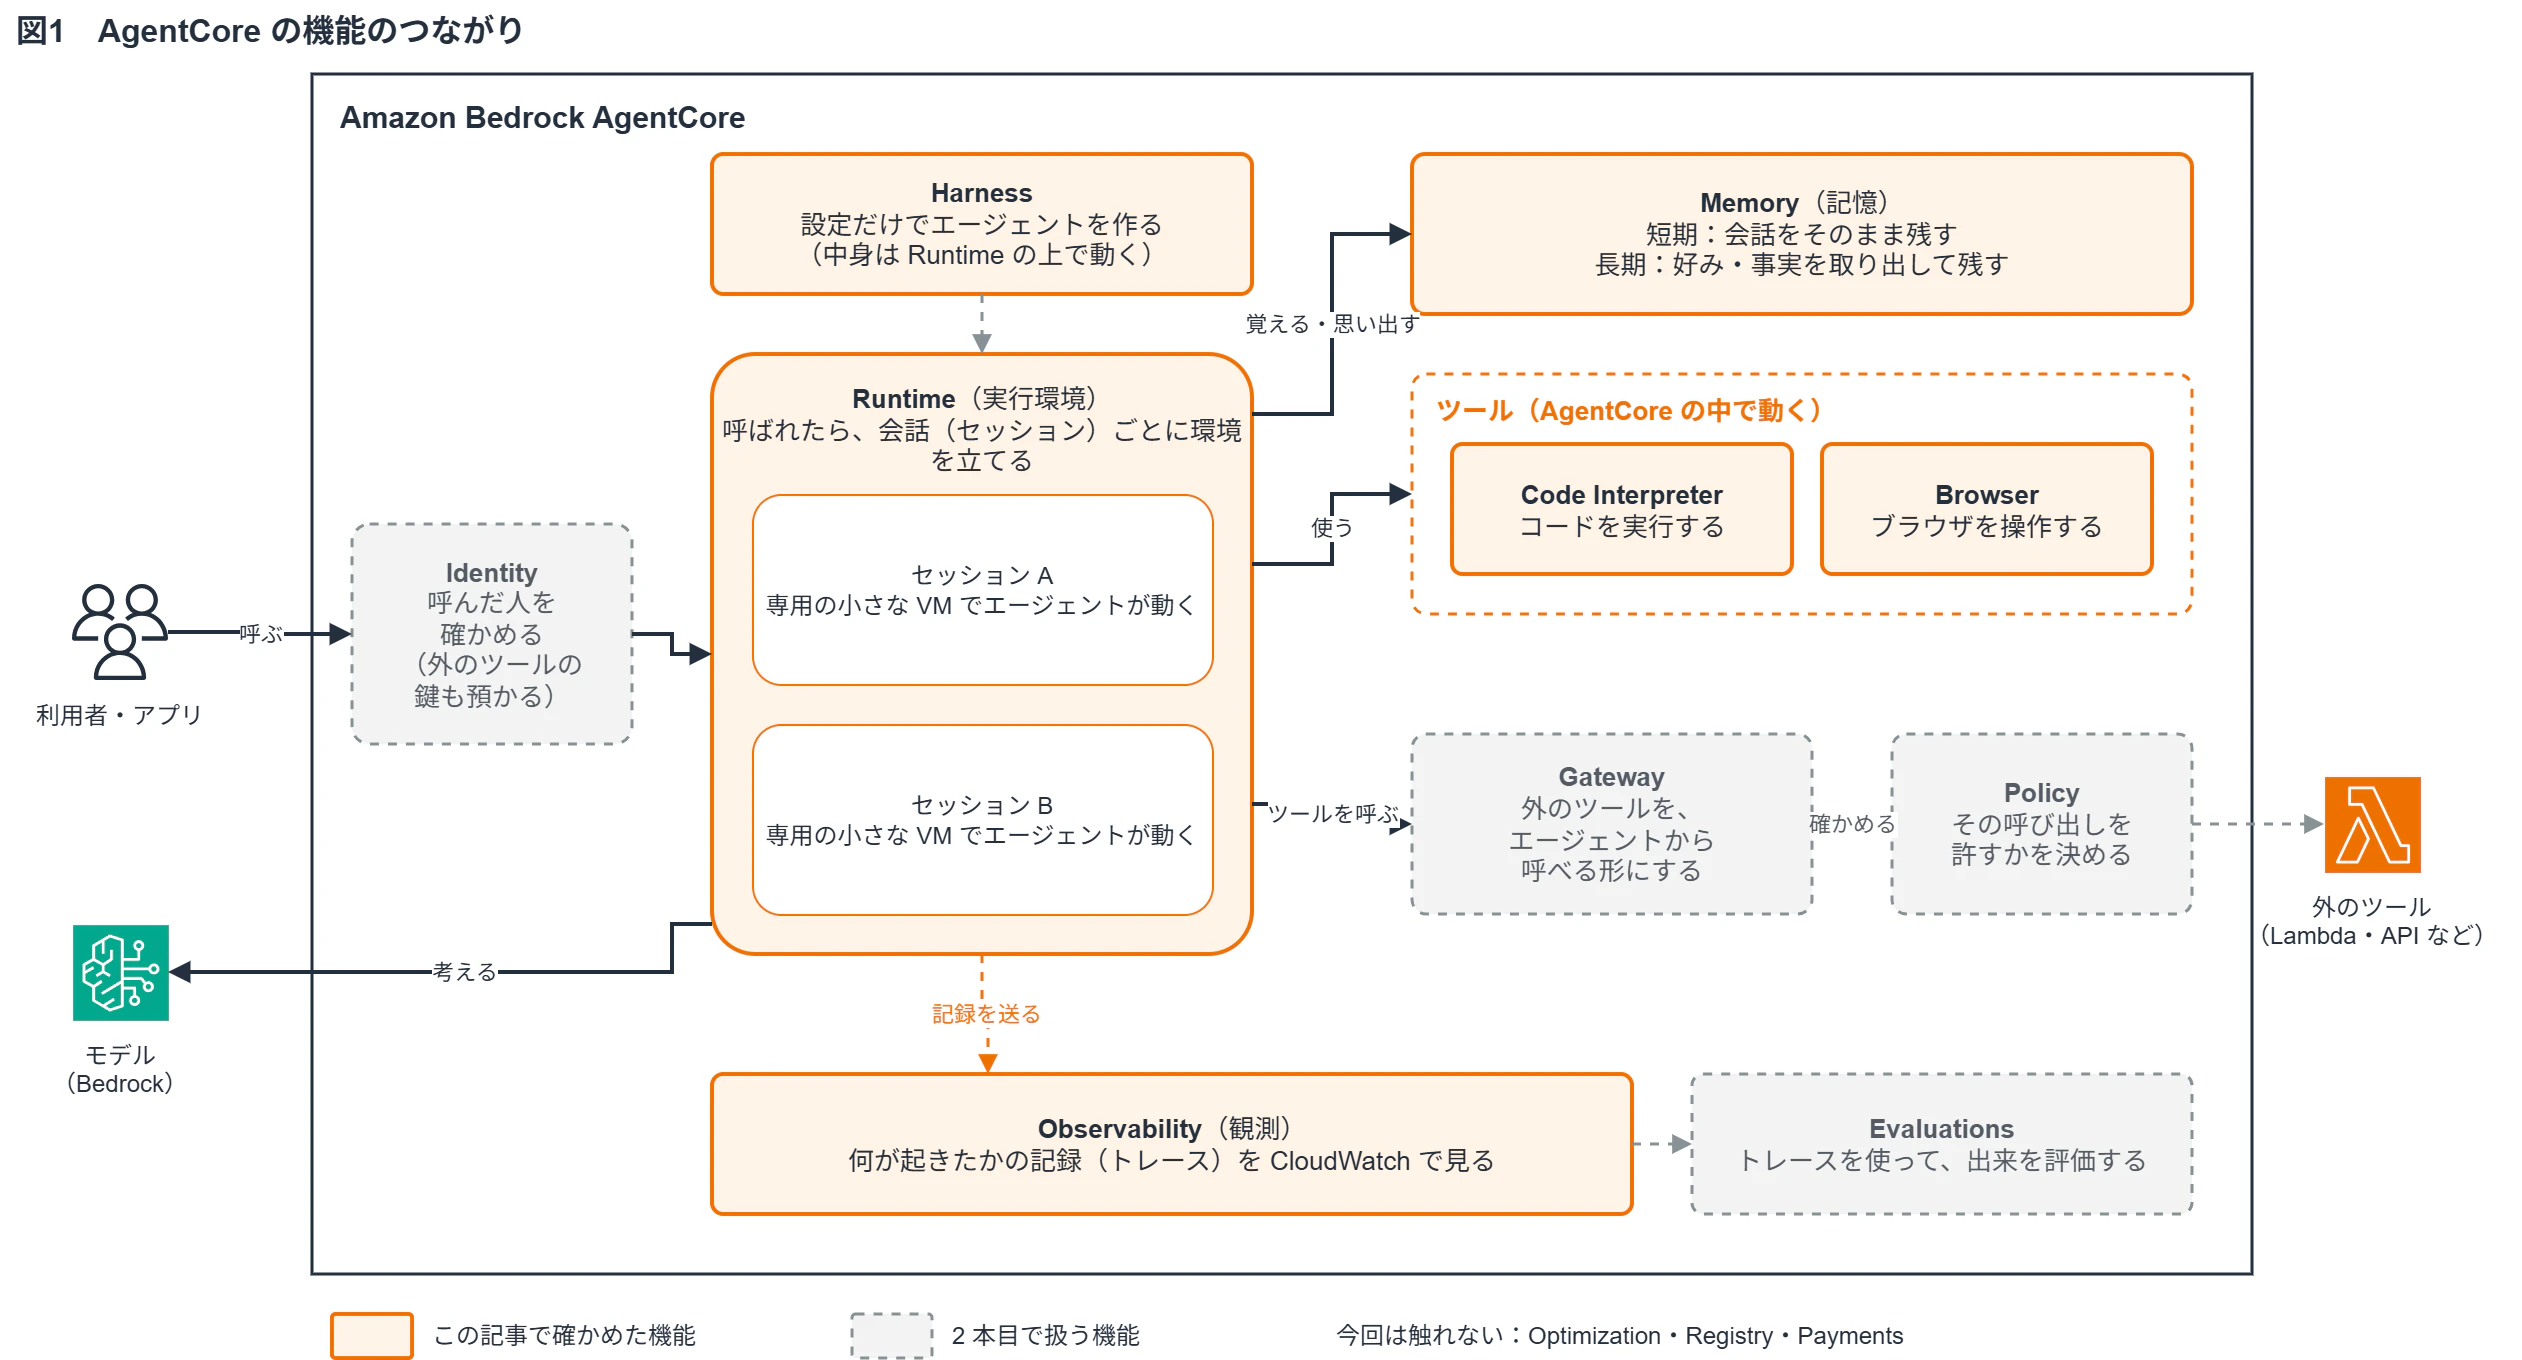
この流れの周りに、残りの機能がある。Identity を設定していれば、呼ばれたときにまず呼んだ人を確かめる。外のツールを Gateway でつないでいれば、ツールの呼び出しは Gateway を通り、Gateway に Policy を付けていれば、その呼び出しを許すかを Policy が決める。どれも使うときに設定するもので、今回の Code Interpreter と Browser は Gateway を通していない。動いた記録は Observability に集まり、Evaluations はその記録を使って出来を評価する。
この 1 本目で扱うのは、図のオレンジの 6 つ。結論で挙げた 4 項目(Code Interpreter と Browser は 5 章でまとめて見る)と、エージェントを作るのに使ったハーネス。
| 機能 | 何をしてくれるか | この記事で見たこと |
|---|---|---|
| Harness(ハーネス) | 使うモデル・ツール・Memory を設定に書くだけで、エージェントが動く。「考える → ツールを使う → 答える」の繰り返しは AgentCore が回す | 2 章で作り、4・5 章で使う |
| Runtime(実行環境) | エージェントのプログラムを置く場所。呼ばれたときだけ、会話(セッション)ごとに専用の小さな VM を立てて動かす | 3 章:会話ごとに環境が分かれるか |
| Memory(記憶) | 会話をそのまま残す短期の「イベント」と、そこから好みや事実を抜き出して残す長期の「メモリレコード」の 2 段 | 4 章:利用者ごとに分かれるか |
| Code Interpreter(コードの実行) | エージェントが書いたコードを、隔離された環境で実行する | 5 章:外のサイトに出られるか |
| Browser(ブラウザの操作) | クラウドにあるブラウザを、エージェントが操作する(ページを開いて読む) | 5 章:同上 |
| Observability(観測) | エージェントが何をしたか(呼び出し・かかった時間・トークン〈モデルが読み書きした量の単位〉)を CloudWatch で見られるようにする | 6 章:何もしなくても見えるか |
ハーネスは設定だけでエージェントを作れるが、今回はそれとは別に、自分でコードを書いたエージェントも作った。2 つの違いと、2 つにした理由は 2 章で書く。
この記事で使う機能は、どれも東京リージョンで使える(2026-10-17、公式のリージョン対応表で確認)。
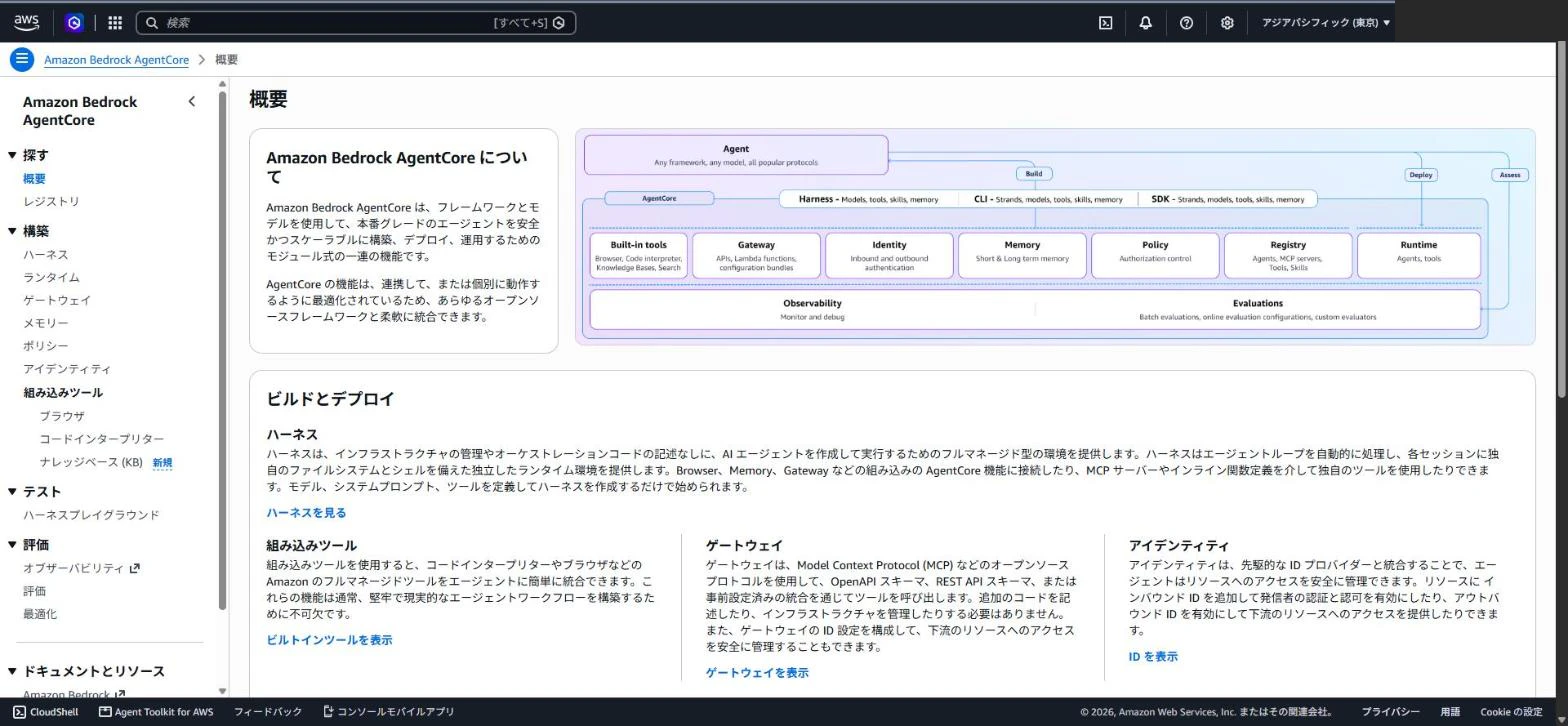
コンソールのトップの画面は以下。左のメニューに機能が並ぶ。
2. 検証の構成
今回の検証では、2 種類のエージェントを用意した。ハーネスで作る labagent と、自分でコードを書く codeagent。このあとの実験は、どれもこの 2 つのどちらかで行った(Runtime は codeagent、Memory とツールは labagent、Observability は両方)。分けた理由は 2 つある。
- 設定だけで作るハーネスでは、中で動くプログラムに手を入れられない。Runtime の隔離の実験では、環境の中身(起動した時刻や置いたファイル)をエージェント自身に答えさせたいので、自分でコードを書いたエージェントが要る
- 仕事で使うなら、ハーネスとコードのどちらで作るかも選ぶことになる。選ぶには、何が違うのかを知りたい。同じ問いを両方に投げて、トレースの大きさ(スパンの数)を Observability の実験で比べる
2 つの違いは、エージェントの中の繰り返しの処理を誰が回すか。エージェントは質問を受け取ると、モデルが考え、必要ならツールを呼び、その結果をモデルに戻し、最後に答える。この「考える → ツールを使う → 答える」の繰り返しを、ここではループと呼ぶ。
-
labagent:ハーネス。設定だけで作り、ループは AgentCore が回す。中身は Strands Agents1。ツールに Code Interpreter と Browser を付け、Memory を付けて長期のメモリレコードも取り出す設定にした。Memory とツールの実験で使う -
codeagent:コード。同じ Strands Agents を Python で書く。ループは、自分のプログラムの中の Strands のエージェントが回す。隔離を見るための命令(/whoamiなど)を持たせた。Runtime の隔離の実験で使う
どちらも同じ Runtime の上で動く。
どちらのエージェントも、作るのは 1 回。会話(セッション)は、呼ぶたびに --session-id で指定する。1 つのエージェントで、会話はいくつでも持てる。誰の会話かは --actor-id で指定する。デプロイしたあと、呼ぶときは次のように書く。
agentcore invoke --harness labagent --session-id <セッション ID> --actor-id alice "私に合うおやつを 1 つ勧めて"
--harness には呼ぶハーネスの名前を書く(コードのエージェントなら --runtime codeagent)。alice は呼ぶ側が決めた利用者の名前で、Memory はこの名前ごとに分かれる。Memory を分けるための名前で、呼んだ人が本人かは確かめない(本人の確認は 2 本目の Identity で見た)。
条件は以下。
- リージョン:東京(ap-northeast-1)
- 日付:2026-10-17
- CLI:
@aws/agentcore0.31.1 - モデル:Amazon Nova 2 Lite(
jp.amazon.nova-2-lite-v1:0)。東京ではクロスリージョン推論2のプロファイル名で指定する
作るのには、AgentCore の CLI(@aws/agentcore)を使った。今回は 2 つのエージェントを同じ条件で並べたい。CLI なら 1 つのプロジェクトにまとめて作れて、設定もファイルとして手元に残る。
CLI のプロジェクトは、設定ファイル(agentcore/agentcore.json)と、それを AWS に作るための CDK(AWS の構成をコードで書く仕組み)の一式でできている。add で設定を足していき、最後の deploy でまとめて AWS に作る流れ。
CLI を使うには、Node.js 20 以降・Python 3.10 以降・uv が要る。CLI は npm install -g @aws/agentcore で入れる。
ここからは、実際に作ったときの手順。プロジェクトを作り、ハーネスとそのツール、コードのエージェントの順に足して、最後にデプロイした。各行の意味はコメントに書いた。
# 1. プロジェクトの雛形だけを作る(エージェントは後から足すので --no-agent)
agentcore create --project-name QiitaAgentLab --no-agent
cd QiitaAgentLab

# 2. ハーネス labagent を足す。Memory を付け、メモリレコードの取り出し方(戦略)を 3 つ付ける(戦略は Memory の実験で説明する)
#    --memory-event-expiry-days 7:会話をそのまま残したイベントは 7 日で消える
agentcore add harness --name labagent --memory-mode managed --memory-strategies SEMANTIC,SUMMARIZATION,USER_PREFERENCE --memory-event-expiry-days 7

# 3. labagent にツールを 2 つ付ける(Code Interpreter と Browser)
agentcore add tool --harness labagent --type agentcore_code_interpreter --name code-interpreter
agentcore add tool --harness labagent --type agentcore_browser --name browser

# 4. コードのエージェント codeagent を足す
#    --build CodeZip:コードを ZIP にして置く(コンテナのイメージは作らない)
#    --memory none:Memory は付けない(隔離の実験を、Memory が邪魔しないように)
#    --idle-timeout 120:何もしないまま 120 秒たつとセッションを終える(既定は 15 分。隔離の実験を短く回すため)
agentcore add agent --name codeagent --type create --build CodeZip --language Python --framework Strands --model-provider Bedrock --memory none --idle-timeout 120

# 5. デプロイ先とモデルを、設定ファイルに書く(下で説明)

# 6. ここまでの設定を、CDK で AWS にまとめて作る
agentcore deploy
5 で書くのは次の 2 つのファイル。
agentcore/aws-targets.json には、デプロイ先(アカウントとリージョン)を書く。
[
  { "name": "default", "account": "<アカウント ID>", "region": "ap-northeast-1" }
]
name はデプロイ先の名前で、deploy は何も指定しなければ default を使う。
app/labagent/harness.json はハーネスの設定で、modelId に使うモデルを書く。add harness で作った時点の値は global.anthropic.claude-sonnet-4-6(Claude Sonnet 4.6)だった。今回は検証なので、安い Nova 2 Lite に変えた(該当の行だけを示す)。
- "modelId": "global.anthropic.claude-sonnet-4-6"
+ "modelId": "jp.amazon.nova-2-lite-v1:0"
6 の deploy は 4 分ほどで終わった。
1 つハマった。実は、検証用のアカウントは作業の前日に作ったばかりだった。そのアカウントでモデルを呼ぶと、Your account is currently being verified(アカウントを確認中)で断られた。メッセージには「通常 2 時間以内に終わる。過ぎても続くなら、書かれた窓口にメールで連絡を」とある。今回は待つだけで、最初に断られてから 1 時間半ほどで呼べるようになっていた。
新しいアカウントは、AWS の確認が済むまで Bedrock のモデルを呼べない。検証用にアカウントを新しく作るなら、作った日のうちにモデルを 1 回呼んで確かめておくと安心。
3. Runtime(実行環境)のセッションの隔離
Runtime でまず気になったのが、セッション(会話)の隔離。もし同じ実行環境を共有しているなら、ある利用者の会話で作ったファイルや途中の結果が、別の利用者の会話から見えてしまう。
公式の説明では、セッションごとに専用の microVM3 が割り当てられ、計算・メモリ・ファイルは別になる。何もしないまま一定の時間がたつと、そのセッションは終わる。この時間は既定で 15 分、60 秒から設定でき、今回の codeagent は 2 章で 120 秒にした。
説明どおりに分かれるのかを、実際にファイルを書いて試した。見たのは次の 2 つ。
- 別のセッションから、ファイルが見えないか
- 同じセッションで、120 秒を過ぎるまで何もしなかったら、ファイルは残るか
隔離を見るだけなら、モデルを呼ぶ必要はない。そこで codeagent に、モデルを呼ばずにプログラムが直接答える命令を 3 つ持たせた(/whoami・/write・/read)。隔離の実験にモデルの費用をかけないため。
codeagent の本体のプログラム(main.py)は、Runtime から呼ばれるたびに invoke を実行する。invoke は利用者の文を受け取り、Strands のエージェント(agent)に渡して、返事を返す。Bedrock のモデルを呼ぶのは、この agent の中。2 章の「ループは、自分のプログラムの中の Strands のエージェントが回す」のエージェントは、この agent のこと。
agentcore add agent で作った雛形の main.py は、MCP のクライアント・セッションごとのエージェントのキャッシュ・ストリーミングを持つ形だった。今回は、それを次の形の main.py に置き換えた(全文は下の折りたたみ)。
3 つの命令は、agent に渡す手前に割り込ませた。/ で始まる命令にはプログラムが答え、それ以外の文はそのまま agent に渡る。Runtime から呼ばれる関数(エントリポイント)の invoke は以下。
@app.entrypoint
def invoke(payload, context):
    text = payload.get("prompt")
    if not isinstance(text, str) or not text.strip():
        return "Error: 'prompt' must be a non-empty string"
    text = text.strip()

    reply = handle_command(text, context.session_id)
    if reply is not None:
        return reply

    result = agent(text)
    return result.message["content"][0]["text"]
handle_command が返事を返したら(/ で始まる命令なら)、そこで答えて終わる。それ以外の文は agent(text) でエージェントに渡し、モデルの返事の文を返す。
割り込ませた命令は以下。
def handle_command(text, session_id):
    if text == "/whoami":
        return (
            f"session_id={session_id} host={socket.gethostname()} "
            f"started_at_utc={STARTED_AT} pid={os.getpid()}"
        )
    if text.startswith("/write "):
        with open(NOTE_PATH, "w", encoding="utf-8") as f:
            f.write(text[len("/write "):])
        return f"wrote {NOTE_PATH}"
    if text == "/read":
        if not os.path.exists(NOTE_PATH):
            return f"{NOTE_PATH} は無い"
        with open(NOTE_PATH, encoding="utf-8") as f:
            return f"{NOTE_PATH}: {f.read()}"
    return None
/whoami は、セッション ID・ホスト名(host)・プログラムが起動した時刻(STARTED_AT)・プロセスの番号(pid)を返す。環境が別なら、プログラムもそれぞれで起動するので、起動時刻が違う。起動時刻は、環境が作り直されたかを見る手がかりで、ファイルの見え方と合わせて判断した。ホスト名は、どの環境でも localhost だった。
/write と /read は、環境の中のファイル(/tmp/note.txt)に書いて読む。セッション ID は、invoke の引数 context の session_id で受け取れる。
main.py の全文(命令を足した版)
# Qiita_AgentCore 1 本目の検証用:コードで書くエージェント(Runtime の中身を確かめる)
#
# 置き場:agentcore add agent で作られた app/codeagent/main.py を、このファイルで置き換える。
# 確かめたいこと:
#   - セッションごとに microVM が分かれるか(同じセッションならファイルが残り、別なら見えない)
#   - アイドルの上限を過ぎると、同じセッション ID でも新しい microVM になるか
#   - ハーネスと比べて、トレースに何が出るか
#
# 「/」で始まる命令はモデルを呼ばずに答える(費用をかけずに隔離を確かめるため)。
#   /whoami        このセッションの ID・ホスト名・プロセスが起動した時刻
#   /write <文>    /tmp/note.txt に書く
#   /read          /tmp/note.txt を読む
# それ以外の文は、Strands のエージェント(モデル)に渡す。
#
# 出典(2026-10-17 確認):
#   https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/observability-get-started.html
#   https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/runtime-troubleshooting.html(context.session_id)

import os
import socket
import time

from bedrock_agentcore.runtime import BedrockAgentCoreApp
from strands import Agent
from strands.models import BedrockModel

MODEL_ID = "jp.amazon.nova-2-lite-v1:0"

NOTE_PATH = "/tmp/note.txt"
STARTED_AT = time.strftime("%Y-%m-%d %H:%M:%S", time.gmtime())

app = BedrockAgentCoreApp()

agent = Agent(
    model=BedrockModel(model_id=MODEL_ID),
    system_prompt="あなたは AWS の検証用アシスタントです。日本語で簡潔に答えます。",
)

def handle_command(text, session_id):
    if text == "/whoami":
        return (
            f"session_id={session_id} host={socket.gethostname()} "
            f"started_at_utc={STARTED_AT} pid={os.getpid()}"
        )
    if text.startswith("/write "):
        with open(NOTE_PATH, "w", encoding="utf-8") as f:
            f.write(text[len("/write "):])
        return f"wrote {NOTE_PATH}"
    if text == "/read":
        if not os.path.exists(NOTE_PATH):
            return f"{NOTE_PATH} は無い"
        with open(NOTE_PATH, encoding="utf-8") as f:
            return f"{NOTE_PATH}: {f.read()}"
    return None

@app.entrypoint
def invoke(payload, context):
    text = payload.get("prompt")
    if not isinstance(text, str) or not text.strip():
        return "Error: 'prompt' must be a non-empty string"
    text = text.strip()

    reply = handle_command(text, context.session_id)
    if reply is not None:
        return reply

    result = agent(text)
    return result.message["content"][0]["text"]

if __name__ == "__main__":
    app.run()
これを 2 つのセッション(A と B)から順に送った。送った順と結果は以下の通り。時刻は UTC。
| 順 | セッション | 送った文 | 結果 |
|---|---|---|---|
| 1 | A | /whoami |
起動時刻 03:22:43 |
| 2 | A | /write セッションAのメモ |
wrote /tmp/note.txt |
| 3 | A | /read |
/tmp/note.txt: セッションAのメモ |
| 4 | B | /whoami |
起動時刻 03:23:17 |
| 5 | B | /read |
/tmp/note.txt は無い |
| 6 | A | 3 分(120 秒を過ぎるまで)待ってから /read と /whoami
|
/tmp/note.txt は無い・起動時刻 03:26:42 |
A の中ではファイルが残り、B からは見えなかった。起動時刻も A と B で違い、別の環境で動いていた。
3 分待ったあとの A では、ファイルが消えて起動時刻が変わった。120 秒何もしなかったので A のセッションは終わり、同じセッション ID で呼んだときに新しい環境が立ち上がった。同じセッション ID でも、中身は別物になる。なので、時間をおいて続く会話の途中の結果を、環境の中のファイルに置いておくことはできない。残したいものは、Memory(4 章)や S3 のような、環境の外の置き場に置く必要がある。
送ってから返事が来るまでは、新しい環境での最初の 1 回が 14〜15 秒、同じセッションの 2 回目からが 9〜11 秒だった。どちらも手元の CLI が起動する時間を含む。14〜15 秒は、新しい環境が立ち上がった 3 回(A と B の最初と、3 分待ったあとの A)の範囲。最初の 1 回だけ数秒長いのは、環境を新しく立ち上げる分だと見ている。推測で、今回の測り方では CLI の起動時間と切り分けていない。
ランタイムの一覧の画面は以下。
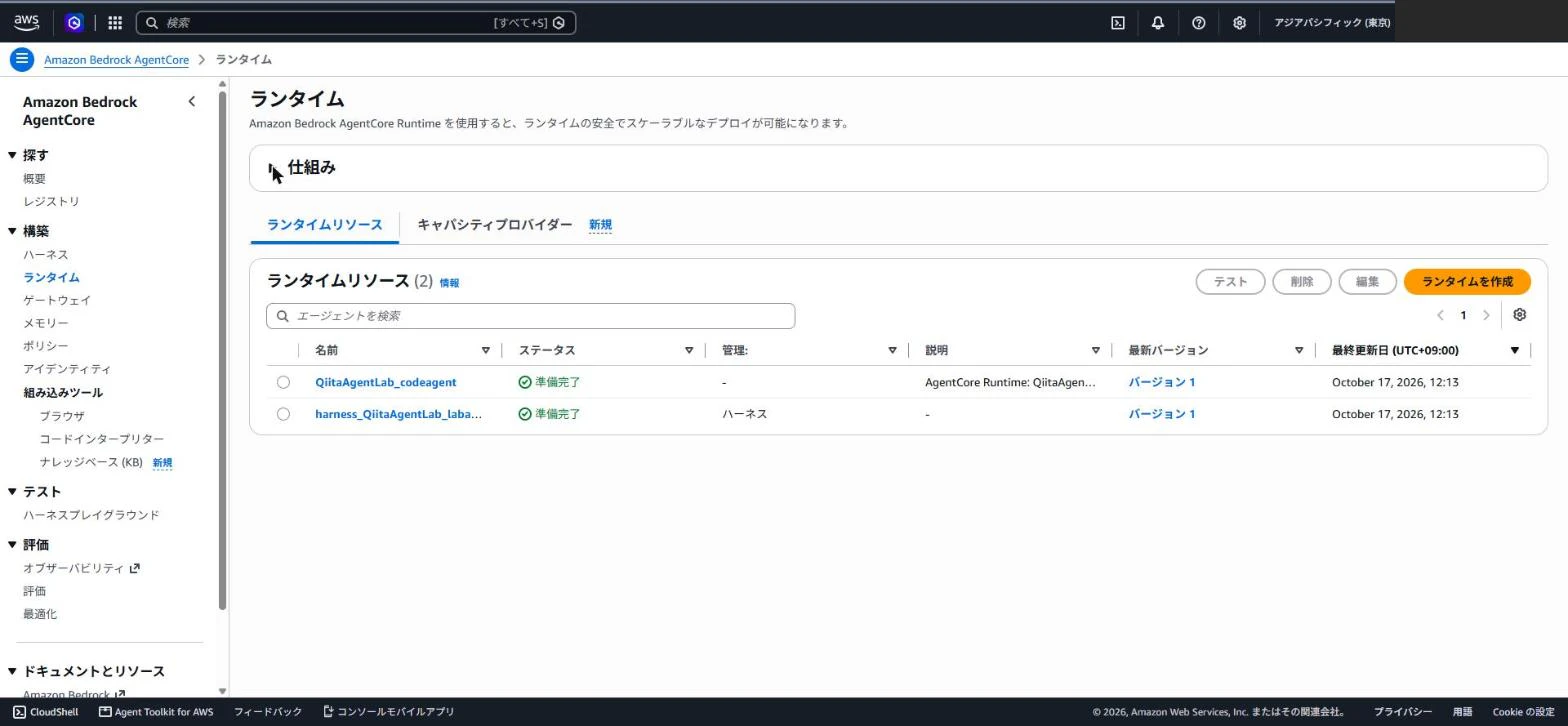
ハーネスの labagent も、harness_ で始まる名前でランタイムの一覧に並んだ。管理の列は「ハーネス」。
codeagent の詳細の画面は以下。
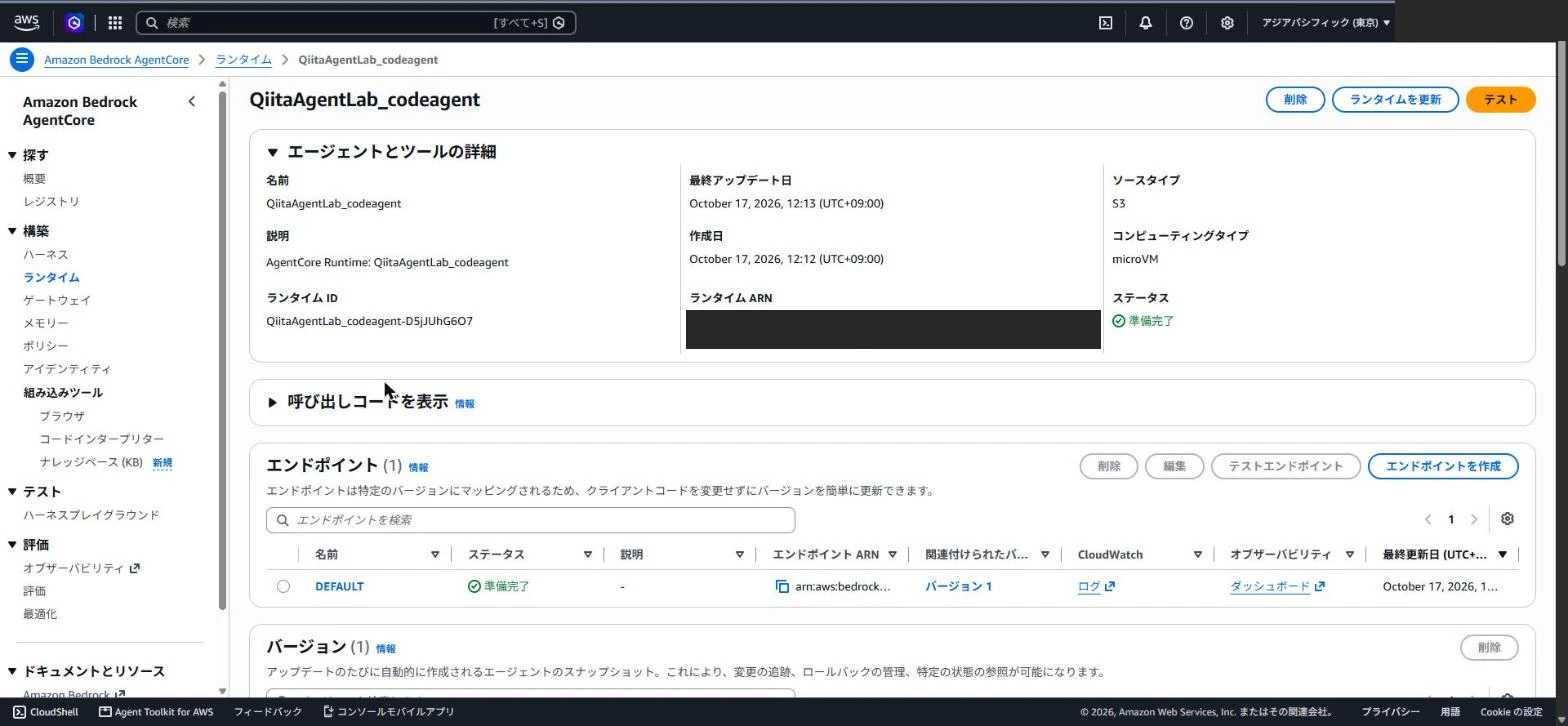
コンピューティングタイプは microVM で、章の冒頭に書いた公式の説明と合う。ソースタイプは S3 だった。
4. Memory(記憶)の利用者ごとの分離
Memory では、利用者ごとの記憶がどう分かれるかを見た。ここでの利用者は、呼ぶときに --actor-id で渡した名前(今回は alice と bob)。分かれていないと、ある人が話した好みや個人の事情が、別の人への返事に混ざってしまう。たとえば、ある人が話した「甘いものが苦手」が、別の人へのおすすめに使われたら困る。
Memory に残るものは 2 段ある。どちらも 1 つの Memory の中に、形の違うデータとして入る。
- 短期の「イベント」:会話をそのまま残したもの。今回は 7 日で消える設定にした(2 章の
--memory-event-expiry-days 7) - 長期の「メモリレコード」:イベントから好みや事実を取り出したもの。イベントとは別に残り、意味の近さで検索して引く
今回見るのは、会話をまたいで使われるメモリレコードのほう。イベントからメモリレコードをどう取り出すかは「戦略」で選ぶ。今回は SEMANTIC(事実)・SUMMARIZATION(要約)・USER_PREFERENCE(好み)の 3 つを有効にした。このうち中身を比べたのは、事実と好みの 2 つ。
Memory の中身は、利用者(actorId)とセッションの組で分けて保存される。ハーネスなら、呼ぶときに --actor-id で利用者を指定できる。
なお、Memory はハーネスごとに持たせ方を選ぶ。ハーネスが自分専用の Memory を作って持つ「管理メモリ」、別に作った Memory を付ける方法(複数のハーネスで共有できる)、Memory を持たない方法の 3 つ。CLI でハーネスを作ったときの既定は、CLI リファレンスとハーネスのメモリの頁では「持たない」とされている(移行ガイドの別の箇所には「持つ」とあり、食い違う)。今回は 2 章のコマンドの --memory-mode managed で管理メモリにした。
これを、alice と bob の 2 人分で試した。次の順に送った。4 と 5 は新しいセッションにした。同じ会話のイベントが使えない状態で、メモリレコードが使われるかを見るため。
- alice(セッション S1):「甘いものが苦手で、辛いものが好き。覚えておいて」
- bob(S2):「コーヒーが好きで、毎朝飲む。覚えておいて」
- メモリレコードが入るのを待つ
- alice(新しいセッション S3):「私に合うおやつを 1 つ勧めて」
- bob(新しいセッション S4):「私に合うおやつを 1 つ勧めて」
1 を送ったとき、モデルは「私は対話内容を覚えておくことができません」と答えた。2 の bob には、覚えたと答えた。返事が食い違ったので、メモリレコードのほうを確かめた。
メモリレコードは、会話のあとに裏で(非同期で)取り出される。なので、送った直後にはまだ無い。メモリレコードの件数を CLI で 30 秒おきに数えると、alice は送ってから 1 分半ほどで、bob は 2 分ほどで入っていた。
Memory の詳細の画面(長期メモリ戦略の欄)は以下。
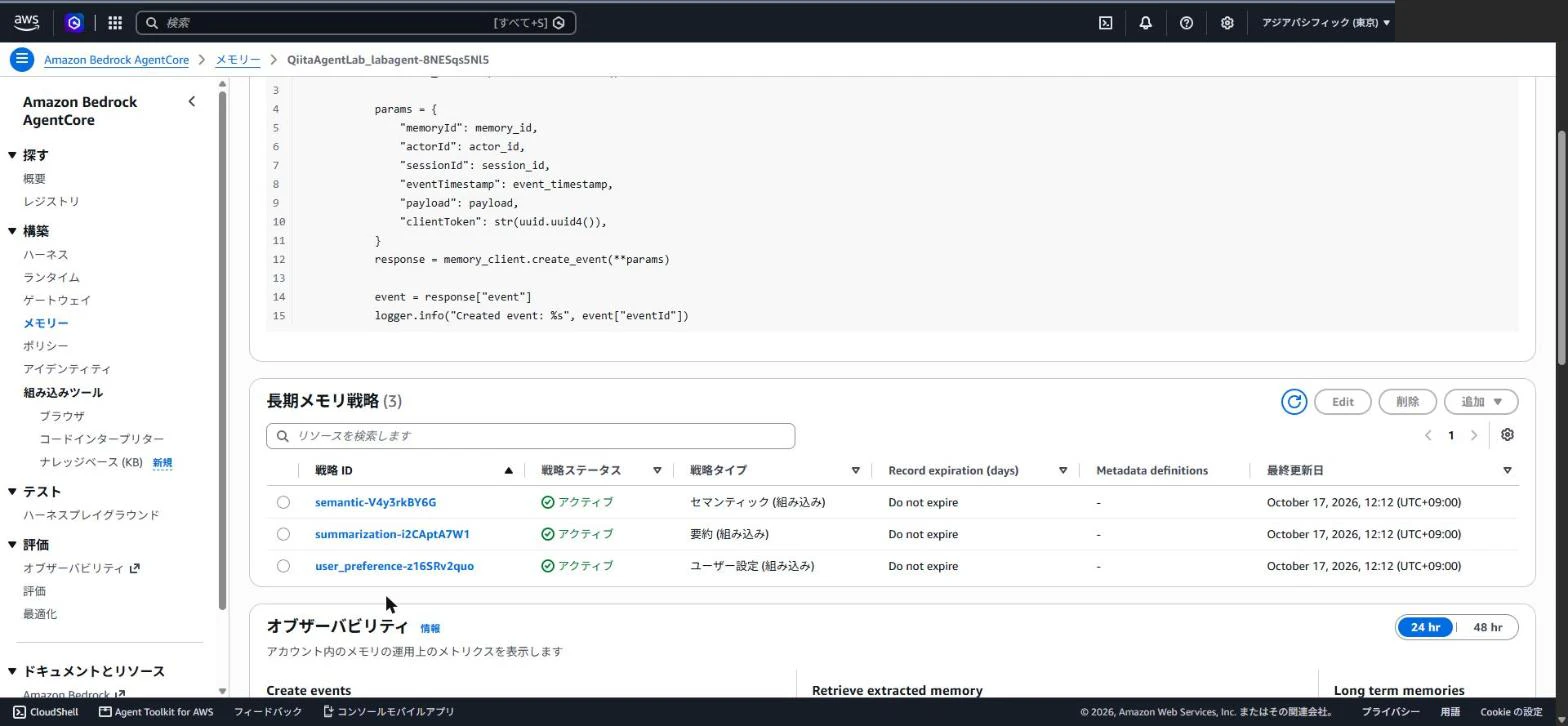
戦略が 3 つ(セマンティック・要約・ユーザー設定)並び、メモリレコードの期限(Record expiration)はどれも「Do not expire」。7 日で消えるのはイベントのほうで、メモリレコードには期限が付いていない。
メモリレコードの中身は CLI で読める(aws bedrock-agentcore list-memory-records)。出力を整理すると以下。
/actors/alice/preferences/ → {"context":"食べ物や料理の選択","preference":"甘いものが苦手で、辛いものが好き。","categories":["食べ物","味の好み","辛い料理"]}
/actors/alice/facts/       → 「ユーザーは甘いものが苦手で、辛いものが好き。」「ユーザーは辛い食べ物を好む。」
/actors/bob/preferences/   → {"context":"毎朝の飲み物を選ぶとき","preference":"コーヒーが好きで、毎朝飲む","categories":["コーヒー","飲み物","朝のルーティン"]}
/actors/bob/facts/         → 「ユーザーはコーヒーが好きで、毎朝飲む習慣がある。」
置き場所(名前空間)は、SEMANTIC が /actors/{actorId}/facts/、USER_PREFERENCE が /actors/{actorId}/preferences/、SUMMARIZATION が /actors/{actorId}/summaries/{sessionId}/。利用者ごとに分かれている。同じ 1 文から、事実は文で、好みは場面と分類の付いた JSON で、別々に取り出された。
「覚えておくことができません」と答えた alice の好みも、メモリレコードに入っていた。モデルが何と答えても、会話はイベントとしてそのまま残り、裏で好みや事実が取り出される。覚えるかどうかを決めているのは、ハーネスに付けた Memory の設定のほうだった。モデルの返事と、Memory に実際に残ったものは一致していなかった。
新しいセッションで 4 と 5 を送った結果は以下。
- alice:「辛うま肉みそマヨネーズおにぎり」を勧め、甘さを感じない点を理由に挙げた
- bob:「モカチーノクッキー」を勧め、「コーヒーとよく合う」と書いた
bob への返事に、alice の好みは出てこなかった。ただし、それぞれの会話でどのメモリレコードを引いたかは見ていない。
5. Code Interpreter・Browser からインターネットへの通信
エージェントにツールを渡すなら、そのツールからどこまで外(インターネット)に通信できるかは、セキュリティの設計として確認しておきたい。ツールを持ったエージェントは、モデルの判断で外のサイトにつなぎに行ける。外に出られるツールなら、手元のデータを外へ送ってしまうこともできる。
そこで、ツールを 2 つ付けた labagent に、計算・外のサイトの取得・ページの閲覧の 3 問を送った。どのツールを使うかは、モデルが決める。どちらのツールも、呼ばれるとツールの側にセッションが作られ、既定では 15 分で切れる。
送った文と結果は以下の通り。
| 送った文 | 見たかったこと | 結果 |
|---|---|---|
| 「1 から 100 までの素数の合計を、Python で計算して答えて」 | Code Interpreter が実際にコードを書いて動かすか(正しければ 1060) | 1060(コードを実行したかは、トレースでは確かめていない) |
| 「Python の urllib で https://aws.amazon.com/jp/ を取得して、HTTP の状態コードを答えて。コードを実行して確かめて」 | Code Interpreter は外に出られるか | つながらないと返した |
| 「https://aws.amazon.com/jp/ を開いて、ページの見出しを 3 つ教えて」 | Browser なら外に出られるか | 出られた(1 回目は失敗) |
Code Interpreter のネットワークには、S3 などの AWS のサービスにだけ出られる「Sandbox」、インターネットに出られる「Public」、VPC につなぐ「VPC」がある。ハーネスに付けたのは、AgentCore が用意している組み込みの Code Interpreter(2 章の --type agentcore_code_interpreter)。これがどちらで動くかは、文書に書いていなかった。既定は「いちばん制限の強い設定」とだけある。2 問目は、どちらで動いているかを見るために入れた。
2 問目は、15 秒ほどで「コード実行環境から aws.amazon.com にリーチできない」と返ってきた。今回の構成で 1 回試した範囲では、組み込みの Code Interpreter はインターネットに出られない設定で動いていると見てよさそう。
3 問目は 1 回目で失敗した。Browser を使うとき、モデルはツールを呼ぶ中で Browser のセッションに名前を付ける。その名前に _ を入れてしまい、使えない文字だと返された。モデルは「有効な名前に変更し、再度試します」と書いたが、やり直さずにそのまま返事を終えた。
新しいセッションで同じ文を送ると、今度は開けた。ただ、返ってきた見出しは「Cookie の設定を選択する」「Cookie の設定をカスタマイズする」「Essential」だった。読んだのは、ページの手前に出た Cookie の同意のダイアログだった。外に出られることは分かったが、ページの本文の見出しは取れなかった。
今回の結果は、組み込みの Code Interpreter がインターネットに出られない設定で動いていたときのもの。
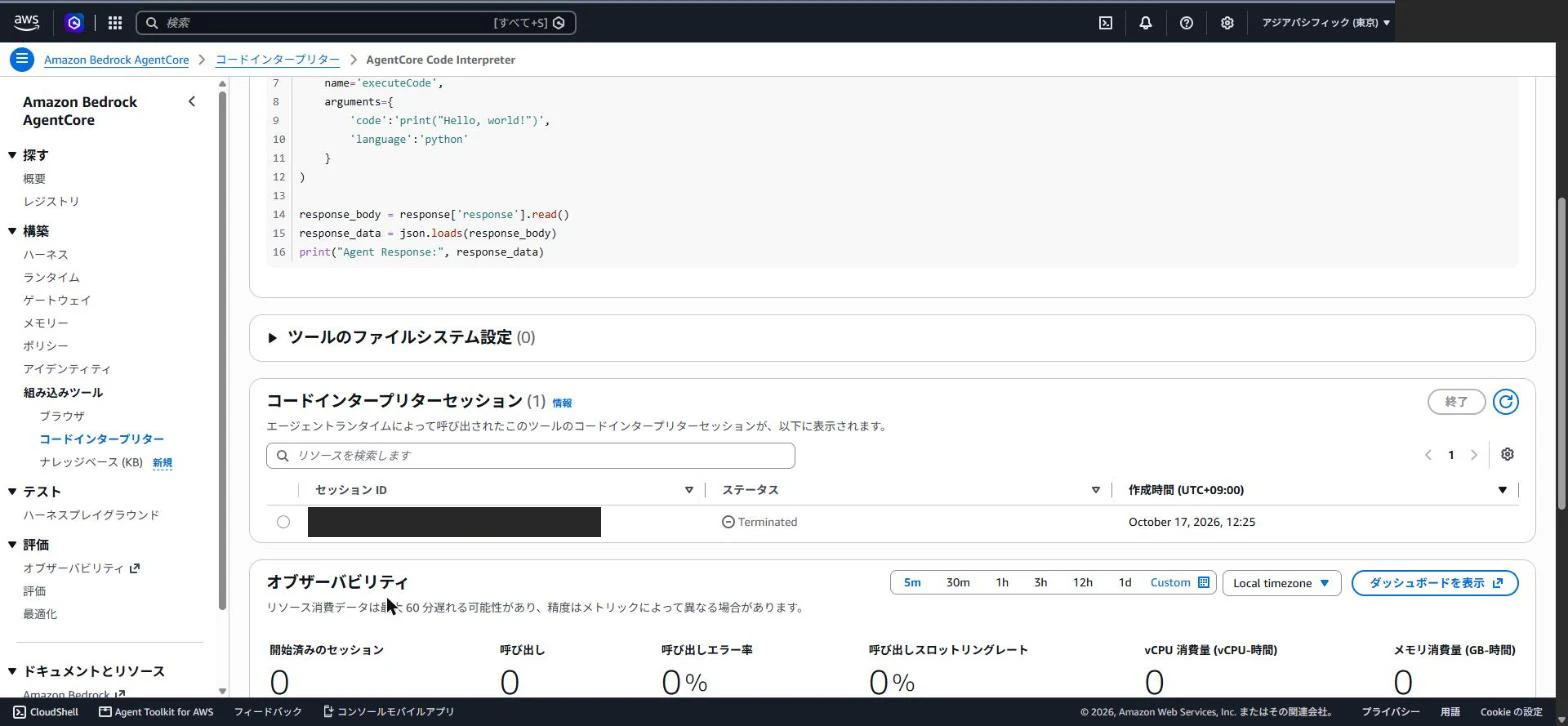
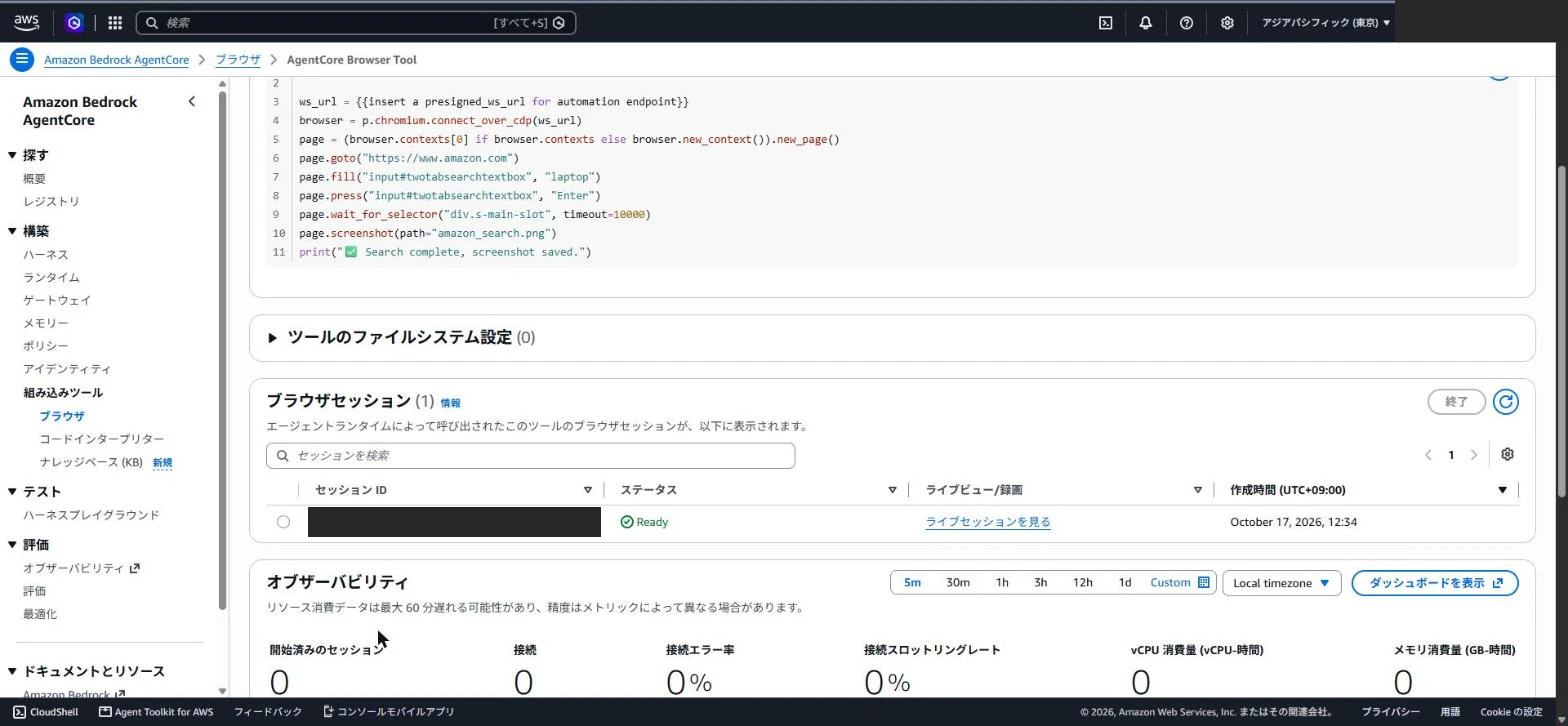
3 問目の 2 回目を送ってから 13 分ほどたって、コンソールでツールのセッションを見た。Code Interpreter のセッションは「Terminated」で、Browser のセッションは「Ready」のまま残っていた。この時点では、Browser のセッションが作られてから、既定の 15 分はまだたっていない。Code Interpreter のセッションは 1・2 問目で先に作られていて、いつ終わったかは見ていない。
1・2 問目で使われた Code Interpreter のセッションの画面は以下。
Browser のセッションの画面は以下。
「ライブセッションを見る」を開くと、リモートのブラウザが aws.amazon.com/jp/ を表示したまま残っていた。その画面は以下。
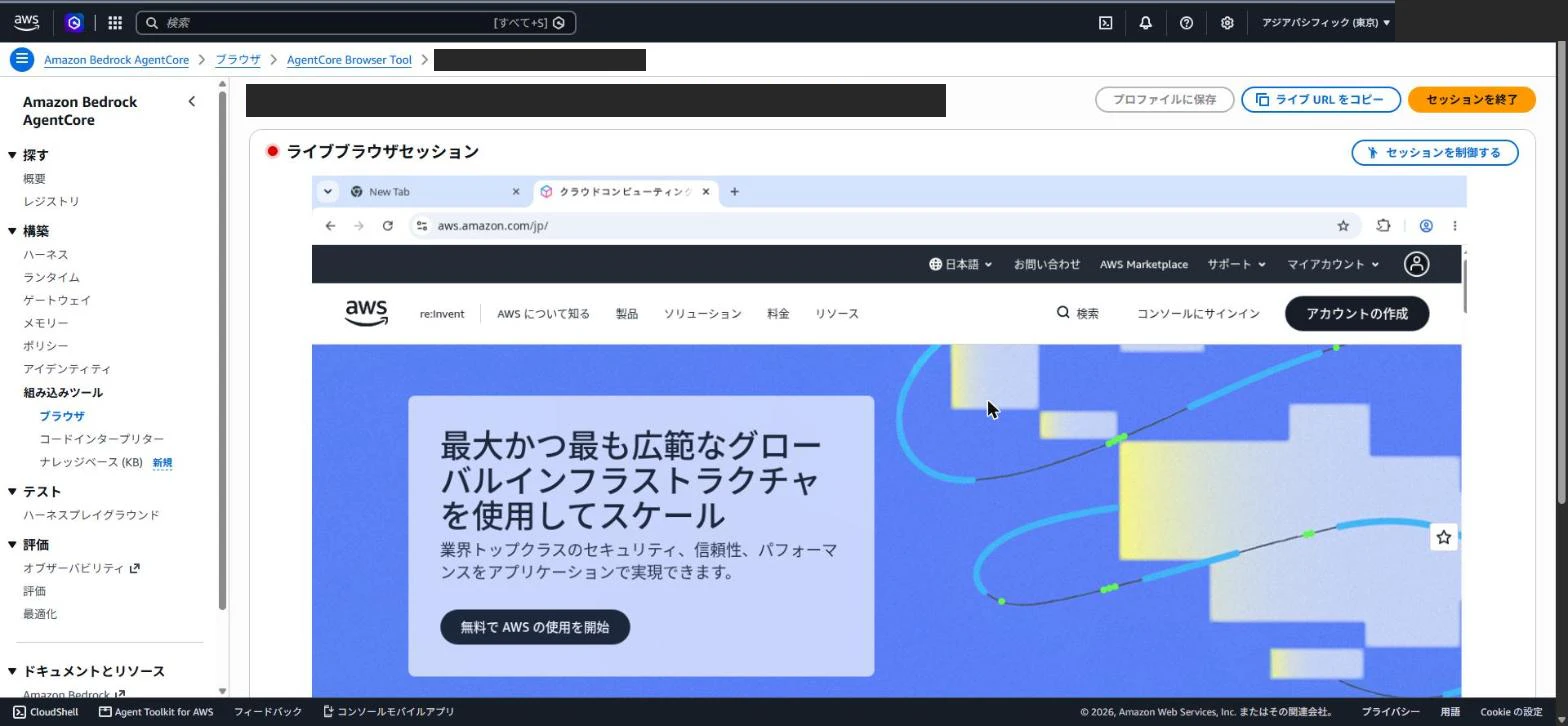
Browser は、セッションの間に使った CPU とメモリの量で、秒単位に課金される。待っている間の CPU はかからないが、メモリの分はかかる。エージェントが開いたまま返事を終えると、セッションは残り、既定の 15 分が過ぎるまでその分が続く。
6. Observability(観測)の初期設定
エージェントは 1 回の質問の中で、モデルやツールを何回も呼ぶ。最後の返事だけを見ても、裏で何が動いたかは分からない。障害を調べるときや挙動を見るときは、処理の記録(トレース)が要る。そこで、デプロイした時点でどこまでトレースが取れるのかを見た。
トレースは、1 回の呼び出し全体で何が起きたかの記録。その中の 1 つ 1 つの処理(モデルを呼ぶ、ツールを使う、など)をスパンと呼ぶ。
トレースを見るには、CloudWatch の Transaction Search4 が有効になっている必要がある。設定はアカウントのそのリージョン全体にかかり、追加の料金がかかることがある。
ここは文書同士が食い違っていた。AWS の開発者ガイドは、アカウントの管理者が 1 回有効にする前提で書いている。CLI の GitHub の文書は「初回のデプロイで自動で有効にする」と書いている。なので、デプロイの前後で状態を見た。見るのは、X-Ray(AWS のトレースを集めて見るサービス)のトレースの送り先を返す次のコマンド。
aws xray get-trace-segment-destination --region ap-northeast-1
"Destination": "CloudWatchLogs" で "Status": "ACTIVE" なら有効。
デプロイの前は "Destination": "XRay" で、有効になっていなかった。デプロイの最後に Note: Transaction search enabled. と出て、直後は "CloudWatchLogs"・"PENDING"、22 分後に見たときは "ACTIVE" だった。Transaction Search を有効にする設定は、自分では何も追加していない。デプロイの出力と前後の状態を見るかぎり、この点は CLI の GitHub の文書のほうが正しかった。
Runtime・Memory・Code Interpreter・Browser の詳細画面には、どれも「トレース:有効になっていません」と出る。この表示のままでも、トレースは CloudWatch に届き、CloudWatch のエージェント向けの画面「GenAI Observability」で見えた。この表示が何の設定を指すかは確かめていない。
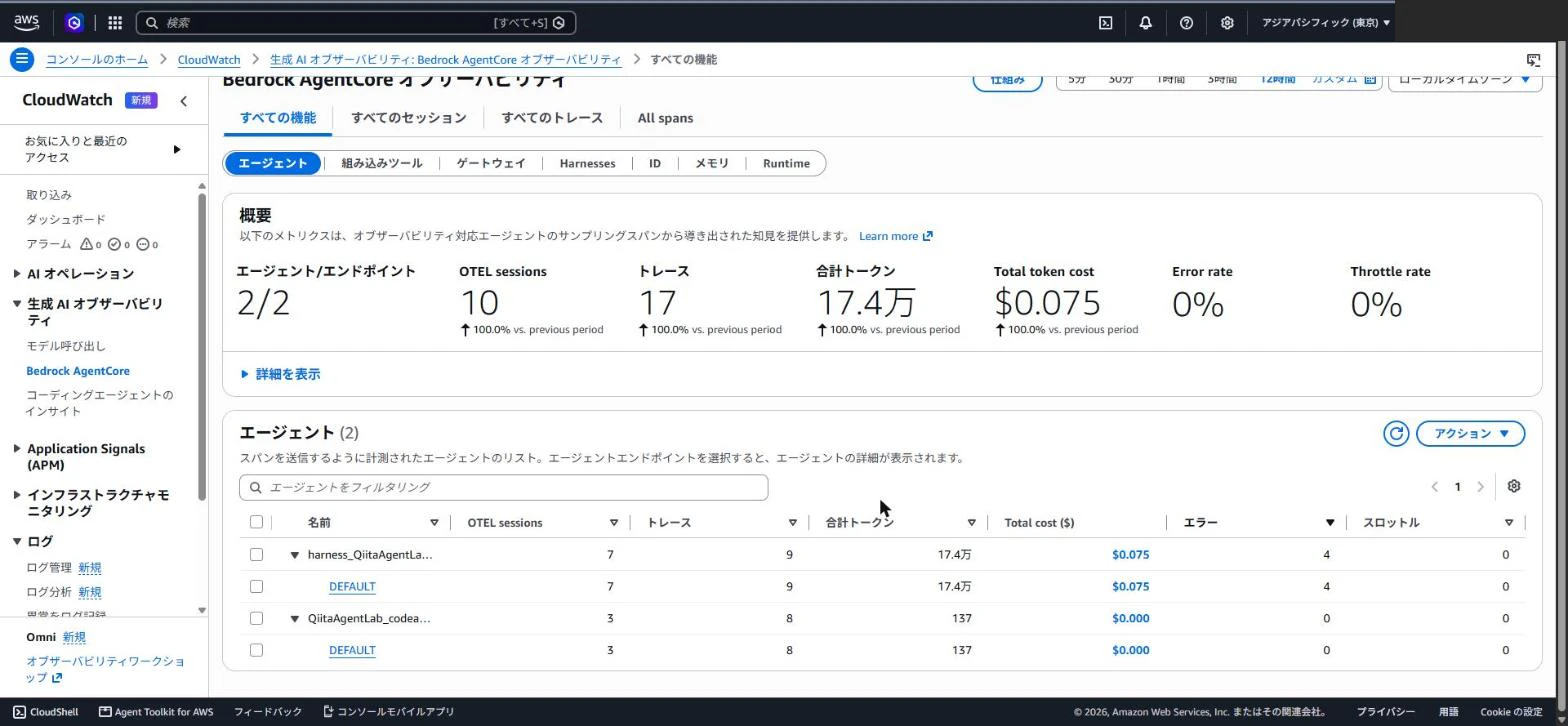
GenAI Observability には、エージェントごとの呼び出し回数・時間・トークンと、トレースの一覧が出る。同じ問い「AgentCore の Runtime とは何か、2 文で説明して」を 2 つのエージェントに送り、トレースを並べた。
GenAI Observability のエージェントの一覧の画面は以下。
同じ問いのトレース 2 本(コードとハーネス)を並べた画面は以下。
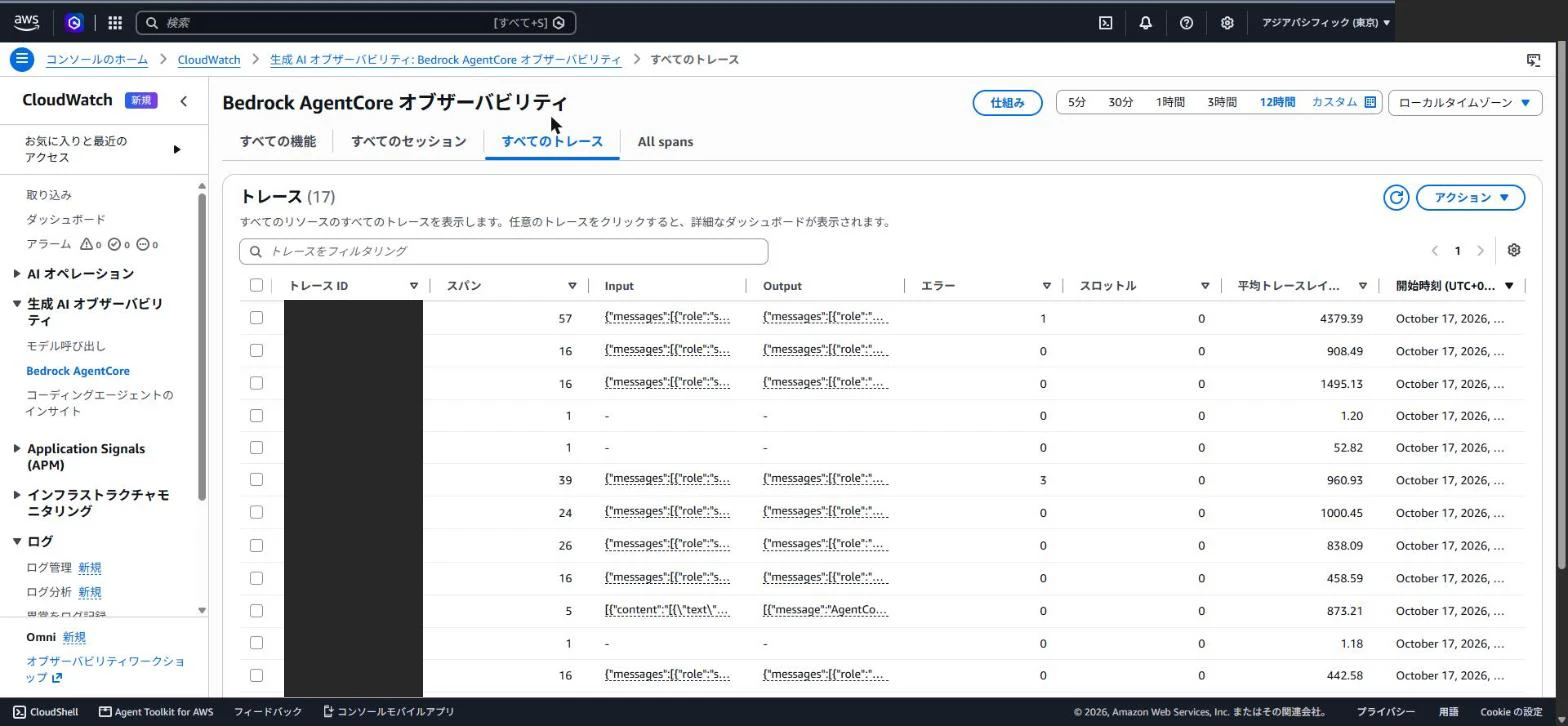
同じ問いのトレースは、コードの codeagent が 5 スパン、ハーネスの labagent が 16 スパンだった。labagent には Memory とツールが付いているので、同じ条件で比べたものではない。Browser を使った回(5 章の 3 問目の 2 回目)は 57 スパンになった。
ハーネスのほうが多い理由は、スパンの中身を 1 つずつ比べていないので、今回の検証では分からない。ハーネスは Memory を付けていて、ループも AgentCore の側で回すので、その分の処理がスパンとして出ていると見ている。ここは推測。
コードのエージェントのトレースも、追加の設定なしで出た。トレースを送るためのライブラリ(aws-opentelemetry-distro)が、agentcore add agent で作った雛形の依存に最初から入っていたため。
7. Bedrock Agents(Classic)との違い
Bedrock には、AgentCore より前から Bedrock Agents というエージェントの仕組みがある。名前が似ていて混同しやすく、すでに使っている人はどう違うかが気になるところなので、ここで整理しておく。
従来の Bedrock Agents は「Bedrock Agents Classic」に名前が変わった。2026-07-30 から、過去 12 か月に使った実績のないアカウントでは新しく作れない(CreateAgent が 403 を返す)。使っている人はそのまま使えるが、新しい機能は足されない。
公式の移行ガイドの対応は以下。
| Bedrock Agents Classic | AgentCore |
|---|---|
| 管理されたオーケストレーション | ハーネス |
| アクショングループ | Gateway を通した MCP5 のツール |
| ナレッジベースへの直結 | Gateway を通すか、検索のツール |
| コードインタープリター | Code Interpreter |
| セッションとメモリ | Memory(短期と長期) |
| 制御の返却(return of control) | ハーネスの inline function |
管理されたオーケストレーションは、Classic が質問からツールの呼び出し、答えまでの流れを回す仕組み。アクショングループは、Classic のエージェントが呼べる操作(Lambda などで実装する)のまとまり。inline function は、モデルが呼んだツールを、呼んだ側のアプリに返して実行させる形で、Classic の制御の返却に当たる。
段階ごとのプロンプトの上書き(前処理・後処理など)は、ハーネスでは直接は再現できない。凝った作りにしていたなら、コードで書いて Runtime に載せ直すことになる。
8. 費用
モデルの料金は、推定で約 0.075 USD(17.4 万トークン)。この検証で送った問いの分の合計で、図A9 の直近 12 時間の集計に出た額。トークン数から出した推定で、請求で確定した額とは別。入力と出力のトークンの内訳は控えていない。ほぼ全部がハーネスの分で、codeagent は 3 章の命令がモデルを呼ばないので、ほとんどかかっていない。
Cost Explorer で見た、検証した日(2026-10-17)の検証用のアカウントの額は 0.30 USD。サービスごとの内訳は見ていない。モデル以外の分も含む、アカウント全体の 1 日の額である。
料金の仕組みは、2026-10-17 に料金ページで見た時点のもの(料金は変わることがある)。Runtime そのものは CPU とメモリの秒単位の課金で、I/O 待ちの CPU は課金されない。エージェントの時間の多くはモデルの返事待ちなので、この課金の仕方はありがたい。
最後に
いちばん印象に残ったのは、モデルの返事と AgentCore の実際の状態がずれていたこと(4 章の Memory、5 章の Browser)。
動かしてみると、見るところはモデルの外に多かった。インフラの側から見ても、セッションの隔離(3 章)、ツールから外への通信(5 章)、ログとトレース(6 章)と、確認しておきたいところがいくつもある。エージェントを仕事で使うなら、動いたかどうかを Memory の中身やトレースで確かめる前提で組むことになりそう。
2 本目では、Gateway で Lambda をツールにつなぎ、Identity・Policy・Evaluations も同じように動かして確認した(記事)。
参考(2026-10-17 確認)
- What is Amazon Bedrock AgentCore?
- AgentCore のリージョン対応
- CLI で始める・CLI リファレンス
- Harness・Harness と Runtime の違い・Harness のツール・Harness のメモリ
- Runtime のセッション・セッションの設定
- Memory の種類
- Code Interpreter のリソース
- Browser のセッション
- Observability を始める
- Bedrock Agents Classic のメンテナンスモード
- AgentCore の料金(Browser の課金の仕方は 2026-11-08 に見直した)
-
AWS が公開している、エージェントを作るためのオープンソースのフレームワーク。ハーネスの中身もこれで動いている。 ↩
-
東京で受けたリクエストを、近くの複数のリージョンに振り分けてモデルを動かす仕組み。モデル ID の代わりに
apac.やjp.などで始まるプロファイル名を指定する。jp.は東京と大阪だけに振り分ける。 ↩ -
小さな仮想マシン。コンテナより隔離が強い。 ↩
-
CloudWatch の X-Ray のトレースを、全件まとめて検索できるようにする設定。 ↩
-
Model Context Protocol。AI のアプリと外部のツールをつなぐための共通の決まり。ツールの側を MCP の形にしておけば、どのエージェントからも同じ手順で呼べる。 ↩