
変更履歴
- 2026-11-13:公開
初めに
仕事で障害対応をしていると、AI の調査がどこまで当てになるのかが気になる。そこで、検証用の AWS アカウントに障害を 10 種類起こし、AWS DevOps Agent(以下、DevOps Agent)に 1 つずつ調査させた。DevOps Agent は、AWS の監視の情報から障害の原因と直し方を調べるサービスである。
DevOps Agent の画面と機能は、基礎編にまとめた。この記事は、調査の結果と、外れたところを書く。検証は 2026-10-26〜28 の 3 晩、東京リージョン(ap-northeast-1)で行った。DevOps Agent は 2026-03 に一般提供が始まったもので、AWS CLI は 2.38.1 を使った。
結論
RDS・ALB・EC2 の小さな注文アプリに、CPU の高負荷からパスワードのローテーションまで 10 種類の障害を 1 つずつ入れた。調査は、アラームの通知か利用者からの問い合わせの形で始め、構成と原因は教えていない。
結果は下記のとおり。
表の観点は、根本原因・裏付け・変更の追跡・直し方の 4 つ。○ はできた。△ は方向は合うが足りない。× はできなかったか誤った。基準と、調査の時間の測り方は 3 章に書いた。
「渡した手がかり」は、調査を始めるときに渡したものを表す。
- 専用のアラーム:障害の種類が名前で分かるアラーム(
cpu-highなど) - 共通の 5xx:アプリが 5xx を返す障害なら種類を問わず鳴るアラーム
- 問い合わせだけ:アラームは渡さず、利用者からの連絡の形で渡した
- おとりあり:関係の無いアラーム(おとり)と、本当の原因のアラームを並べて渡した
| 検証 | 障害 | 渡した手がかり | 根本原因 | 裏付け | 変更の追跡 | 直し方 | 調査の時間 |
|---|---|---|---|---|---|---|---|
| 1 | EC2 の CPU の高負荷 | 専用のアラーム | ○ | ○ | ○ | ○ | 9 分 |
| 2 | EC2 のディスクの枯渇 | 専用のアラーム | ○ | ○ | ○ | ○ | 12 分 |
| 3 | メモリ不足(OOM) | 問い合わせだけ | △ | ○ | △ | △ | 19 分 |
| 4 | RDS の接続数の上限 | 専用のアラーム | ○ | ○ | ○ | ○ | 18 分 |
| 5 | セキュリティグループの設定ミス | 共通の 5xx | ○ | ○ | ○ | ○ | 16 分 |
| 6 | IAM の権限不足 | 共通の 5xx | ○ | ○ | △ | ○ | 14 分 |
| 7 | パスワードのローテーション | 共通の 5xx | ○ | ○ | ○ | ○ | 15 分 |
| 8 | ALB のヘルスチェックの設定ミス | 専用のアラーム | ○ | ○ | ○ | ○ | 10 分 |
| 9 | DB のロック待ち | 問い合わせだけ | ○ | ○ | ○ | ○ | 15 分 |
| 10 | おとりの CPU の高負荷+IAM の権限不足 | おとりあり | ○ | ○ | × | ○ | 14 分 |
すべて ○ の 7 種類では、CloudTrail・メトリクス・プロセスの一覧・SSM のコマンドの履歴から原因まで辿り、直し方も自分が戻した操作と同じだった。運用の手順書(ランブック)などの追加の知識は登録しておらず、正解の手順を前もって教えてはいない。
ただし、この結果には条件がある。エージェントは環境を検証用と知ったうえで調べていた。EC2 の中で起こした 4 つ(検証1・2・4・9)は、障害を入れた SSM のコマンドが履歴に残っていて、そこから原因を辿っている。プロセスの一覧も、CloudWatch エージェントでログに出してあった。本番で同じ材料がそろうとは限らない(8 章)。
IAM の変更の記録は、東京ではなく us-east-1 の CloudTrail に残る(理由は 7 章)。エージェントは検証6 でその記録を見つけられず、検証10 では「IAM 書き込み変更は皆無」と言い切った。ただし検証3 の調査では、自分から us-east-1 を見に行っていた。
検証3 は、メモリが増え続けて上限で落ちる障害(メモリリーク)。メモリ不足(OOM)でプロセスが落ちては起き直す繰り返しまでは、正しく特定した。ただ、同じ晩のほかの障害まで根本原因にまとめ、最優先の対処には、前の版に戻すより先に「メモリの上限を上げる」を出した。
本記事の構成
1 章で DevOps Agent が見るもの、2 章で検証環境、3 章で 10 種類の選び方と評価の決め方を説明する。4〜7 章が障害の種類ごとの結果で、8 章は答えに近い情報を消して環境を作り直した話。9〜10 章で結果を見比べ、11 章に費用をまとめた。
1. AWS DevOps Agent とは
DevOps Agent は、アラームや問い合わせを受けて、AWS の環境から障害の原因を調べるエージェントのサービス。調査が終わると、根本原因と、直し方の計画(緩和計画)が返ってくる。
エージェントが見てよい範囲は、Agent Space という単位で決める。Agent Space に AWS アカウントをひも付けると、エージェントがリソースの関係(トポロジー)を自動で集める。調査の材料は、CloudWatch のメトリクスとログ、CloudTrail、リソースの設定など。権限は読み取りだけで、EC2 の中でコマンドを打つことはできない。
2. 検証環境の構成
図1 が、検証のために作った環境の全体である。

注文を受ける小さな Web アプリを、CloudFormation のスタック 1 つで作った。Agent Space も同じスタックに入れている。
要求は、利用者の代わりのスクリプト → 内部向けの ALB → EC2 の上の注文アプリ → RDS(注文)か S3(帳票)の順に流れる。
アプリのパスは 3 つ。/orders は注文をデータ用のディスクにファイルで書き、RDS に 1 行入れる。/report は S3 に書いて読む。/health は何にも触らずに 200 を返す。/orders と /report は失敗すると 500 を返し、アプリのログにエラーを書く。
- ALB:内部向け。ヘルスチェックは
/healthを 10 秒おきに呼び、2 回続けて失敗すると Unhealthy、2 回続けて成功すると Healthy にする。 - EC2:t4g.small・Amazon Linux 2023。注文アプリと、20 秒ごとに ALB 経由で
/ordersと/reportを呼ぶスクリプトを動かす。データ用のディスク 2 GiB を付けた。 - RDS:PostgreSQL 17・db.t4g.micro。
max_connections=30。マスターのパスワードは RDS が Secrets Manager で管理する。 - S3:アプリが帳票を書いて読むバケット。
DevOps Agent は EC2 の中を見られないので、CloudWatch エージェントでプロセスの一覧(CPU 順とメモリ順の上位)を 1 分ごとにログへ出した。カーネルとアプリのサービスの記録もログに送り、RDS のログにはロック待ちも出るようにした(log_lock_waits)。VPC フローログも取っている。
アラームは次の 5 つ。メモリと応答時間のアラームは、わざと置いていない。
-
devopslab-ec2-cpu-high:EC2 の CPU 使用率が 90% 以上で 3 分 -
devopslab-ec2-data-disk-full:データ用のディスクの使用率が 95% 以上 -
devopslab-alb-target-5xx:アプリが返した 5xx の 1 分ごとの件数が、2 回続けて 1 件以上。ALB が自分で返す 502 などは数えない -
devopslab-alb-unhealthy-host:ALB のターゲットが Unhealthy -
devopslab-rds-connections-high:RDS の接続数が 20 以上
エージェントが読める状態にしてあったものは、次のとおり。
- トポロジーと記憶(エージェントが自分で書き残す、環境についてのメモ)。どちらも Agent Space の中にある
- スタックのタグ(
Environment=sandbox・Purpose=qiita-devopsagent) - 障害を入れるために自分が送った、SSM の Run Command(EC2 でコマンドを動かす機能)の履歴
Agent Space には、ランブックや指示などの追加の知識を登録していない。

図2 では、トポロジーの収集が「完了」になっている。図3 は、ナレッジの「指示」(エージェントに守らせたい調べ方を書く欄)のタブである。
3. 検証の内容と評価基準
10 種類の選び方
障害の原因を 4 つの種類に分けて選んだ。10 種類のうち 9 種類は原因が 1 つで、残る 1 つ(検証10)は、2 つを重ねた組み合わせ。
| 種類 | 障害 | 選んだ理由 |
|---|---|---|
| 資源の枯渇 | CPU・ディスク・メモリ・DB の接続 | メトリクスに出る障害。メモリだけはアラームを置かず、問い合わせから辿れるかを見る |
| 設定の変更 | SG・IAM・パスワード・ALB のヘルスチェック | 操作の記録が CloudTrail に残る障害。ALB のヘルスチェックは、利用者にエラーが見えない |
| 性能の劣化 | DB のロック待ち | まず遅くなり、待ちきれずにエラーになる。応答時間のアラームが無いので、問い合わせから始まる |
| 複合 | 関係の無い CPU の高負荷+IAM | 関係の無いアラームが同時に鳴る |
結果に使ったのは 2 晩目と 3 晩目で、1 晩に 5 つずつ、続けて入れた。2 晩目(10/27)は検証4・5・6・1・2、3 晩目(10/28)は検証8・9・7・10・3 の順。1 つずつ入れて、アプリ・アラーム・ターゲットが平常に戻ってから次へ進んだ。ただし、アラームの履歴とログは消えずに残る。そのため、前の障害が次の調査に見えることがあった(各章で触れる)。
1 晩目(10/26)の結果は、8 章で書く理由から使っていない。作り直したあとも、エージェントは環境を検証用と知っていて、障害を入れた SSM のコマンドの履歴も読める状態だった。結果はこの条件のもとでのものである(8 章)。
調査に渡した文
調査は、アラームから自動で始める設定にはしていない。障害ごとに、自分が CLI(aws devops-agent create-backlog-task)でタイトルと内容を付けて始めた。
文面は、アラームの通知を受けた当番の形にした。渡したのは、アラームの名前・鳴った時刻・依頼の一文だけで、構成の説明と原因は渡していない。
タイトル:アラーム devopslab-alb-target-5xx が鳴った
内容:2026-10-27 21:24 JST にアラーム devopslab-alb-target-5xx が ALARM になった。原因を調べて、根拠と直し方を示して。
アラームが鳴らない障害(検証3・検証9)は、利用者からの問い合わせの形にした。書いたのは、そのとき利用者の側に見えた症状だけ。
タイトル:利用者から「注文が終わらない」と連絡があった
内容:2026-10-28 20:24 JST ごろから、利用者から「注文が終わらない」と連絡があった。原因を調べて、根拠と直し方を示して。
アラームの名前は症状を表しているので、そこから分かることもある。たとえば data-disk-full は、原因にかなり近い。ただし、どのプロセスか・どの変更かまでは教えていない。
4 つの観点
| 観点 | ○ | △ | × |
|---|---|---|---|
| 根本原因 | 正解の原因を名指しした | 症状や関わるリソースは当てたが、原因まで言わない | 別の原因を挙げた |
| 裏付け | 原因を支えるメトリクスかログを、名前か値で示した | 示したが、原因と結び付いていない | 示さなかった |
| 変更の追跡 | 原因になった変更・操作を、記録に基づいて時刻つきで追えた | 方向は合うが、特定まで行かない | 触れなかった・誤った |
| 直し方 | 自分が実際に戻した方法と同じ内容を出した | 方向は合うが具体的でない・余計な手順が主になる | 外れた |
このほかに、調査の時間を測った。調査を作った時刻から、エージェントがまとめを出し終えて状態が完了になった時刻までで、表では分に丸めた。途中で自分が答えたり承認したりはしていない。
評価には、エージェントが最後に出すまとめを使った。まとめは、根本原因を書いた要約と、優先の順に対処を並べた緩和計画の 2 つでできている。途中の推論は、何を見たかを確かめるためだけに読んだ。
4. 資源の枯渇
検証1 EC2 の CPU の高負荷
CPU が張り付いたとき、どのプロセスが原因かまで言えるかを見た。SSM の Run Command で stress-ng(CPU に負荷をかけるツール)を入れ、--cpu 0(すべての vCPU を使う)で 2 vCPU を使い切らせた。負荷は、次のコマンドで systemd のサービスとして動かしている。
aws ssm send-command --instance-ids <インスタンス ID> --document-name AWS-RunShellScript \
  --parameters 'commands=["dnf install -y -q stress-ng", "systemd-run --unit=batch-job stress-ng --cpu 0 --timeout 40m"]'
systemd-run は、コマンドを 1 つのサービスとして動かす。サービスの名前(batch-job)は、夜間の集計のようなありふれた名前にした。名前から原因が読めないようにするため。
エージェントの答えは「SSM 経由で起動された stress-ng CPU ストレステスト」。プロセスの一覧のログから stress-ng が 99% ずつ使っていることを示し、SSM のコマンドを送った CloudTrail の記録(SendCommand)を時刻つきで示した。CloudTrail ではコマンドの中身が伏せられるが、SSM のコマンドの履歴から中身をそのまま読んでいた。直し方は systemctl stop batch-job で、自分が戻した操作と同じ。
緩和計画の注意書きでは、この環境を「検証用サンドボックス」と呼び、負荷は意図的な演習かもしれないので、止める前に担当者へ確かめるよう勧めていた。タグを読んだとみられる。

図4 の緩和計画は、ステップ 1 に確認のコマンドを 2 つ置いている。SSM Agent(EC2 の中で SSM のコマンドを受けて動かす常駐のプログラム)が応答するかと、batch-job と stress-ng がまだ動いているかを見るもので、2 つ目には「読み取り確認のみ」と注記がある。止める操作は、その次のステップ 2 にある。
検証2 EC2 のディスクの枯渇
データ用のディスクを、dd で大きなダミーのファイルを書いて埋め、注文のファイルが書けない状態にした。/orders は「No space left on device」で 500 を返す。
アラームの名前(data-disk-full)が原因に近いので、見たかったのは、名前からは分からない「どのファイルを消せばよいか」だった。
答えは「admin が SSM 経由で実行した dd コマンドが 2 GiB データボリュームを意図的に満杯化」。ディスクの使用率が 2.5% から 99.99% に上がったことと、アプリのログの Errno 28(空き容量の不足)を並べた。dd を送った SendCommand を時刻つきで挙げ、SSM の履歴から dd が書いたファイルの名前まで突き止めた。直し方はそのファイル 2 つだけを消す案で、注文のファイルは残す、と書き分けていた。
検証3 メモリ不足(OOM)
悪いリリースでメモリが増え続け、上限に当たって落とされては起き直す、という障害を作った。この検証は、3 晩目の最後に入れた。アプリのサービスには systemd の MemoryMax=512M で上限を置き、Restart=always で起き直す設定にしてある。EC2 全体のメモリは余っていても、サービスが上限に届くと OOM killer(メモリが足りないときにプロセスを止める仕組み)に止められる。
アプリの版は、EC2 の上の release.sh で切り替える(v1 が正常、v2 がメモリの増え続ける版)。SSM で v2 に切り替えた。
aws ssm send-command --instance-ids <インスタンス ID> --document-name AWS-RunShellScript \
  --parameters 'commands=["/opt/devopslab/release.sh v2"]'
v2 は約 3 分で 512 MB に届いて落ち、3 秒後に起き直して、また増えた。利用者の側から見えたのは、ALB が返す 502 が数件だけ。この 502 は ALB が自分で返したもので、2 章のとおり target-5xx のアラームには入らない。メモリのアラームも置いていないので、問い合わせの形で調査を始めた。
タイトル:利用者から「時々エラーになる」と連絡があった
内容:2026-10-28 22:12 JST ごろから、利用者から「時々エラーになる」と連絡があった。原因を調べて、根拠と直し方を示して。

エージェントは、プロセスのメモリが 54 MB から 489 MB へ直線的に増え、上限で落とされて再起動を繰り返していることを示した。ここまでは正しい。
v2 に切り替えた SSM のコマンドは、特定できなかった。その晩の SendCommand を 35 件数えたうえで、中身は SSM の API でも取れないとしている(ほかの検証では、同じ履歴から中身を読めていた)。
版が v1 から v2 に変わったこと自体は、自分が症状を確かめるために SSM で送ったコマンドの出力から読んでいた。このコマンドは、各 URL の応答とアプリの版を返すもので、出力は SSM の履歴に残る。変更の追跡を △ にしたのはこのため。
崩れたのは根本原因だった。根本原因の欄は「admin による手動メンテナンス作業中の連鎖的な設定ミス」。「時々エラー」という症状に合うものを同じ晩の 5xx から全部拾い、時間帯で分けた 4 つのフェーズとして 1 つの話にまとめていた。時刻はエージェントが挙げたもの(JST)で、検証9・7・10 の中身は後の章で書く。
- 20:24〜20:41:DB の文のタイムアウト(検証9)
- 20:53〜21:13:DB の認証の失敗(検証7)
- 21:32〜21:53:S3 の AccessDenied(検証10)
- それ以降:メモリリークによる OOM(この検証)
4 つ目がこの検証の障害で、残りは同じ晩に先に入れた別の障害である。この晩の最後に入れたので、拾えるものが一番多かった。
4 つ目のフェーズの原因には「アプリのメモリリークによる OOM クラッシュループ」と書いていて、リークそのものは名指ししている。ただ、根本原因に立てたのは admin の作業の連鎖で、悪いリリースではない。根本原因を × ではなく △ にしたのはこのため。

図6 の「原因」の欄に、同じ 4 つが 1 つの段落に並んでいる。
最優先の対処は「MemoryMax を 512M→1024M へ引き上げ」。v2 のままでは、上限を上げても落ちるまでの時間が延びるだけになる。v1 に戻す案は、恒久策の括弧書きにしか出てこなかった。自分は v1 に戻して直した。
検証4 RDS の接続数の上限
DB の接続が上限に達したとき、どこが接続を抱えているかまで言えるかを見た。SSM で EC2 の上にスクリプトを置き、RDS への接続を 40 本試して、張れた分を持ち続けさせた。スクリプトは EC2 の上で report-export というサービスとして動かし、DB への接続にも同じ名前(PostgreSQL の application_name。誰の接続かを示すラベル)を付けた。帳票の書き出しの処理が接続を抱えた、という形。
張れたのは 21 本で、使える枠が埋まった。/orders は「remaining connection slots are reserved」で 500 になった。
答えは「report-export.service の接続リーク × max_connections=30」。接続数が 0 から 21 に上がって張り付いたことと RDS のエラーを示した。スクリプトを置いた SendCommand を時刻つきで挙げ、SSM の履歴から中身を読んで出どころを絞った。直し方はそのサービスを止める案で、自分が戻した操作と同じだった。
調査は 18 分かかった。すべての観点が ○ だった障害の中では、一番長い。
5. 設定の変更
検証5 セキュリティグループの設定ミス
RDS のセキュリティグループから、EC2 からの 5432 番の許可を外した。/orders は DB への接続を 3 秒で諦めて 500 になる。
答えは「RDS SG の app-to-db ルール削除による接続遮断」。SG はセキュリティグループの略で、app-to-db は消した許可の規則に付けてあった説明の文。許可を外す操作(RevokeSecurityGroupIngress)の CloudTrail の記録を、消した規則と相手のセキュリティグループまで示した。直し方も、プロトコル・ポート・相手・説明を消す前と同じ形で付け直す案だった。
同じ調査には、1 つ前の検証4 の接続の枯渇も「フェーズ 1」として並んでいた。5xx のアラームの履歴に、前の障害の分が残っていたため。事実としては正しいが、実施の順では、前の障害が次の調査に混ざった最初の例になった。
検証6 IAM の権限不足
EC2 のロールから、S3 を読み書きするインラインポリシー(ロールに直接埋め込んだポリシー)を消した。/report が AccessDenied で 500 になる。
aws iam delete-role-policy --role-name devopslab-app-role --policy-name devopslab-app-s3
エージェントは、アプリのログの AccessDenied から「ロールに S3 の権限が無い」と名指しし、同じ名前のポリシーを付け直す案を出した。根本原因と直し方は合っている。
変更の追跡は △ にした。ポリシーを消した操作の記録(DeleteRolePolicy)を見つけられず、同じ作業の中で権限がずれたと推し量っただけで、いつ誰が消したかは追えていない。理由は検証10 で分かった。
検証7 パスワードのローテーション
DB のパスワードが変わったのに、アプリが起動時に読んだ古いパスワードを持ち続ける、という障害。アプリは最初に 1 回だけ Secrets Manager からパスワードを読み、要求のたびに新しい接続を張る作りにしてある。RDS が管理するパスワードを、すぐにローテーションした。
aws rds modify-db-instance --db-instance-identifier devopslab-db \
  --rotate-master-user-password --apply-immediately
約 1 分でパスワードが変わり、/orders は「password authentication failed」で 500 になった。
答えは「admin による手動の DB 認証情報ローテーション(rotateMasterUserPassword)がアプリの DB 接続を破壊」。根拠として、DB の設定を変える操作(ModifyDBInstance)とシークレットを入れ替える操作(RotateSecret)の CloudTrail の記録を、時刻つきで示した。Secrets Manager と DB のパスワードは一致している、とも切り分けている。
直し方は「order service (devopslab-app.service) を再起動して、ローテーション済みの最新 DB 認証情報(AWSCURRENT)を Secrets Manager から再取得させる」。AWSCURRENT は、Secrets Manager で今の値を指すラベルである。DB とシークレットの側の変更は要らない、と明記していた。パスワードを元に戻す案ではない。自分もアプリの再起動で直した。

図7 の「原因」の欄で、エージェントは 5xx が出た 2 つの時間帯を「第 1 バースト」「第 2 バースト」と呼び分けている。第 1 バーストは同じ晩に先に行った検証9 の分で、原因を行ロックと分けたうえで、根本原因は第 2 バースト(パスワードのローテーション)に置いた。ただし「2 フェーズとも admin の手動操作に起因」とも書いている。同じ晩の障害を 1 つの話にまとめる動きは、検証3 だけでなく、ここにも出ていた。
検証8 ALB のヘルスチェックの設定ミス
ヘルスチェックのパスを、アプリに無い /status に変えた。ヘルスチェックの設定は、ALB のターゲットグループ(TG。振り分け先の EC2 をまとめたもの)が持っている。ターゲットの EC2 は 404 を返して Unhealthy になる。
ALB は、ターゲットが全部 Unhealthy になると、全部に流し続ける(フェイルオープン。参考の「ALB のターゲットグループのヘルスチェック」)。今回はヘルスチェックのパスを誤っただけで、アプリ自体は正常に答えられる。なので利用者には何も見えず、/orders も /report も 200 のままだった。利用者に影響が出ていない構成の異常を、原因まで特定できるかを見た。
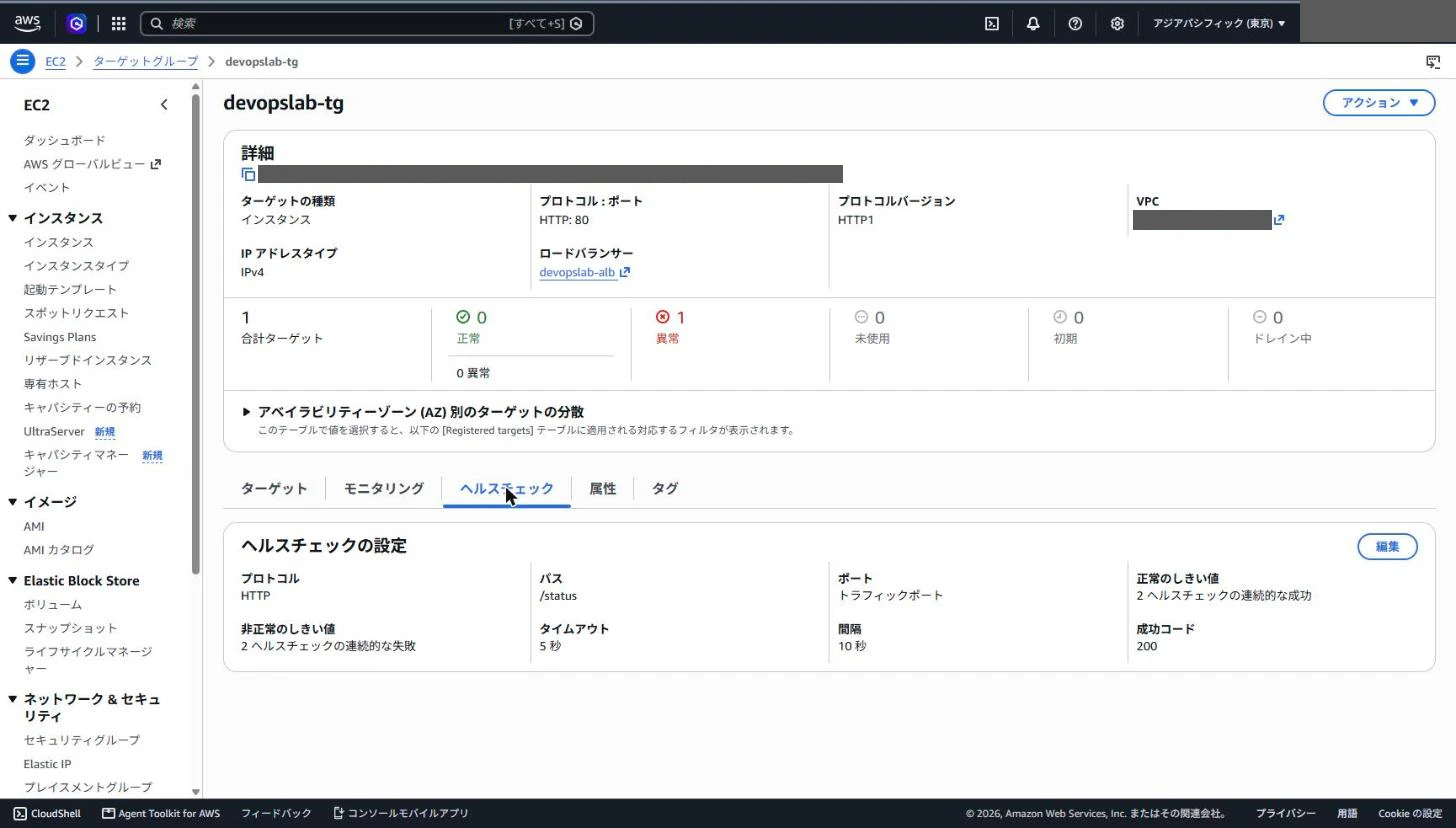
答えは「admin が TG のヘルスチェックパスを未実装の /status に変更した」。TG の設定を変える操作(ModifyTargetGroup)の CloudTrail の記録を示し、EC2 とアプリは正常と切り分けた。フェイルオープンで流し続けているので利用者向けの 5xx はほぼ 0 だ、とも書いていた。
自分はこの変更を 2 回打っていて、1 回目はパスの書き方を誤って ValidationException(入力の誤りのエラー)で失敗している。エージェントはこの失敗した呼び出しも拾い、成功した 2 回目を原因にしていた。

図9 の根本原因の欄には、成功した 2 回目の変更の時刻(20:00 JST。画面は UTC)と、それを打ったユーザーが出ている。
6. 性能の劣化
検証9 DB のロック待ち
まず応答が遅くなり、最後はタイムアウトで 500 になる障害で、どこまで辿れるかを見た。SSM で EC2 の上にスクリプトを置き、1 本の接続の中で次の順に SQL を流させた。スクリプトは EC2 の上で orders-maintenance というサービスとして動かし、DB への接続にも同じ名前を付けた。下は流れの抜粋。
begin;
lock table orders in access exclusive mode;
select pg_sleep(1);  -- スクリプトが 2400 回(約 40 分)流す
commit;
lock table … in access exclusive mode は、そのテーブルに一番強いロックを取る。トランザクションを終えるまで、ほかのセッションは orders に書けない。注文の INSERT はロックを待ち、アプリの statement_timeout(25 秒)で打ち切られて、/orders は 25 秒かかって 500 になった。/report と /health は速いまま。

調査は「注文が終わらない」という問い合わせの形で始めた(3 章の 2 つ目の例)。最初の 500 から 20 秒後で、この時点ではアラームはどれも鳴っていない。target-5xx は 2 分続けて数える設定なので、調査を始めた約 3 分後に鳴った(エージェントには渡していない)。
答えは「orders-maintenance スクリプトの意図的な AccessExclusiveLock が注文 INSERT をブロック(根本原因)」。RDS のログで注文の INSERT が次々に同じセッションを待っていることを示し、そのセッションを起こした SSM のコマンドを時刻つきで挙げ、中身まで突き止めた。
直し方は順番まで合っていた。先に EC2 の上の orders-maintenance のサービスを止め、そのあと DB のセッションを終える。セッションだけを切ると、サービスがつなぎ直してまたロックを取りうる、と理由も書いている。自分はサービスを止めて直した。

図11 の根本原因の欄には、スクリプトの置き場所、ロックの種類(AccessExclusiveLock)、ロックを持っていた DB のプロセスの番号が出ている。
7. 複合障害
検証10 おとりの CPU の高負荷+IAM の権限不足
関係の無いアラームが同時に鳴ったとき、切り分けられるかを見た。先に検証1 と同じ CPU の負荷を入れ、負荷の中でもアプリが 200 を返すことを確かめた。その 6 分後に、検証6 と同じ IAM のポリシーの削除を入れた。鳴った順に 2 つのアラームを並べて渡した。
タイトル:アラーム devopslab-ec2-cpu-high と devopslab-alb-target-5xx が鳴った
内容:2026-10-28 21:31 JST にアラーム devopslab-ec2-cpu-high が、2026-10-28 21:36 JST にアラーム devopslab-alb-target-5xx が ALARM になった。原因を調べて、根拠と直し方を示して。
切り分けはできていた。答えは「2つのアラームは因果的に独立した別々の根本原因が時間的に重なったもの」。CPU が 100% の間も注文の処理は 34〜48 ms で、CPU は 5xx の原因ではないと示していた。

外れたのは IAM の変更の追跡だった。エージェントは「CloudTrail でも IAM 書き込み変更は皆無」と書き、権限は元から足りず、帳票を使い始めて表に出た、と結論した。実際には自分が 21:32 にポリシーを消していて、/report はそれまで 200 を返していた。根本原因は「ロールに S3 の権限が無い」を名指ししているので ○ とし、消された経緯を外した分は変更の追跡の × に入れた。
確かめると、IAM の操作は us-east-1(米国東部・バージニア北部)に記録される。IAM は特定のリージョンに属さない(グローバルな)サービスで、管理イベント(ポリシーの削除のような、設定を変える操作の記録)は us-east-1 に入る(参考の「CloudTrail の概念」)。CloudTrail のイベント履歴で、消した時刻の前後の DeleteRolePolicy を検索すると、東京リージョンでは 0 件、us-east-1 では 1 件だった。
エージェントの調査の記録には、us-east-1 を見に行った跡が無い。検証6 で記録を見つけられなかったのも、同じ理由とみられる。一方、最後に行った検証3 の調査では、エージェントが自分で us-east-1 を検索し、この DeleteRolePolicy を見つけていた。同じエージェントでも、調査によって見に行くかどうかが変わる。
IAM の変更を CloudTrail のイベント履歴で探すときは、us-east-1 を見る。エージェントが「変更は無い」と言ったら、どのリージョンを見た結果かを確かめる。
8. 検証の途中で、エージェントが答えを読めると気づいて作り直した
1 晩目(10/26)は、CPU・ディスク・DB の接続の 3 つを調べた。そのあとエージェントの調査の記録を読み返すと、答えに当たる情報を読んでいた。
- EC2 のユーザーデータ(EC2 の起動のときに流すスクリプト):アプリのコードのコメントに、障害ごとの筋書きを書いていた(例:「障害 7 = メモリ(v2 の悪いリリース)」。作り直す前のコードの中の番号で、この記事の検証の番号とは別)。
- 障害を起こすスクリプト:接続を張る・ロックを取るスクリプトを、ユーザーデータの中で EC2 に書き出していた。名前と中身がユーザーデータにそのまま入っていた。
- スタックのタグ:CPU の調査で、意図的な負荷テストだと推し量った。
どれも AWS の API で読める情報で、エージェントが EC2 の中に入って読んだわけではない。
DB の接続の調査では、スクリプトの見出しの「障害 5・障害 9」を接続の数と読み違え、動かしていないロックのスクリプトまで原因に挙げていた。


そこで、ユーザーデータとスクリプトから、筋書きの分かるコメントと「障害 N」の番号を消した。障害を起こすスクリプトは最初から置かず、障害を入れるときに SSM でその場に置く形にした。EC2 と Agent Space(記憶ごと)を作り直し、3 つの検証もやり直した。タグは、10 種類で条件をそろえるために残した。
作り直す前後で、同じ 3 つの結果を比べた。
| 障害 | 4 観点(根本原因・裏付け・変更の追跡・直し方)前 → 後 | 調査の時間 前 → 後 |
|---|---|---|
| CPU の高負荷 | ○○○○ → ○○○○ | 8 分 → 9 分 |
| ディスクの枯渇 | ○○○○ → ○○○○ | 12 分 → 12 分 |
| DB の接続数の上限 | ○○○○ → ○○○○ | 12 分 → 18 分 |
○△× は変わらなかった。DB の接続だけ、調査が 6 分長くなった。作り直したあとは、SSM の履歴からスクリプトの中身を読んで辿っている。ただし、前後で Agent Space の記憶や、その晩に残っていたアラームの履歴は同じではない。この比較だけでは、答えに近い情報が結果をどれだけ左右したかは分からない。
作り直したあとも、エージェントは検証環境だと分かったうえで調べていた。作り直した Agent Space は、最初の調査の前に環境の説明を記憶として作っていた。そこには「sandbox environment - a three-tier web application for testing AWS DevOps Agent capabilities」とあり、調査のたびに読まれていた。スタックのタグ(2 章)から判断したとみられる。ディスクの調査では、同じ日の CPU と DB の負荷を挙げて「複数の障害注入を実施しており本件はその一環」とまで書いている。続けて障害を入れたことが、SSM の履歴から読めるためとみられる。
SSM のコマンドの履歴は 30 日分が残り(aws ssm list-commands で確かめた)、消す API は見当たらなかった。3 晩目のロック待ちの調査では、前の晩に同じ EC2 へ送ったコマンドまで読んでいた(結論の原因には使わず、参考として挙げただけ)。
EC2 の中で起こす障害は SSM で入れたので、原因になったコマンドがそのまま SSM の履歴に残っていた。検証1・2・4・9 は、その履歴が原因の特定に直接つながっている。本番の障害で、原因の操作がいつも SSM に残るとは限らない。今回の結果は、エージェントが検証環境だと知っていて、SSM の履歴も読める状態での結果として読んでほしい。
9. 検証結果の比較
結論の表を、渡した手がかりの列で見直した。
専用のアラームを渡した 4 つ(検証1・2・4・8)は、すべての観点が ○ だった。共通の 5xx の 3 つは、検証6 だけが変更の追跡で △。問い合わせだけの 2 つは、検証9 が ○、検証3 が △ に分かれた。
崩れた 3 つ(検証3・6・10)は、手がかりの多さでは分かれない。IAM の 2 つは、検証10 が us-east-1 を見ておらず、検証6 も同じとみられる(7 章)。検証3 は、問い合わせの症状が広く、同じ晩のほかの障害まで拾った。
調査の時間は 9〜19 分で、10 回の平均は 14 分だった。最長は、ほかの障害まで拾った検証3 の 19 分。
10. AWS DevOps Agent が得意な障害・苦手な障害
得意だったのは、操作の記録が東京リージョンの CloudTrail に残る障害。SG・パスワード・ヘルスチェックは、どれも操作と時刻を示し、戻す操作まで出してきた。同じ設定の変更でも、記録が us-east-1 に残る IAM は外した。
材料にする範囲は広い。CloudTrail では伏せられるコマンドの中身を、SSM の履歴から読んでいる。ただし今回は、原因の操作がその履歴に残っていた(8 章)。自分が症状を確かめるために SSM で送ったコマンドの出力まで、根拠に使っていた。運用者が確かめた結果も、エージェントの材料になる。
外したのは、IAM の変更の記録(検証10 は ×、検証6 は △。検証10 は us-east-1 を見ておらず、検証6 も同じとみられる。7 章)と、検証3 の根本原因と直し方の順番。検証3 では、症状を正しく特定しても、最優先の対処が先送りの案になった。悪いリリースなら前の版に戻すのが先だが、上限の引き上げを先に出している。
障害が続くと、前の障害が次の調査に混ざることも分かった。今回は 1 晩に 5 つ入れたので、その影響が大きく出た。本番で障害が続いたときにも、同じことが起きうる。
今回の結果から、人が確かめる所は 3 つになる。緩和計画の最優先が、先送りの案になっていないか(検証3)。「変更は無い」が、us-east-1 も見た結果か(検証6・10)。直前のほかの障害が、同じ話にまとめられていないか(検証3・5・7)。
11. 費用
DevOps Agent の料金は、エージェントが調査などで働いた時間に 1 秒 0.0083 USD(1 時間で約 30 USD)。調査の時間をそのまま課金の時間とみると、今回の調査は平均 14 分なので、1 回あたり約 7 USD になる。13 回の調査(作り直す前の 3 回を含む)では、合わせて約 2.9 時間・約 87 USD の概算になる。
初めて使う人には 2 か月の無料期間があり(月に調査 20 時間などの上限つき)、今回の DevOps Agent の請求は 0 USD だった。
なお、調査の中でエージェントが使う CloudWatch Logs Insights のクエリなどは、そのサービスの料金が別にかかる。
最後に
今回の検証を通じて、AWS DevOps Agent が障害調査において大きな可能性を持つことを実感した。
10 種類の障害のうち 7 種類で、根本原因の特定から具体的な対処方法の提示までを実現した。特に印象的だったのは、人が複数のログやメトリクス、操作履歴を確認して原因を絞り込むような調査を、わずか十数分で実施し、根拠とともに結果を提示してくれたことだ。従来の障害対応を考えると、この調査能力とスピードには驚かされた。
もちろん、AI エージェントの利用には追加の費用が発生する。しかし、障害調査にかかる人的工数の削減や、原因特定までの時間短縮を考えると、その費用をかける価値は十分にあると感じた。
今回の検証では、誤った結論や変更履歴の見落としも確認されたため、エージェントの回答をそのまま鵜呑みにすることはできない。それでも、AI が短時間で調査の大部分を担い、人がその結果を確認して判断するという進め方には、大きな魅力がある。
多少の追加費用を許容してでも、今後の障害対応には積極的に AI エージェントを取り入れていきたい。今回の検証は、そう感じるきっかけになった。
参考
- AWS DevOps Agent の料金(2026-11-13 確認)
- AWS DevOps Agent の対応リージョン(2026-10-28 確認)
- CloudTrail の概念(グローバルサービスのイベント)(2026-10-28 確認)
- ALB のターゲットグループのヘルスチェック(2026-10-28 確認)
- RDS と Secrets Manager によるパスワードの管理(2026-10-28 確認)