
はじめに
- 最近の LLM は色々な言語をどのようにトークン化しているのだろう
- 英語が一番効率よさそうだが、それ以外の言語はどうなのだろう
など tokenizer の多言語性能について気になったので、今回は次の2点について調べてみました。
- tokenizer の vocabulary はどのような文字体系で構成されているのか
- 言語が変わるとトークン数はどう変わるのか
参考にした研究
(2023.05) Language Model Tokenizers Introduce Unfairness Between Languages
この論文は、同じ内容の文章であっても言語が異なると、トークン数に大きな差が生まれることを示しています。
具体的には、対訳コーパスを用いて、言語 A と言語 B で書かれた同じ内容の文章をトークン化し、そのトークン数の比を評価指標としています。
(2023.09) GlotScript: A Resource and Tool for Low Resource Writing System Identification
この論文では、テキストの文字体系を判定する GlotScript というライブラリが提案されています。また、GlotScript を用いて言語モデルの tokenizer の vocabulary に含まれるトークンを分析しています。その結果が下の図です。

調査に使うもの
LLM / tokenizer
以下の13モデルの tokenizer を対象にします。
できるだけ新しいモデルを選びましたが、GPT と Gemini については、tokenizer が特定できる中で一番新しいものとなっています。
| LLM | 企業・団体 | 国 | vocabulary size |
|---|---|---|---|
| GPT-5 | OpenAI | アメリカ | 200,019 |
| Gemini 3.5 | アメリカ | 262,144 | |
| Nemotron 3 | NVIDIA | アメリカ | 131,072 |
| Llama 4 | Meta | アメリカ | 201,135 |
| Qwen3.8 | Alibaba | 中国 | 248,077 |
| DeepSeek-V4 | DeepSeek | 中国 | 129,280 |
| GLM-5.2 | Z.ai | 中国 | 154,856 |
| Kimi K3 | Moonshot AI | 中国 | 163,840 |
| PLaMo 3 | Preferred Networks | 日本 | 107,520 |
| LLM-jp-4 | LLM-jp | 日本 | 196,608 |
| Mistral Medium 3.5 | Mistral AI | フランス | 131,072 |
| Command A+ | Cohere | カナダ | 255,032 |
| K-EXAONE 2.0 | LG | 韓国 | 153,600 |
データセット
2種類の対訳コーパスを使用します。
1つ目は、参考論文でも使用されていた FLORES-200 の後継プロジェクトである FLORES+ です。これは200言語2000文の翻訳が収録されたコーパスです。
2つ目は、Bible SuperSearch というサイトで提供されている聖書のデータです。50言語を超える聖書の全文がテキスト形式でダウンロードできます。
言語
対象とするモデルの開発企業などを考慮して、以下の8言語を対象とします。
| 言語 | ISO 639-1 |
|---|---|
| アラビア語 | ar |
| ドイツ語 | de |
| 英語 | en |
| フランス語 | fr |
| 日本語 | ja |
| 韓国語 | ko |
| ベトナム語 | vi |
| 中国語 | zh |
調べ方
vocabulary の文字体系
tokenizer の vocabulary がどの文字体系に属するかを、GlotScript を用いて分析します。
ただ vocabulary すべてを対象とするのではなく、今回は文字体系が判定できない箇所には興味がないので、以下のような前処理を加えます。
- 特殊トークンや HTML タグなどを大まかに除外する
- GlotScript の前処理に合わせて、空白・記号・数字などを大まかに除外する
- トークン中に文字列としてデコードできないバイト列がある場合は、その部分だけ除外する
またトークン数の数え方ですが、1つのトークンに複数の文字体系が含まれる場合、文字数の比率に応じて各文字体系にトークン数を按分します。
例えば abc花 というトークンにはアルファベットが3文字、漢字が1文字含まれるので、アルファベット0.75トークン、漢字0.25トークンというように数えます。
対訳コーパスのトークン数
各言語の対訳コーパスを各 tokenizer でトークン化し、そのトークン数を数えます。
実装
実装は GitHub をご覧ください。
https://github.com/yuichi0625/llm-tokenizer-analysis
結果
vocabulary の文字体系
次の図は、文字体系ごとにトークン数を積み上げて描画したものです。文字体系は ISO 15924 の4文字のコードで表されています。

また、vocabulary 全体に占める割合を百分率で表したものが次の図です。

どの tokenizer でもアルファベットが大きな割合を占めており、特に Command A+ では7割を超えていました。
アルファベット以外の文字体系に注目すると、モデルの開発元と関係の深い文字体系が多く含まれる傾向にあります。中国モデルでは漢字、日本モデルでは漢字・ひらがな・カタカナ、韓国モデルではハングルの割合が比較的大きくなっています。一方アメリカのモデルでは、比較的さまざまな文字体系に vocabulary が割り当てられているように見えます。
対訳コーパスのトークン数
Flores+ のトークン数を言語・モデルごとに取得し、ヒートマップにしたものが次の図です。

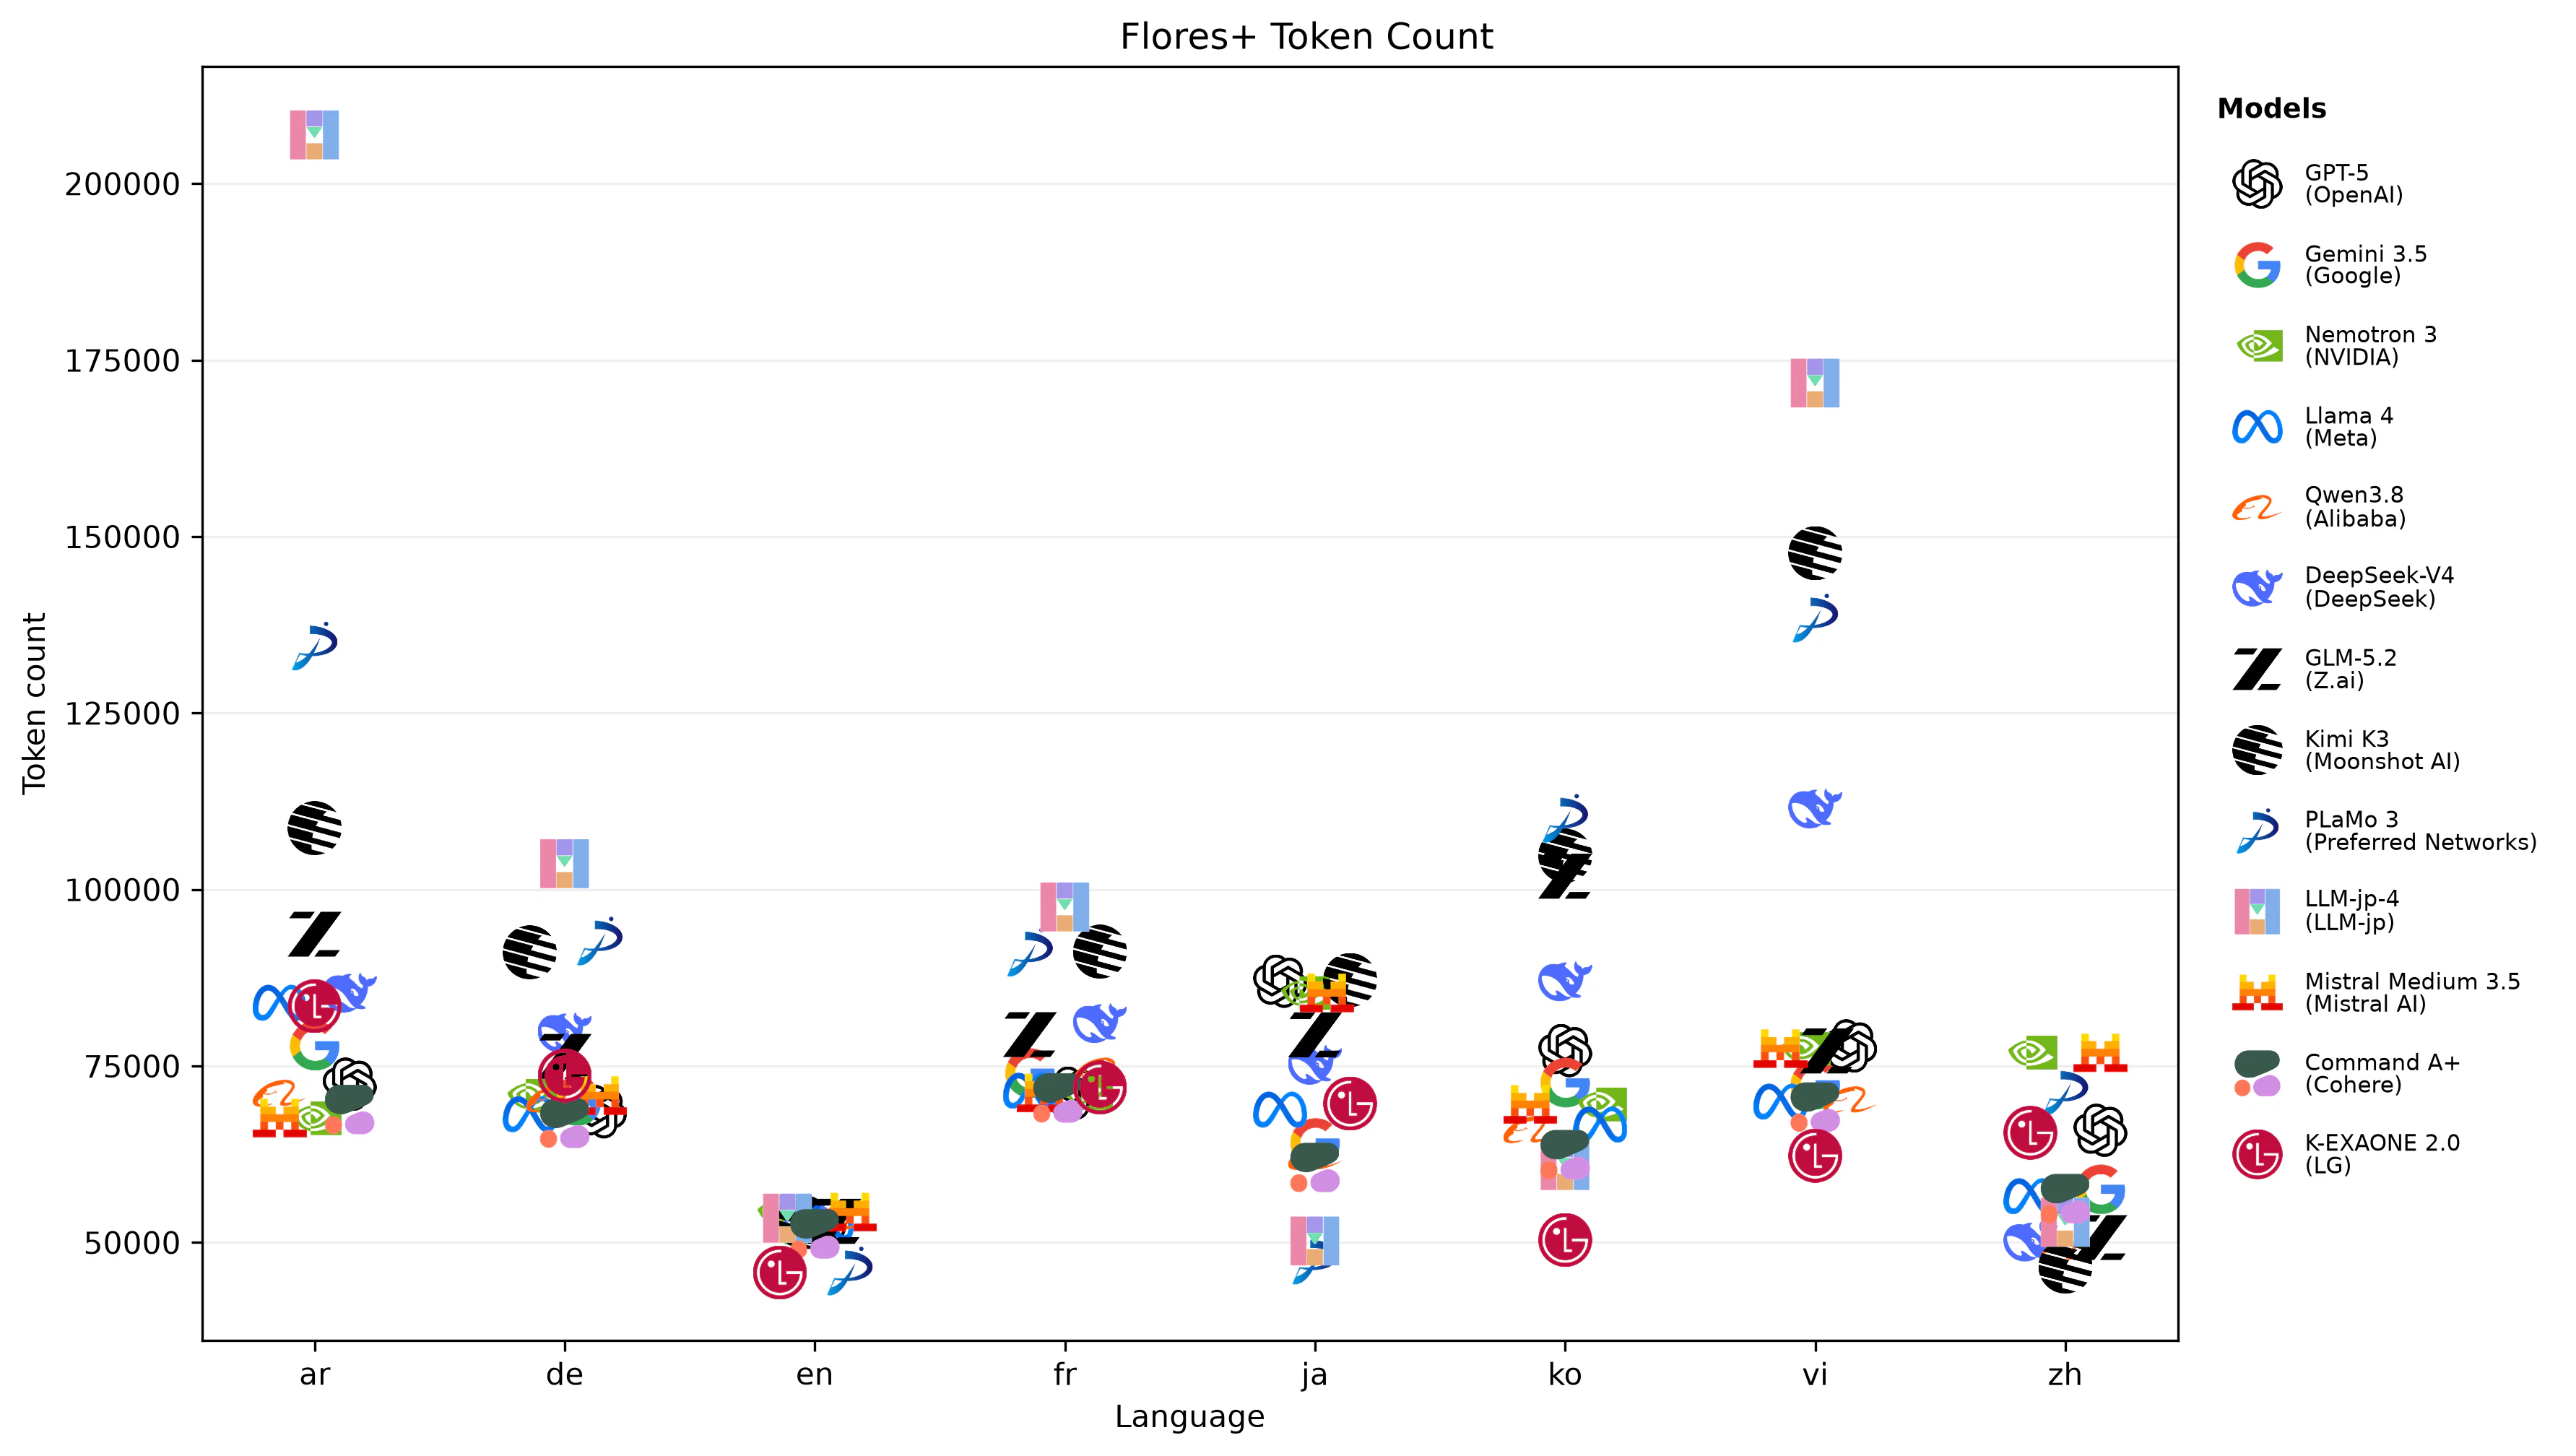
また、同じ結果を散布図的に描画したものが次の図です。
続いて、聖書データについて同様の描画を行ったのが次の図です。
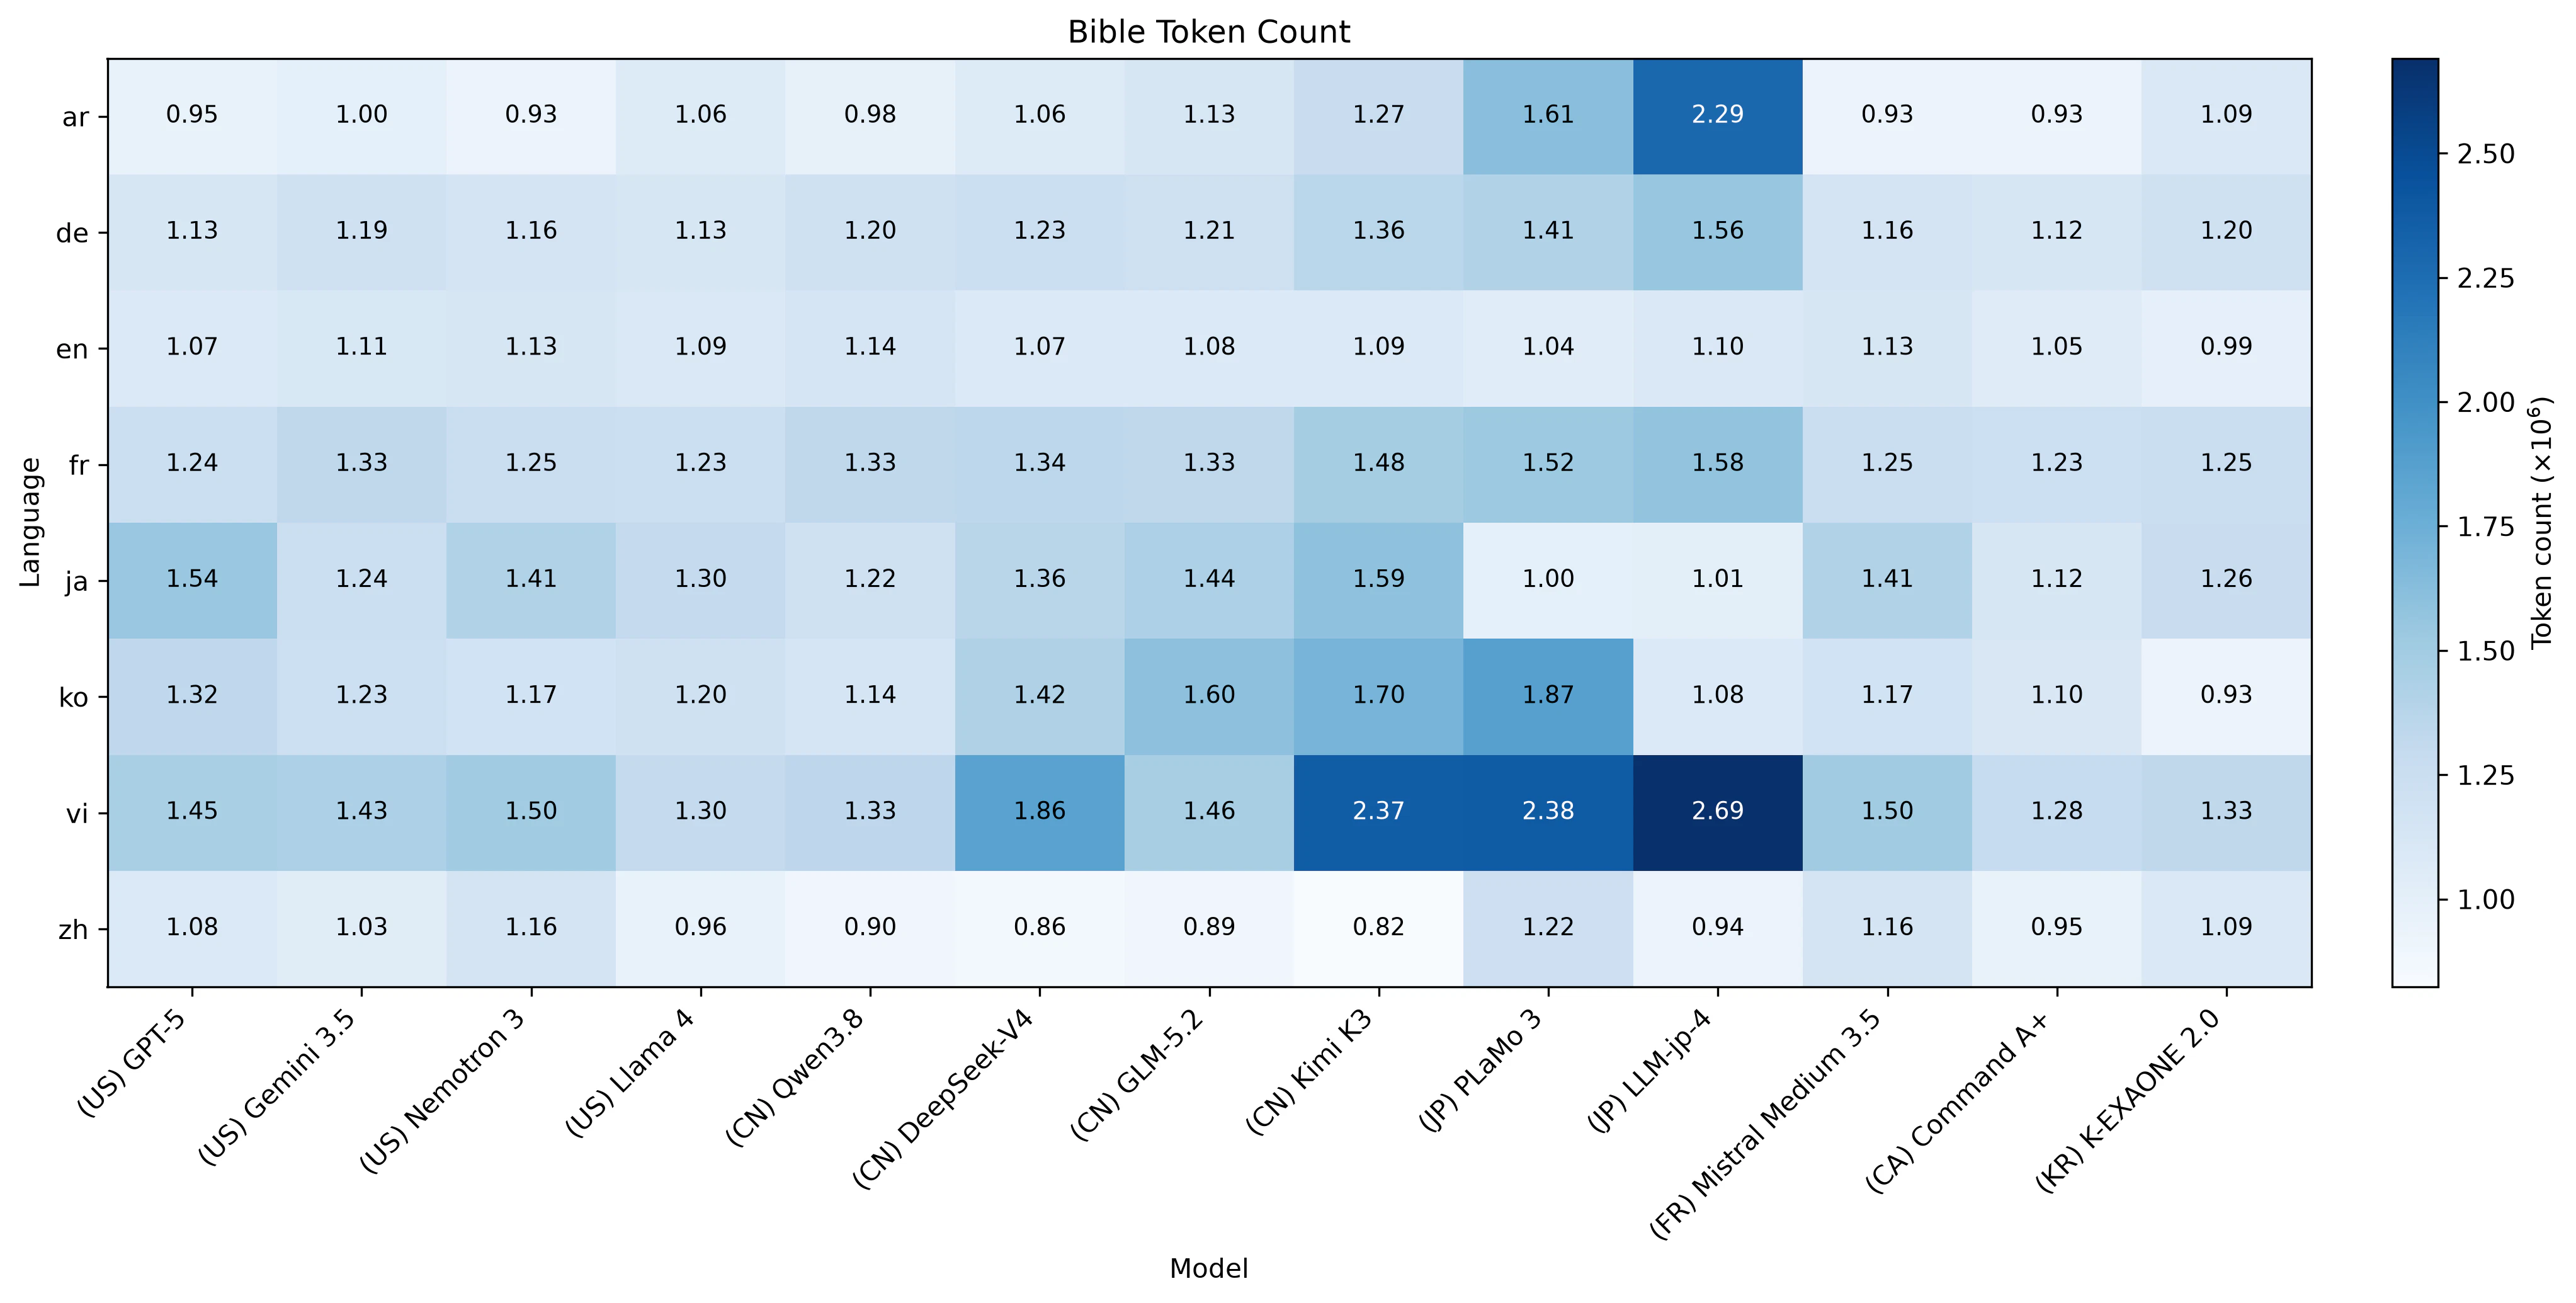
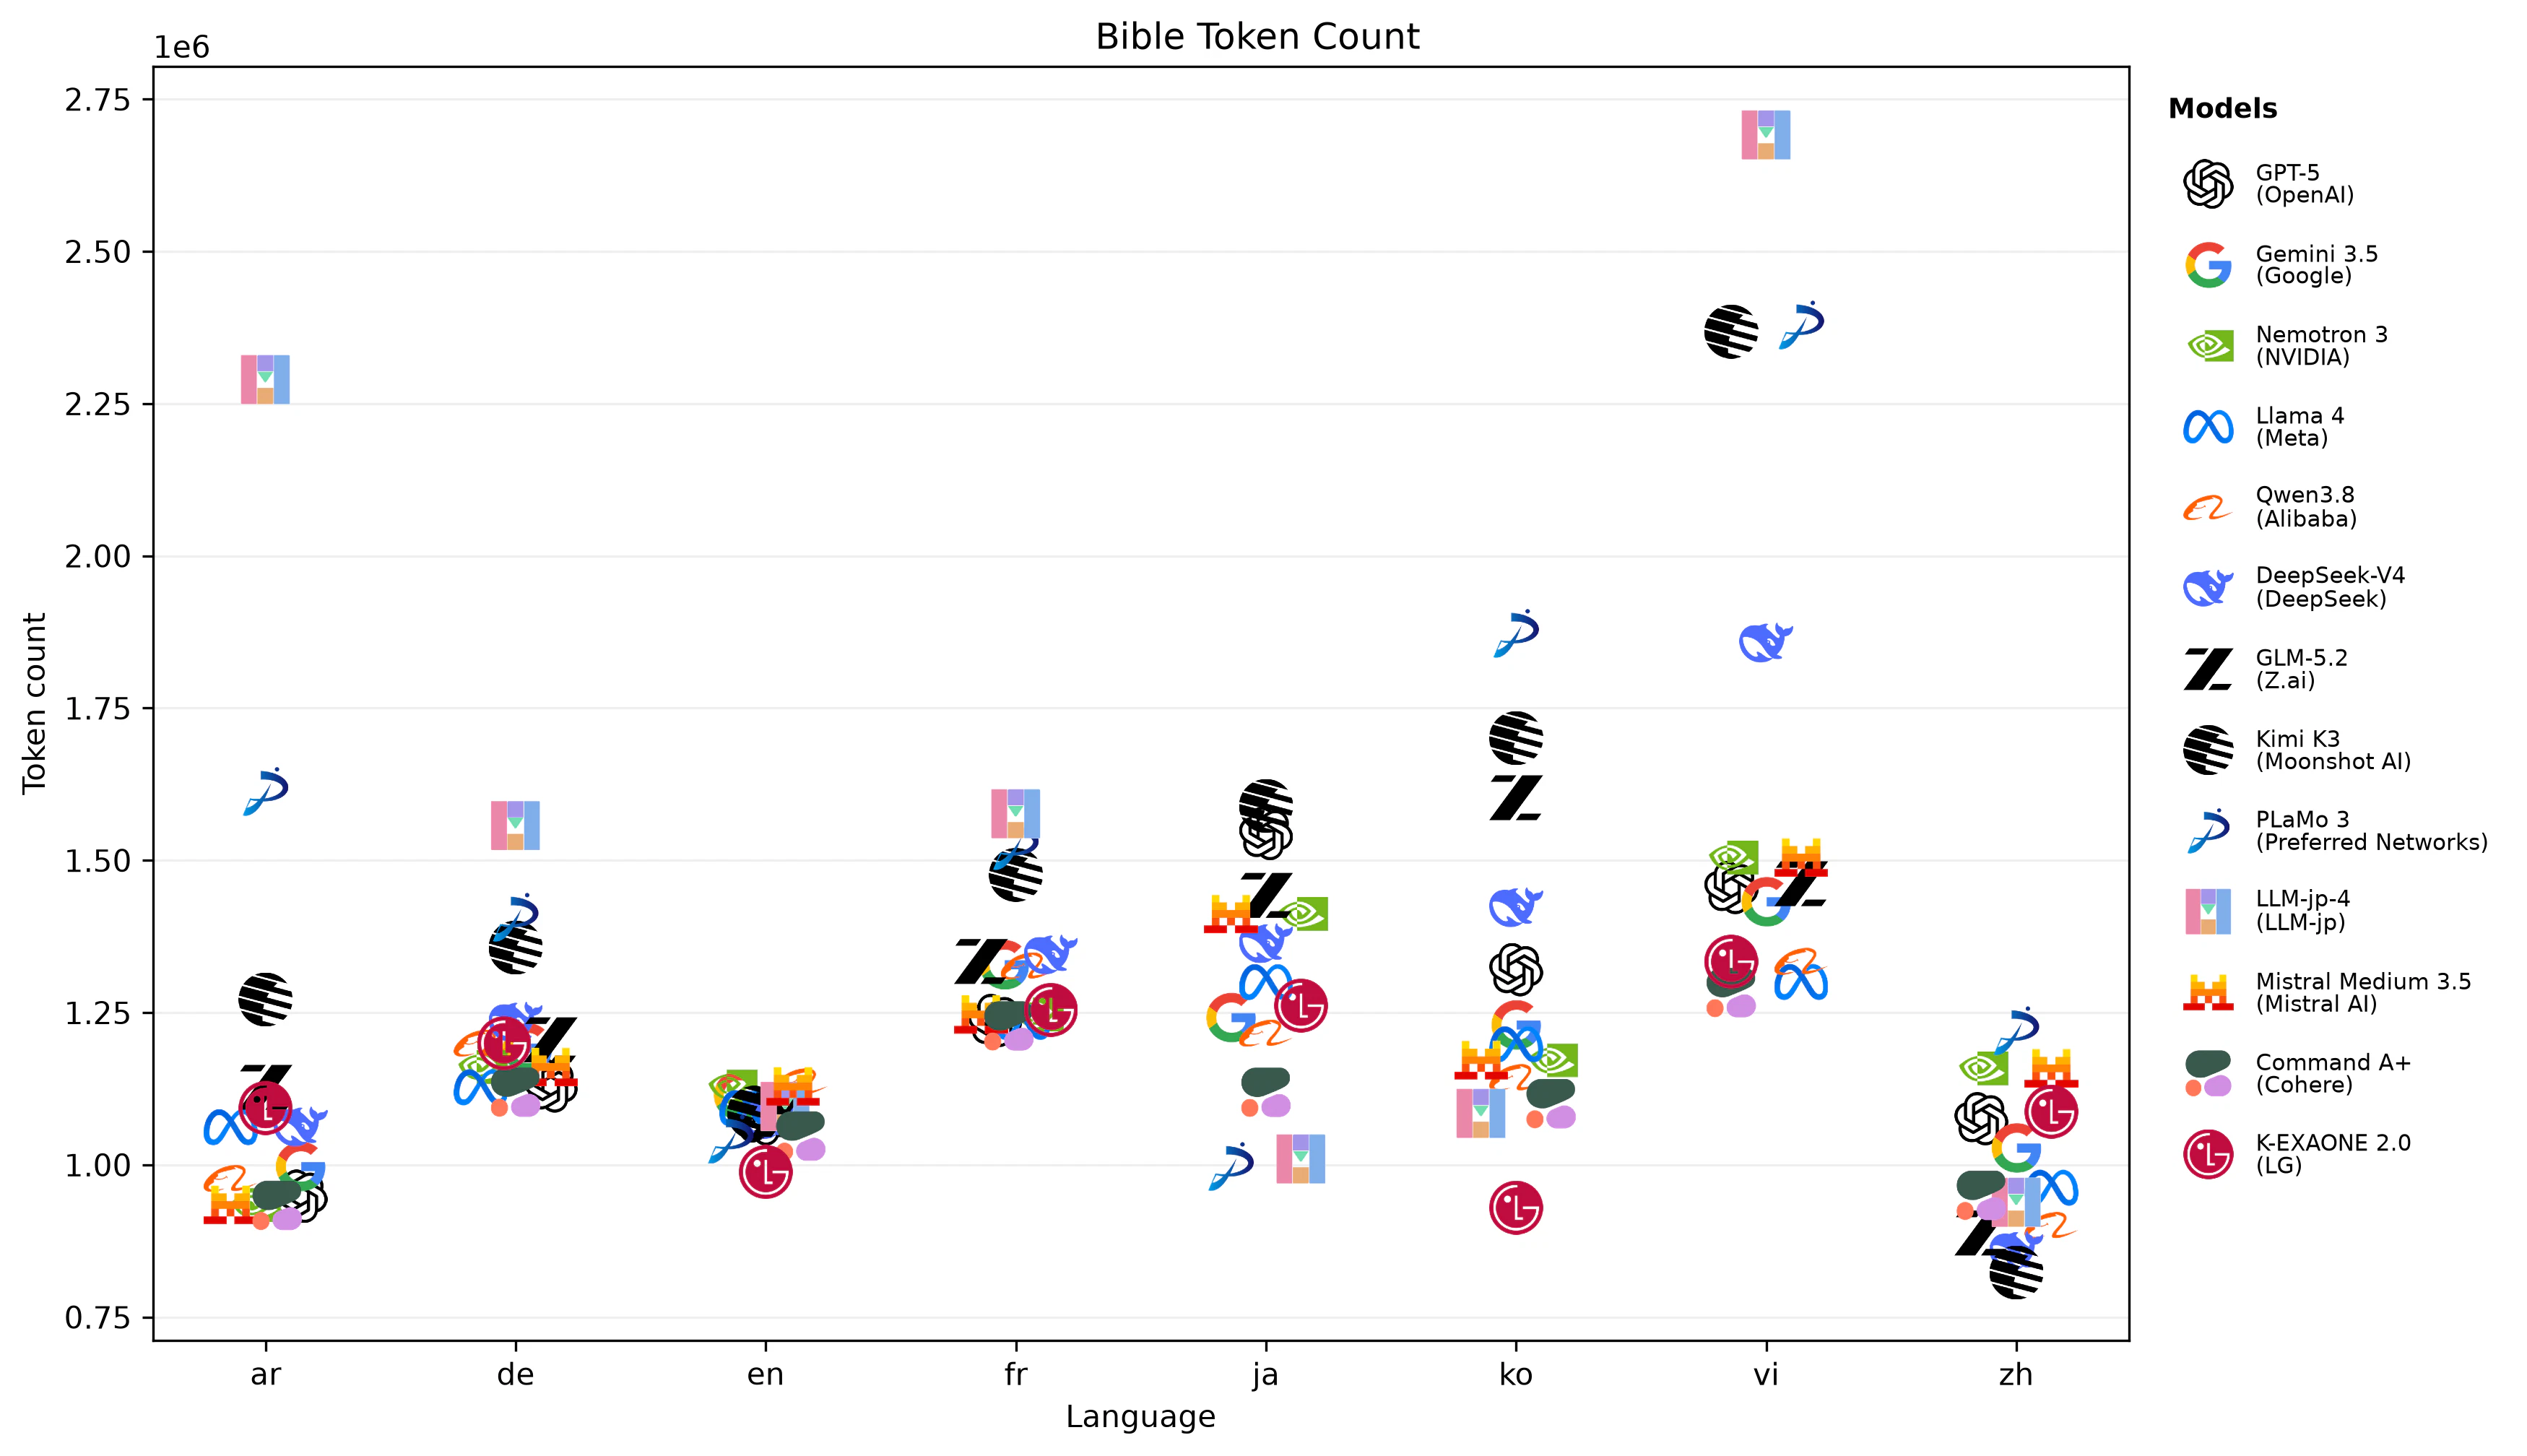
どちらのコーパスでも同じような傾向が見られました。
言語ごとに見ると、まず英語はモデル間の差が比較的小さく、安定して少ないトークン数となっています。同じヨーロッパ言語であるドイツ語とフランス語も多くのモデルであまり差がありませんが、日本モデルと Kimi K3 ではややトークン数が多くなる傾向が見られました。
中国語は全体的にトークン数が少なく、特に中国モデルでその傾向が顕著です。日本語と韓国語についても、それぞれ日本モデル・韓国モデルでトークン数が少なくなっています。
アラビア語とベトナム語は、どちらも日本モデルと Kimi K3 でトークン数が大きくなっています。ただそれらを除くと、アラビア語では比較的少ないトークン数に収まっていました。
モデルごとに見ると、PLaMo は日本語を少ないトークン数で表せる一方で、それ以外の言語ではトークン数が多くなる傾向があります。LLM-jp も同様で、日本語・中国語・韓国語は少ないトークン数で表せるものの、それ以外の言語ではトークン数が多くなっていました。
Kimi K3 は中国語を特に少ないトークン数で表せる一方、それ以外の言語では全体的にトークン数が多めでした。K-EXAONE は韓国語だけに偏ることなく、今回調べた言語を比較的少ないトークン数で表現できていました。
考察
なぜアラビア語のトークン数は英語と同程度なのか
結果を見ていて意外だったのが、アラビア語のトークン数が英語と同程度、あるいは英語より少なくなっていることです。
アラビア語に特化したモデルは含んでいないのに、複数のモデルでこの傾向が見られたことが不思議だったので、トークン数について少し分解して見てみます。
トークン数は、大まかに以下のように表せます。
$$
全体のトークン数 = \frac{全体の文字数}{1トークンあたりの文字数}
$$
そこで、「全体の文字数」と「1トークンあたりの文字数」の関係を可視化したものが下の図です。

x 軸は、同じ内容を表現するために必要な文字数を、英語を1として比率に直したものです。
フランス語・ドイツ語・ベトナム語はおおむね英語に近い一方、アラビア語は約60%、日本語・韓国語は約45%、中国語は約30%となっています。今回比較した8言語では、ラテン文字を用いる言語では英語と同程度の文字数を必要とするのに対し、アラビア語を含むそれ以外の言語では英語より少ない文字数で表現できています。
y 軸は、1トークンあたりに含まれる文字数を、同じく英語を1として比率に直したものです。
アラビア語では、1トークンあたりに含まれる文字数は英語の25~70%程度となっており、tokenizer による分割効率だけ見れば、英語よりも非効率であることが分かります。
つまり、アラビア語のトークン数が英語と競っていたのは、tokenizer が効率的だからというわけではなく、むしろ tokenizer による分割効率は英語よりも低いものの、同じ内容をより少ない文字数で表現できることによって、その不利が相殺されているからだと考えられます。
このように、言語ごとのトークン効率を考える際には、tokenizer による分割効率だけではなく、同じ意味・内容を表現する際に必要となる文字数の違いも重要であることが分かりました。