
はじめに
2026年9月25日、AWS Networking & Content Deliveryブログに「AI best practices for AWS network operations with AI agents and MCP」が公開されました。
著者はVijay Menon氏とVamsi Manthapuram氏です。
内容は、VPCやTransit Gateway、Cloud WANの障害調査をAIエージェントに任せるための設計指針です。
AWS DevOps Agent、Amazon Bedrock AgentCore、AWS Agent Registry、それに複数のMCPサーバーを組み合わせる構成が紹介されています。
この記事では、次の3つを突き合わせて読んでいます。
- ブログ本文
- ブログからリンクされているサンプルリポジトリ(aws-samples/sample-Gen-AI-best-practices-for-network-operations)
- 実際にuvxで起動したMCPサーバーが返すツール一覧(2026年9月27日時点)
先に結論を書きます。
仕組みの中心は「MCPサーバー+SKILL.md+読み取り専用IAMロール」の3点です。
一方で、サンプルを実物と突き合わせると、ツール名のずれ、SKILL.mdの書式、PCAP Analyzerの起動失敗といった、事前に直しておきたい箇所が見つかりました。
後半でその点を具体的に書きます。
元記事が想定している場面
ブログは、午前2時47分に本番VPC間のトラフィックが落ち始める場面から始まります。
3つのリージョンでCloudWatchアラームが鳴り、オンコール担当はフローログ、セキュリティグループ、NACL、Cloud WANのセグメントを行き来しながら経路を頭の中で組み立てることになります。
ブログはこの状況を難しくしている要因として、次の3つを挙げています。
- シグナルとノイズ:テレメトリの量が、人手でリアルタイムに相関を取れる量を超えている
- 複数領域の専門知識:ルーティング、ファイアウォール、DNS、ロードバランサーの知識が同時に必要になるが、1人に集まっていることは少ない
- 同じ症状、別の原因:TCPタイムアウトひとつでも、TGWの戻りルート欠落、VPNの不安定、NACLの戻りルール漏れ、Network Firewallのルールなど原因の候補が多い
AIエージェントはすべてのデータソースに並列で問い合わせて相関を取れるので、根本原因の特定を数時間から数分に縮められる、というのがブログの主張です。
4層で組むAI NetOpsスタック
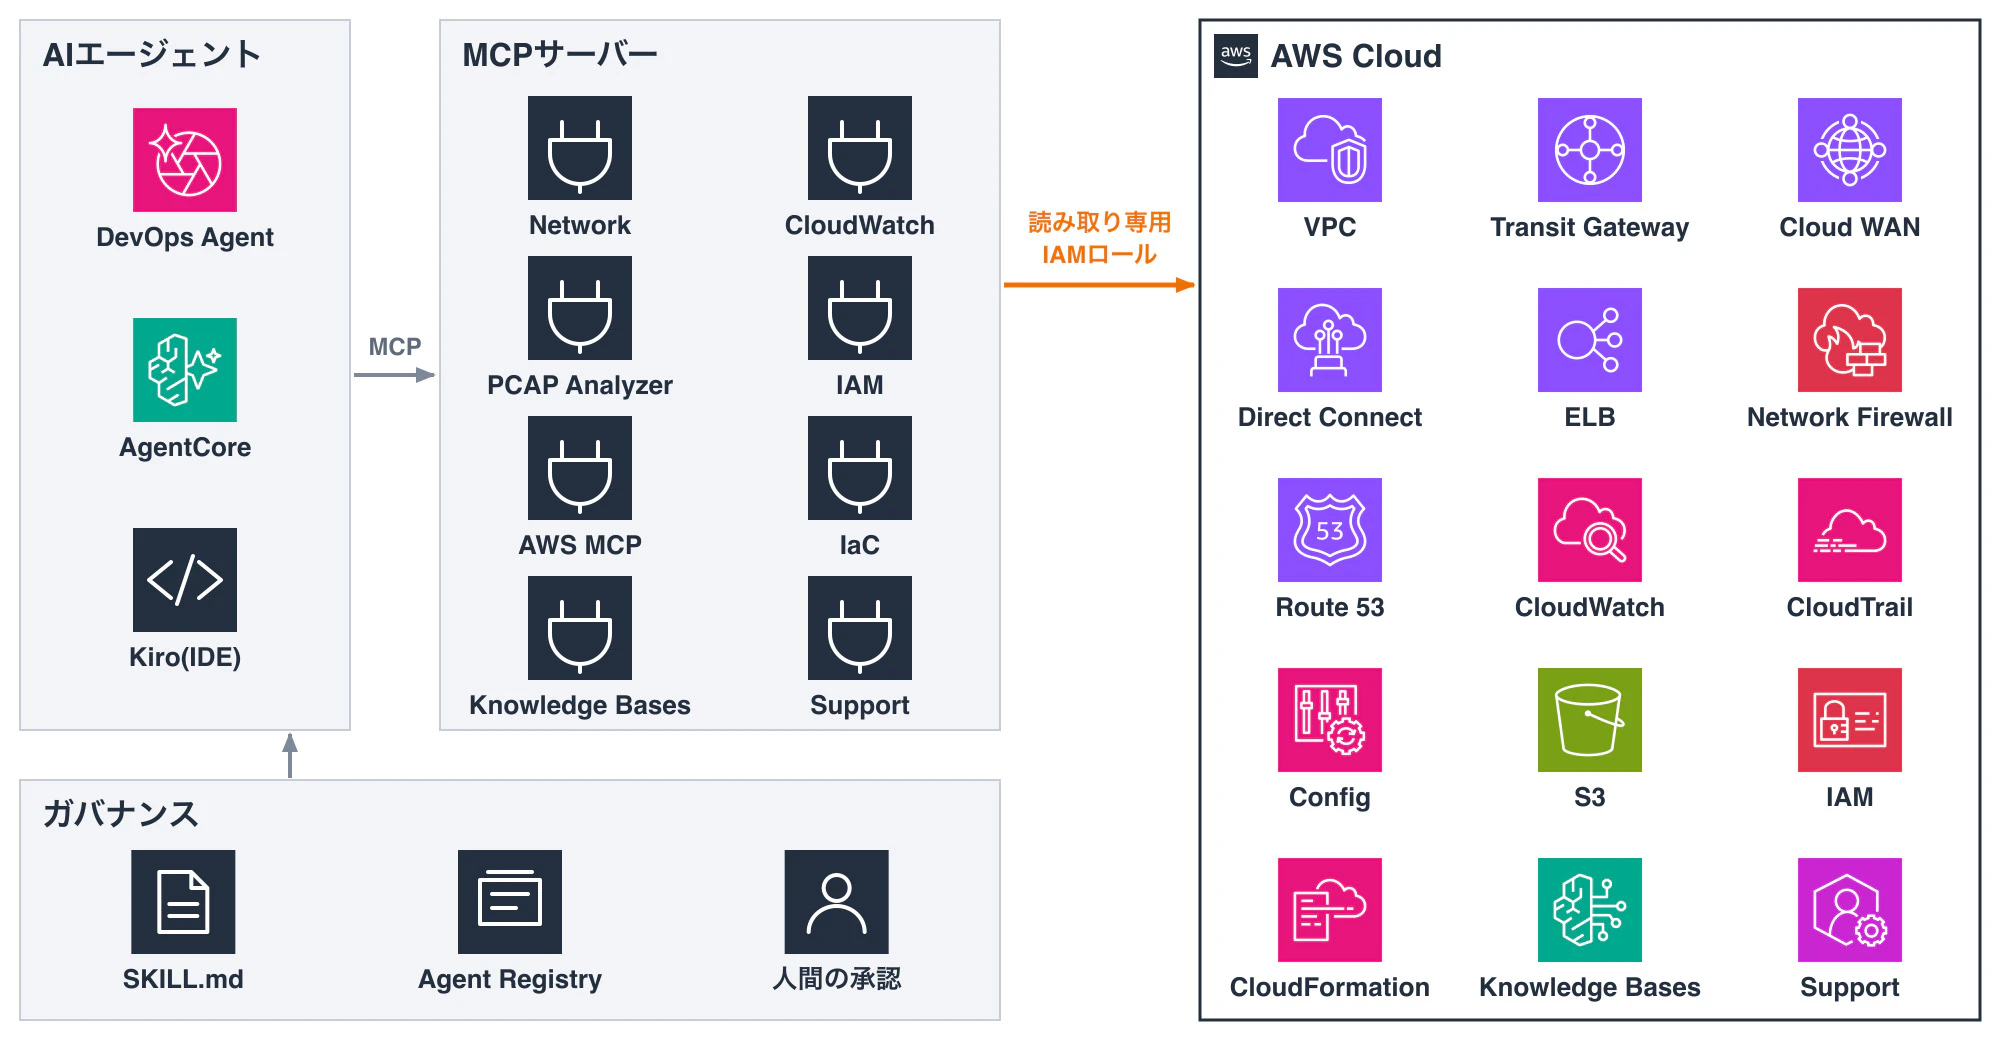
ブログの構成は4層に分かれています。
- エージェント層:Kiro IDE、Amazon Bedrock AgentCore、AWS DevOps Agent
- ツール層:MCPサーバー群(ネットワーク、CloudWatch、IAM、IaC、PCAP解析、ナレッジベース検索、サポート)
- データソース層:VPC、Transit Gateway、Cloud WAN、Network Firewall、CloudWatch、CloudTrail、S3など
- ガバナンス層:AWS Agent Registryと、調査手順を書いたSKILL.md
MCPサーバーからAWSへのアクセスは、すべて読み取り専用のIAMロールを経由します。どのエージェントから呼んでも同じツール、同じ権限になる点が、この構成の要です。
3種類のエージェントの使い分け
ブログは「1つを選ぶ必要はない」としたうえで、次のように整理しています。
| 観点 | DevOps Agent | カスタム(AgentCore) | IDEエージェント |
|---|---|---|---|
| 向いている用途 | 本番インシデントの自動対応 | 組織固有のワークフロー | 場当たり的な調査、開発中の診断 |
| 起動のきっかけ | CloudWatchアラーム(人の操作なし) | API呼び出し、イベントルール、手動 | エンジニアのプロンプト |
| 準備の手間 | 小さい(連携とAgent Spaceの設定) | 中程度(ロジック実装とランタイムのデプロイ) | 小さい(MCP設定のJSONを追加) |
| 記憶 | 過去の調査から学習 | AgentCore Memoryでセッションをまたいで保持 | セッション単位のみ |
| ガバナンス | Agent Spaceの境界、IAM、監査証跡 | IAM、AgentCore Observability、Agent Registry | 個人のIAM認証情報、集中監査なし |
DevOps AgentはCloudWatchのほか、Datadog、Grafana、New Relic、SplunkなどのWebhookや、ServiceNow・PagerDutyのチケットからも調査を始めます。
サンプルリポジトリのREADMEは執筆時点でDevOps AgentとAgent RegistryをPreviewと書いています。2026年9月27日時点のDevOps Agent製品ページでは、インシデント調査(Production Operations)はGA、Release ManagementはPreviewの表記でした。
使う前に最新の状態を確認してください。
Agent Registryの役割
Agent Registryは、MCPサーバー、エージェントスキル、カスタムリソースを「承認済みで検索できるもの」として公開する仕組みです。
ドキュメントによると、承認ワークフローがあり、人間とエージェントの両方がハイブリッド検索(意味検索+キーワード一致)で見つけられます。
運用面では、本番用と開発用のレジストリを分け、非推奨にしたレコードは検索結果から即座に消える運用を勧めています。
プロンプトにツール一覧を直書きすると、承認済みのものと実際に動いているものがずれていくので、その対策という位置づけです。
4つのユースケース
1. スキルを使った障害調査
一番効果が大きいのは障害調査です。アラームが鳴ったら、エージェントはSKILL.mdに書いた手順の順番でツールを呼びます。
場当たり的に呼ぶと結果がばらつくからです。
スキルの置き場所はエージェントの種類で変わります。
- DevOps Agent:コンソールでスキルを作成すると、アラートの内容がスキルの説明と一致したときに自動で読み込まれる
- カスタムAgentCoreエージェント:GitかS3に置き、プロンプトで「SKILL: network-triage」のように明示する
- IDEエージェント:プロジェクトのリポジトリに置き、プロンプトでスキル名を指定する
サンプルのSKILL.mdは次の内容です(aws-samples、MIT-0ライセンス)。
---
name: network-triage
version: "1.1"
description: >
  Investigation procedures for AWS network connectivity failures
  including Transit Gateway routing issues, VPC security policy blocks,
  DNS failures, TLS/protocol faults, and IAM permission errors. Use this
  skill when investigating packet drops, TCP timeouts, VPC flow log
  REJECTs, or any connectivity failure across VPC, TGW, Cloud WAN, or
  Direct Connect.


# Network Triage

Stop at first confirmed fault. Always invoke before ad-hoc queries.

## OBSERVE (CloudWatch MCP)

- get_active_alarms, get_alarm_history: identify when the fault started.
- execute_log_insights_query on flow log groups: top-contributing subnet/ENI.

## ROUTE (Network MCP)

- find_ip_address (both IPs), get_eni_details, get_tgw_routes, get_cloudwan_routes:
  check BOTH directions. Missing return route is the leading cause.
- Evidence: ACCEPT at source, zero records at destination.

## POLICY (Network MCP + CloudTrail)

- SGs src+dst, NACLs inbound+outbound (stateless; return rules must be explicit),
  VPC Endpoint policies, Network Firewall rule groups.
- Evidence: REJECT at destination.

## DNS (Network MCP)

Prerequisite: ACCEPT both sides but application fails.

## LOAD BALANCER (Network MCP)

Prerequisite: ACCEPT both sides but application fails.

## PROTOCOL (PCAP Analyzer)

- analyze_tls_handshakes
- analyze_sni_mismatches
- analyze_tcp_retransmissions

## IDENTITY (IAM MCP)

## KNOWLEDGE (Bedrock KB)

## ESCALATE (Support MCP)

## OUTPUT

Fault layer → Evidence → CloudTrail attribution → CLI fix → Rollback

## SAFETY

Read-only. No production changes without human approval
---
調査は「観測→ルーティング→ポリシー→DNS・LB→プロトコル→ID→ナレッジ→エスカレーション」の順に進み、最初に障害が確認できた層で止まります。
判断材料もフローログの見え方で決まっています。
- 送信元でACCEPT、宛先で記録なし → ルーティング(戻りルート欠落が最多)
- 宛先でREJECT → ポリシー(SG、NACL、エンドポイントポリシー、Network Firewall)
- 両側でACCEPTなのにアプリが失敗 → DNS、LB、プロトコル層(PCAP)
出力形式も「障害層→証拠→CloudTrailでの変更者→修正コマンド→ロールバック」と決めてあるので、誰が調べても報告の形がそろいます。
2. 構成分析
設定のドリフトは、ネットワーク障害の主な原因です。
エージェントはAWS Configの現在の状態をIaCのベースラインと比べ、差分をCloudTrailで「どのIAMプリンシパルが、いつ、どうやって変えたか」までたどります。
障害調査と同じ仕組みで、障害が起きる前のドリフト検出にも使えます。
3. 変更管理
ルートテーブルの変更は、特定の通信パターンでしか表に出ない非対称ルーティングを生むことがあります。エンジニアが急いで省きがちな3段階を、エージェントに任せます。
- 変更前:全ルートテーブルのスナップショットを取り、Cloud WANのルート変更シミュレーションで非対称やブラックホールの危険を確認します。シミュレーションが通らなければ変更しません
- 変更中:Cloud WANのイベントログでトポロジー変更とルート伝播を監視し、伝播が止まったら自動でロールバックします
- 変更後:時間を区切ってパケットキャプチャを取り、TLSハンドシェイクとTCP再送を解析します
サンプルリポジトリのREADMEには、変更後の確認を入れる理由が書かれています。
CloudWatchの標準メトリクスは1分粒度で集計されるので、アラームのしきい値を下回る再送の増加はパケットを見ないと分かりません。
4. 複数シグナルの相関
単独では鳴らないシグナルも、組み合わせると原因を示すことがあります。ブログの例は次の2つです。
- フローログのREJECT率上昇と、同じ時間帯のセキュリティグループ変更(CloudTrail) → ポリシー変更による遮断
- Direct Connectの送信量低下と、同じ仮想インターフェースのBGPプレフィックス受信数の減少 → リンク障害ではなく経路の取り下げ
MCPサーバーを起動して分かったこと
ここからが深掘りした部分です。
サンプルのmcp.jsonに書かれたMCPサーバーのうち3つを手元のMacで起動し、MCPのtools/listでツール一覧を取得しました。
AWSのAPIは呼んでいないので、確かめたのはツールの顔ぶれまでです。実際のアカウントでの調査はしていません。
uvx awslabs.aws-network-mcp-server@latest
uvx awslabs.cloudwatch-mcp-server@latest
uvx --from git+https://github.com/aws-samples/sample-pcap-analyzer-mcp awslabs.pcap-analyzer-mcp-server
NetworkとCloudWatchはこのまま起動しました。
PCAP Analyzerは起動に失敗したので、後述の回避策を入れて起動しています。
Network MCP Serverはツール名が短くなっている
AWS Network MCP Serverは、サーバー名 awslabs.aws-core-network-mcp-server、バージョン1.0.0を名乗り、27個のツールを返しました。
READMEは、すべてのツールがDescribe、Get、Listだけを行う読み取り専用だと説明しています。
また、ツール名がずれていました。
ブログとSKILL.mdはCloud WAN系のツールを長い名前で書いていますが、実際に登録されている名前は「cwan」に縮められていました。
| ブログ・SKILL.md・READMEの表記 | 実際のツール名(1.0.0) |
|---|---|
| get_cloudwan_routes | get_cwan_routes |
| get_all_cloudwan_routes | get_all_cwan_routes |
| simulate_cloud_wan_route_change | simulate_cwan_route_change |
| get_cloudwan_logs | get_cwan_logs |
| get_tgw_details | get_tgw |
| get_vpc_network_details | get_vpc_network |
| get_network_firewall_flow_logs | get_firewall_flow_logs |
ブログのリンク先にあるソースファイル名(get_all_cloudwan_routes.py など)は長い名前のままなので、ファイル名だけを見ると気づきにくいです。
エージェントは説明文から近いツールを選ぶことが多いので、このずれで調査が止まるとは限りません。
ただ、SKILL.mdにツール名を書いて手順を固定するのが目的なら、実際の名前に合わせておく方が確実です。
一方、CloudWatch MCP Serverが返したツールには get_active_alarms、get_alarm_history、execute_log_insights_query があり、SKILL.mdの記述と一致していました。
SKILL.mdのフロントマターが閉じていない
サンプルのSKILL.mdを見ると、区切り線の「---」は1行目と最終行(61行目)の2か所だけです。
descriptionの直後に閉じる「---」がないので、YAMLとして読むと本文全体がフロントマターの中に入ってしまいます。
エージェント側がどこまで厳密に解析するかは実装次第ですが、コピーして使うなら、descriptionの後に「---」を入れて閉じておくのが無難です。
また、ファイル名はリポジトリでは SKILLS.md、ブログ本文では SKILL.md、よくある落とし穴の表では network-triage-skill と、表記が3通りあります。
自分の環境に置くときは1つにそろえておくと迷わないでしょう。
PCAP Analyzerはmcp.jsonのままでは起動しなかった
サンプルのmcp.jsonどおりに起動すると、PCAP Analyzerは次のエラーで終了しました。
AttributeError: 'Server' object has no attribute 'list_tools'
pyproject.tomlの依存は「mcp>=1.17.0」で上限がありません。
そのため、この日に入ったMCP Python SDKは2.2.0で、1.x系のServer.list_toolsデコレーターを前提にしたコードが動きませんでした。
SDKを1.x系に固定すると起動します。
uvx --with "mcp<2" --from git+https://github.com/aws-samples/sample-pcap-analyzer-mcp awslabs.pcap-analyzer-mcp-server
このときの MCP SDK は1.30.0でした。mcp.jsonに書く場合は、args の先頭に "--with", "mcp<2" を足します。
将来リポジトリ側で直る可能性があるので、使う時点で一度起動を確かめてください。
PCAP Analyzerは読み取り専用ではない
PCAP Analyzer MCP Serverはtsharkを呼び出すサーバーで、起動後のtools/listは46個のツールを返しました。
SKILL.mdが使う analyze_tls_handshakes、analyze_sni_mismatches、analyze_tcp_retransmissions のほかに、次のようなツールも含まれています。
- start_packet_capture:ネットワークインターフェースでキャプチャを開始する
- extract_credentials:HTTP Basic認証、FTP、Telnet、SMTP AUTHの平文認証情報を検出する
Network MCP Serverが読み取り専用なのに対して、こちらはキャプチャの開始や認証情報の抽出までできます。
PCAPについて、ブログはSSE-KMSで暗号化し、ローカル(stdio)で動かせばパケットの中身は手元に留まると書いています。
加えて、エージェントに渡すツールを絞る(MCPクライアントの許可リストで解析系だけにする)と、診断エージェントは読み取り専用という原則とそろいます。
導入前にそろえておくもの
ブログは「エージェントの出来は、運用環境の出来で決まる」と書いています。
権限が欠けていたり、フローログがなかったり、タグがなかったりすると、調査は途中で終わります。
データ基盤の3段階
| 段階 | 主なデータソース |
|---|---|
| 構造化 | VPC・TGWフローログ(CloudWatch Logs)、CloudWatch、AWS Config、CloudTrail、Network Firewallログ、DNS Firewallログ |
| 半構造化(パケット) | VPC Traffic MirroringでS3に保存したPCAP(SSE-KMS暗号化) |
| 非構造化 | Amazon Bedrock Knowledge Basesに入れたランブックとADR |
フローログの送り先は用途で分ける
ブログのコストの節では「フローログはS3の方が安い」と書かれ、落とし穴の節では「S3に送るとNetwork MCPのフローログ系ツールが使えない」と書かれています。
一見矛盾しますが、Network MCP ServerのフローログツールはCloudWatch Logs Insightsを使うので、エージェントに調べさせたい範囲はCloudWatch Logsに送る必要があります。
READMEの手順1は、本番アカウントのようにエージェントが調査する範囲はCloudWatch Logs、Logs Insightsが不要な範囲はS3、と使い分ける形になっています。
Transit GatewayをNetwork Managerに登録する
TGWのルートを取るツール(get_tgw_routes、get_all_tgw_routes)は、EC2のSearchTransitGatewayRoutes APIではなくNetwork ManagerのAPIを使います。TGWをAWS Network Managerに登録していないと、エラーを出さずに空の結果を返します。障害調査で「ルートが空だった」と報告されると誤った方向に進むので、最初に登録しておきます。
IAMは最初から全部付ける
Network MCP Serverが必要とする権限はREADMEにまとまっています。
ec2:Describe系、networkmanager:Get系・List系、network-firewall:Describe系、それに logs:StartQuery と logs:GetQueryResults です。
ブログによると、logs:GetQueryResults が1つ欠けただけでフローログ分析がエラーなしで止まります。
細かい点ですが、同じREADMEのFAQは「No flow logs found」の確認項目に logs:FilterLogEvents を挙げている一方、ポリシー例には含まれていません。
フローログが取れないときは、この権限も確認してみてください。
タグとAgent Space
- タグは Environment、Service、Owner を揃えます。
- Environment=Production、Service=PaymentAPI と付いたTGWアタッチメントは、タグなしの tgw-attach-0abc123 よりエージェントに多くを伝えます
- Agent Spaceは本番と非本番を分け、密結合のマイクロサービスは解決担当グループごとに1つにまとめます。狭すぎるとアカウントをまたぐ文脈を見落とし、広すぎるとノイズが増えます
コストの主な要因
- AWS Config:記録する構成項目数に比例します。
ネットワーク系のリソースタイプ(AWS::EC2::SecurityGroup、AWS::EC2::VPC、AWS::EC2::TransitGatewayなど)に絞ります - VPCフローログ:取り込み量に比例する
- CloudTrail:リージョンごとに最初の管理イベント証跡は無料
- VPC Traffic Mirroring:ENI時間に比例します。調査中や変更確認の時間帯だけ、数分単位で使います
自律させる範囲と人間が承認する範囲
エージェントに任せる度合いは、操作の重さで段階的に変えます。
| 操作 | 進め方 |
|---|---|
| 読み取り専用の調査、変更前のシミュレーション | エージェントが自律して実行する |
| ルート変更の提案 | シミュレーションは自律、本番に反映するかはエンジニアが承認・却下する |
| セキュリティグループ、Network Firewallのルール変更 | エージェントは変更案とロールバックコマンドを用意し、実行と確認はエンジニアが行う |
| 本番のTGWルート、Direct Connect VIFの変更 | エージェントは証拠を示して待ち、明示的な承認があるまで何もしない |
そのうえで、次の仕組みを組み合わせます。
-
IAMの分離:診断用は読み取り専用にします。
修復用は人間の承認後にだけ別ロールを引き受け、Environment: production タグのリソースへの書き込みはタグ条件で拒否します - 監査:STS AssumeRoleのRoleSessionNameにインシデントのチケットIDを入れます。CloudTrail上で、どのAPI呼び出しがどのインシデントのものか一意に分かります
- 3段階のゲート:構文(リソースは存在するか)、意味(ルーティングループを作らないか)、影響(1回のAPI呼び出しで戻せるか)
- 出力の制御:Amazon Bedrock Guardrailsで、IPアドレスは組み込みのPIIフィルター、アカウントIDはRegexesConfigによるカスタム正規表現でマスクする
効果の測り方
導入前にベースラインを取り、MTTR、調査の正確さ、運用効率(夜間呼び出しの削減など)を追います。READMEは例として、手作業で45〜90分かかっていたよくある障害を10分未満にする、という目標値を挙げています。
調査の件数が増えると、全件を人が確認するのは難しくなります。
そこでLLM-as-a-Judgeとして、調査の記録一式(アラート、ツール呼び出し、推論、根本原因)を別のBedrockモデルに渡して採点させます。
- ペア比較:エージェントの根本原因と、エンジニアが確定させた根本原因が意味的に一致するかを判定する
- ルーブリック採点:根本原因の正しさ、証拠の網羅性、推論の一貫性、手順の遵守を1〜5で採点し、手順の遵守を最も重く扱います
- 継続的な較正:定期的に人間の専門家の採点と比べ、一致率が85%を下回ったら評価プロンプトかモデルを見直します
ブログによると、証拠の網羅性のスコアが下がるときは、たいていデータ基盤に穴があります。READMEは例として、新しいVPCでフローログを有効にし忘れた、TGWをNetwork Managerに登録していない、といったケースを挙げています。
小さく始める手順
ブログとREADMEは、初日からすべてをそろえる必要はないとして、次の順番を示しています。
- 本番アカウントでVPCフローログをCloudWatch Logsに送る
- Transit GatewayをAWS Network Managerに登録する
- Environment、Service、Ownerのタグをそろえる
- Network MCP Server用のIAMポリシーを用意する
- DevOps AgentのWebアプリでSKILL.mdを作り、Agent Spaceに割り当てる
- Network MCP Serverをつなぎ、次のインシデントで使う
- 導入前後のMTTRを比べ、残りを整える判断材料にする
プロンプトの書き方も具体的に示されています。
「なぜネットワークが遅いのか」のような聞き方だとエージェントは何でも取りに行ってトークンを使います。
スキル名、送信元と宛先のVPCとIP、時間帯(13:30〜15:30Zなど)、調べなくてよいもの(DNSは解決できる、RDSは正常など)、安全上の制約(読み取り専用、変更前の状態を先に取る)を書くと、調査が短くなります。
読み終えて
ブログは最後に
エージェントは運用の規律を増幅するもの
とまとめています。
タグ付け、フローログ、ランブックが整っているチームほど改善幅が大きいと書かれています。
読み比べると、この主張は具体的な設定項目に見られました。
フローログがCloudWatch Logsにないとフローログ系ツールは使えず、TGWが未登録だとルート系ツールはエラーなしで空を返し、logs:GetQueryResults が欠けるとフローログ分析が黙って止まる、とブログとREADMEは書いています。
どれもモデルの性能とは関係のない、環境側の準備です。
試す場合は、まずIDEエージェントからNetwork MCP Serverを読み取り専用のプロファイルで使うのが手軽です。
サンプルのSKILL.mdとmcp.jsonを使うなら、ツール名、SKILL.mdの区切り線、PCAP AnalyzerのSDKのバージョンの3点を手元の版に合わせてから使ってみましょう。
最後まで読んでいただきありがとうございました。
参考
- AI best practices for AWS network operations with AI agents and MCP(AWS Networking & Content Delivery Blog、2026-09-25)
https://aws.amazon.com/blogs/networking-and-content-delivery/ai-best-practices-for-aws-network-operations-with-ai-agents-and-mcp/ - aws-samples/sample-Gen-AI-best-practices-for-network-operations
https://github.com/aws-samples/sample-Gen-AI-best-practices-for-network-operations - AWS Network MCP Server
https://github.com/awslabs/mcp/tree/main/src/aws-network-mcp-server - aws-samples/sample-pcap-analyzer-mcp
https://github.com/aws-samples/sample-pcap-analyzer-mcp - AWS Agent Registry(Amazon Bedrock AgentCore Developer Guide)
https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/registry.html