
はじめに
AIが作ったものを画面に映すのではなく、自分の目で直接見たい。
指示もキーボードを打たずに出したい。
そう考えて
「AIで脳に信号を送り、それが網膜に映し出される」
ことは実現できるのかを調べました。
先に結論を書きます。
- 「網膜に映す」は方向が逆です。脳を経由して見せる像は、網膜ではなく視覚野で生じます
- 自分の目で見るだけなら、脳に触れず網膜へ直接投影する方式が最短です
- キーボードは筋電・音声が先に不要になり、脳から文字への変換は医療用途が先です
- ソフトウェア側はAWSで試作できます。電極や光学系はAWSでは再現できません
この記事は調査と設計をまとめたもので、実装はしていません。
実装は別の機会に行います。
数値は論文か公式発表を根拠にしています。
報道など二次情報でしか確認できなかった箇所は、その旨を書き添えました。
「今」「数年」などの見通しは、私の判断です。
「脳から網膜へ」は経路が逆向き
網膜は目の入り口にある器官で、光を電気信号に変えて脳へ送ります。
私が調べた範囲では、脳から網膜へ像を送り返す経路は確認できませんでした。
脳を直接刺激して像を見せる場合、生じるのは網膜に映った像ではなく、視覚野での「見えた」という知覚です。
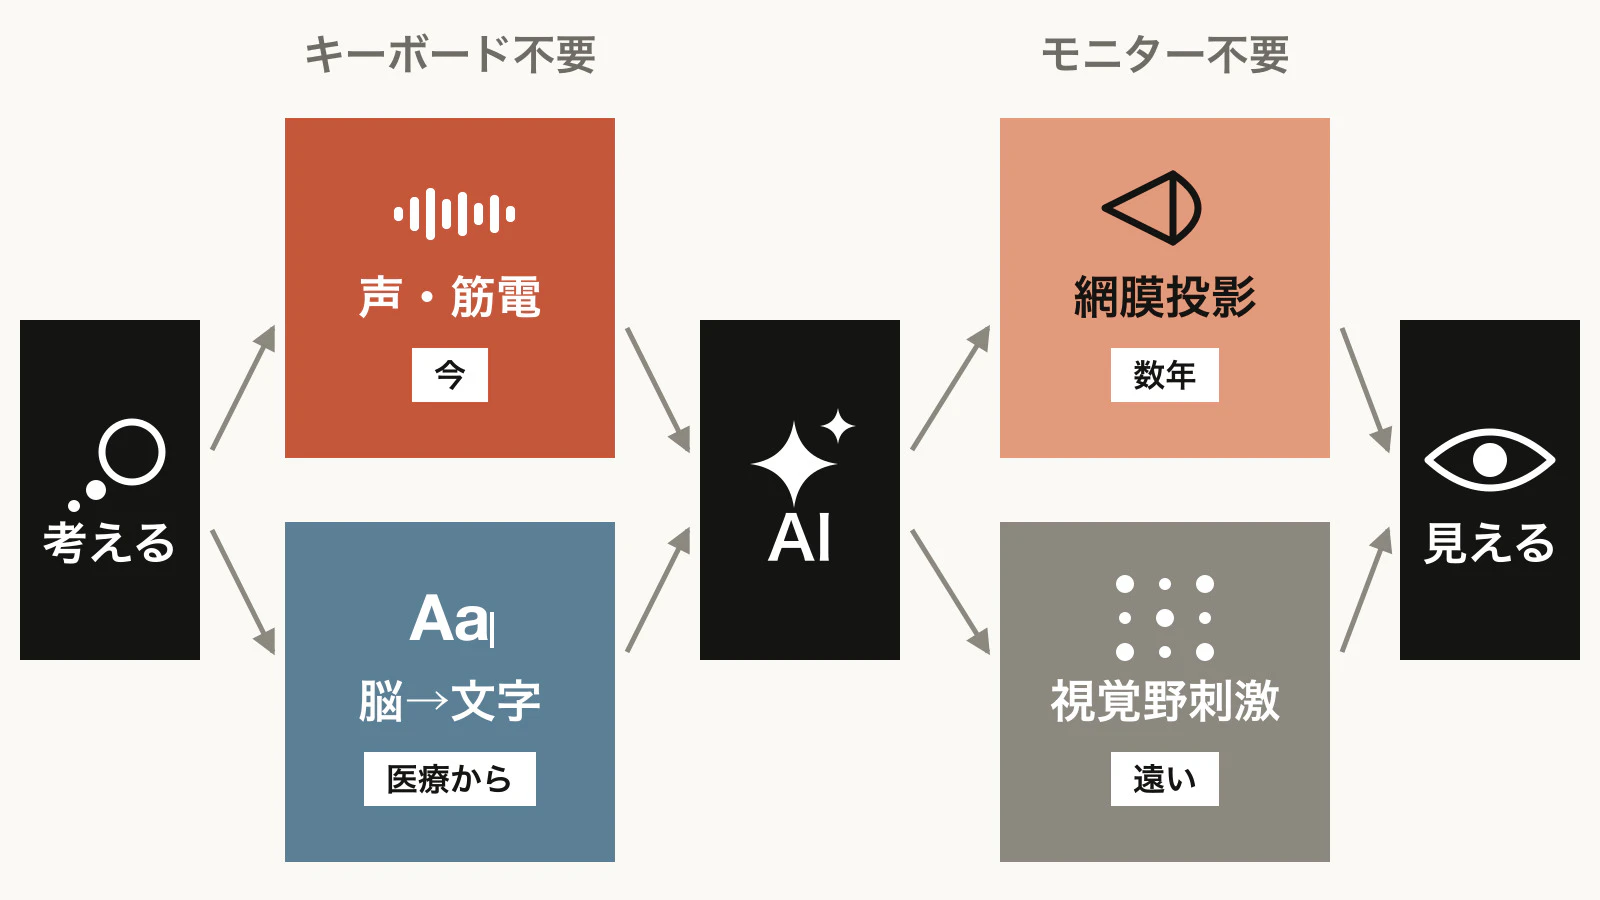
冒頭の問いは、次の2つに分けて考えることになります。
- 出力(モニターの代わり):AIが作った映像を、どうやって自分の視覚にするかという問題です
- 入力(キーボードの代わり):自分の意図を、どうやってAIに渡すかという問題です
全体の流れは、左に入力、右に出力を置き、間にAIが入る形です。
モニターなしの出力は2つの道がある
網膜投影は手術なしで自分の目に映る
光を瞳の中心に細く絞って通し、網膜へ直接描く方式です。
これは、水晶体のピント調節を経由しないので、近視や遠視でも像がボケません。
製品はすでにあります。
- QDレーザの網膜走査型ディスプレイ:RGBレーザーとMEMSミラーで網膜へ直接走査するピントフリー方式。弱視の人向けの用途が中心です
- MetaのOrion(2024年発表、報道による):対角70度の両眼ARグラスの試作機。マイクロLEDと炭化ケイ素の導波路を使っています
- MetaのRay-Ban Display(2025年発売):右目だけの単眼表示で、反射型の導波路を使っています。表示は600×600画素とされます(二次情報)
OrionとRay-Ban Displayは導波路方式で、網膜走査そのものではありません。
コンタクトレンズ型を目指したMojo Visionは、2023年にレンズの開発を保留し、マイクロLEDディスプレイ事業へ転換しました。
課題は光学設計です。
- 視野と、瞳の位置ずれを許容する範囲(アイボックス)は、光の広がりの保存則によりトレードオフになります
- 視線が動いても像が消えないよう、視線追跡で出射瞳を追従させる必要があります
- 視力1.0相当(1度あたり60画素)で水平・垂直とも100度を埋めると、片目で約3,600万画素になります(私の試算)
画素数は、注視点だけを高精細にする中心窩レンダリングで減らせます。
AIが入る場所は視線追跡、ホログラムの位相計算(ニューラルホログラフィ)、生成映像の視線条件付き配信です。
ニューラルホログラフィはStanfordのPengらがSIGGRAPH Asia 2020で報告していて、コードも公開されています。
視覚野への直接刺激はまだ点の集まり
視覚野を電気刺激すると、光の点(ホスフェン)が見えます。
複数の点を同時に刺激して像を作る方式です。
- 96電極のUtah Arrayを、完全に失明した57歳の被験者に6か月間埋め込み、一部の文字と物体の輪郭を識別できました(Fernándezら、J Clin Invest 2021年)
- 電極を順番に刺激して文字の輪郭を「なぞる」動的刺激で、盲人2名を含む被験者が文字を認識しました(Beauchampら、Cell 2020年)
- サルの視覚野に1,024チャンネルを埋め込み、複数電極の刺激で形を知覚させました(Chenら、Science 2020年)
- Neuralinkの視覚補助向けBlindsightは、2024年9月にFDAのBreakthrough Device指定を受けました。ヒトへの埋め込み実績は、私が調べた範囲では確認できませんでした
96電極という規模は、実用的な視覚に必要な点の数(数百から数千点以上と予測)に届きません。現状の課題としては
- 電極1本で動くニューロンが多くて点がにじむこと
- 開頭手術と長期の組織反応が残ること
の2つが一般に指摘されています(個別の論文は確認していません)。
また、帯域の桁も違います。
網膜の神経節細胞は片眼で約100万個と推定され、網膜の出力は約10Mbpsと見積もられています(Kochら、Current Biology 2006年)。
これはモルモットの網膜約10万個の実測値からヒトへ入れ替えた場合の推定となります。
1,000電極を毎秒10回刺激し、1回を1ビットと数えても約10kbpsで、約3桁小さくなります(私の試算)。
網膜そのものに埋め込む方式もあります。
Science CorpのPRIMAは、患者38名に埋め込まれました。
12か月時点で評価できた32名のうち26名(81%)に、臨床的に意味のある視力改善が報告されています(NEJM 2025年)。
対象は、加齢黄斑変性による地図状萎縮の患者です。
キーボードなしの入力も2つの道がある
筋電と音声は今すぐ使える
手首の筋電位を読むMetaのNeural Bandは、意図した微小な指の動きを非侵襲で入力に変えます。
Nature 2025年の論文では、個人ごとの較正なしで動く汎用モデルで、空中の手書き入力が毎分20.9語でした。
Neural Bandは2025年9月30日にRay-Ban Displayとのセットで発売されています。
音声入力と合わせれば、手術なしでキーボードがいらなくなります。
音声入力っていいですよね
脳から文字への変換は医療用途が先
運動野や発話関連野の神経活動を電極で読み、AIが音素、文字へ変換する方式です。
| 研究 | 方式 | 結果 |
|---|---|---|
| Willettら(Nature 2023年) | 皮質内電極256本、ALS患者1名 | 毎分62語。語彙12.5万語で単語誤り率23.8% |
| Metzgerら(Nature 2023年) | 脳表面電極253チャンネル、脳幹卒中の患者1名 | 毎分約78語。語彙1,024語の一般文で誤り率25.5% |
| Cardら(NEJM 2024年) | 皮質内電極256本、ALS患者1名 | 8.4か月間、精度97.5%を維持。毎分約32語 |
Kunzら(Cell 2025年)は、頭の中で発話する内語の一部も変換できたと報告しています。
被験者は4名です。
頭の中の思考が意図せず出力されないよう、特定のキーワード(論文では「Chitty Chitty Bang Bang」)を思い浮かべたときだけ有効になる仕組みが入っています。
このキーワードの検出精度は98%を超えたとされます。
ただし、単語誤り率は語彙12.5万語で26〜54%でした。
現在の成功例は、話そうとする運動の意図を読む方式で、任意の思考を読み取るものではありません。
実用の壁は次の3つです。
- 頭蓋内へのインプラントが前提になります
- 電極の位置や信号が日ごとに変わり、毎日の再較正が必要になります
- 非侵襲の方式は精度が足りません。MetaのBrain2Qwertyは、公開された初版(arXiv)で、文字誤り率がMEGで32%、EEGで67%でした
4つの道を並べる
| 方式 | 目的 | 手術 | 見通し(私の判断) |
|---|---|---|---|
| 網膜投影 | 自分の目で見る | 不要 | 数年 |
| 筋電・音声 | キーボード不要 | 不要 | 製品化済み |
| 脳から文字 | 思考入力 | 必要 | 医療用途が先 |
| 視覚野刺激 | 目も不要 | 必要 | 自然な視覚は数十年単位 |
「キーボードもモニターもない世界」は、網膜投影と筋電・音声の組み合わせで、手術なしにほぼ届きます。
脳への接続が必要になるのは、目や手が使えない人への医療用途か、感覚そのものを置き換えたい場合です。
AWSで試作するなら
ソフトウェア側はAWSで再現できます。
電極、光学、レーザー、MEMSミラーは再現できません。
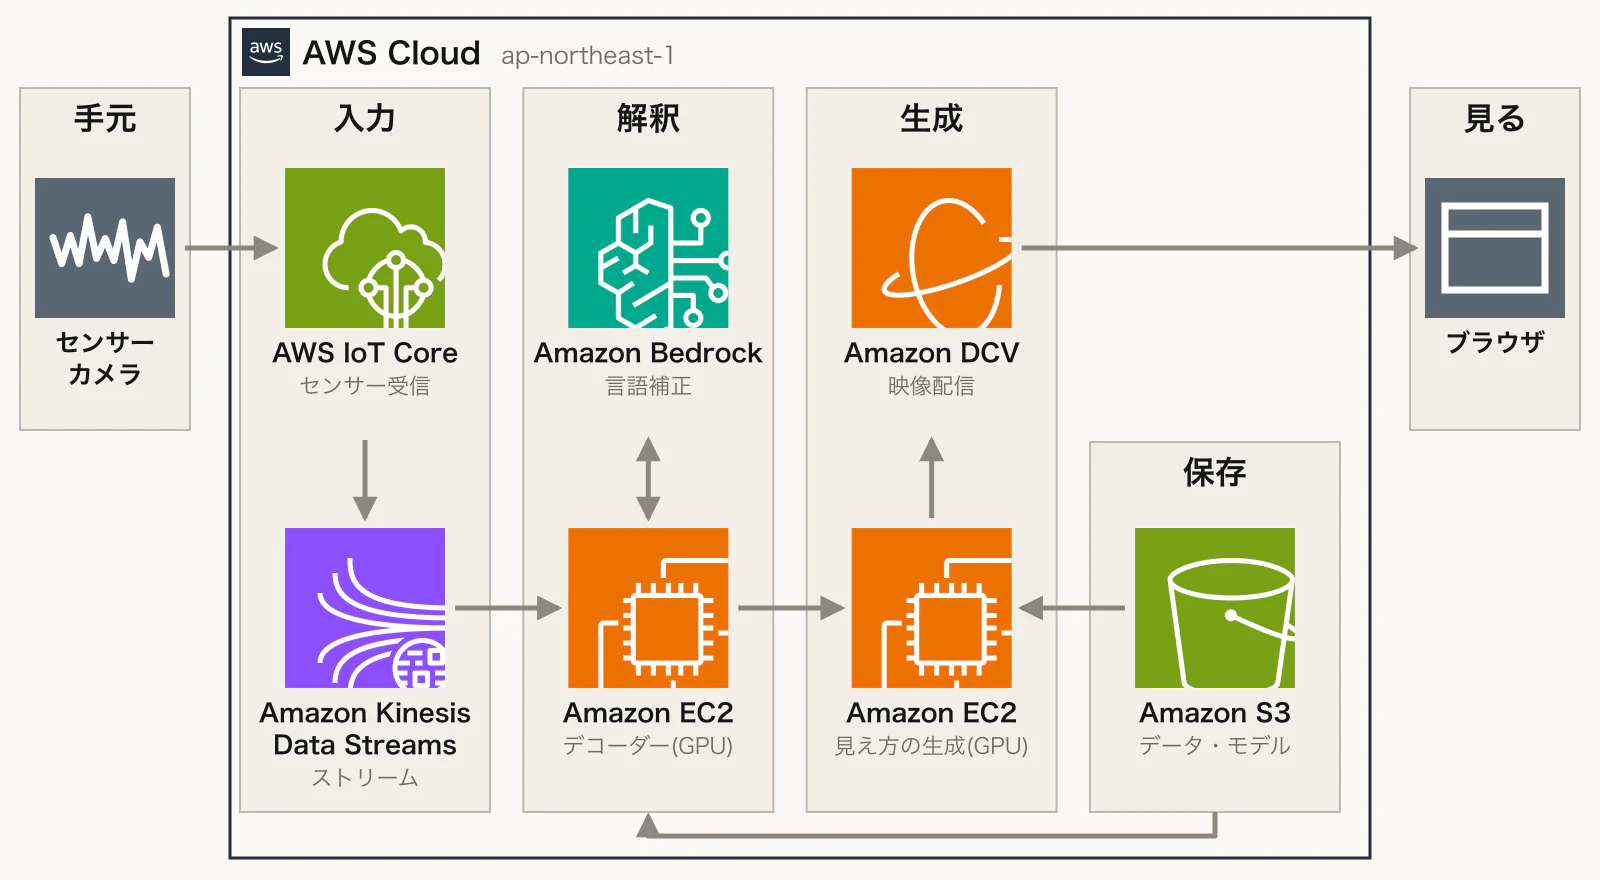
構成は次の通りです。リージョンはap-northeast-1を想定しています。
- 入力:AWS IoT CoreとAmazon Kinesis Data Streamsで、センサーの流れを受けます。公開データの再生もここに流します
- 解釈:Amazon EC2のGPUで、GRUとCTCによるデコーダーを動かします。Amazon Bedrockで言語モデル補正をかけます
- 生成:Amazon EC2のGPUで、視覚野刺激のシミュレーターやホログラムの位相計算を動かします。Amazon DCVでブラウザへ映像を届けます
- 保存:Amazon S3にデータセットとモデルを置きます
デコーダーの学習データは公開されています。
Willettら(2023年)のデータはDryadに、Card他(2024年)のデータを使ったKaggleのコンペ「Brain-to-Text '25」もあります。
筋電はMetaのemg2qwertyデータセット(108名、346時間分)が公開されています。
ライセンスはCC BY-NC-SA 4.0で、商用利用はできません。
視覚野刺激の側は、Dynaphos(eLife 2024年)が、電流から知覚される像を予測する微分可能なシミュレーターとして公開されています。
制約も4つあります。
- 視線追跡から出射瞳の追従までの閉ループは、遅延の都合で端末側に置きます。
AWSに往復すると間に合いません - このアカウントのAmazon SageMaker AIは、GPU学習ジョブのクォータが0でした(2026年9月時点、ap-northeast-1)。
学習はEC2のGPUで行うか、小さなGRUならCPUで行います - 公開データを使えば神経データの扱いは軽くなります。
自分の脳波や筋電を録る場合は、暗号化と保存期間を決めます - 料金はインスタンスとリージョンで変わるため、着手前に確認します
最初に作るもの
最初の試作は「疑似皮質視覚デモ」にします。
Webカメラの映像を、電極1,000本で表現した場合のホスフェン像に変換して、ブラウザに映します。
理由は3つあります。
データ収集が要らないこと
体験としてすぐ見せられること
AWSだけで完結することです
それができたら、公開データを使った脳から文字へのデコーダーの再現へと進む予定です。
終わりに
冒頭の問いに戻ります。
「脳に信号を送って網膜に映す」は、網膜という言葉が実態と合いません。
一方、脳へ信号を送って像を見せること自体は、点の集まりという形ですでに実現しています。
自然な映像には遠く、数十年単位の課題です。
自分の目で見たいという目的だけなら、脳に触れず網膜へ直接投影する方式が最短で、入力は筋電と音声が先に届きます。
手術が必要な部分を待たなくても、モニターとキーボードの大半は外せる見込みです。
実装はまだしていません。着手する際は、疑似皮質視覚デモから始めます。
最後まで読んでいただきありがとうございました。
参考
- Willett et al., Nature 2023: https://pmc.ncbi.nlm.nih.gov/articles/PMC10468393/
- Metzger et al., Nature 2023: https://www.nature.com/articles/s41586-023-06443-4
- Card et al., NEJM 2024: https://doi.org/10.1056/nejmoa2314132
- Kunz et al., Cell 2025: https://pubmed.ncbi.nlm.nih.gov/40816265/
- Fernández et al., J Clin Invest 2021: https://www.jci.org/articles/view/151331
- Beauchamp et al., Cell 2020: https://www.cell.com/cell/fulltext/S0092-8674(20)30496-7
- Chen et al., Science 2020: https://www.science.org/doi/10.1126/science.abd7435
- Koch et al., Current Biology 2006: https://www.cell.com/current-biology/fulltext/S0960-9822(06)01639-3
- Meta sEMG, Nature 2025: https://www.nature.com/articles/s41586-025-09255-w
- Science Corp PRIMA, NEJM 2025(プレスリリース): https://www.businesswire.com/news/home/20251020014793/en/
- Neuralink Blindsight(FDA指定): https://neuralink.com/updates/neuralink-receives-breakthrough-device-designation-for-blindsight/
- Meta Orion(報道): https://www.uploadvr.com/meta-connect-2024-orion-prototype-ar-glasses/
- Brain2Qwerty (arXiv): https://arxiv.org/abs/2502.17480
- Neural Holography: https://github.com/computational-imaging/neural-holography
- Dynaphos (eLife 2024): https://elifesciences.org/articles/85812
- Willett 2023 データ(Dryad): https://datadryad.org/dataset/doi:10.5061/dryad.x69p8czpq
- Brain-to-Text '25 (Kaggle): https://www.kaggle.com/competitions/brain-to-text-25
- emg2qwerty: https://github.com/facebookresearch/emg2qwerty