
1.要旨
VRAM 16GBのRTX 4080で、ファイルサイズ約84GBのQwen3.8-Flash-Next(IQ3_S)を動かした。STRATAでホストRAM 64GBと併用し、生成速度は約49 token/sになった。単独の生成速度では、統合メモリ128GBのDGX Spark+vLLM(MTP3)を上回った。
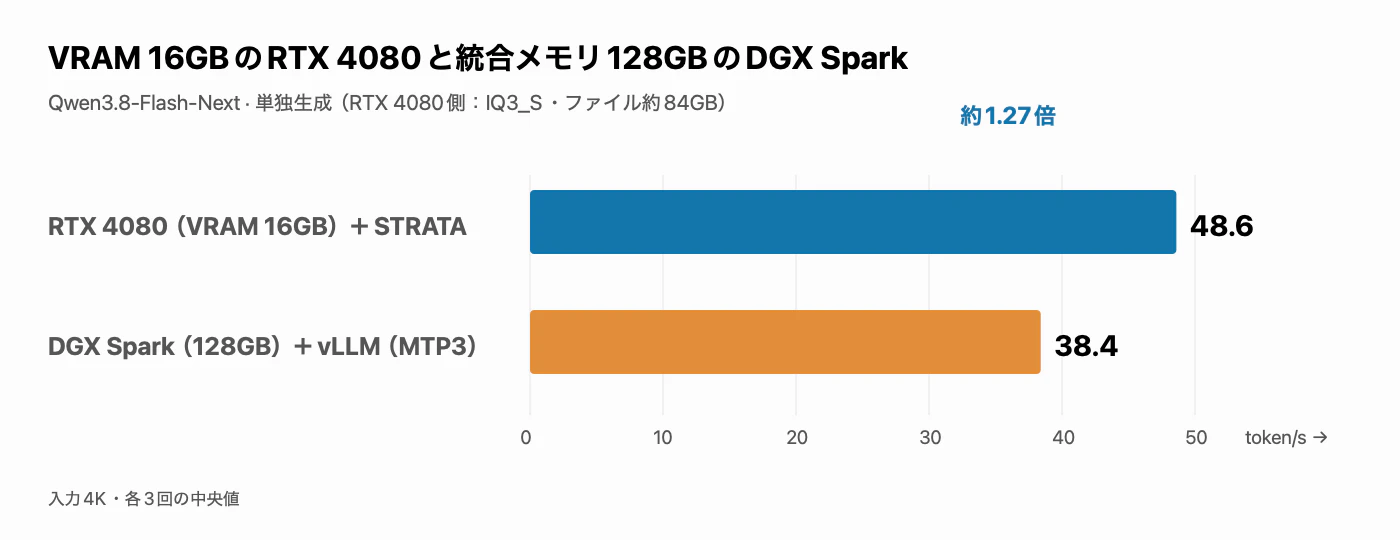
| 構成 | 生成速度(token/s) |
|---|---|
| RTX 4080(VRAM 16GB)+STRATA | 48.6 |
| DGX Spark(統合メモリ128GB)+vLLM(MTP3) | 38.4 |
| RTX 4080搭載PC | DGX Spark | |
|---|---|---|
| CPU | Ryzen 7 3700X | GB10・20コアArm CPU |
| GPU | RTX 4080 16GB | Blackwell GPU |
| メモリ | 64GB DDR4-3200 | 128GB LPDDR5x統合メモリ |
| SSD | Samsung 980 PRO 1TB(NVMe) | 4TB NVMe M.2 |
| モデル | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
| 量子化 | IQ3_S | FP4-Local |
| 推論エンジン | STRATA 0.2.8/engine 0.1.54 | vLLM・MTP3 |
グラフは入力4K・各3回の中央値。
2.速度改善
1. expertを全量常駐させる(23.4→36.5 token/s)
expertの一部がSSDに残り、生成中も読み出していた。RAMに空きはあったが、Windowsのコミット上限に近く、常駐量を増やせなかった。
ページファイルを自動管理の4GiBから32GiB固定に変更した。コミット上限は約68GiBから約96GiBに増えた。
他アプリを停止してRAM・VRAMを空け、ロード中のメモリ不足には次の設定を追加した。
STRATA_FILE_RELEASE=1
STRATA_UNBUFFERED_LOAD=1
RAMへコピーしたファイルデータを読み込み中に解放する設定だ。GPUキャッシュ(--expert-cache)とRAM常駐量(--resident-budget-gib)も調整し、expert全量をRAMとVRAMに置いた。
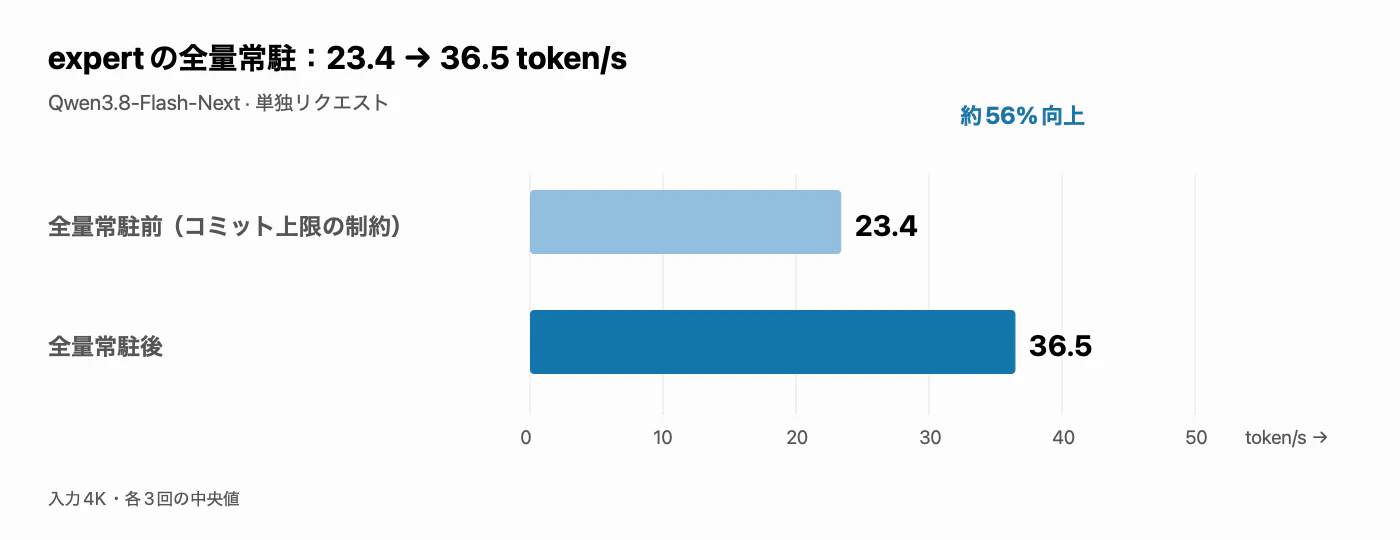
| 配置 | 生成速度(token/s) |
|---|---|
| 全量常駐前 | 23.4 |
| 全量常駐後 | 36.5 |
比較元は、変更前のコミット上限に合わせて常駐量を増やした構成。ページファイルの拡大と読み込み・配置の調整により、生成時のexpertのSSD読み出しがなくなり、約56%速くなった。
2. MTPを有効にする(36.5→44.7 token/s)
MTPのdraft層を追加し、--mtp でフォルダを指定した。設定は --spec 4 --spec-min-p 0.5。
draft層に約1GiBのVRAMを使うため、GPUキャッシュを減らしてRAM側へ移し、全量常駐を維持した。

| 構成 | 生成速度(token/s) |
|---|---|
| MTPなし | 36.5 |
| MTPあり | 44.7 |
生成速度は約22%向上した。draftの採択率は約66%。
3. メモリの動作速度を上げる(44.7→48.6 token/s)
DDR4-3200定格のメモリが2667で動いていた。3200動作に変更した。

| メモリ動作速度 | 生成速度(token/s) |
|---|---|
| DDR4-2667 | 44.7 |
| DDR4-3200 | 48.6 |
STRATAの設定は変えず、約9%速くなった。
3.まとめ
RTX 4080でこんなに大きなモデルを高速に動かせるというのは衝撃的な結果だ!
DGX Sparkの存在意義が問われかねない。
今後、並列処理やコンテキスト長などを深堀りしていきたい。