
DGX Sparkでは、仕事に合わせて複数のローカルLLMをとっかえひっかえ使っている。モデルを切り替えるたびに待たされるので、切替時間を短くしたい。
中でも重いのがNemotron 3.5 Super VL 120B-A12B(NVFP4、重み70GiB)で、切替に11分かかっていた。これを83秒にした。同時に保持できる文脈の量(KVキャッシュ)は変えていない。
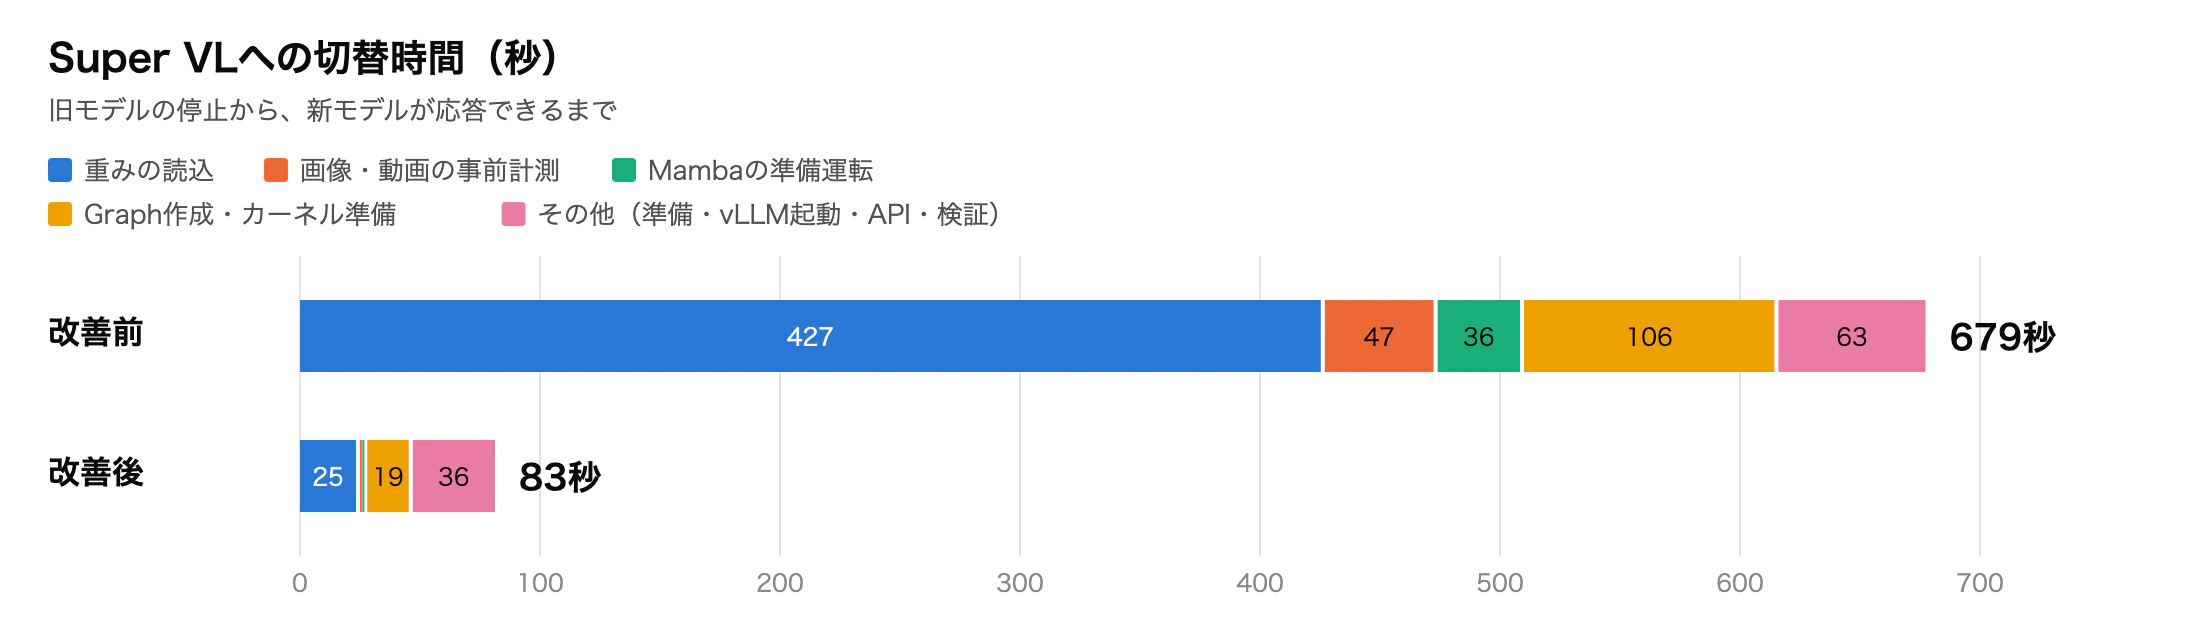
改善前:どこに時間がかかっていたか
切替は自作の管理ツールが行う。旧モデルの停止から新モデルが応答できるまでの各段階に時刻を記録し、vLLMのログと突き合わせて5つに分けた。
| 段階 | 改善前(秒) | 中身 |
|---|---|---|
| 重みの読込 | 427 | 70GiBのモデルファイルを読み、GPUへ配置する |
| 画像・動画の事前計測 | 47 | 最大長の動画をエンコーダに通し、必要なメモリを測る |
| Mambaの準備運転 | 36 | Mamba層のカーネルをコンパイルし、試しに動かす |
| Graph作成・カーネル準備 | 106 | CUDA Graphの記録と、それに使うカーネルのコンパイル |
| その他 | 63 | コンテナ起動、vLLM起動、API起動、応答確認 |
| 合計 | 679 |
全体の63%が重みの読込だった。
改善の内容

1. 高速ローダーに替える(重みの読込 427→25秒)
vLLM標準のローダーは、モデルファイルをmmapで開き、テンソルを1つずつ取り出してGPUへ配置する。70GiBを409秒、毎秒約184MBで読んでいた。
--load-format fastsafetensors に替えると、ファイルをまとめて読んでからGPUへ渡す。本体の重みは16秒(毎秒約4.6GB)で読め、読込全体は25秒になった。
あわせてKVキャッシュの量を --kv-cache-memory 19252190904(17.93GiB)で固定した。理由は末尾の参考に書く。
2. コンパイル済みカーネルを残す(Graph作成・カーネル準備 106→19秒)
CUDA Graphの記録では、FlashInferなどがGPU用のカーネルをその場でコンパイルする。保存先がコンテナ内だったため、起動のたびに作り直していた。
CUDA・FlashInfer・b12xのキャッシュの保存先を、再起動後も残るボリュームへ移した。コンパイルを含めて71秒かかっていたGraph記録が7秒になった。さらにKVを固定すると、メモリ見積もりのためのこの記録自体が不要になる。
3. Tritonのキャッシュを残す(Mambaの準備運転 36→2秒)
Super VLは、Transformerと、長い文脈を少ないメモリで扱うMamba層を組み合わせたモデルだ。Mamba層の計算部品は、起動時にTriton(GPU用のカーネルをその場でコンパイルする仕組み)がコンパイルする。
このキャッシュは /tmp/torchinductor_root と /root/.triton に置かれ、コンテナの再起動で消えていた。環境変数を2つ足し、残るボリュームへ移した。
ENV TRITON_CACHE_DIR=/root/.cache/vllm/p064-super/triton
ENV TORCHINDUCTOR_CACHE_DIR=/root/.cache/vllm/p064-super/inductor
4. 動画の事前計測をやめる(画像・動画の事前計測 47→1秒)
vLLMは起動時、画像・動画のエンコーダに最大長の動画を1本通して、必要なメモリを測る。今の用途は文章と画像なので、--limit-mm-per-prompt.video 0 で動画入力を止めた。事前計測は最大サイズの画像1枚になり、1秒で終わる。
その他の63→36秒には直接手を入れていない。
改善後も、生成速度(1要求あたり約75トークン/秒)、画像の読み取り、ツール呼出し、8要求の同時処理、約25万トークンの長文入力は改善前と同じように動く。
参考:高速ローダーだけだとKVキャッシュが減る
高速ローダーに替えただけでは、KVキャッシュに入るトークン数が111.5万から87.5万へ減った。
vLLMは起動中に、総メモリの81%から「重みとその他の消費」を引いた残りをKVキャッシュにする。DGX SparkはCPUとGPUでメモリを共有するので、「その他の消費」はシステム全体の空きの減り方で測る。
改善前の起動では、計測の直前に同居する別のプロセスのメモリが2.6GiBスワップへ追い出され、空きが増えて見えていた。高速ローダーではそれが起きないので、KVが小さく出る。そこでKVを改善前と同じ17.93GiBに固定した。
環境
- NVIDIA DGX Spark(GB10、メモリ128GB)
- vLLM
0.32.0rc1.dev100+g77154ca61、PyTorch2.13.0+cu130、fastsafetensors0.4.0、FlashInfer0.7.0.post1 - モデル:Nemotron 3.5 Super VL 120B-A12B(NVFP4)、文脈長262,144、同時8要求、投機デコードDFlash(7トークン)