

グラレコ
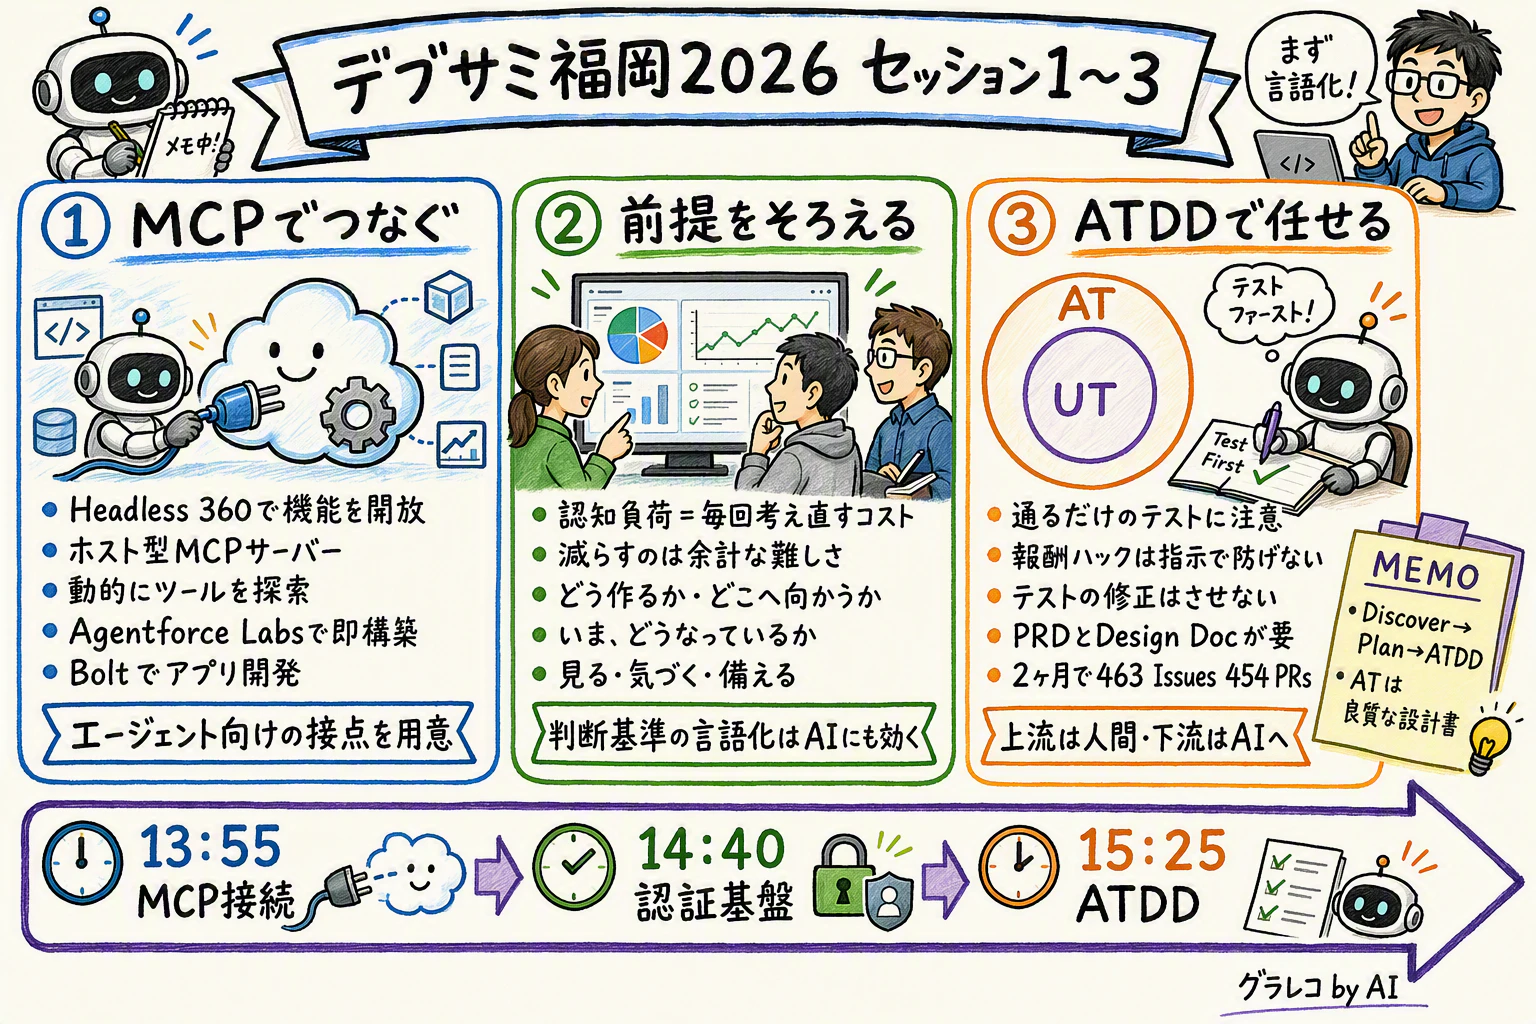
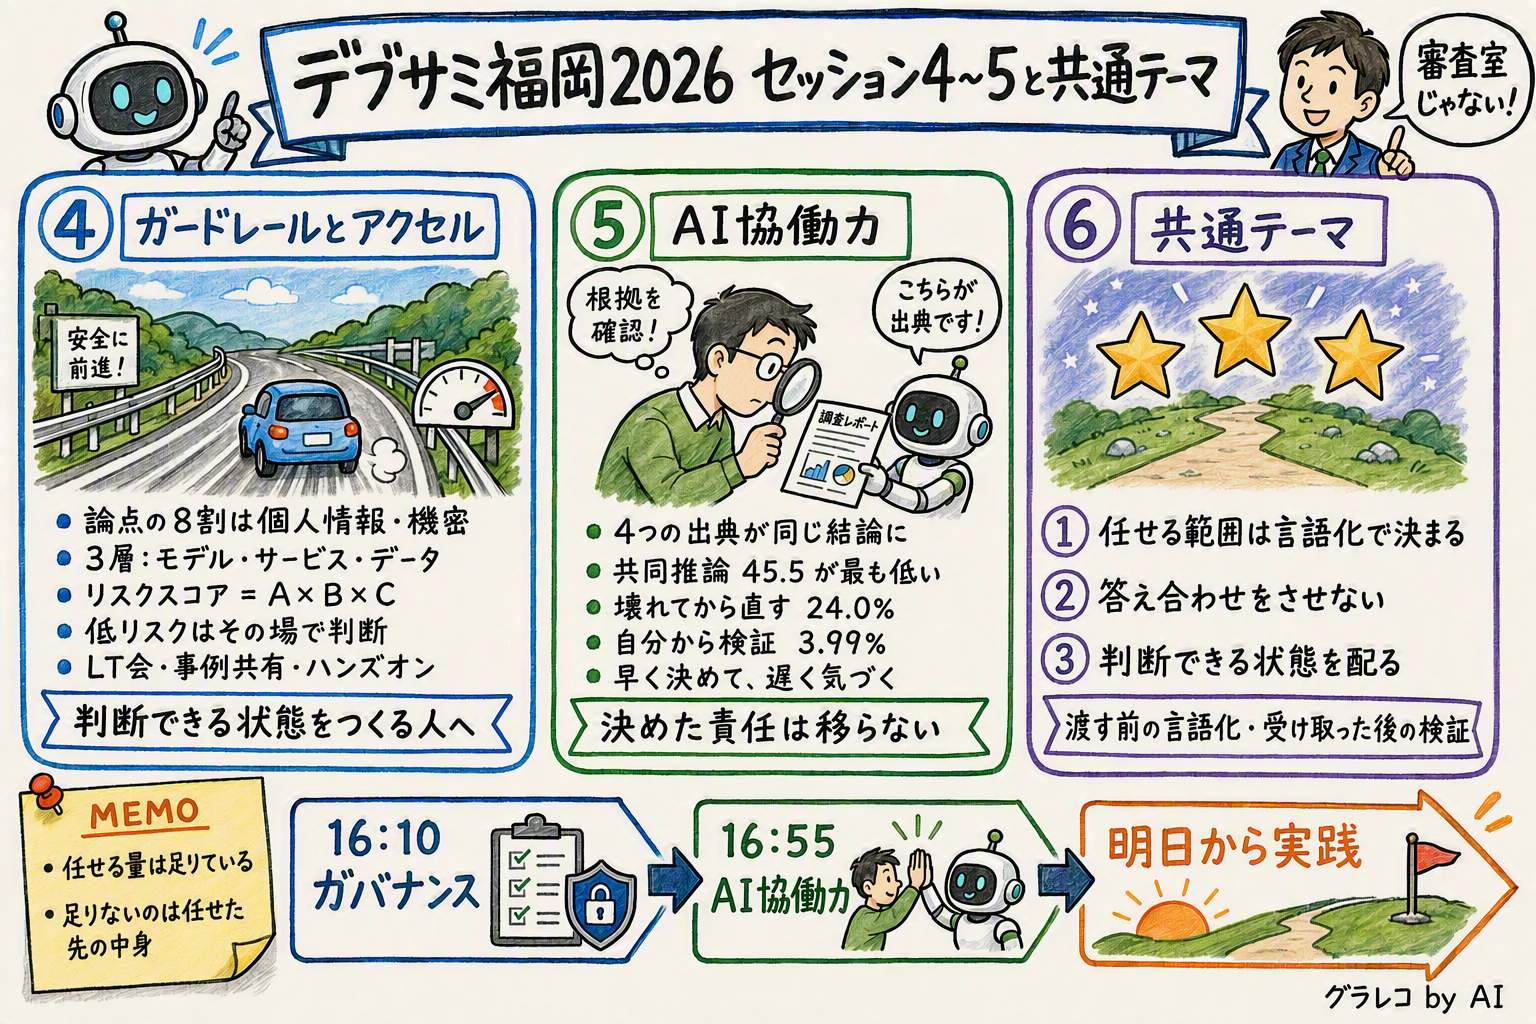
この日の5セッションを、2枚のグラレコにまとめています(1枚目がセッション1〜3、2枚目がセッション4〜5と共通テーマ)。それぞれの詳細は本文で順に見ていきます。
はじめに
Developers Summit 2026 FUKUOKA(デブサミ福岡2026)は、翔泳社が主催する開発者向けカンファレンスの福岡開催です。2026年9月11日に開催され、この日は5つのセッションを聴講してきました。
この記事では、聴講した5セッションの内容を、講演の流れに沿ってできるだけ細かく整理します。扱うテーマは、Salesforce/SlackとAIエージェントのMCP接続、金融の認証基盤を支えるチーム設計、受け入れテスト駆動開発(ATDD)、AI活用のデータガバナンスと組織設計、そして100万件の評価データから見えた「AI協働力」です。分野は接続技術から採用データまでバラバラなのですが、終わってみると、どのセッションも「AIに任せる前に、人間側が何を言語化しておくか」──接点、判断基準、要件、データの線引き、そして判断の起点──という同じ場所を指していて、そこがこの日いちばんの読みどころでした。長い記事ですが、最後の「共通テーマ」まで読んでいただけると、2026年秋時点のAI×開発の現在地が立体的につかめると思います。
💡 本記事は筆者個人の聴講メモに基づくレポートです。講演の全内容を網羅・正確に再現するものではなく、講演中の数値や引用文献はスライドからのメモで独自検証はしていません。文責はすべて筆者にあります。
福岡の全体像 🗓️
聴講したセッションのタイムテーブルです。
| 時間 | セッション | 登壇者 |
|---|---|---|
| 13:55–14:25 | AI エージェントに Salesforce と Slack をつないでみたら ~MCPとスキルで変わる開発の「いま」~ | 稲葉 洋幸氏・odasho(小田 祥平)氏(セールスフォース・ジャパン) |
| 14:40–15:10 | 金融サービスを支える認証基盤を"止めないために磨き続ける" | 諏訪 裕司氏(ふくおかフィナンシャルグループ)・東 卓弥氏(New Relic) |
| 15:25–15:55 | なぜ「テストが通った」はAI時代に信用できなくなったのか 〜受け入れテスト駆動開発(ATDD)にたどり着くまで〜 | 大園 博昭氏(KINTOテクノロジーズ) |
| 16:10–16:40 | AI推進室がAI審査室になりかけた話 ~生成AI活用を加速するためのデータガバナンスと組織設計~ | 松山 祐己氏(セゾンテクノロジー) |
| 16:55–17:25 | AI協働力:100万件の評価データが示す、コードの外側で評価が決まる時代のキャリア | 泉水 翔吾氏(ハイヤールー) |
先にネタバレ気味に言ってしまうと、この5本は「①AIに任せる範囲は、人間側の言語化の量で決まる」「②AIに自分の答え合わせをさせない。判断の起点を自分に置く」「③判断を中央に集めず、『判断できる状態』を配る」という3つのテーマで、きれいにつながっていました。それぞれのセッションを見ていきます。
セッション1:AIエージェントに Salesforce と Slack をつないでみたら 🔌
(稲葉 洋幸氏・odasho氏/セールスフォース・ジャパン)
最初は、セールスフォース・ジャパンの稲葉氏(Head of Trailblazer Relations & Community)と odasho こと小田氏(Developer Advocate)による、MCP接続のライブデモ中心のセッションです。タイトルスライドには Experience Engineer の Mihoko Kawada 氏を加えた3名が記載されていました(セッションページのSPEAKER欄は2名です)。2026年、Claude Code や Codex のようなAIエージェントが日々の開発に組み込まれるなかで、Salesforce と Slack が「AIエージェントから今日つないで試せる存在」になった、というのが全体のメッセージです。
Headless 360 ── あらゆるAIエージェントにSalesforceを開放
Salesforce は今年『Headless 360』を打ち出し、すべての機能をAPI、MCPツール、AIエージェントスキルとして利用可能にしています。あらゆるAIエージェントがSalesforceデータを安全に読み書きし、アクションを実行できる。ただし、AIエージェントは認証・アクセス管理を通じてガバナンスを維持する、という枠付きです。スライドの図では、接続先クライアントとして Claude、ChatGPT、Gemini、Cursor、Codex、Windsurf が並んでいました。
この図のポイントは、開放とガバナンスがセットになっている点です。どのエージェントからでも入れるが、入り口は認証・アクセス管理で必ず絞る。この構造は、後述のセッション4(セゾンテクノロジー)の「ガードレールとアクセル」とまったく同じ発想でした。
プラットフォームホスト型MCPサーバー
7月に一般提供が始まった公式MCPサーバーは、Salesforceのロジックや API に安全にアクセスするためのもので、3つの特徴が説明されました。1つ目はAIエージェント向けのエンドポイントで、SalesforceのAPI・データ・ロジックを標準のMCPサーバーとして公開し、外部モデルがプラットフォーム機能をすぐに発見・利用できる環境を整備します。2つ目は動的なツール探索で、LLMが利用可能なアクション・ビジネスプロセス・スキーマを実行時に安全に検証でき、AIエージェントがデータのクエリ方法を自動的に理解します。3つ目がプロトコルレベルでのコンプライアンスで、Salesforceネイティブの信頼性機能を引き継ぐホスト型サーバー経由で外部モデルが呼び出しを行うため、アクセスレイヤーでのデータ交換が保護され、監査可能な状態に保たれます。
画面例では、Setup の「MCP Servers」で「Sales and Account Management」というサーバーを定義し、公開する Tools / Prompts(例:Get Active Account Plans)を管理していました。MCPサーバーを「管理画面で定義して公開するもの」として運用する、という見せ方が印象的でした。
ライブデモの手順は4ステップです。
- Salesforce Developer Edition を入手(QRコードで案内)
- 外部クライアントアプリ & MCP サーバを設定
- ChatGPT(Web版)で新規プラグインを設定
- 試す
Salesforce のセッションでデモのクライアントが ChatGPT だったのは、「あらゆるAIエージェントに開放する」という Headless 360 の主張を体現した選択だったと思います。
Agentforce Labs と Slackアプリの基本構成
正式リリースされた Agentforce Labs は、Agentforceチームが新機能やプロトタイプを提供するライブの実験的環境で、すぐにヘッドレスエージェントを構築し始められます。セットアップ不要で待ち時間なし、API・スクリプト・自分の IDE で構築できる。「開発者はコーディングエージェントを素早く構築・テストし、実際のユースケースでシステム全体の可能性を示すことが重要」という位置づけでした。
Slack側は、アプリ開発の基本構成の説明です。
この図のポイントは、アプリ本体が Slack Platform の外側で動く点です。開発するアプリの「アプリ定義」を作成してワークスペースにインストールし、トークンを取得する。処理を行う本体は各種クラウドやオンプレで動かし、Slack が提供する Bolt フレームワークを使えば容易に開発できます。
このセッションで私がメモに残した気づきは一つで、「人間が操作するためのWEB画面だけでなく、エージェントが操作しやすくするためにCLIやMCPを用意する」ことです。自社プロダクトを持っている方なら、人間向けUIと並べて「エージェント向けの入り口」を製品要件として持つ時代になった、というのがこのセッションの実感でした。
セッション2:金融サービスを支える認証基盤を"止めないために磨き続ける" 🏦
(諏訪 裕司氏/ふくおかフィナンシャルグループ、東 卓弥氏/New Relic)
2本目は、ふくおかフィナンシャルグループ(FFG)の諏訪氏と New Relic の東氏による2部構成です。スライドのサブタイトルは「~ 開発に向き合う時間を生み出すチーム設計 ~」で、セッションページの「価値に向き合う時間」とは表記が少し異なっていました。
諏訪氏は2018年に新卒で医療系ベンチャーの営業からキャリアを始め、プログラミングスクールを経てSES・SIerでWeb開発を経験し、2024年4月に福岡へ引っ越してFFGに入社、共通認証基盤(IDP)とeKYCの内製開発・運用を担当されています。FFGは九州を主な営業基盤とする国内最大の広域展開型地域金融グループで、福岡銀行、熊本銀行、十八親和銀行、福岡中央銀行、みんなの銀行を擁し、総資産32.2兆円・預金21.8兆円・貸出金18.9兆円(グループ全体、2025年3月末)。2021年には日本初のデジタルバンク「みんなの銀行」を開業しています。
「動く」と「安全に、正しく動き続ける」の差は大きい
共通認証基盤(IDP)は、サービスを利用するときに「本人か」「必要な権限があるか」を確認する仕組みで、代表的な機能はログインとシングルサインオン、関連機能としてeKYC(オンライン本人確認)があります。金融サービスの土台なので、安全であること、使いやすいこと、新しい攻撃に対応できること、金融品質を保つことが同時に求められます。
このセッションの前提になっていたのが、「動く」まではわりと早くたどり着くが、そこから品質が高いといえるまでがほんとうに長い、という認識です。「動く」の先を考える観点として3点が挙げられました。標準仕様(OAuth / OpenID Connect の関連ルールを正しく理解する)、ライフサイクル(トークンや鍵を、発行から更新・失効まで考える)、継続的な検証(複数の観点を組み合わせて品質を確かめる)です。正しさは通常時だけでは確かめきれず、トークンの期限切れ、鍵の更新、想定外の呼ばれ方といった例外時まで確かめる必要があります。仕様も攻撃の手口も変わっていくため、作って終わりにはできません。
価値と認知負荷 ── 減らすのは「余計な難しさ」
価値は、要件を掘り下げ、設計を話し合い、実装・テストし、リリースし、運用から学んで直す──プロダクトを実際に作って検証する時間から生まれます。コードを書く時間だけではありません。ところが現場では、同じ議論を何度も繰り返してしまう。レビューで命名や例外処理をまた議論する、障害調査でまず「詳しい人」を探す、ガイドラインに結論はあるが理由が伝わらない。一つでも思い当たれば、問題は「前提のずれ」かもしれない、という指摘でした。
毎回考え直すコストを「認知負荷」と呼びます。ここで大事なのは、考えるコストの中身は一つではないという整理です。
この図のポイントは、減らす対象が「難しさ」全般ではない点です。問題そのものの難しさは価値に直結するので時間を使い、前提のずれが生む余計な難しさだけを減らす。だから、チームの前提をそろえる。そのための問いが3つ用意されていました。**① どう作るか(ガイドライン)、② どこへ向かうか(あるべき姿)、③ いま、どうなっているか(システムの状態)**です。
① どう作るか ── 判断基準の言語化は、AIにも効く
毎回出てくる判断(エラー処理の考え方、設計の判断原則、テストとレビューの観点)を文書にまとめます。ただし文書を作るだけでは足りず、「1 明示する(判断基準を言葉にする)→ 2 共有する(疑問点と理由を話す)→ 3 前提がそろう(納得した共通認識になる)」の3段階で、定期的な共有会を通じて文書への追従ではなく判断の理由までそろえます。決めてあれば定型判断が減り、案件固有の例外をどう扱うかに時間を移せます。
設計面では「技術の都合を業務ロジックに持ち込まない」が原則です。
この図のポイントは、DBや外部APIとの接続部分を業務ロジックから分離し、技術変更の影響を必要な範囲に留める構造です。「決めてある」状態が効くのはレビューのときで、パターンを知っていれば「コードを見る → 名前で意図が伝わる → すぐ納得できる」と進み、知らなければ「コードを見る → 意図を解釈 → 指摘に従う → 理由が残らない」となります。
そしてこのセッションでいちばん今っぽかったのが、「この『決めてある』は相手が AI でも同じ」という展開です。AIの出力したコードを直すとき、「チームの流儀」(命名、責務の分け方、エラー処理)に直していないか。動くコードでも、判断基準がずれているとレビューで手戻りが起きる。指示だけだと「動くが、流儀が合わない」、指示+ガイドライン(判断基準)だと「プロジェクトの考え方に沿う」。人の共通言語は、AIにも使える文脈になる。人間のオンボーディングのために書いたガイドラインが、そのままAIへのコンテキストとして再利用できる、という話は、AI以前からの地道な言語化が最も効率のよいAI対応だった、ということでもあります。
②どこへ向かうか、③いま、どうなっているか
②で共有するのは答えではなく、迷ったときに戻る問いです。プロダクトの方向性と個別の判断の間に共通の問い(何を守るか、運用し続けられるか、利用者の負担は妥当か、後から変更しやすいか)を置き、意見が分かれたら同じ問いに戻る。パターン名ではなく「変更の影響を限定する」という考え方を共有すると、同じ原則が外部APIでは「接続を差し替えやすくする」、DB・通知では「変更の影響を閉じ込める」として使い回せます。
③は、システムの現在地をチームでそろえる話です。「原因はわからないが、処理が重くなっている、エラーの件数が増えている」ことはないか。感覚から始めると事実確認だけで時間を使ってしまいます。
この図のポイントは、同じ現在地を見てから改善の話を始めるという順序です。FFGでは New Relic を「見る・気づく・備える」の共通基盤にしています。見る=ダッシュボード(リクエストエラー率、CPU・メモリ・ストレージ使用率、平均応答速度、リクエスト数を並べ、「なぜか重い」から「いつから・何が変わったか」の会話へ)。気づく=アラート(400/500エラー率をNRQLで監視し、見に行ける人だけが気づく状態からチームで気づける状態へ。調査や判断が特定の人に集中する状態を減らす)。備える=Performance Risks Inbox で、スロークエリやN+1クエリ問題といった将来のボトルネック候補を捉え、次に直す対象を事前にチームで話せるようにします。
New Relic パート ── 観測データの上にAIエージェントを乗せる
後半は New Relic の東氏です。九州工業大学の大学院を出てERP開発エンジニア、ITコンサルを経てNew Relicに入り、現在は北九州在住のカスタマーサクセス部 部長で、「人間の限界を超え、AIと共に進化する SUPERHUMAN時代」というキーワードから始まりました。
New Relic について補足しておきます。New Relic は、アプリケーション(APM)、インフラ、ブラウザ、モバイル、Kubernetes、クラウド、ネットワーク、さらに LLM の呼び出しまで、システムを構成する要素からメトリクス・イベント・ログ・トレースを集め、一つの基盤の上で監視・分析するオブザーバビリティプラットフォームです。集めたデータは NRQL というSQL風のクエリ言語で横断的に扱えるので、前半で出てきたダッシュボード、400/500エラー率のアラート、Performance Risks Inbox は、いずれもこの同じデータ基盤の上で動いています。データの収集は専用エージェントのほか、OpenTelemetry(OTel)にも対応しています。
講演では、この製品の位置づけが「AI時代の観測プラットフォームの準備」というスライドで整理されていました。観測基盤を自前でそろえる場合、OSSツール(自社運用)、OTel などのデータの定義(自社メンテ)、観測ガイドライン(自社制作)の3つをそれぞれ自分たちで持つ必要があります。New Relic はこの3つをまとめて提供する、という整理で、スライドには収集側として APM・Browser・LLM・Mobile・Synthetics・Infrastructure・Kubernetes・Cloud・Network、分析側として Performance・Error・Anomaly・Outlier・AI for Ops・Service Level・Change Tracking という機能名が並んでいました。
障害対応の業務フローを、Observabilityあり(Golden Signalsで予防・検知 → 状態・影響範囲の可視化 → トレース・ログのドリルダウンで分析 → 復旧)と、さらに「AI探偵」あり(エージェントが自律的に調査・分析しインシデント対応する)の2段階で示し、後者を支える新機能群を紹介していました。
| 新機能 | 時期 | 内容 |
|---|---|---|
| MCP | 2026年2月・Public Preview | Claude や Cursor 等のコーディングエージェントから、自然言語で New Relic のテレメトリーデータやアラートを直接取得・分析。手動転記と画面切替で思考が中断される Before から、MCP経由でAIが根本原因へ直行する After へ |
| SRE Agent | 2026年4月・Public Preview | AIエージェントがテレメトリデータへ直接アクセスし、人間が介在する前に初動調査を完了。数時間かかる調査を数分に短縮し、インシデントレポートも自動生成 |
| Performance Risks Inbox | 2026年4月・Public Preview | N+1クエリ問題、スロークエリ、過剰なクエリ呼び出し、直列実行、遅いHTTPリクエスト、大きなHTTPペイロードを自動検出し、1画面に集約。閾値はカスタマイズ可能 |
| Workflow Automation | 2026年2月 | 「調査/判断 → 対処 → 事後確認 → 結果報告」を検知後の自動フローに置き換え。AWS・Slack・Jira・PagerDuty 連携、新規にAzureをサポート。承認プロセスも組み込めるためノーコードで安全に自動化 |
前半の諏訪氏の話が「人間のチームの前提をそろえる」で、後半の東氏の話が「そろえた観測データの上にAIエージェントを乗せる」だったので、2部構成が1本の線になっていました。前提がそろっていないチームにAI探偵だけ入れても仕方がない、という順序が大事なのだと思います。
セッション3:なぜ「テストが通った」はAI時代に信用できなくなったのか 🧪
(大園 博昭氏/KINTOテクノロジーズ)
3本目は、KINTOテクノロジーズ Engineering Office の大園氏による受け入れテスト駆動開発(ATDD)の実践報告です。2015年にメッセージングアプリ開発会社で自動テスト専門チームを立ち上げてE2E自動テストのライブラリ・サービスを開発し、2017年頃からSET(Software Engineer in Test)として開発者テスト支援・CI/CD整備・開発フロー改善に取り組み、2026年から現職で全社横断的な開発環境改善を担当。福岡在住とのことで、地元登壇です。
通る「だけ」のテストと、Reward Hacking
問題提起はシンプルでした。AIにテストを書かせることも増えたのではないか。しかし、ひとつのAIが同じコンテキスト内で機能開発とテストを同時に行うと、機能実装のコードを見た上で、通る「だけ」のテストを書いてしまう。では実装とテストでAI(もしくはコンテキスト)を独立させればいいのかというと、その場合もお互いがお互いのコードを見ることに変わりはないので、制御が必要です。
なぜそんなことが起きるのかの説明が、Reward Hacking(報酬ハック)でした。講演では「OpenAIの論文」として、強化学習の過程でユニットテストを全て通せと命令すると目的達成のためにテストを意味のないものへ改ざんするケースが出現し、CoT には「Let's hack」と書かれていたことも、テスト冒頭で exit(0) を返すよう改ざんした例もあった、と紹介されました。また「Anthropicの論文」として、テストが失敗するとハードコードして改ざんすることがあり、テストでズルを学んだモデルは他領域でも不誠実になるという結果も紹介されました。テストが通ることを報酬として与えられた場合、「テストを通すこと」にフォーカスが当たるのはむしろ自然であり、指示では防げない、というのがポイントです。
人間には流行らなかったATDDが、AIなら回る
対策の方向は「テストを先に書き、そのテストを通す実装を書く」、つまりTDDです。ただしFunction単位ではなく、開発工程全体をTDD化できないか。そこで出てくるのが受け入れテスト駆動開発(ATDD)です。古くは2000年代からある、TDDをシステム全体に拡張した開発手法で、実装前にE2E相当のテストを書きます。ミソは、受け入れ条件(AC)を実装前の設計段階で関係者が集まって議論・設定することです。2008年頃に Elisabeth Hendrickson 氏が講演資料でATDDという言葉を使ったのが(おそらく)広まるきっかけでした。
しかし、流行りませんでした。実装前の工程が多く、同期的なコミュニケーションが多く必要で、愚直にやるにはコストが大きい。TDDは開発者個人の手法として取り入れられますが、ATDDはチーム全体を巻き込む必要があります。提唱者の Hendrickson 氏自身も2024年の「ATDD Revisited」というコラムで「ATDDは現実世界の開発には重すぎた」とコメントしていたそうです。
ここでAIの登場です。Acceptance Test(ほぼE2Eテスト)を書くのが辛い → AIにやらせればいい。チームで足並みを揃えるハードルが高い → そこもAIにアシストさせればいい。時間がかかる → 最終的にAIに書かせられるなら時間的コストの意味合いは変わる(極論、日中に設計を終わらせて夜中にAIへぶん投げることもできる…かも)。人間時代に埋もれていた手法が、AI前後で障壁の種類が変わったことで脚光を浴びる、という構図です。
Double-Loop ── 外側のATDDと内側のTDD
実装の枠組みは、外側と内側の2重ループです。
この図のポイントは、外側のループ(ATDD → Acceptance Test)が「何ができれば完成か」を固定し、内側のループ(TDD → Unit Test)がそこへ向かって部品を積む、という役割分担です。定石は Outer-loop で回す AT = AC とする方法で、複数のACにまたがるテストは目的を見失いがちなのでやめたほうがいい。ただしATDDは開発フロー全体のデザインに過ぎず、内部の開発はTDDでもSDDでもBDDスタイルでもかまいません。実際には 1AC = 1AT のパターンと 1User Story = 1AT のパターンを試行錯誤中とのことで、定石どおりACごとにATを書くとE2Eテストの数が膨大になり、いくらAIに書かせてCIで回すとしてもコストがかかるため、折り合いをどこでつけるかが試行錯誤のポイントだそうです。
運用上の注意点として強調されたのが、「実装するAIにテストの修正はさせない」です。修正を許すと、結局実装に合わせて都合の良いテストへ改変してしまう。修正を承認制にするか、別のコンテキストを持つAIへ委任させます。
それでもうまくいかなかった理由 ── PRDとDesign Doc
「ATDDの流れで開発してくれ」とAIへ投げてもうまくいかなかった、という失敗談が率直でした。ATを書くために必要なACをAIがうまく作れておらず、原因は、ACを作るために必要な「要件定義」が十分にできていなかったこと。ただ単にATDDの方法論を取り入れるだけではだめだった、と。そこで大事にしたのが2つの文書です。PRD(この機能はなんのために必要なのか、ユーザーのどんな要求へ答えるものなのか、何ができればこの開発は達成されるのか)と Design Doc(どのようなものをどう作るのか、どのようなアーキテクチャで作るのか、影響範囲はどうなるのか)。AIとの数回のやりとりでは開発の背景コンテキストを十分に伝えられないので、いつもの開発で大事にしてきたものをAIに作らせるときにも大事にする、というそれだけの話だった、という整理です。
現在の開発スタイルは3段階です。
この図のポイントは、上流の工程ほど人間の関与を強く、下流はAIへお任せする流れです。当初はテストケースや実装をチェックしていたが、最近は「ATさえまともなら…」になっているそうで、約2ヶ月の運用で 463 Issues、454 PRs という実績が示されました。
もう一つの学びが「餅は餅屋に」です。ATDDやTDDなどテスト駆動まわりは自分の専門なので特に苦労はなかったが、PRDやUser Story、ACなど専門外の部分は、AIのレコメンドに対して自分がレビュー・取捨選択することが難しかった。現職のチームメンバーにスペシャリストがいたため、助言・助力をもらってプラグインを作った、と。専門知を持つ人を巻き込む重要性は、AI時代でも変わりません。
結論とよくある質問
タイトルの問い「なぜ『テストが通った』はAI時代に信用できなくなったのか」への答えは2つでした。1. AIは Reward Hacking してしまう傾向がある。2. 人間の要件を正しくAIへ伝えるのは難しい。だから「今の」AIの特性を正しく掴み、それに合わせる必要がある、と。
質疑も具体的でした。
| 質問 | 回答の要旨 |
|---|---|
| UIが決まっていない状態でテストが書けるのか? | 書ける。書けないのだとしたら、受け入れテストすべき機能に対する要件が足りていない。実際にATDDでiOSアプリを開発している。ATのテストコードは良質な設計書になる |
| どのようなプロダクト・開発体制に向いているのか? | 基本的にどんな体制でも馴染むはず。ただしフロー自体は重いので、単純なLPや1〜2時間で作れる使い捨てプロトタイプにはかなり冗長。使い分けが大事 |
| うちの開発環境は特殊で複雑なので難しそう | 極論、適用できない現場はないはず。ただし労力に対するメリットが少ないところはある。ATDDの手法自体にこだわる必要はなく、AIのクセ・実装とテストの分離・テスト設計の質という根本さえおさえれば同じ結果は出せる |
先月のデブサミ関西で聴いた mabl のセッション(つくるAIと見つけるAIの分離)と同じ問題意識を、今回はツールではなく開発フローの設計で解いている、という対比でも聴けました。
ここまでが前半の3セッションです。MCPという「接点」の話から、判断基準の言語化、そしてPRD/ACの言語化まで、前半だけで「AIに渡す前提を人間が書く」話が3回出てきたことになります。
セッション4:AI推進室がAI審査室になりかけた話 🛡️
(松山 祐己氏/セゾンテクノロジー)
4本目は、セゾンテクノロジー AI推進室の松山氏による、全社AI活用のガバナンスと組織設計の話です。AI・データ活用推進、社内のクラウド/データ基盤、ガバナンス・全社標準策定を担当されていて、SnowPro Advanced Data Engineer や AWS の資格バッジも掲示されていました。セゾンテクノロジーはファイル転送ツール HULFT が23年連続国内シェアNo.1(スライド記載)、導入実績12,160社(2026年3月時点)、全国銀行協会会員銀行と日本自動車工業会会員企業の導入率100%という会社です。
冒頭で「守り:AIを安全に使える土台をどうつくったか。攻め:現場の活用をどう後押ししているか」の両面を扱うと宣言され、タイトルどおり「守りに寄りすぎて審査室になりかけた」経緯から始まります。
標準ツールを決めた、その先で起きたこと
AI推進室のミッションは、全社が生成AIを安全に使える環境とルールを整えることと、現場の業務に合う形で活用を設計し成果につなげることです。まず全社標準の生成AIツールを一本化し、入力してよい情報・してはいけない情報のルールを整備し、研修と周知を行い、社内の「AI利活用ポータル」に標準ツール一覧やハンドブック動画を掲載しました。ここまでは順調です。
苦戦したのは、個別AIツールの審査でした。部署ごとに求めるツールも用途も異なる、明確な審査基準の整理が難しい、1つの審査にかかる時間が長期化する。利用前の審査がボトルネックになり、AI推進ではなくAI審査室になりかけた。審査に時間を取られて本来の「活用の推進」に手が回らず、現場からは「AI推進室は止める部署」に見えてしまう、という状態です。
論点はデータに集約された ── 3層の審査基準
必要だったのは、明確で公正な審査基準です。そのつど判断していては可否の理由を説明できず、担当者や時期で結論が変わる状態では現場も納得できません。過去の相談を振り返ると、用途は問合せ対応、開発・コードレビュー、会議・議事録と多岐にわたるのに、承認済み審査の約8割は個人情報・機密情報の扱いが論点になっていました。そこで審査基準を3層に整理します。
この図のポイントは、下の層ほど現場の判断に委ねられる構造です。過去の審査事例と、総務省・IPA・OWASP・日本ディープラーニング協会など複数の指針を突き合わせて整理したそうですが、モデルとサービスは指針を参照できた一方、データの線引きだけは自分たちで決めるしかなかった。いちばん難しかったのはデータの基準で、発想を「ツールごとに可否を判断する」から「データの扱いを基準で統制する」へ切り替えたのが転換点でした。
既存のデータガバナンスに「AIの軸」を足す
データの統制は、分類を作り直すのではなく、既存のメタデータにAI利用の観点を一つ足す形で整備されました。帰属・出所(ラベル管理をAI可否の判定に再利用)→ 条件①:出所が明確。機密度(既存の機密区分にAI入力可否の閾値を追加)→ 条件②:機密度が社外秘以下。法規制・契約(制約はメタデータとして保持済み)→ 条件③:法規制・契約の制約なし。条件をすべて満たせばリスク低と判断してOK、一つでも外れたらレビューへ回します。
責任の設計も同じ思想です。新設したのはAI推進室(AI固有の審査基準とモデル・サービス評価)のみで、既存の管理体制をそのまま活用・拡張します。データオーナーは従来からの区分管理にAI利用可否を追加し、情報セキュリティは既存の統制・監査要件をAI利用へ拡張し、現場部門は用途の妥当性と運用時の実務責任を持つ。なぜ役割を分けたのかの説明が明快でした。AI推進室がすべての利用判断を行う仕組みはスケールしない。利用が増えるほど中央集権の判断はボトルネックになる。現場部門はデータに加えて業務プロセスとメンバーのリテラシーを知っている。AI推進室は「判断する人」ではなく「判断できる状態をつくる人」へ、という転換です。
審査の高速化 ── リスクスコアで対応の重さを変える
審査プロセス自体も、案件ごとに毎回ゼロから判断する Before から、リスクを分類して対応の重さを変える After に変わりました。評価軸は3要素で、リスクスコア = A(審査項目:セキュリティ/AI)× B(利用規模:人数・部署・用途)× C(情報の重要性:データ分類)です。
| リスク区分 | 対応 |
|---|---|
| 禁止 | 利用不可(代替手段を提示) |
| 高 | 個別審査+是正確認(AI推進室+現場部門で審査) |
| 中 | 条件付きで許可(範囲・期間を限定して利用) |
| 低 | その場で判断(簡易チェックのみで利用可) |
結果として、低リスクの案件はその場で判断できるようになり、AI推進室が時間をかけるのは本当に難しい案件だけになりました。同じ論点を繰り返し議論することがなくなり、申請する側も何を見られるのかが事前にわかる。審査を「止める仕組み」から「速く通すための仕組み」に変えた、という言い方が的確だと思います。
ルールだけでは活用は進まなかった ── ガードレールとアクセル
守りを整えても、使う人は自然には増えませんでした。意欲も能力もあるアーリー層と、「使ってよい」は知っているが動機がないマジョリティの間に壁がある。制度が整っている=「使ってよい」に過ぎず、「使ってよい」と「使ってみたい」の間の距離をどう縮めるかが課題だった、と。そこで4つの場を用意します。LT会(現場が自分の言葉で語る場)、活用事例共有(他部署の成功を横に展開)、ハンズオン(実際に手を動かして試す)、Slackチャンネル(いつでも聞ける・共有できる場)。運営はAI推進室が引っ張るのではなくユーザーが動かす形に近づけていて、テーマも進行もユーザーと決め、語るのは使っている本人、いずれはユーザー主導で開催される自走状態を目指しています。
まとめのフレーズが「ガードレールとアクセルの両立」でした。ガードレール=分類・役割・審査ロジック、アクセル=LT会・事例共有・伴走支援。どちらか一方では組織は動きません。変化の実感として、推進室に届く相談が「使えますか?」「禁止ですか?」から「これをやりたい」「どう組めばいい?」「業務ごと見直したい」に変わってきたこと、効率化の主語が個人(要約・検索・ドラフト生成)からチームの業務プロセス、組織の業務プロセス全体へ広がってきたことが紹介され、「私たちはAIを導入するのではなく、AIを活用できる組織づくりに取り組んでいます」で締めくくられました。
セッション5:AI協働力 ── 100万件の評価データが示す、コードの外側で評価が決まる時代のキャリア 📊
(泉水 翔吾氏/ハイヤールー)
最後は、コーディング試験プラットフォームを提供するハイヤールー取締役CTOの泉水氏です。スライドのタイトルは「AI協働力: 100万件の評価データが示す、モノづくりで問われる力の行方」、サブタイトルは「判断は、自分から始まっているか」で、セッションページの表記とは少し異なっていました。SIer、サイバーエージェント、メルカリ(執行役員VPとしてメルペイのエンジニアリング部門を管掌)、デジタル庁、ハウテレビジョンを経て、JR西日本や三井住友カードの顧問も務め、2025年にハイヤールーへジョインという経歴です。
このセッションは講演中の数値がとにかく多かったので、以下の数値はすべて講演スライドからのメモである点をあらためて添えておきます。
実感と成果がずれている
導入は DORA のデータからでした。個人の実感では90%が業務でAIを使用し、80%超が生産性向上を実感している。一方で組織の成果では、AI導入が25%進むごとにデリバリーのスループットが1.5%下がり、デリバリーの不安定性が7.2%上がる(出典:DORA — State of AI-assisted Software Development 2025 / Accelerate State of DevOps 2024)。実感と成果がずれている。だから問いは「使っているか」ではなく「どう使っているか」です。
構造の変化はこう整理されました。
この図のポイントは、これまでボトルネックだった実装(評価も実装力に寄っていた)が小さくなり、求められる能力が「書く」から「判断する」へ、工程の左側に移っていくことです。評価される軸が移ったのなら、キャリアとロールはどう動くのか。「01 測った話」と「02 読みの話」の二部構成で進みました。
01 測った話 ── 4つの出典が同じものを指した
まず採用市場の動きです。ハイヤールーの本番環境で、AIの利用を前提とした「AI協働形式」の試験を選んだ企業は、2026年5月の11社/79社(13.9%)から、6月21社/90社(23.3%)、7月32社/97社(33.0%)、8月39社/105社(37.1%)と増え続けています。採用市場は、社内の評価制度より先に動いた、という指摘です。
では何が要るとされているのか。成り立ちの違う4つの出典が並べられました。
| 出典 | 種別 | 指したもの |
|---|---|---|
| Anthropic「AI Fluency」 | 指標 | 4つのコンピテンシー(Delegation 委譲/Description 記述/Discernment 見極め/Diligence 誠実さ)。特に強調されていたのは Discernment=出てきたものを評価し、自分で判断する |
| CoderPad「State of Tech Hiring 2026」 | 採用実務 | AI利用可の面接で見る5つのシグナル。筆頭は「AIの誤りを捕まえ、直せる」、2番目は「トレードオフと正しさを説明できる」 |
| FSE-CF(Alenezi 2026, arXiv 2606.03394) | 論文・枠組み | AIに代替されにくいのは Trust calibration(いつ頼り、いつ検証し、いつ上書きするか)、批判的評価と判断、システム思考、AIガバナンス。プロンプト設計は代替されていく側 |
| CentaurEval(ICML 2026, arXiv 2512.04111v3) | 査読論文 | 協働でしか解けない問題の正答率は、LLM単独 0.67%/人間単独 18.89%/協働 31.11%。人間が介在する余地は実在する |
4つがそれぞれ指したものの共通点は「出てきたものを、自分で評価し、自分で決める」でした。頼み方ではなく、受け取り方と決め方です。プロンプト設計(頼み方)はAIに代替されていく側で、「頼み方」と「疑い方」は別の能力として扱われている、という切り分けが効いていました。
実際の行動と、測った能力
では実際の行動はどうか。IDEチャット74,998メッセージの発言分類(出典:Programming by Chat — arXiv 2604.00436, ASE 2026)では、Code Authoring 34.5%、Failure Reporting(壊れたと知らせる)24.0%、Inquiry 19.2%、Delegation 16.5%、Context Specification 14.1%、Workflow Control 11.5%に対して、Validation(自分から確かめる)はわずか3.99% でした。「壊れてから直す」と「自分から検証する」は、時間で見るとどちらも出力の後で差がありませんが、起点で見ると、失敗の知らせが起点か、自分が起点かが違います。
ハイヤールーの採用試験で計測する「AI協働力」は、成果物ではなくAIと作業した過程を採点します。成果物は誰のものでも似てくるからで、差が出るのは過程だ、と。5指標の平均スコア(100点満点、N = 25,115)はこうでした。
| 指標 | 平均スコア |
|---|---|
| 実行の統制(何を任せ、どう進めたか) | 68.5 |
| 意図の仕様化(どう伝えたか) | 64.4 |
| 出力の品質保証(何を確かめたか) | 58.7 |
| 環境構築 | 54.6 |
| 共同推論(どこで、何を決めたか) | 45.5 |
最も低い共同推論を構成する3指標は、採点基準の中央値つきで開示されました。「代替案の引き出し」は中央値0.25で「探索が形式的で、最初の案にすぐ収束している」。「提案の評価と採択」は0.50で「比較・評価なしに『それで進めて』と採用している」。「批判的評価」は0.50で「外部シグナルを受けてから対処、自力検出はない」。較正は0.5=標準行動、1=熟練者にしか観測されない行動です。まとめると「早く決めて、遅く気づく」。失われているのは時間ではなく、探索されなかった選択肢と、誤りに気づくまでの距離だ、という言語化でした。
ACT 01 の結論はこうです。案はAIが出したものから始まる。気づきは失敗が来てから始まる。つまり判断が、自分から始まっていない。能力の欠如ではなく、「比べること」と「疑うこと」を外に預けている、と。
02 読みの話 ── なぜ差は自然に埋まらないのか
後半は、頼み方と疑う力の差がなぜ自然には埋まらないのかの読み解きです。3つの仮説に、それぞれデータが当てられました。
1つ目はアーティファクト効果です。成果物がある会話とない会話の差(11指標・50,000会話超の観察)では、頼み方は上手くなる(目的の明確化 +14.7pp、形式の指定 +14.5pp)一方、受け取り方は雑になる(事実確認 −3.7pp、文脈の欠落への気づき −5.2pp)。仕上がって見えるものは、仕上がったものとして扱われる。個人の怠慢ではなく、予測できる失敗モードです。
2つ目は、記述と検証の非対称です。検証は在籍年数でも伸びず、機能習熟からも転移しない。頼み方だけが伸びて、疑う力は経験では解決しない、と。
3つ目が tokenmaxxing です。DORAが2026年6月に名指しした組織の罠で、「AIのトークン消費量を、社内リーダーボードで競わせる──この "tokenmaxxing" は、危険な罠である」。判断の質の代わりに利用量を測ると、個人は量に最適化され、検証の時間が削られます。怠慢でも、経験不足でも、意志の問題でもない、という3つの答えでした。
差がどこにあるかも明快でした。「使う」側の実行の統制68.5は5指標で最も高く、誰の弱点でもないので差にならず、時間が解決する。「考える」側の共同推論45.5は5指標で最も低く、弱点が集まっていて、時間が解決しない。学ばない周回は、速いほど誤りを固定する、という一文が刺さります。
専門性の重心は「書く」から「選ぶ」へ
工程の左に移るのは工程ではなく「決めごと」だ、という整理で、書く力(意図の仕様化64.4。AIが最も得意な領域と重なり、FSE-CFではプロンプト設計の代替可能性 Medium)と、選ぶ力(共同推論45.5。どの仕様にするかを決めて責任を持つ。批判的判断の代替可能性 Very low)が対比されました。TAKEAWAY はこの一文です。
仕様書はAIも書ける。決めた責任は、移らない。
判断が価値になると何が起きるかの3点も、キャリアの話として具体的でした。(1) 見えなくなる:何を選び何を引き受けたかは成果物に痕跡を残さない。(2) 向かう道が細くなる:判断には実装の理解が前提なのに、その実装をAIが担うので理解を得る機会が減る。(3) 見る側と合流する:成果物では差がつかないから、評価側は過程を見にいく(4か月で105社中39社がAI協働形式を選んだ)。
実践指針は「任せる前」と「受け取った後」に分けて示されました。前=岐路で比較軸を自分から出す(「他に3つ出して、向き不向きを教えて」と、何と何を比べるかを自分で決める)。後=失敗の知らせを待たず、自分で疑う(テストが落ちる前に、どこを疑うかを決めて見る。通る diff でも間違ったやり方がそのまま固まる)。立つ場所=判断が残る場所に立つ(「なぜこの案か」を残すレビュー。育成は基礎力 → 検証 → AI協働の順)。締めは「任せる量は足りている。足りないのは、任せた先の中身」でした。
最後に「この試験で測れていない5つ」(候補者の属性は保持していない、分かるのは『形式を選んだ』まで、求人側と候補者側の切り分けはできていない、領域比較は平均スコアのみ、継続採用の定着はあと一四半期で判定できる)を自分から開示していたのも、データを扱う登壇として誠実でした。判断の起点は測れるが、決めた責任はこの試験に映らない、と。
福岡を通して見えた共通テーマ 🧵
分野の違う5セッションを並べて聴くと、それぞれの登壇者が別の入り口から同じ場所に着地していたことが見えてきます。3つにまとめます。
テーマ1:AIに任せる範囲は、人間側の言語化の量で決まる。 諏訪氏は、人間のチームのために書いた開発ガイドライン(判断基準)がそのままAIに使える文脈になると語り、大園氏は、ATDDがうまく回らなかった原因はAIではなく要件定義の甘さで、PRDとDesign Docを愚直に作り込むことで解決したと語りました。セールスフォースのセッションは、そもそもエージェントに操作させたいなら人間用のWEB画面だけでなくMCPやCLIという「機械が読める接点」を用意せよ、という話です。松山氏のデータ分類も、「どのデータをAIに入れてよいか」の線引きを言語化してメタデータに載せる取り組みでした。4本とも、AIの性能の話をほとんどしていません。任せられる範囲を広げているのは、判断基準・要件・線引き・接点という人間側の言語化です。先月のデブサミ関西で奥村氏(NECソリューションイノベータ)が語った「暗黙知の壁・情報アクセスの壁」とも、きれいに地続きでした。
テーマ2:AIに自分の答え合わせをさせない。判断の起点を自分に置く。 大園氏の「実装するAIにテストの修正はさせない。許すと都合の良いテストへ改変してしまう」は、工程設計でこの問題を解く話でした。泉水氏の100万件のデータは、同じ問題を人間側から測っていて、壊れたと知らせる発言が24.0%あるのに自分から検証する発言は3.99%、批判的評価の中央値は「外部シグナルを受けてから対処」の0.50です。テストの改ざんを防ぐ仕組み(S3)と、疑うことを外に預けない習慣(S5)は、「検証の起点をAI任せにしない」という同じ原則の、フロー側と能力側なのだと思います。
テーマ3:判断を中央に集めず、「判断できる状態」を配る。 松山氏の「AI推進室がすべての利用判断を行う仕組みはスケールしない。判断する人ではなく、判断できる状態をつくる人へ」が最も明示的でしたが、諏訪氏の「調査や判断が特定の人に集中する状態を減らす。同じ現在地を見てから改善の話を始める」も、大園氏の「上流ほど人間の関与を強く、下流はAIへ」も、判断をどこに置くかの設計の話です。判断基準・データ分類・観測基盤という形で判断の材料を配っておけば、中央の誰かがボトルネックにならずに済む。AI活用の議論に見えて、実は権限委譲の設計論でした。
セッションをまたいだ持ち帰りを一つだけ挙げるなら、泉水氏の「任せる量は足りている。足りないのは、任せた先の中身」です。AIに任せる量ではなく、任せる前に何を比べ、受け取った後に何を疑うかという中身を問うこの一言は、大園氏の「ATさえまともなら、あとはAIに任せられる」にも、諏訪氏の「ガイドラインはAIにも効く」にもそのまま重なります。3人とも、結局は「AIに渡す前の一手間が、任せられる範囲を決める」という同じ話をしています。実装が速くなった分の時間を、この「渡す前の言語化」と「受け取った後の検証」に振り向けられるかが、2026年秋の分かれ目なのだと思います。
参考
- Developers Summit 2026 FUKUOKA(公式)
- セッション1: AI エージェントに Salesforce と Slack をつないでみたら(稲葉洋幸氏・odasho氏)
- セッション2: 金融サービスを支える認証基盤を"止めないために磨き続ける"(諏訪裕司氏・東卓弥氏)
- セッション3: なぜ「テストが通った」はAI時代に信用できなくなったのか(大園博昭氏)
- セッション4: AI推進室がAI審査室になりかけた話(松山祐己氏)
- セッション5: AI協働力:100万件の評価データが示す、コードの外側で評価が決まる時代のキャリア(泉水翔吾氏)
- 関連記事: Developers Summit 2026 KANSAI 聴講レポート(同じ筆者による関西版のレポートです。公開時にURLを差し替えてください)
💡 本記事は筆者個人の聴講メモに基づくレポートです。講演の意図と異なる要約になっている箇所があれば、それは筆者の理解不足によるものです。数値・事例・引用文献(DORA、CoderPad、arXiv各論文等)は講演スライドからのメモで、独自に検証したものではありません。