

AI生成のカバーイラスト。API検証の作業を表したものです。
背景
「AI API 中継」で検索すると、「2026年おすすめプラットフォーム」のまとめ記事が何十本も出てきます。3本開くと1位が3社とも違う。多くが出稿された記事なので、そういう結果になります。
それでCrazyrouterを対象に、自分でスクリプトを書いて測ることにしました。この記事はその検証手順と、実際に引っかかった箇所の記録です。数値はすべて2026年10月14日に実行した本物のリクエストから取っています。
先に結論だけ書いておきます。
- 中継サービスが安い理由は2種類しかなく、どちらなのかでサービスが消えるリスクが決まります
- 検証は4項目、所要時間は10分ほど
- そのうち最初の1項目はリクエスト1回で終わるのに、いちばん見落とされます
なお検証中、自分のスクリプトのバグで「このサービスはストリーミングに対応していないのでは」と誤判定しかけました。その話も「エラー対処」の節に残してあります。中継サービスを評価するとき、いちばん間違えやすいのはサービス側ではなく測り方のほうです。
なぜ安いのか:出どころが言えるかどうか
安さの程度よりも、その安さがどこから来ているかが重要です。答えは2種類に分かれます。
出どころを言えるケース
多くのモデルは Azure、AWS Bedrock、Google Vertex AI 経由で呼び出せます。これらのクラウドは独自の価格体系と数量契約を持っており、ベンダーの公開価格表とはそもそも別の仕組みです。加えて一括調達の階段価格、そして越境決済のコストをプラットフォーム側が一度にまとめて吸収する分があります。
出どころを言えないケース
典型的なパターンが2つあります。1つはリバースエンジニアリングで、ベンダーのWebクライアントの通信プロトコルをAPIの形に再梱包するもの。原価はほぼゼロです。もう1つはアカウントプールとサブスクリプションの分割転売で、同時接続数を調整して気づかれないように運用します。
いずれも上流の利用規約に違反します。ここで問題なのは倫理面よりも運用面です。この手のサービスは徐々に劣化するのではなく、一斉に止まります。 何週間も正常に動いていたものが、ある朝すべてエラーを返すようになる、という壊れ方をします。
したがって評価の順序はまず上流を確認し、それから他を見るになります。どのモデルがどのクラウド経由なのかを具体的に答えられる事業者は、検証可能な主張をしていることになります。「うちは安いので」とだけ言って追及をかわす事業者も、それはそれで情報を伝えてくれています。
ここから3つのリスクが出てきて、4つの検証項目はこれに対応しています。
- サービス停止 — この市場は参入障壁が非常に低い
- モデルの差し替え — 表記はフラッグシップ、経路は安いモデル
- プライバシー — プロンプトが第三者のインフラを通過する
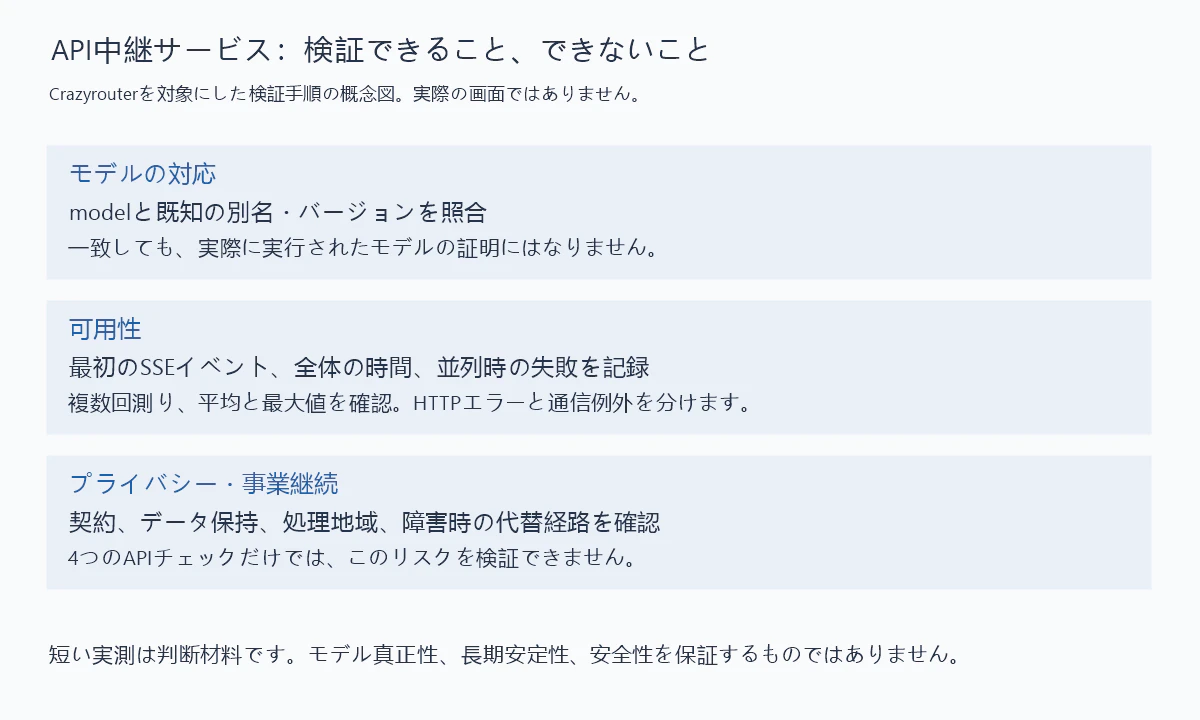
検証項目と限界を示す概念図です。スクリーンショットではありません。
環境とバージョン
| 項目 | 値 |
|---|---|
| OS | Windows 10.0.19045 |
| シェル | PowerShell 7(pwsh) |
| curl | 8.13.0(Windows, Schannel, zlib/1.3.1) |
| Node.js | 24.21.0(配色検証スクリプト用、検証本体には不要) |
| Base URL | https://api.crazyrouter.com/v1 |
| エンドポイント | POST /chat/completions |
| パラメータ |
temperature=0、max_tokens=60
|
| 計測日 | 2026年10月14日 |
依存関係についての注意点です。並列検証で Start-ThreadJob を使いますが、このコマンドレットは PowerShell 7 に同梱されています。Windows PowerShell 5.1 で動かす場合は ThreadJob モジュールを別途インストールしてください。ストリーミング部分は .NET 標準の System.Net.Http.HttpClient を直接使うので、追加パッケージは不要です。
Base URL を差し替えれば、OpenAI 互換の他社サービスでもそのまま動きます。
検証手順
| 検証項目 | 対応するリスク | 判断基準 |
|---|---|---|
| モデルエコー | 差し替え | レスポンスの model フィールドが要求したモデルと一致するか |
| 最初のSSEデータイベントまでの時間 | 可用性 | ストリーミング時、最初の data: ブロックが届くまでの時間 |
| ばらつき | 可用性 | 同一リクエストを複数回、いちばん遅い回を見る |
| 並列時のレート制限 | 可用性 | 同時に複数本投げて 429 の割合を数える |
手順1:モデルエコー
普通のリクエストを1回送り、回答の中身は完全に無視してレスポンスのフィールドを読みます。
実行前に次の内容を req.json に保存し、環境変数 CR_API_KEY を設定します。以下のcurl構文はBash用です。
{"model":"gpt-4o-mini","messages":[{"role":"user","content":"Explain an API in one sentence."}],"temperature":0,"max_tokens":60}
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CR_API_KEY" \
  -H "Content-Type: application/json" \
  -d @req.json
見るのは model フィールドです。今回の gpt-4o-mini は gpt-4o-mini-2024-07-18 を返しました。日付付き文字列は全モデル共通の必須形式ではありません。既知の別名・バージョン対応を確認し、前方一致は一次チェックとして使います。system_fingerprint や service_tier は提供元やモデルによって省略される場合があります。これらは診断用メタデータであり、存在や一致だけで実際のモデルや公式経路を証明することはできません。不一致は調査のきっかけです。
手順2:最初のSSEデータイベントまでの時間
リクエストに "stream": true を足し、最初の data: ブロックが届いた時刻を記録します。ここに落とし穴が2つあるので、手順を書くより先に「エラー対処」の節で説明します。
手順3・4:ばらつきと並列
ばらつきは -w "%{time_total}\n" に変えて同じリクエストを10回まわし、平均ではなくいちばん遅い回を見ます。平均だけでは、少数の遅いリクエストを見落とすことがあります。
並列は -w "%{http_code} " に変えてバックグラウンドで同時に投げ、429 を数えます。逐次実行では、バースト時にだけ効くレート制限は見つかりません。この2項目では req.json の max_tokens を5程度に下げておくと速く済みます。
エラー対処
リクエストボディを3回見直したエラー
実際に返ってきたレスポンスを挙げます。
| ステータス | 実際のメッセージ | 本当の原因 |
|---|---|---|
| 401 | 無効的令牌 (request id: ab7157a9...) |
Bearer プレフィックスの付け忘れ、またはキーの空白文字がシェルに食われている |
| 404 |
model_not_found ·Model gpt-4o-minii is not provided by...
|
モデル名のタイプミス。GET /v1/models で現在の一覧を取って突き合わせる |
| 400 | Model name is required (request id: 98a73cde...) |
紛らわしい。リクエストボディには model を書いてある。実際は Content-Type: application/json の付け忘れで、サーバ側がボディをパースしていない |
3つ目で時間を使いました。「model が無い」と言われてボディを3回見直しましたが、問題はヘッダ側にありました。どのエラーにも request id が付くので、問い合わせるときは症状を説明するよりこれを添えたほうが早いです。
ストリーミング非対応だと誤判定しかけた話
冒頭で触れた件です。TTFT を測ろうとしたらカウントが 0 のまま、HTTPステータスは 200、ストリームは流れている。「このサービス、本当はストリーミングに対応していないのでは」と評価メモに書きかけました。
原因は2つのバグが重なっていて、どちらも自分のコード側でした。
1つ目:PowerShell のワイルドカードは [DONE] を文字集合として扱う。 SSE の終了マーカーを弾くつもりで次のように書いていました。
if ($line -like 'data: *' -and $line -notlike '*[DONE]*') { $chunks++ }
ワイルドカードの [DONE] はリテラルではなく、D・O・N・E のいずれか1文字にマッチする文字集合です。しかも既定で大文字小文字を区別しません。SSE の各行のJSONには o か e が必ず含まれるため、-notlike の条件が常に偽になり、データ行が全部落ちていました。

本図はAIによる生成画像で、両側の結果は実際の実行から取っています。スクリーンショットではありません。
文字列メソッドで書けば問題ありません。角括弧をワイルドカードで扱う必要がある場合は `[DONE`] とエスケープします。
2つ目:HttpClient は既定で解凍しない。 ハンドラに AutomaticDecompression(GZip -bor Deflate)を設定していないと、gzip のストリームが圧縮バイト列のまま読まれ、やはり data: 行に1つもマッチしません。症状が1つ目とまったく同じなので、2つ重なると切り分けに時間がかかります。
あわせて、ストリームを読むときは HttpCompletionOption::ResponseHeadersRead を指定してください。指定しないと HttpClient がレスポンス全体を受け切ってから返すため、初回トークンの時間が測れません。
SSE のハートビート行
このエンドポイントは本文の前に : PING を1行送ってきます。SSE の仕様上コロン始まりはコメント行なので、計測ループで先に読み飛ばさないと、計測しているのはハートビートの到着時刻になり、数値が小さく出ます。
並列時のTLS失敗はHTTPエラーではない
並列検証で1本が失敗したとき、返ってきたのは The SSL connection could not be established でした。バースト時のTLSハンドシェイク失敗で、リトライすれば通ります。ただしこれはトランスポート層の例外であってHTTPステータスではないため、-SkipHttpErrorCheck では捕まりません。$ErrorActionPreference = 'Stop' のままだとスクリプトごと落ち、そこまでに集めた結果も一緒に失われます。並列部分は例外処理で囲んでください。
計測結果
3モデル、各3回、temperature=0:
計測上の注意:保存済みスクリプトは最初の非終了 data: 行を測っています。空のdeltaやroleのみのイベントを含む可能性があるため、厳密な「最初の出力トークン」の時間ではありません。表は実際の1・2・3回目の順です。モデルエコーはモデル真正性を保証せず、これら4項目ではプライバシーを検証できません。
| モデル | 最初のSSEイベント(ミリ秒) | 全体(ミリ秒) |
|---|---|---|
gpt-4o-mini |
2454 / 1509 / 2102 | 2622 / 1732 / 2309 |
glm-5.3-flash |
1526 / 1395 / 1789 | 2431 / 2339 / 2558 |
deepseek-v4-flash |
1486 / 2867 / 1453 | 2412 / 3681 / 2402 |
モデルエコーは3つとも一致しました。ほかに claude-haiku-4-5 は claude-haiku-4-5-20251001、gemini-3-flash は gemini-3-flash-preview を返しており、いずれも通常のバージョン展開です。
表そのものより、次の3点のほうが重要です。
deepseek-v4-flash の2回目が2867ミリ秒で、1回目・3回目の1486と1453に対して明らかに跳ねています。1回しか測らなければ、このモデルが3つの中で最速という結論になっていました。
並列10本で 429 は出ませんでしたが、1本が57ミリ秒で失敗しました。前述のTLSハンドシェイク失敗です。
別の並列10本の実行では、最も遅いリクエストが26.31秒でした。他の9本は2.37〜4.40秒です。平均は5.56秒で、最大値とは大きく異なります。これは先ほどのTLS失敗とは別の実行記録です。少数の試行では平均と最大値を併記し、本番の分布とは区別します。
まとめ
数値について正直な但し書きを2つ。1つ目、上の数値は1つの入口・3モデル・1日分にすぎません。ネットワーク状況も上流の負荷もモデルのバージョンも動きます。移植できるのは手順のほうで、数値ではありません。2つ目、モデルエコー以降の3項目が見ているのは可用性であって品質ではありません。そのモデルが自分のタスクに向いているかは、レイテンシからは何も分かりません。
実務的な落としどころとしては、中継サービスを開発・モデル比較・重要でない経路に使い、業務上重要な部分は自前のゲートウェイ(One API、LiteLLM など)の背後に置いて上流を2つ以上用意しておく形になります。そうしておけば1社が消えても劣化で済み、停止にはなりません。上流を言えない事業者には本番データを流さない、という線引きも併せて。
今回の計測対象はCrazyrouterです。利用可能なモデルはモデル一覧ページで確認できます。カタログは、個々のリクエストが通ったクラウドを証明するものではありません。
少額だけ入金して4項目を走らせ、それから金額を決める。 10分程度の作業で、数か月後に表面化する種類の問題を先に潰せます。