
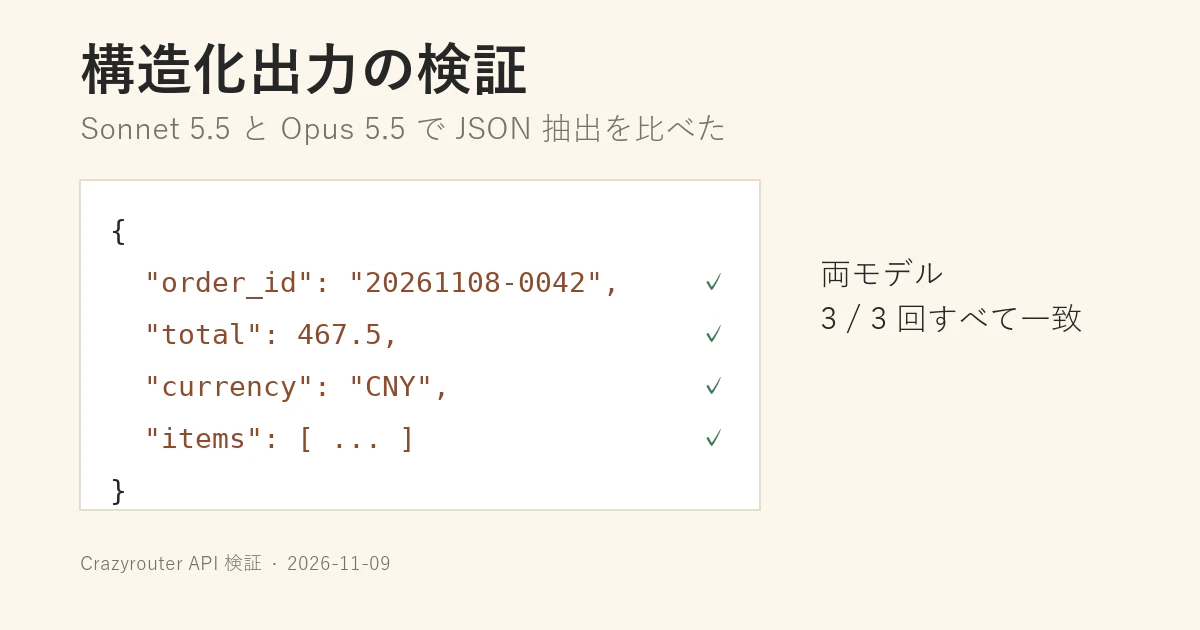
API からモデルの出力を JSON で受け取り、そのままデータベースや後段の処理に流す場合、いちばん困るのは「200 が返ってきたのに中身が使えない」ケースです。このメモでは、claude-sonnet-5-5 と claude-opus-5-5 を同じ条件で呼び出し、構造化出力のタスクで何が起きたかを整理します。
結論を先に書くと、今回の試験では両モデルとも JSON 抽出タスクをすべて正しく処理しました。差が出たのは速度と出力の長さで、精度ではありませんでした。ただし、長い文書から条件を抜き出すタスクでは、どちらのモデルも「本来は対象外の項目」を混ぜることがあったため、後段でのチェックは省けません。
呼び出し条件
エンドポイントは https://api.crazyrouter.com/v1 の /chat/completions で、モデル ID は claude-sonnet-5-5 と claude-opus-5-5 です。試験は 2026-11-09 に行い、合計 132 回の呼び出しがすべて HTTP 200 を返しました。max_tokens は 4096 に固定し、effort パラメータは指定せず、接口の既定値を使っています。
構造化出力に関係するのは、次の 2 つのタスクです。
- 注文テキストから JSON を抽出する:注文番号、顧客名、商品の配列、合計金額、通貨を一つの JSON オブジェクトで返す。
-
ログ行を JSON Lines に変換する:各行を
ts、level、module、msgのキーを持つ JSON にする。
どちらも正解が一つに決まるため、JSON のパースと、フィールドごとの値の照合で判定しました。3 回の試行すべてで、両モデルとも全フィールドが一致しました。
長い文書からの抽出で起きたこと
もう一つのタスクは、約 5,000〜8,000 字の要件文書から、硬い制約(上限、期限、保存期間など)を表にする作業です。文書には、旧版の数値や、まだ決まっていない計画項目といった「対象外の記述」が意図的に含まれています。
両モデルとも主要な制約はすべて拾いました。一方で、Opus は 3 回の試行のうち 1 回で、表の中に「対象外」の項目を混ぜました。たとえば Opus は、ある 1 回の試行で「CSV と JSON のアップロード対応」という機能の記述を制約として表に加えています。その説明文の中では「数値制限ではない」と明記されていましたが、表をそのまま機械的に読み込むと、この行が余分な制約として扱われてしまいます。
Sonnet では今回この混入は確認されませんでしたが、同じ形式の出力を扱う以上、次の 2 点を実装しておくのが現実的です。
- 出力に列を増やし、各行が「数値の制約」か「機能の記述」かを区別させる。
- 後段で、表の各行が原文にある数値と一致するかを機械的に確認する。
構造化出力の検証を組み込む
JSON を受け取る側では、次の順番で確認すると問題を切り分けやすくなります。
-
finish_reasonがstopであることを確認する。lengthの場合は JSON が途中で切れている可能性がある。 - JSON としてパースできるかを確認する。
- 必須フィールドが揃っているか、型が合っているかを確認する。
- 値を原文と照合できるなら照合する。
このうち 1 と 2 は、モデルに関係なく必ず実装しておくべきです。3 と 4 は、タスクの性質によって決めます。
速度とトークン数
今回のテストでは、速度と出力長に一貫した差がありました。JSON 抽出のような短い出力のタスクでも、Opus は Sonnet より少し長く答える傾向があり、総出力トークンは多くなりました。構造化出力だけを目的にするなら、この差は主に費用と遅延に影響します。精度には影響していません。
数値は同じ接続経路で取得したもので、ネットワークや負荷によって変わります。比較の参考程度に扱ってください。
モデル ID が自分のアカウントで使えるかは、Crazyrouter のモデル一覧で確認できます。
試験の限界
今回の構造化出力タスクは 2 種類、各 3 回です。対象は英語の注文例とログ形式に限られ、日本語の帳票や複雑なネスト構造は含めていません。すべての呼び出しは同じ互換ゲートウェイを経由しています。料金は今回確認していません。
モデルの選択を考えるなら、自分の実際の入力で同じ検証を回すのが確実です。その際、usage と finish_reason を毎回記録しておくと、後で原因を追いやすくなります。