
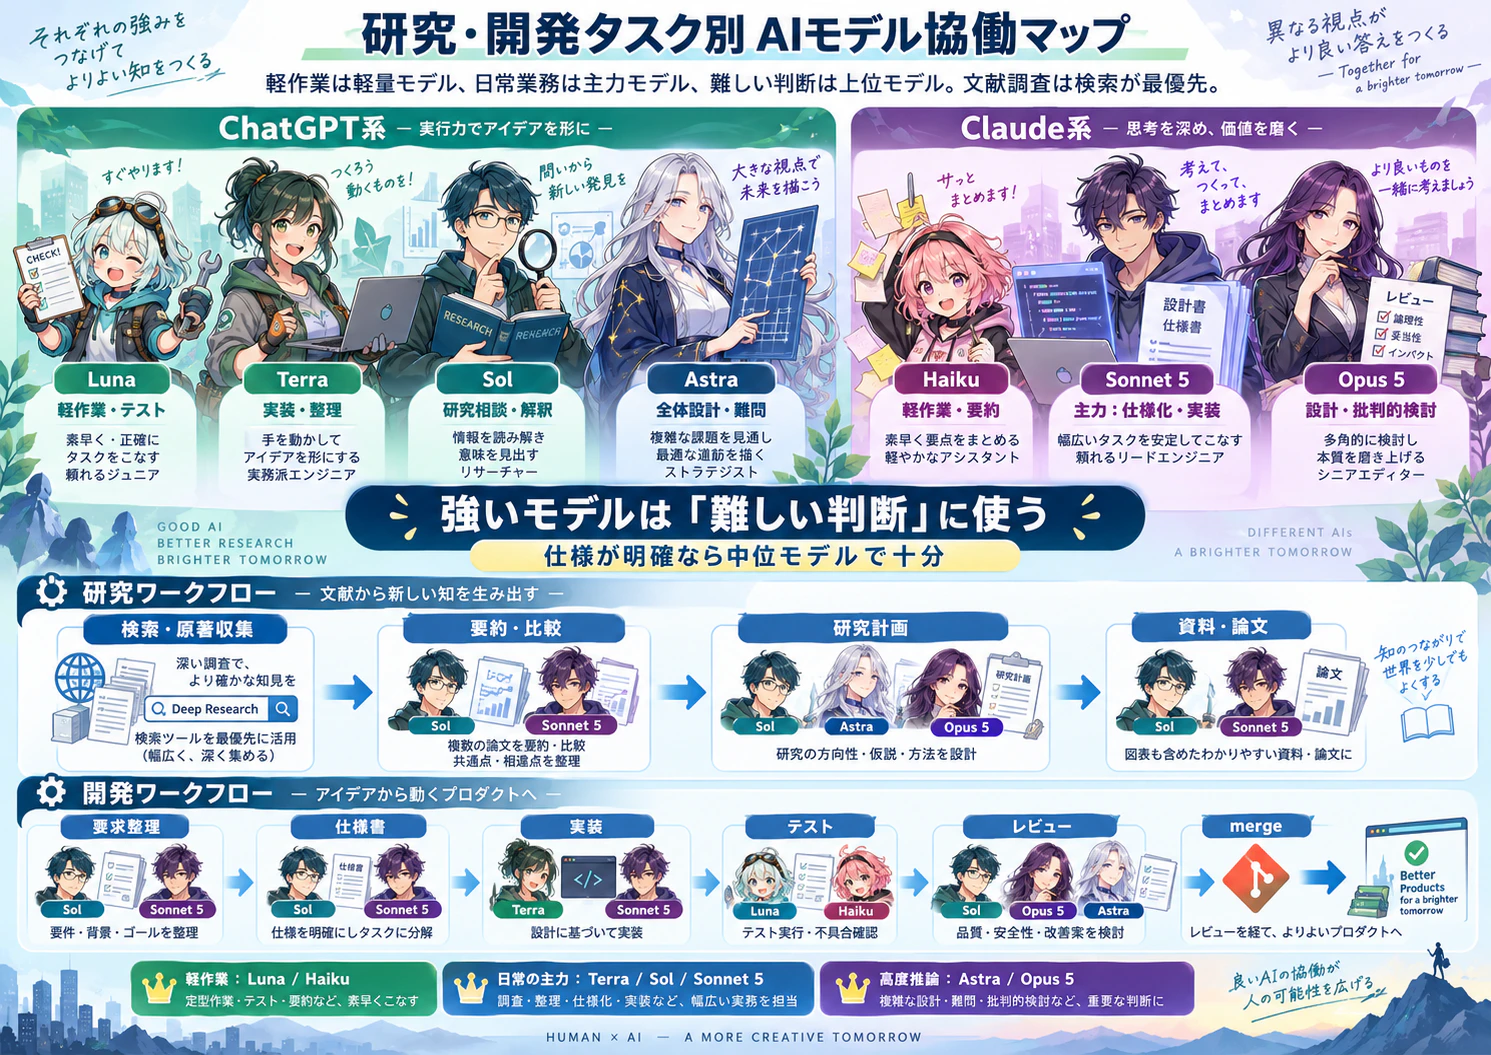
研究・開発タスク別:ChatGPTとClaudeのモデル使い分けガイド
*本記事はChatGPTにより作成されました。
生成AIのモデルが増えてくると、意外と困るのが、
どのタスクに、どのモデルを使えばいいのか?
という問題です。
高性能モデルを常に使えばよいようにも思えますが、実際にはそうでもありません。
- 軽い作業に最上位モデルを使うと無駄が多い
- 難しい設計問題を軽量モデルに任せると、修正ループが増える
- 文献調査ではモデル性能より検索能力の方が重要なこともある
- コーディングでは「仕様を考える仕事」と「仕様を実装する仕事」で必要な能力が違う
といった事情があります。
そこでこの記事では、研究・論文執筆・文献調査・データ解析・ソフトウェア開発などを対象に、ChatGPT系とClaude系のモデルをどう使い分けるとよいかを整理します。
TL;DR
かなり乱暴にまとめると、次のようになります。
| タスクの重さ | ChatGPT | Claude |
|---|---|---|
| 軽作業 | Luna | Haiku |
| 普通の作業 | Terra / Sol | Sonnet |
| しっかり考えてほしい | Sol Medium | Sonnet Medium |
| 難しい研究・設計問題 | Sol High | Sonnet High / Opus |
| 非常に難しい全体設計 | Astra | Opus High |
日常作業では、
- ChatGPTなら Sol / Terra
- Claudeなら Sonnet
を主力にするのがよいと思います。
AstraやOpusは、毎回使うというよりも、
「判断そのものが難しい問題」
に投入するのが合理的です。
1. モデル選びで重要なのは「タスクの種類」
モデル選択でよくある失敗が、
難しい仕事だから一番強いモデル
という考え方です。
実際には、同じ「研究」や「プログラミング」でも必要な能力はかなり違います。
例えば、
既に仕様書がある
↓
それに従ってコードを書く
のと、
ユーザーの曖昧な要求
↓
要件整理
↓
仕様設計
↓
アーキテクチャ設計
↓
実装
では、後者の方がはるかに高度な推論を要求します。
そのため、
タスクの難易度
だけでなく、
どの種類の判断が必要なのか
を見ることが重要です。
2. タスク別モデル対応表
研究・論文・文献調査
| タスク | ChatGPT | Claude | コメント |
|---|---|---|---|
| 用語や概念の説明 | Luna / Sol | Haiku / Sonnet | 上位モデル不要 |
| 短い文章の要約 | Luna / Sol | Haiku / Sonnet | 明確な文章なら軽量で十分 |
| 英文校正・言い換え | Sol | Sonnet | 普通の論文英語なら十分 |
| 論文1本の要約 | Sol Medium | Sonnet Medium | 方法や結果の整理 |
| 論文の原理を深く理解 | Sol Medium〜High | Sonnet High | 数式・機構が難しければ上げる |
| 数本の論文比較 | Sol Medium | Sonnet Medium | 検索能力も重要 |
| 網羅的な先行研究調査 | Deep Research + Sol | Research + Sonnet | モデルより検索が重要 |
| 大量文献の統合レビュー | Sol High | Opus Medium | 矛盾整理やgap抽出 |
| 原著記載の厳密な確認 | Sol High + 原文 | Sonnet High / Opus | 必ず一次文献を見る |
| 研究アイデアの壁打ち | Sol Medium | Sonnet Medium | 日常的な相談 |
| 研究計画の設計 | Sol High | Opus Medium | 強モデルの価値が大きい |
| 新規性・research gap検討 | Sol High / Astra | Opus | 複数情報の統合 |
| 研究テーマの批判的評価 | Sol High / Astra | Opus High | 反証や弱点探索 |
| 実験条件の検討 | Sol Medium〜High | Sonnet High | 文献検索併用 |
| 実験トラブルシューティング | Sol High | Sonnet High / Opus | 原因候補が多い場合 |
| データ解析方針の設計 | Sol High | Sonnet High / Opus | 統計・ML設計 |
| Python解析コード | Terra / Sol | Sonnet | 上位モデル不要なことが多い |
| 結果の科学的解釈 | Sol High | Opus Medium | コードよりこちらが難しい |
| 図表の解釈 | Sol Medium〜High | Sonnet Medium〜High | 科学図は推論が必要 |
| 研究内容のまとめ資料 | Sol Medium | Sonnet Medium | 基本これで十分 |
| 学会発表の構成 | Sol High | Sonnet High / Opus | ストーリー構成 |
| 論文outline | Sol High | Sonnet High / Opus | 論理構造の設計 |
| 論文本文執筆 | Sol Medium〜High | Sonnet Medium〜High | 最上位モデル常用は不要 |
| Reviewer response | Sol High | Opus Medium | 批判への対応は高推論向き |
3. ソフトウェア開発
開発タスク別
| タスク | ChatGPT | Claude | コメント |
|---|---|---|---|
| 要求整理 | Terra / Sol | Sonnet | 普通の案件 |
| 要求→仕様書化 | Sol Medium | Sonnet Medium | 曖昧さ整理 |
| 仕様書→通常実装 | Terra | Sonnet Medium | 主力モデル |
| 小さなバグ修正 | Luna / Terra | Haiku / Sonnet | 軽量モデルでも十分 |
| UI微修正 | Luna / Terra | Haiku / Sonnet | 上位モデル不要 |
| テスト追加 | Luna / Terra | Haiku / Sonnet | 定型作業 |
| 複数ファイルのfeature実装 | Terra / Sol Medium | Sonnet Medium | 日常的なagentic coding |
| 通常のデバッグ | Sol Medium | Sonnet Medium〜High | |
| 難しいroot cause解析 | Sol High | Opus Medium | 強モデル向き |
| 大規模リファクタ | Sol High / Astra | Opus | 設計判断が増える |
| architecture設計 | Astra / Sol High | Opus High | 最上位モデル向き |
| PRレビュー | Sol Medium〜High | Sonnet High / Opus | 実装モデルより一段強く |
| lint / test / Git操作 | Luna / Terra | Haiku / Sonnet | 高級モデル不要 |
| 仕様→実装→PR一式 | Terra / Sol | Sonnet | 通常これで十分 |
| 巨大プロジェクトの自律実行 | Astra | Opus | 長期agentic task |
4. 「仕様書を書く」と「実装する」は別タスク
これはコーディングで特に重要です。
例えば次のような依頼があります。
グラフを削除した後もズーム状態を保持してほしい
このままAIに渡すと、AIはまず、
- どの状態を保持するのか
- x軸だけか、y軸もか
- 全trace削除時はどうするか
- undoとの関係はどうするか
- 既存テストとの互換性はどうするか
などを考える必要があります。
一方で、先に仕様を定義します。
## Requirement

Trace削除後も現在のx/y zoomを保持する。

## Acceptance Criteria

- 複数trace表示中にzoomできる
- 1つのtraceを削除できる
- 削除後もxlim/ylimが変化しない
- 残りのtrace表示は維持される
- existing testsがpassする
ここまで決まっていれば、実装作業はかなり単純になります。
つまり、
曖昧な要求
↓
高推論モデル
↓
仕様書
↓
中量モデル
↓
実装
という分業が可能になります。
これだけでAI開発のコストはかなり下げられます。
5. コーディングでは「実装者よりレビュー担当を強くする」
実務的にかなり使いやすい構成がこれです。
要求
 ↓
Sol / Sonnet
仕様化
 ↓
Terra / Sonnet
実装
 ↓
Luna / Haiku
test
 ↓
Sol High / Opus
レビュー
 ↓
Terra / Sonnet
修正
つまり、
高性能モデルをずっと使う
のではなく、
高性能モデルを審査役として使う
という方法です。
これはかなりコスト効率が良いです。
6. 先行研究調査では「モデル性能」より検索が重要
研究用途では特に重要です。
先行研究調査で、
Astraに全部聞く
よりも、
検索
↓
論文収集
↓
原文確認
↓
Sol / Opusで統合
の方が圧倒的に信頼性が高いです。
特に、
- どの論文が最初の報告か
- 実際にどの発現株を使っているか
- DNA配列がSupplementにあるか
- purification bufferの濃度
- DOI
- mutation位置
などは、モデルの記憶ではなく一次文献を見るべきです。
したがって先行研究調査では、
Retrieval能力
+
Reasoning能力
を分けて考えます。
7. Deep Researchを使うべきタスク
次のような場合は、モデルをAstraに上げるよりDeep Research系機能を使う方がよいです。
例えば、
Aβ42のrecombinant expressionについて、
過去20年の主要戦略を整理してほしい
というタスク。
必要なのは、
- 多数の論文検索
- 原著確認
- strategy分類
- 比較
- 引用
- research gap整理
です。
この場合、
Deep Research
↓
Sol Highで統合
の方が合理的です。
一方、
集めた文献を見ると、
この研究テーマには新規性があるか?
という問題はreasoning中心なので、
Sol High / Astra
Opus
の出番になります。
8. 研究計画では上位モデルを使う価値が高い
研究では、
コードを書く仕事
より、
何を測るべきか決める仕事
の方が難しいことがあります。
例えば、
抗菌ペプチド配列
↓
hydrophobicity
hydrophobic moment
charge
i,i+3 / i,i+4 interaction
などのfeature抽出
↓
抗菌活性・helicity・DNA bindingとの関連解析
という研究を考えるとします。
Pythonでfeatureを計算するだけなら、
Terra / Sonnet
で十分でしょう。
しかし、
- feature数に対してサンプル数は十分か
- multicollinearityはどうするか
- PCAを使う目的は正しいか
- supervised learningの方が適切ではないか
- cross validationはどう組むか
- explainabilityはどう担保するか
- publishable noveltyはどこにあるか
という議論になると、
Sol High
Opus
Astra
を使う価値が出てきます。
つまり、
計算をAIにやらせるところではなく、
「研究の問い」を考えるところに高性能モデルを使う
のが効率的です。
9. まとめ資料作成は意外と上位モデル不要
例えば、
- 研究室ミーティング資料
- 実験条件まとめ
- タンパク質発現条件比較
- 文献比較表
- README
- 開発仕様書
- プロジェクト進捗資料
などは、情報が既に揃っていれば、
Sol Medium
Sonnet Medium
程度で十分な場合がほとんどです。
むしろ重要なのは、
- 元データが正しいこと
- 必要情報が与えられていること
- 出力フォーマットを指定すること
です。
10. Astra / Opusを使うべき場面
最上位モデルを使う価値があるのは、
実装が難しい
というより、
判断が難しい
場合です。
例えば、
GUIアプリが継ぎ足し開発で複雑になってきた。

今後、

- ピークフィッティング
- undo/redo
- project save
- dual y-axis
- 自動ピーク検出
- batch processing

を追加したい。

現在のarchitectureを維持するべきか、
state managementを再設計するべきか?
こういう問題はAstra / Opus向きです。
逆に、
Issue #42を実装してテストして
なら、仕様が明確であればTerra / Sonnetで十分です。
11. モデルのエスカレーション戦略
私は、最初から上位モデルを使うよりも、次のような方式が合理的だと思っています。
ChatGPT
Luna
↓
Terra
↓
Sol Medium
↓
Sol High
↓
Astra
Claude
Haiku
↓
Sonnet Medium
↓
Sonnet High
↓
Opus Medium
↓
Opus High
つまり、
失敗したら一段上げる
方式です。
例えばcodingなら、
Sonnetで実装
↓
成功
→ 終了

失敗
↓
Sonnet High

まだ原因不明
↓
Opus
とすればよいでしょう。
12. 私が使っている判断基準
かなり単純化すると、次の4つで考えています。
① 軽作業
Luna / Haiku
例:
- typo修正
- lint
- git操作
- 短い要約
- テスト実行
② 普通の仕事
Terra / Sol
Sonnet
例:
- 通常実装
- 論文要約
- 資料作成
- 英文修正
- Issue作成
③ ちゃんと考える必要がある
Sol High
Sonnet High / Opus
例:
- 研究計画
- 難しいデバッグ
- データ解釈
- Reviewer response
- 論文story設計
④ 判断そのものが難しい
Astra
Opus High
例:
- research direction
- architecture再設計
- project全体の再構成
- 複数のtrade-offがある意思決定
13. 重要なのは「最強モデルを使うこと」ではない
生成AIを使っていると、
一番強いモデルを使えば一番いい結果になる
と思いがちです。
しかし実際には、
良いタスク分解
+
適切なモデル
+
良い入力情報
+
適切なレビュー
の方が重要です。
特に、
高性能モデル
↓
仕様を作る

中量モデル
↓
実装する

高性能モデル
↓
レビューする
という分業は、研究でもソフトウェア開発でもかなり有効です。
14. 最終的なモデル選択チートシート
最後に、最も簡単な表です。
| やりたいこと | ChatGPT | Claude |
|---|---|---|
| とりあえず聞く | Sol | Sonnet |
| 単純作業 | Luna | Haiku |
| 通常coding | Terra | Sonnet |
| 研究相談 | Sol Medium | Sonnet Medium |
| 本気の研究計画 | Sol High | Opus |
| 難しいdebug | Sol High | Opus |
| 文献調査 | Deep Research + Sol | Research + Sonnet |
| 論文を書く | Sol Medium〜High | Sonnet |
| 論文storyを考える | Sol High | Opus |
| 仕様書を作る | Sol / Terra | Sonnet |
| 仕様書から実装 | Terra | Sonnet |
| architecture設計 | Astra | Opus |
| 最終レビュー | Sol High / Astra | Opus |
おわりに
個人的には、
普段
ChatGPT → Sol / Terra
Claude → Sonnet

難しいとき
ChatGPT → Sol High
Claude → Opus

本当に難しいとき
ChatGPT → Astra
Claude → Opus High
くらいの使い分けで十分だと思います。
また、研究用途では、
モデル性能を上げる
前に、
文献検索・一次情報へのアクセスを強くする
方が重要な場合も多いです。
逆に研究計画、データ解釈、研究の新規性判断、ソフトウェアarchitectureなど、
正解が事前に決まっていない問題
では、上位モデルを使う価値が高くなります。
最強モデルを常用するのではなく、
判断が難しいところだけ強いモデルに任せる
という使い方が、現状では最も効率が良いのではないかと思います。