
※ ↓この記事を読めばだいたい同じ事書いてあるんだけど、記事は多い方がいいかなって。
やったこと
まずは…このhtopの表示を見てほしい。

中二病の男子ならクッソテンション上がると思うんですが、規模的には一般のご家庭に置けるものです!
冗長クラスタと拡張クラスタ
このクラスタについて語るに、まずはクラスタの恩恵を語る必要があります。コンピュータクラスタの恩恵には、冗長性の向上と拡張の向上があります。
冗長性
コンピュータのプロセスが絶対死なない†不死性†を持つのが冗長性であります。沢山のプロセスが次々と身代りになるような挙動をするのです。
WEBサーバーなど、落ちてはいけないサーバーに用いられるけど…この記事の範囲ではありません!
- k8s, docker swarm
- webサーバー
- 絶対に落ちてはならないもの
- 作りは複雑
ご存知k8sは冗長型で、web系のシステムの様な落ちてはいけないものに強いですね。これは大変に複雑なシステムです。あたりまえです。落ちたものの身代わりを何度も繰り出せるのですから。
https://kubernetes.io/
拡張性
コンピュータのプロセスが力をあわせて†瞬間火力†を出すのが拡張性です。
スパコン等の場合、巨大な演算を圧倒的速度で殴らねばならなりません。皆で同時に同じ計算を手分けしてやるわけですね!今回作ったのはこちらです。
- open mpi, mpich
- スパコン, GPUクラスタ
- 圧倒的な性能のもの
- 作りは単純だが、プログラミングは特別
本稿では拡張型のクラスタを自作/運用しているので、それについて書こうと思います。ちなみに、僕の用途ではGPUクラスタではなくCPUクラスタです。複雑な計算ではいまだCPUが強い場面が多いものです。
根本的にはスパコンの小さいやつと思っていただければいいかと。
ま、富嶽は158976ノードで、僕のは4ノードとショボく、故に仕組みも単純なんだけどな!
https://global.fujitsu/ja-jp/technology/research/fugaku/specifications
何故自作クラスタなのですか?スパコンではダメなんですか?
スパコンに対する優位性はいくつかあります。必要とする計算量やその性質により、自作クラスタはスパコンを上まわるパフォーマンスを出せるはずです。
- 価格対性能比
- ソフトウェアの互換性
- 待ち時間
- †浪漫†
価格対性能比
価格対性能比については…スパコン借り賃が発生するので、どの程度使い倒せるかでコストがかわります。いっぱい使う、長く運用するならばスパコンに勝るコストを叩きだせます。
ちなみに、ryzen threadripper搭載のworkstationを使うという選択肢もありますが…それはもっと高いと思います。
互換性
当然ながらオレオレクラスタは自分で構築するので好きなソフトを選択できます。僕の大学のスパコンには僕の必要とするソフトがなかったのです。
待ち時間
スパコンは高性能なものほど人気がでます。すると、使うのに待ち時間がかかるようになります。すると…スパコンを使うまでの待ち時間が処理時間を上まわる事すらあるのです。
中二心
君の心の中に†浪漫†(中二病)があるならば、そのクラスタをめいっぱい使いたくなります。その結果、使い倒す事になり、結果的に自作クラスタではなく自らの力が上がるのです。
作り方
まず、材料を揃えます。
- 沢山のコンピュータ
- スイッチングハブ
- mpichまたはopen mpi
- 家族の同意
この中で最も取得が難しいのが家族の同意です!というか、それから先に取得するべきです!
でなければ…どんな恐ろしい事が起こるか…兎に角家族の同意を取れ!
僕と君との約束だ!
パソコンとハブ
上記の全てを取得しました。ノードは4つの小型パソコンにしています。
このくらいなら日本人の住む小さな家でも置けます!
OSを入れます。僕はUbuntuを入れました。後々大変なのでOSはここは割愛。
ここで超重要な事があります。スイッチングハブの性能は絶対にケチらないでください。
スイッチングハブの性能はそのままIOの性能として直結します!
MPIプロトコルとは?
これらで並列計算を行うにあたり、必要なのは使用する全てのプロセス同士の連携です。
ただ…考えてもみてください。これってそんなに難しいものでしょうか?
まずは指揮する人、そして働く人、そして材料が必要です。例えばこんな感じ。
このなかで、具体的にはファイルサーバーはNFSが定番でしょう。もしかするとSAMBAでもgoogle driveでもいいのかもしれません。なんならファイルサーバがノード2であってもいいです。ここは単なるファイル共有なので適当にやりゃあできる。
問題は命令です。
この命令についてのプロトコルがMPIであり、MPICHとopen mpiが有名どころなのです。
ubuntuならこんな感じ?
sudo apt install openmpi-common openmpi-bin
今回はopenmpiを採用しました。
ちなみに僕のクラスタでノードの一部にファイルサーバとワーカーの役割も与えています。もちろんファイルサーバーが欲かったのですが、家族の同意/理解を得るためにノード数を極限まで抑える必要があったのです。
ssh
SSHをクラスタの中で命令を出す側のノードとその他のノードで公開鍵方式で開通させておく必要があります。一々パスワード書けませんし。適当にsshの記事でも読んで開通させておいてください。
あと、それぞれのパソコンの中のユーザーは多分同じユーザーじゃないとダメなんじゃないかと思います。
MPIのプログラム
命令、といっても簡単なものです。ただしボイラープレート感はどうしてもでてきます。
仕組みとしては「同時に多数の同じプロセスのコピーを起動した上で、それらのプロセスに番号を振って協調的に動作させる」とうい事です。
つまり一つのプログラムに「このノードで動く場合はこうする」と一つ一つ書く事になります。
で、その時にプロセス間通信で「このプロセスでは別のプロセスからの命令を待ちうける」とかして、言わば互いにダイレクトメッセージで繋ったお友達同士みたいに通信しながらジョブをこなすのです。
つまり…別に上記のような中央集権的なジョブ管理である必要すらありませんし、ファイルサーバも一つである必要はありません。
雰囲気的にはmpi4pyのチュートリアルのコードを見ると良いかも。
例えば下記はmpi4pyのドキュメントからの抜粋です。
from mpi4py import MPI
assert MPI.COMM_WORLD.Get_size() > 1
rank = MPI.COMM_WORLD.Get_rank()
if rank == 0:
    1/0
    MPI.COMM_WORLD.send(None, dest=1, tag=42)
elif rank == 1:
    MPI.COMM_WORLD.recv(source=0, tag=42)
こうやって、他のプロセスにtag付きのメッセージをsendしたりrecvしたりして協調的に動かします。…結構ボイラープレートでしょ?
MPIのプロトコルはソフトのバージョンに非常に過敏です!必ず同じバージョンで揃えてください!
python
ここで、僕はpythonを使うのでpython用のmpiパッケージが必要になります。「pythonかよwww」と言われそうですが、富嶽だってnumpyが動く仕様だしnumpyは遅くない。今回は僕はmpi4pyを採用しました。こんな感じかな。
sudo apt install python python-venv
python -m venv venv
. ./venv/bin/activate
pip install mpi4py
僕としてはdirenv推奨。
当然、CPUクラスタはできる。単純な仕組みだからGPUクラスタも多分できるんじゃねーかな、知らんけど。
ここで落し穴があります!mpiは基本的に命令を送信するもので、巨大なデータやpythonのオブジェクトは送信できないっぽいです。mpi経由でそういうのを送信しようとして失敗したので、僕はmpi4pyのラッパを書く事になりました。
p coreとe core
ちなみに、僕はnumpyを多様するのですが、intelの新しいCPUにはp coreとe coreがあり、e coreは性能が低いと言われています。しかし、僕は計算の速度を測り、e coreも浮動小数点演算で十分戦力にできると考えたため、敢えてe coreにも計算をわりあてています。
具体的な数字は忘れました。ただ、そのあたりは構築のまえにきちんと考えたほうがいいと思います。なんならAMD製の方が性能の見積はしやすいかと。
トリガーとホストファイル
mpiプロトコルによる並列計算プロトコルを用いるためにはmpirunというコマンドを叩きますが、この時にhostfileというものが必要です。
一つ一つのノードにどの程度の事をさせるかという事ですね。例えばhoge, fuga, piyoというノードがあって、それぞれが10コア、4コア、6コアのCPUを搭載しているならばこんな感じでhostfileを書いてコマンドに食べさせます。
hoge slots=10
fuga slots=4
piyo slots=6
あとはこんな感じ。
mpirun --np $((10+4+6)) --hostfile hostfile hello-world
ここの--npで指定した数によって並列化してくれます!
完成したもの
性能はこんな感じ
- ノード数: 4
- CPU: intel Corei7 14700 物理80コア(p 32コア、e 48コア)
- Main memory: 64GB x 4 計256GB
- GPU: なし
- 調達費: 66万円
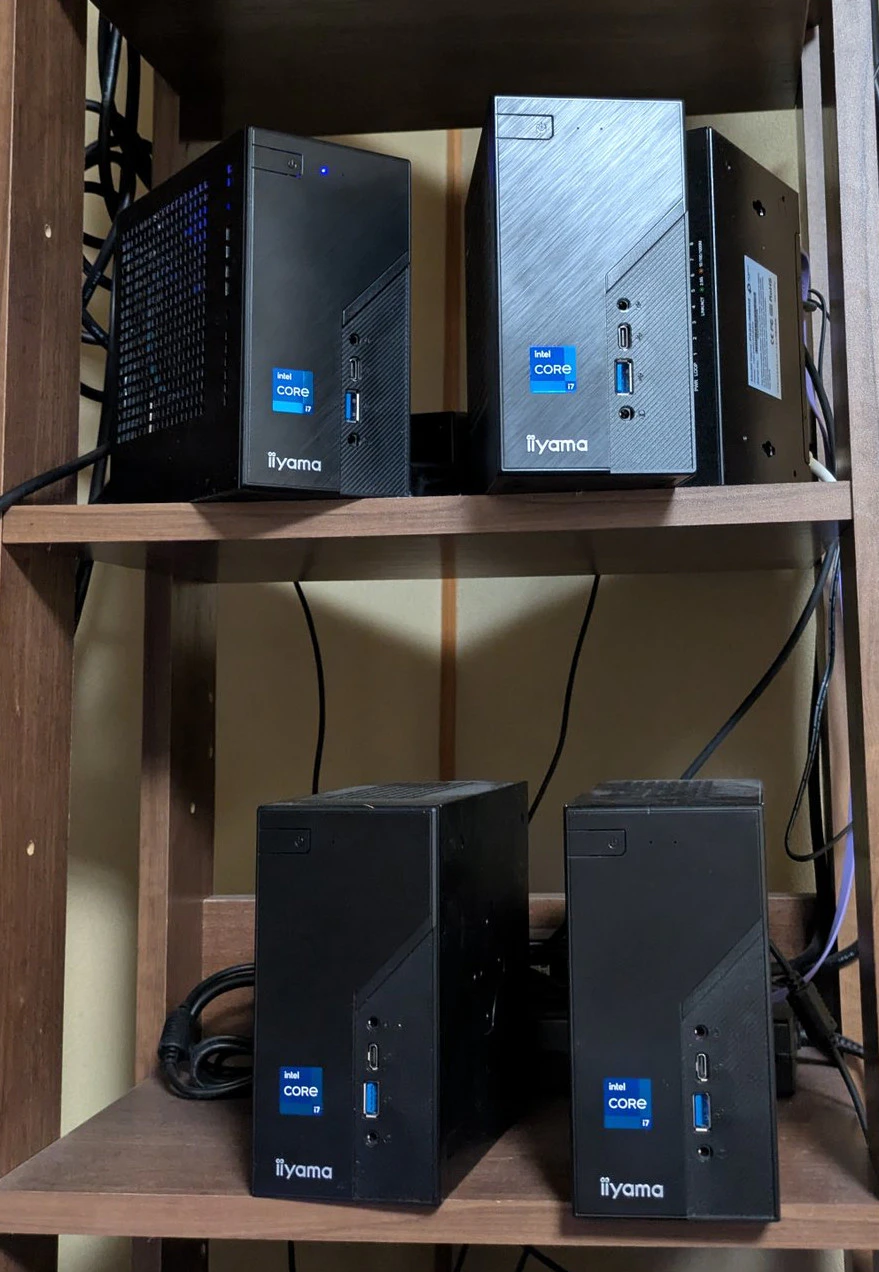
使用目的は複雑な計算が必要になるものですが、GPUを載せればより大規模な計算もできるかもです。
音は…シューシューいうのかと思いきや、以外と共鳴するのかハーモニカっぽいです。暖房機ほど熱くならないですが、なんだかヌルッとした生あたたかさを感じます。
サイズ感は本棚に普通におさまる感じだし、値段も66万円なら自家用車をショボくすれば捻出できる。
つまり、一般のご家庭に普通に置いていい感じのものに仕上りました。
まとめ
一般のご家庭でも置ける程度のコンピュータクラスタを構築、運用できることが示せたと思います!
みんなもやるといいと思うよ!楽しいよ!