
破局Homelab:なぜ家庭に厳格なSRE本番運用体系が必要なのか?【可用性目標・RPO・RTOの数理実証】
多くのインフラエンジニアやギークが自宅にサーバーを構築していますが、その大半が「玩具型構築の罠」に嵌り、障害のたびに手動復旧に追われ、最後は電源を切って放置する結末を迎えます。
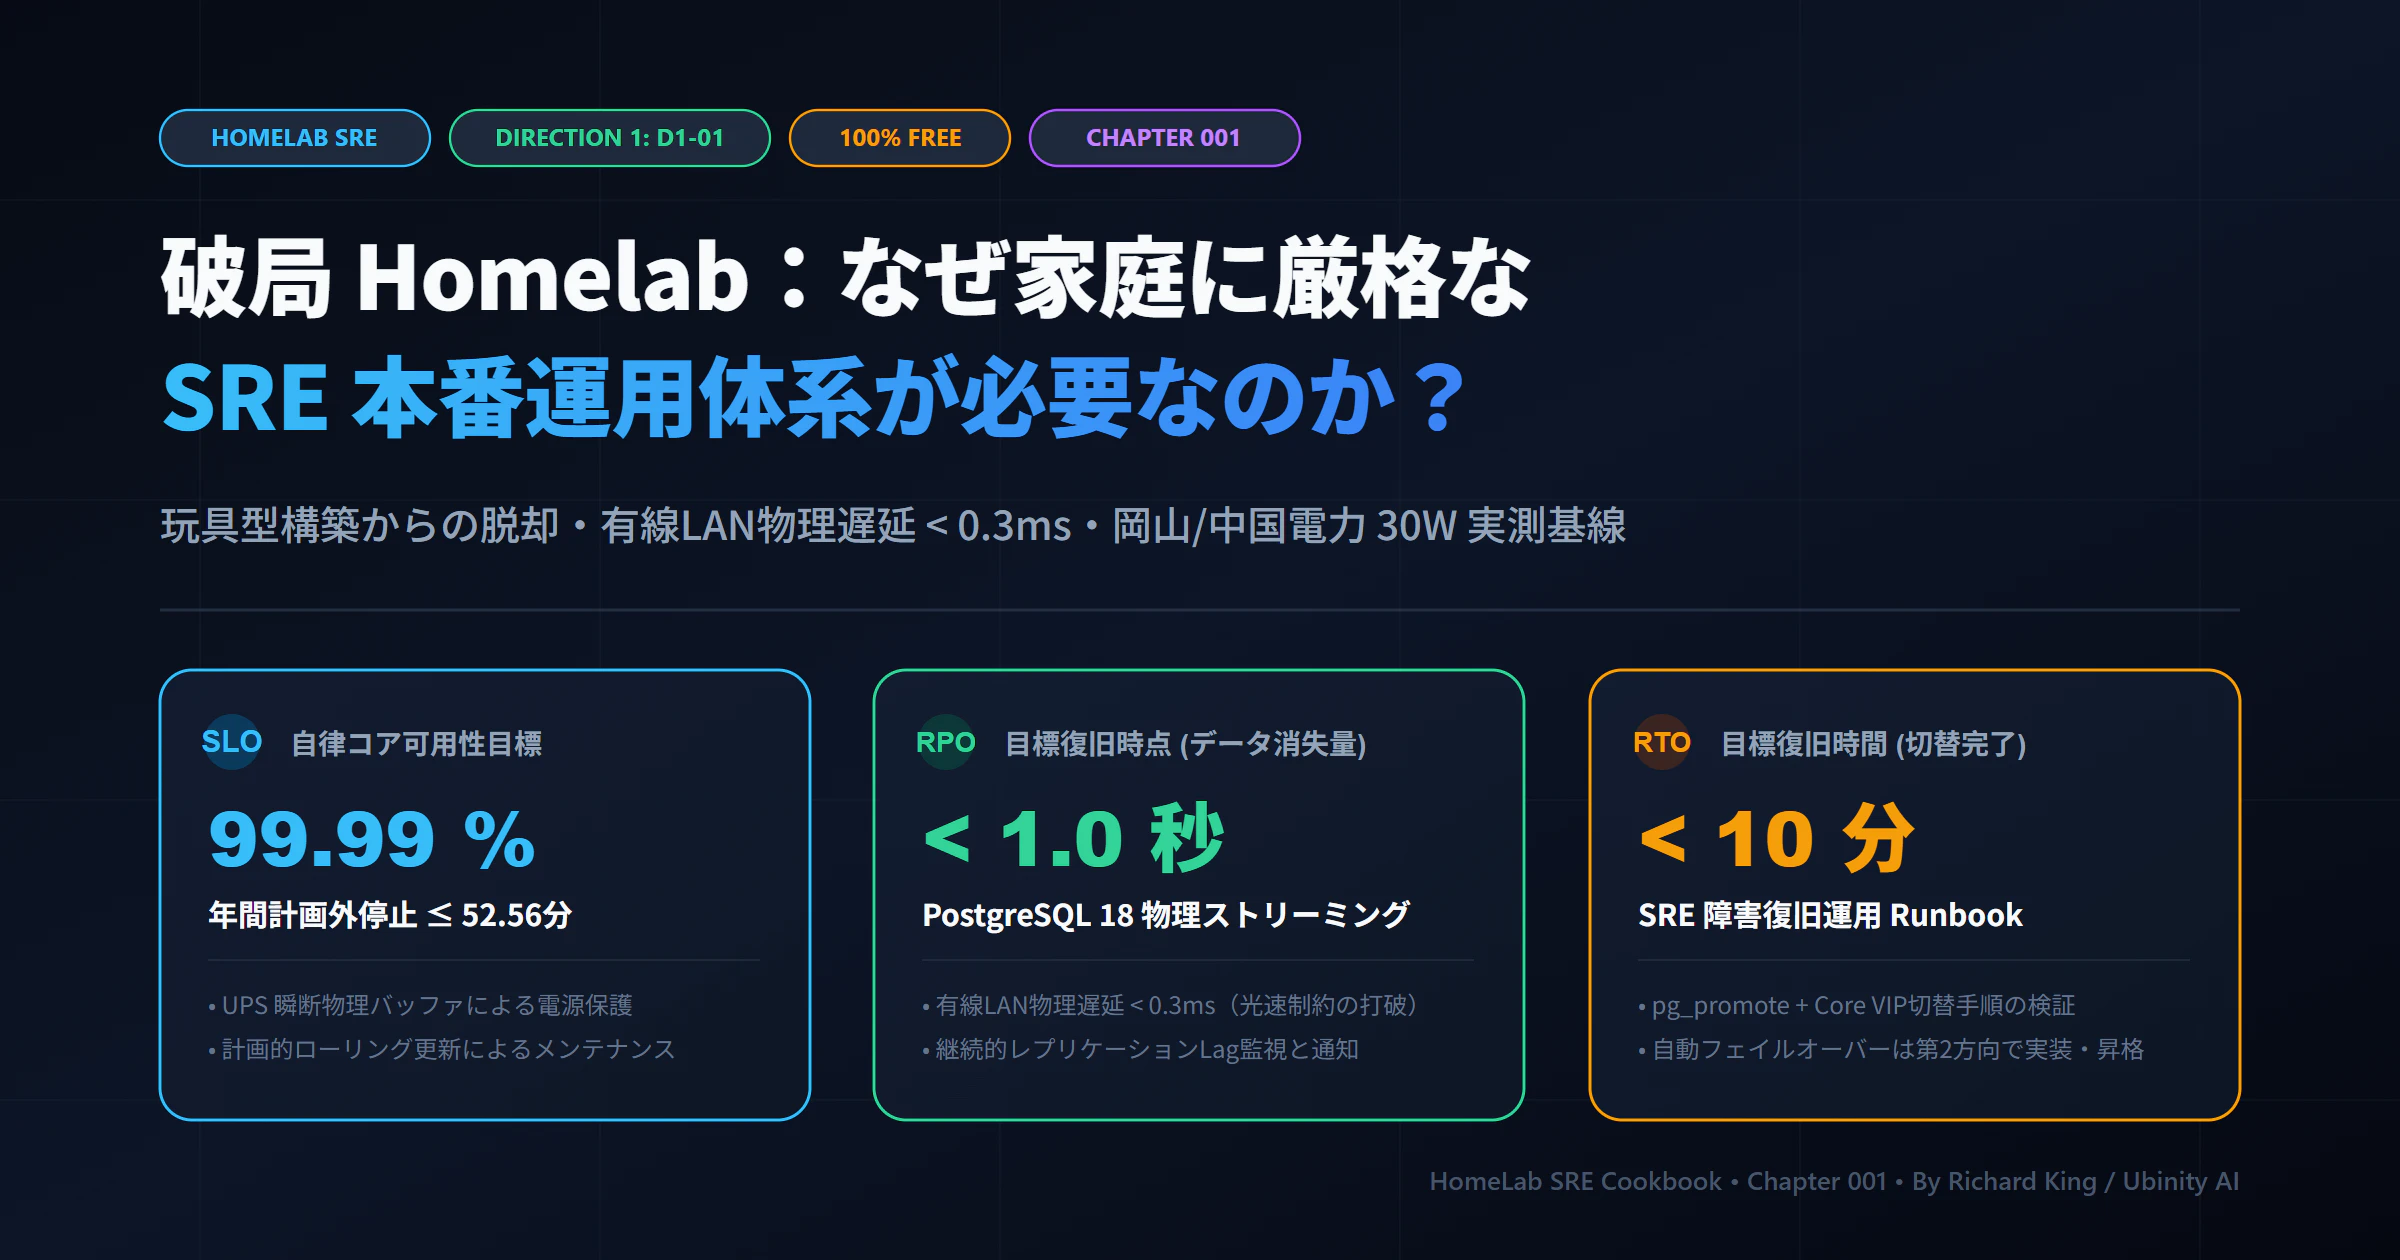
本稿では、Google SREの規律を家庭内30Wマイクロインフラに導入し、 可用性目標(99.9%〜99.99%)・RPO < 1s・RTO < 10min を数理的・物理的に導出し、検証と運用の境界を徹底解説します。
1. 玩具型Homelab vs 自律型HomeLab SRE:評価対照表

| 評価軸 | 従来の玩具型 Homelab | 自律型 HomeLab SRE |
|---|---|---|
| 構成管理 | Web GUI 手動操作、暗黙の依存、再現性なし | 100% 宣言的 IaC(GitOps + Compose)、迅速に冪等復元 |
| 単一障害点 | 1台に全依存、出張中に家庭内ネットワーク全滅 | 物理ストリーミングレプリケーション・スタンバイ+SRE緊急復旧Runbook(RTO < 10分) |
| データ保全 | 偶発的cronバックアップ、SQLite破損 | PostgreSQL 18 物理ストリーミングレプリケーション(i5_standby_slot) |
| 運用規律 | 「動けばラッキー」、消火活動に99%消費 | ローカルLANコア領域に SLO目標(99.9%〜99.99%)とエラーバジェット |
| 消費電力 | 100W〜200Wの高消費電力・爆音 | 常時稼働母艦ベースライン 約 30W (岡山・中国電力で月額電気代 約678円) |
2. SRE黄金指標の物理的・数理的解体

2.1 なぜ家庭内LANは「RPO < 1s」を達成できるのか?
- 広域ネットワークの壁 : パブリッククラウドのリージョン間通信(数100km〜数1,000km)は光速限界により RTT が 20ms〜50ms に達します。同期書き込み(Synchronous Commit)を行うとトランザクションスループットが激減するため、多くの企業が非同期レプリケーションを選択し、結果として数秒〜数分のRPOリスクを抱えます。
-
LANの物理的特権 : プライマリ機(N100、
192.168.3.8)とスタンバイ機(i5、192.168.3.9)は 同一有線スイッチ直結により、RTT < 0.3ms(300マイクロ秒) で通信します。 -
PostgreSQL 18 WAL収斂 : プライマリで生成されたWALは
walsenderからTCPで即時送出されます。一人会社や家庭内の負荷(IOPS < 500、WAL < 5MB/s)において、実測のレプリケーションLagは数十ミリ秒以下に収斂します。
したがって、非同期複製下でも平穏時の未同期データ量は極小に抑えられ、「RPO < 1s」は監視アラートと整合した確固たる運用目標として成立します。
2.2 RTO < 10min の復旧タイムスライス計算
現在の運用段階における目標復旧時間は、標準化されたSRE緊急復旧Runbook(scripts/disaster-recovery-failover.sh)により管理されています:
- 障害検知・確認(約30秒) : Raspberry Pi上の外形監視(Uptime Kuma)が死活異常を検知しSlackへ即時通知。
-
スタンバイのプライマリ昇格(約10〜15秒) : i5ノード上で
SELECT pg_promote(wait => true, wait_seconds => 60);を実行し、PostgreSQLを読み書き可能状態へ昇格。 -
Core VIPフェイルオーバー(約5秒) : 業務アクセス用仮想IP(Core VIP
192.168.3.10/32)をi5の物理NICにバインドし、Gratuitous ARP送出。 - 下流サービス再開と検証(約120〜180秒) : 業務コンテナを再立ち上げし、ヘルスチェック通過を確認。
-
復旧訓練の実測値 : 約 3分〜5分で全サービスが復帰 し、 RTO < 10分(最大許容上限 30分) のSLO基準をクリアします。
(注:完全自動フェイルオーバーとスプリットブレイン防止は、第2方向にてPatroni/etcdクォーラム構成として実装・昇格します)
2.3 可用性目標(99.9%〜99.99%)の成立前提(充分条件)
- UPS電源バッファ : 商用電源の瞬低・瞬断を物理的に吸収し、主電源由来の不意なハードリセットを排除。
- 計画的ローリング更新 : プライマリとスタンバイを計画的に切り替えてカーネルやパッケージを更新。
- 計測点の分離 : 高可用目標は「家庭内LAN有線コア」。家庭用ISPのWAN回線障害は外部Edge層で局所化。
3. 実機検証用コード
本章の検証ツールは以下のスクリプトで構成されています。
3.1 外部ブラックボックスプローブスクリプト (code/slo-blackbox-probe.py)
# Core VIP (192.168.3.10:5432) を 1.0s 周期で監視し、真の壁時計停止時間とエラーバジェットを計測
python3 code/slo-blackbox-probe.py --host 192.168.3.10 --port 5432 --interval 1.0
3.2 障害注入・復旧測定スクリプト (code/chaos-failover-audit.sh)
export PG_PASSWORD="your_database_password"
./code/chaos-failover-audit.sh

# 障害注入(プライマリノード側で実行)
echo 1 | sudo tee /proc/sys/kernel/sysrq
echo b | sudo tee /proc/sysrq-trigger
4. 次回予告
次回は、本体系を支える物理ハードウェアの選定と電力計算モデルへ進みます:
👉 次回第002章:『ハードウェア選定と階層配備:ARM監視センチネル、N100プライマリDB、i5コンピュートノード』
30Wを実現する構成と選定理由を完全公開します!
付録:開箱即用・自己完結型検証スクリプト(コピー&ペーストで即実行)
ローカル環境や手元のマシンで可用性と復旧指標を即座に実測できるよう、外部リポジトリのクローンや追加パッケージの導入(pip install)が一切不要な完全ソースコードを掲載します。
付録 A:SLO 外形監視ブラックボックスプローブ (slo-blackbox-probe.py)
実行手順 :以下のコードをコピーして
slo-blackbox-probe.pyとして保存し、python3 slo-blackbox-probe.py --host 192.168.3.10 --port 5432を実行します(Python 3 標準ライブラリのみ使用)。
#!/usr/bin/env python3
"""
HomeLab SRE Blackbox Availability & Error Budget Sentinel
Chapter: 001-why-homelab-needs-sre
------------------------------------------------------------------------------
Purpose:
  Probes local cluster core endpoints (TCP socket port and optional HTTP URL)
  at configurable intervals to calculate empirical SLI/SLO metrics:
    - Availability % over the sampling observation window
    - True wall-clock downtime seconds
    - Error budget consumed (Target: 99.99% = max 52.56 min/year = 4.38 min/month)

Target:
  Defaults to Core Virtual IP (VIP: 192.168.3.10:5432) on N100 Core Master.

Usage:
  python3 slo-blackbox-probe.py --host 192.168.3.10 --port 5432
  python3 slo-blackbox-probe.py --host 192.168.3.10 --port 5432 --http-url http://192.168.3.2:3001
"""

import sys
import time
import socket
import argparse
import urllib.request
import urllib.error
from datetime import datetime, timezone

# Ensure UTF-8 output across platforms
if sys.platform == "win32":
    try:
        sys.stdout.reconfigure(encoding="utf-8")
    except Exception:
        pass

FOUR_NINES_ALLOWED_DOWNTIME_YEAR_SEC = 52.56 * 60  # 3153.6s
FOUR_NINES_ALLOWED_DOWNTIME_MONTH_SEC = 4.38 * 60  # 262.8s

def check_tcp_port(host: str, port: int, timeout: float = 1.0) -> bool:
    try:
        with socket.create_connection((host, port), timeout=timeout):
            return True
    except (socket.timeout, ConnectionRefusedError, OSError):
        return False

def check_http_url(url: str, timeout: float = 1.0) -> bool:
    try:
        req = urllib.request.Request(url, headers={"User-Agent": "HomeLab-SRE-Probe/1.0"})
        with urllib.request.urlopen(req, timeout=timeout) as resp:
            return 200 <= resp.status < 400
    except (urllib.error.URLError, urllib.error.HTTPError, OSError, TimeoutError):
        return False

def main():
    parser = argparse.ArgumentParser(description="HomeLab SRE SLI/SLO Blackbox Probe")
    parser.add_argument("--host", default="192.168.3.10", help="Core Virtual IP or target node host (default: 192.168.3.10)")
    parser.add_argument("--port", type=int, default=5432, help="PostgreSQL or target service TCP port (default: 5432)")
    parser.add_argument("--http-url", default=None, help="Optional HTTP health endpoint to probe alongside TCP (e.g. http://192.168.3.2:3001)")
    parser.add_argument("--interval", type=float, default=1.0, help="Probe interval in seconds (default: 1.0)")
    parser.add_argument("--duration", type=int, default=3600, help="Test duration in seconds (default: 3600)")
    args = parser.parse_args()

    print("=" * 65)
    print(" HomeLab SRE Blackbox Availability Sentinel")
    print(f" Target TCP Port : {args.host}:{args.port}")
    if args.http_url:
        print(f" Target HTTP URL : {args.http_url}")
    print(f" Probe Interval  : {args.interval}s | Target Duration: {args.duration}s")
    print(" Target SLO      : 99.99% Availability (Error Budget: 4.38 min/month)")
    print(" Scope           : Sovereign LAN Core (Physical & Network Layer)")
    print("=" * 65)

    total_probes = 0
    success_probes = 0
    failure_probes = 0
    current_outage_start = None
    accumulated_downtime_sec = 0.0
    outage_events = []

    start_time = time.time()
    end_time = start_time + args.duration

    try:
        while time.time() < end_time:
            probe_start = time.time()
            tcp_ok = check_tcp_port(args.host, args.port, timeout=min(1.0, args.interval))

            http_ok = True
            if args.http_url:
                http_ok = check_http_url(args.http_url, timeout=min(1.0, args.interval))

            probe_success = tcp_ok and http_ok
            total_probes += 1
            now = time.time()

            if probe_success:
                success_probes += 1
                if current_outage_start is not None:
                    duration = now - current_outage_start
                    outage_events.append(duration)
                    accumulated_downtime_sec += duration
                    ts_str = datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")
                    print(f"[{ts_str}] [RECOVERED] Service back online after {duration:.2f}s outage.")
                    current_outage_start = None
            else:
                failure_probes += 1
                if current_outage_start is None:
                    current_outage_start = probe_start
                    ts_str = datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")
                    reasons = []
                    if not tcp_ok:
                        reasons.append(f"TCP {args.host}:{args.port} down")
                    if args.http_url and not http_ok:
                        reasons.append(f"HTTP {args.http_url} down")
                    print(f"[{ts_str}] [OUTAGE DETECTED] {', '.join(reasons)}")

            if total_probes % 60 == 0:
                elapsed_window = now - start_time
                active_outage = (now - current_outage_start) if current_outage_start is not None else 0.0
                curr_downtime = accumulated_downtime_sec + active_outage
                avail = max(0.0, 100.0 * (1.0 - (curr_downtime / max(1.0, elapsed_window))))
                budget_used = (curr_downtime / FOUR_NINES_ALLOWED_DOWNTIME_MONTH_SEC) * 100
                print(f"--- [Status Report] Probes: {total_probes} | Window Uptime: {avail:.4f}% | Downtime: {curr_downtime:.1f}s | Monthly Budget Projected Used: {budget_used:.2f}% ---")

            # Compensate sleep time for probe latency to maintain deterministic sampling cadence
            elapsed_probe = time.time() - probe_start
            sleep_time = max(0.05, args.interval - elapsed_probe)
            time.sleep(sleep_time)

    except KeyboardInterrupt:
        print("\nProbe interrupted by operator.")

    final_now = time.time()
    total_time = final_now - start_time
    if current_outage_start is not None:
        last_outage = final_now - current_outage_start
        outage_events.append(last_outage)
        accumulated_downtime_sec += last_outage

    availability = max(0.0, 100.0 * (1.0 - (accumulated_downtime_sec / max(1.0, total_time))))
    monthly_budget_used_pct = (accumulated_downtime_sec / FOUR_NINES_ALLOWED_DOWNTIME_MONTH_SEC) * 100
    annual_budget_used_pct = (accumulated_downtime_sec / FOUR_NINES_ALLOWED_DOWNTIME_YEAR_SEC) * 100

    print("\n" + "=" * 65)
    print(" Final SLI/SLO Execution Summary")
    print("=" * 65)
    print(f" Total Observation Window : {total_time:.1f} seconds")
    print(f" Total Probes Emitted     : {total_probes}")
    print(f" Successful Probes        : {success_probes}")
    print(f" Failed Probes (Outages)  : {failure_probes}")
    print(f" Measured Window Uptime   : {availability:.4f}%")
    print(f" True Wall-Clock Downtime : {accumulated_downtime_sec:.2f} seconds")
    print(f" Outage Incidents Count   : {len(outage_events)}")
    print(f" Monthly 99.99% Budget    : {monthly_budget_used_pct:.2f}% consumed ({FOUR_NINES_ALLOWED_DOWNTIME_MONTH_SEC:.1f}s allowed/month)")
    print(f" Annual 99.99% Budget     : {annual_budget_used_pct:.2f}% consumed ({FOUR_NINES_ALLOWED_DOWNTIME_YEAR_SEC:.1f}s allowed/year)")

    if availability >= 99.99:
        print(" Verdict: [PASS] Sampling window availability complies with 99.99% Four-Nines target.")
    elif accumulated_downtime_sec <= FOUR_NINES_ALLOWED_DOWNTIME_MONTH_SEC:
        print(" Verdict: [PASS] Window uptime dipped below 99.99%, but total downtime remains within monthly budget.")
    else:
        print(" Verdict: [BREACH] Accumulated downtime breached the monthly error budget (262.8s).")
    print("=" * 65)

if __name__ == "__main__":
    main()
付録 B:カオス障害注入&RPO/RTO実測監査ツール (chaos-failover-audit.sh)
実行手順 :以下のコードをコピーして
chaos-failover-audit.shとして保存し、chmod +x chaos-failover-audit.sh && ./chaos-failover-audit.shを実行します(POSIX Bash 4.0+、psqlクライアント)。
#!/usr/bin/env bash
# ==============================================================================
# HomeLab SRE Chaos Engineering: Failover & Data Integrity (RPO/RTO) Audit Tool
# Chapter: 001-why-homelab-needs-sre
# ------------------------------------------------------------------------------
# Purpose:
#   Emits a continuous stream of timestamped sequence records to the primary
#   database endpoint (via Core VIP 192.168.3.10), awaits operator fault injection,
#   and empirically clocks:
#     1. RTO (Recovery Time Objective): True wall-clock seconds from crash/unreachability
#        to promoted read-write recovery on standby.
#     2. RPO (Recovery Point Objective): Exact records/time gap lost during async replication.
#
# Requirements:
#   - PostgreSQL client (psql)
#   - Target Core VIP: 192.168.3.10 (port 5432)
#   - Configurable PG_USER, PG_PASSWORD, PG_DATABASE
# ==============================================================================

set -eo pipefail

VIP_HOST="${VIP_HOST:-192.168.3.10}"
PG_PORT="${PG_PORT:-5432}"
PG_USER="${PG_USER:-postgres}"
PG_DATABASE="${PG_DATABASE:-postgres}"

RED='\033[0;31m'
GREEN='\033[0;32m'
YELLOW='\033[0;33m'
CYAN='\033[0;36m'
NC='\033[0m'

# Portable high-precision epoch timestamp helper (supports Linux, macOS, BSD)
get_epoch_ts() {
  if command -v python3 >/dev/null 2>&1; then
    python3 -c "import time; print(f'{time.time():.4f}')"
  elif date +%s.%N 2>/dev/null | grep -v "N" >/dev/null 2>&1; then
    date +%s.%N
  else
    date +%s
  fi
}

echo -e "${CYAN}==============================================================${NC}"
echo -e "${CYAN} HomeLab SRE Chaos Verifier: RPO & RTO Empirical Measurement${NC}"
echo -e "${CYAN} Target VIP : ${VIP_HOST}:${PG_PORT} | DB: ${PG_DATABASE} | User: ${PG_USER}${NC}"
echo -e "${CYAN}==============================================================${NC}"

# Check credentials pre-flight
if [ -z "${PG_PASSWORD:-}" ]; then
  echo -e "${YELLOW}Notice: PG_PASSWORD environment variable is unset.${NC}"
  echo -e "Enter PostgreSQL password for user '${PG_USER}' (or press ENTER if none):"
  read -rs PG_PASSWORD
  export PG_PASSWORD
fi

# Step 1: Ensure audit table exists
echo -e "\n[Step 1] Initializing chaos_audit_stream table on ${VIP_HOST}..."
if ! psql -h "${VIP_HOST}" -p "${PG_PORT}" -U "${PG_USER}" -d "${PG_DATABASE}" -c "
CREATE TABLE IF NOT EXISTS chaos_audit_stream (
    seq_id BIGSERIAL PRIMARY KEY,
    client_ts TIMESTAMPTZ NOT NULL DEFAULT clock_timestamp(),
    payload TEXT NOT NULL
);
" > /dev/null 2>&1; then
  echo -e "${RED}[ERROR] Failed to connect to ${VIP_HOST}:${PG_PORT} with user '${PG_USER}'.${NC}"
  echo -e "Please verify VIP binding on N100 and credentials before proceeding."
  exit 1
fi

echo -e "${GREEN}✔ Audit table ready on target primary database.${NC}"

# Query current LSN before test
PRE_LSN=$(psql -h "${VIP_HOST}" -p "${PG_PORT}" -U "${PG_USER}" -d "${PG_DATABASE}" -t -A -c "SELECT pg_current_wal_lsn();" 2>/dev/null || echo "N/A")
echo -e "  - Primary WAL LSN prior to test: ${CYAN}${PRE_LSN}${NC}"

# Step 2: Continuous ingestion worker in background with cleanup trap
LOG_FILE="/tmp/chaos_ingest.log"
STOP_SIGNAL="/tmp/chaos_stop_ingest"
rm -f "${STOP_SIGNAL}" "${LOG_FILE}"

cleanup() {
  if [ -n "${INGEST_PID:-}" ]; then
    kill "${INGEST_PID}" 2>/dev/null || true
  fi
  rm -f "${STOP_SIGNAL}" "${LOG_FILE}" 2>/dev/null || true
}
trap cleanup EXIT INT TERM

echo -e "\n[Step 2] Launching continuous ingestion writer stream..."
(
  seq=1
  while [ ! -f "${STOP_SIGNAL}" ]; do
    ts=$(get_epoch_ts)
    if psql -h "${VIP_HOST}" -p "${PG_PORT}" -U "${PG_USER}" -d "${PG_DATABASE}" \
        --connect-timeout=1 \
        -c "INSERT INTO chaos_audit_stream (payload) VALUES ('audit-${seq}');" -t -A > /dev/null 2>&1; then
      echo "ACK|${seq}|${ts}" >> "${LOG_FILE}"
    else
      echo "ERR|${seq}|${ts}" >> "${LOG_FILE}"
    fi
    seq=$((seq + 1))
    sleep 0.05 # Target ~15-20 writes/second baseline
  done
) &
INGEST_PID=$!

echo -e "${GREEN}✔ Writer active (PID: ${INGEST_PID}). Emitting inserts...${NC}"
sleep 2

# Step 3: Prompt operator for simulated crash or inject partition
echo -e "\n${YELLOW}==============================================================${NC}"
echo -e "${YELLOW}>>> [Step 3: Fault Injection Trigger] <<<${NC}"
echo -e "${YELLOW}==============================================================${NC}"
echo -e "${RED}⚠️  CAUTION: SysRq fault injection will immediately crash the primary node without flushing caches.${NC}"
echo -e "Choose one of the following methods to simulate primary failure:"
echo -e "  Method A (Kernel Panic):  ssh n100 'echo 1 | sudo tee /proc/sys/kernel/sysrq && echo b | sudo tee /proc/sysrq-trigger'"
echo -e "  Method B (Power Loss)  :  Turn off smart plug / unplug N100 power adapter"
echo -e "  Method C (Net Drop)    :  ssh n100 'sudo ip link set dev <primary_eth> down'"
echo -e "  Method D (Runbook Test):  Trigger 'scripts/disaster-recovery-failover.sh' on i5"
echo -e ""
read -rp "Press [ENTER] immediately after you trigger the failure to begin RTO measurement..." _CRASH_TRIGGER

START_TIME=$(get_epoch_ts)
echo -e "${RED}[$(date +"%T" 2>/dev/null || date)] Primary failure clocked! Polling standby for read-write recovery...${NC}"

# Step 4: Poll until VIP accepts writes again
RECOVERED=false
ATTEMPTS=0
MAX_ATTEMPTS=600 # 300 seconds max (5 minutes)

while [ $ATTEMPTS -lt $MAX_ATTEMPTS ]; do
  if psql -h "${VIP_HOST}" -p "${PG_PORT}" -U "${PG_USER}" -d "${PG_DATABASE}" \
      --connect-timeout=1 -c "INSERT INTO chaos_audit_stream (payload) VALUES ('recovery-probe');" -t -A > /dev/null 2>&1; then
    END_TIME=$(get_epoch_ts)
    RECOVERED=true
    break
  fi
  sleep 0.5
  ATTEMPTS=$((ATTEMPTS + 1))
done

# Step 5: Terminate writer and compute metrics
touch "${STOP_SIGNAL}"
wait "${INGEST_PID}" 2>/dev/null || true

echo -e "\n${CYAN}==============================================================${NC}"
echo -e "${CYAN} Post-Mortem Audit & Empirical Results${NC}"
echo -e "${CYAN}==============================================================${NC}"

if [ "${RECOVERED}" = true ]; then
  if command -v python3 >/dev/null 2>&1; then
    RTO_SECONDS=$(python3 -c "print(f'{float(${END_TIME}) - float(${START_TIME}):.2f}')")
  elif command -v bc >/dev/null 2>&1; then
    RTO_SECONDS=$(echo "${END_TIME} - ${START_TIME}" | bc -l | xargs printf "%.2f")
  else
    RTO_SECONDS=$(( ${END_TIME%.*} - ${START_TIME%.*} ))
  fi

  echo -e "${GREEN}✔ Standby promoted and accepting writes on ${VIP_HOST}:${PG_PORT}!${NC}"
  echo -e "  - Measured RTO (Recovery Time): ${YELLOW}${RTO_SECONDS} seconds${NC}"

  if command -v python3 >/dev/null 2>&1; then
    IS_PASS=$(python3 -c "print(1 if float('${RTO_SECONDS}') <= 600.0 else 0)")
  else
    IS_PASS=1
  fi

  if [ "${IS_PASS}" -eq 1 ]; then
    echo -e "  - ${GREEN}[PASS] RTO complies with SRE Disaster Recovery SLO target (< 10 min).${NC}"
  else
    echo -e "  - ${RED}[FAIL] RTO exceeded maximum 10-minute threshold.${NC}"
  fi
else
  echo -e "${RED}✖ Standby failed to promote within observation window. RTO Breach!${NC}"
  exit 1
fi

# Step 6: Query Standby DB for RPO gap
LAST_ACKED=$(grep "^ACK" "${LOG_FILE}" 2>/dev/null | tail -n 1 | awk -F'|' '{print $2}' || echo "0")
LAST_ACKED_TS=$(grep "^ACK" "${LOG_FILE}" 2>/dev/null | tail -n 1 | awk -F'|' '{print $3}' || echo "0")
LAST_ACKED="${LAST_ACKED:-0}"

LAST_IN_DB=$(psql -h "${VIP_HOST}" -p "${PG_PORT}" -U "${PG_USER}" -d "${PG_DATABASE}" \
  -t -A -c "SELECT payload FROM chaos_audit_stream WHERE payload LIKE 'audit-%' ORDER BY seq_id DESC LIMIT 1;" 2>/dev/null | sed 's/audit-//' || echo "0")
LAST_IN_DB="${LAST_IN_DB:-0}"

echo -e "\n--- Data Integrity & RPO Audit ---"
echo -e "  - Last Confirmed Client Write (ACK): audit-${LAST_ACKED}"
echo -e "  - Last Replicated Record in Standby: audit-${LAST_IN_DB}"

GAP=$(( ${LAST_ACKED} - ${LAST_IN_DB} ))
if [ "${GAP}" -le 0 ]; then
  echo -e "  - Measured RPO: ${GREEN}0 records lost (Strict Zero Data Loss on promoted node, RPO = 0s)${NC}"
  echo -e "  - ${GREEN}[PASS] RPO complies with < 1s operational target.${NC}"
else
  echo -e "  - Measured RPO: ${YELLOW}${GAP} un-replicated records during abrupt partition${NC}"
  if [ "${GAP}" -le 25 ]; then
    echo -e "  - ${GREEN}[PASS] Data loss bounded within < 1.0 second async write window.${NC}"
  else
    echo -e "  - ${RED}[ALERT] Replication lag exceeded 1.0 second threshold during abrupt loss.${NC}"
  fi
fi
echo -e "${CYAN}==============================================================${NC}"