
はじめに
Marketing Mix Modeling(MMM)は売上などのKPIに対するマーケティング施策(主に広告など)の横断での効果検証や予算配分の最適化をするために活用される分析手法です。
MMMをざっくりと解釈すると、
「売上などのKPIに対する重回帰分析を行い、そのモデルの説明変数としてのメディア変数(主に広告のインプレッションやリーチ/フリクエンシーなど)の偏回帰係数をメディアの効果と見なす」
ような分析手法と言えます。
具体的なイメージは、下記のように、売上を各要因ごとに分解して説明する数理モデルを構築します。(※厳密には、広告の残存効果や逓減効果を考慮した形で、その効果をモデリングするのですが、ここでは割愛します。)

したがって、MMMモデルを構築する上では、重回帰分析を用いて因果効果を推定する際の諸注意点に気をつける必要が出てきます。そこで登場するのが、バックドア基準となります。
バックドア基準の解説
バックドア基準を一言で言うと、因果効果のバイアスのない推定値を得るための、変数選択についての理論的基準と言えます。すなわち
選択された変数のセットがバックドア基準を満たしているのであれば、その変数のセットから推定される推定値を因果効果として見做せる
という事になります。
具体的には、因果ダイアグラム上において以下の2つの条件を満たす事が要求されます。
- 条件1:処置$T$→結果$Y$のバックドアパスをブロックする
- 条件2:処置$T$→結果$Y$の流れ(有向道)をブロックするな
※因果ダイアグラム:変数(要因)間の因果関係を矢印で視覚的に表現した図
※バックドアパス:処置$T$と結果$Y$の両者に影響を与えうる、両者の上流側にある流れ
また、重回帰分析による因果効果の推定においては、
重回帰モデルに含まれている説明変数のセットが「処置$T$→結果$Y$についてのバックドア基準を満たすのであれば、処置$T$の偏回帰係数を「処置$T$→結果$Y$の因果効果」のバイアスの無い推定値として解釈する事が出来ます。
すなわち、説明変数のセットがバックドア基準を満たしている事は、重回帰分析を使った因果効果の推定を行うため十分条件であると言えます。
次節では、MMMにおける具体例を用いて、「バックドア基準を満たす」とはどういう事なのかを具体的に見ていきます。
バックドア基準のMMMにおける具体例
今回は、あくまで仮定として、売上をKPIとした時の媒体毎の広告の効果を見ていきたいと考えます。その際に、下記の変数セットがどうやら売上に関係していそうだということが分かっている状況を想定します。
- 各媒体の広告費$T$(今回は、これが介入変数となる)
- 各媒体の広告クリック数$M$
- マクロ経済における景気$C$
上記の変数セットで因果ダイアグラムを書こうとすると、以下のような因果関係になるかもしれません。
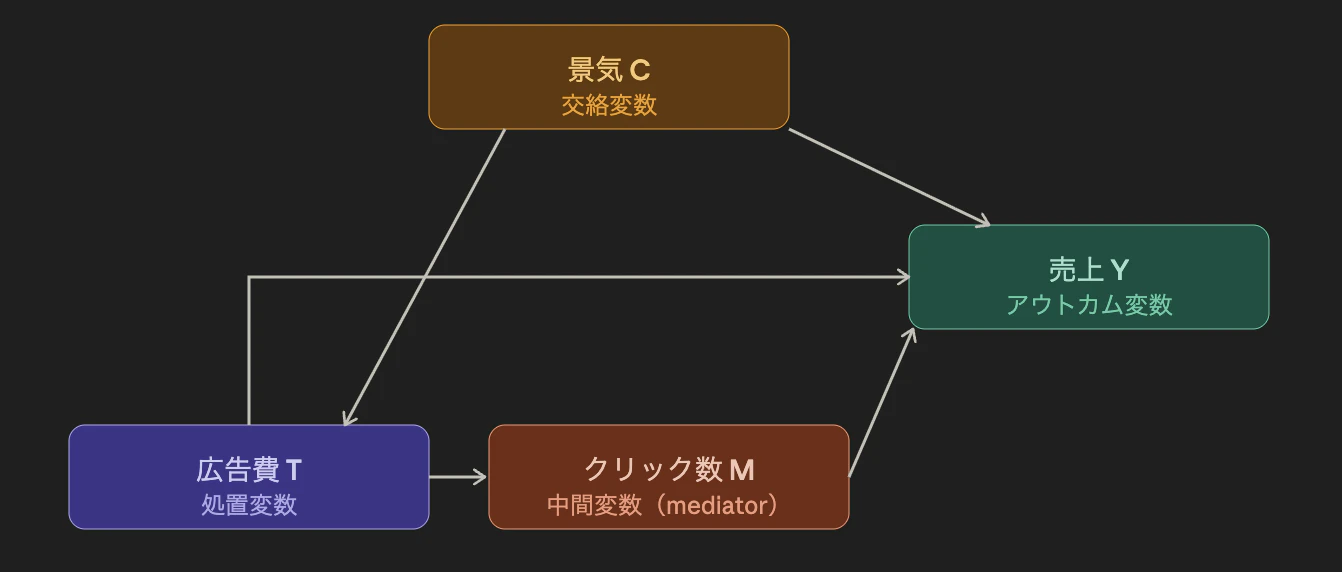
- 景気が良くなれば、広告費も上がり、売上も上がる
- 広告費の増減によって、売上も増減する
- 広告費の増減によって、広告のクリック数も増減する
- 広告のクリックは、売上コンバージョンにつながる
では、上記の因果ダイアグラムにおいてバックドア基準を満たすとはどういうことでしょうか?
いくつかの変数セットを考えてみます。
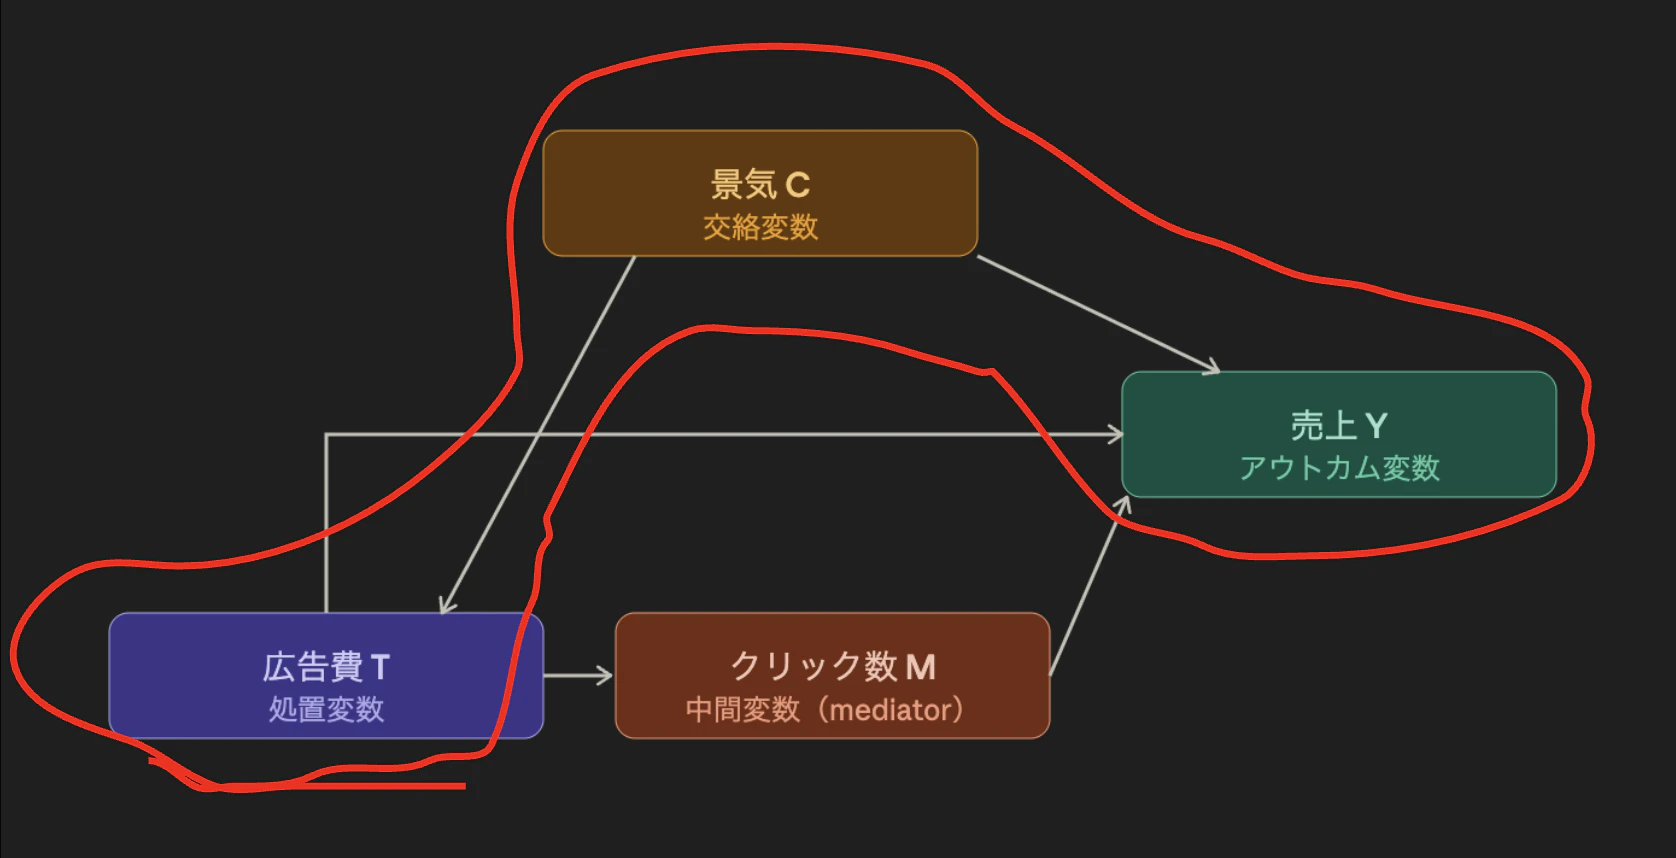
もし変数セットが広告費$T$のみだった場合、どうでしょうか?
バックドア基準の条件1に照らし合わせてみると、広告費$T$→売上$Y$のバックドアパスが開いています。したがって、景気$C$を変数セットに加えることで、バックドアパスを閉じる事が出来そうです。
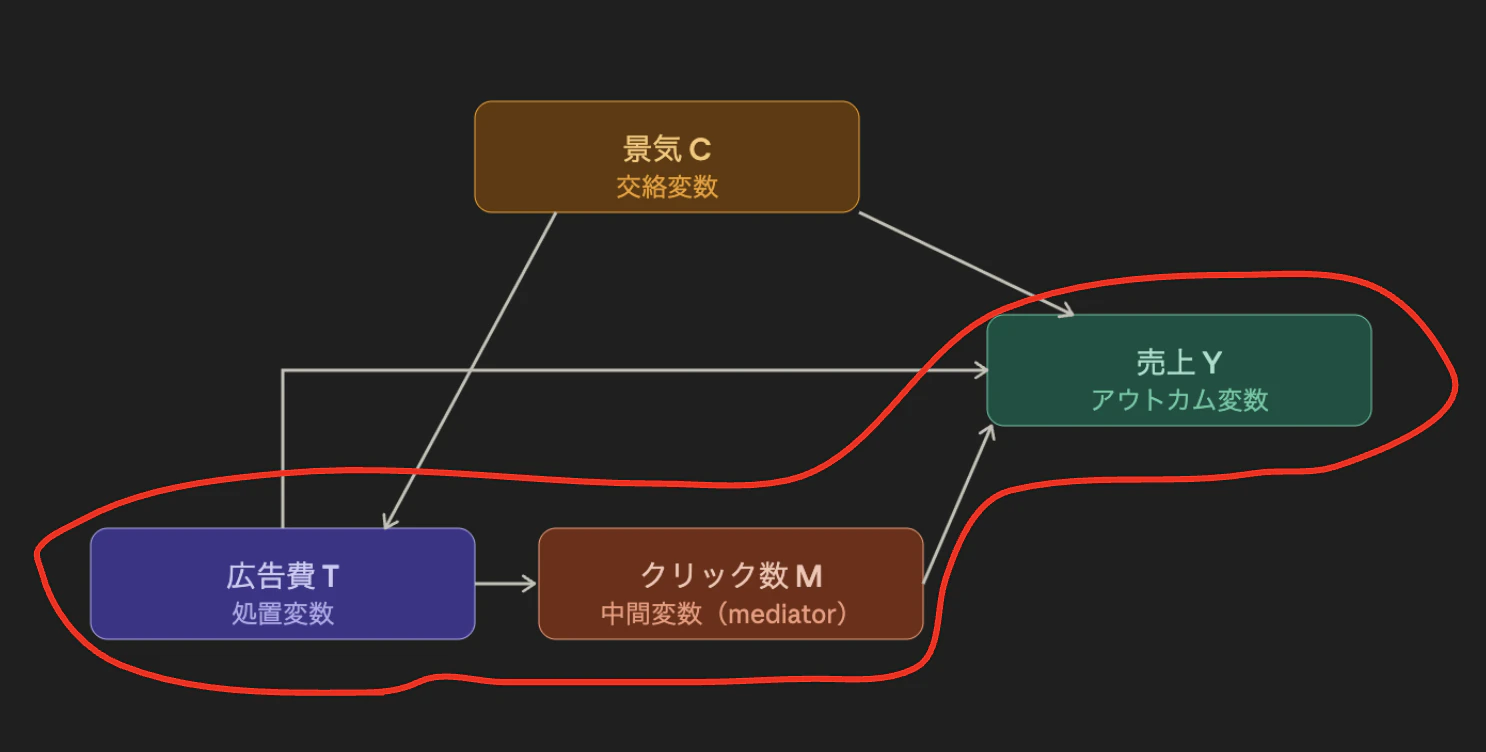
次に、クリック数$M$を変数セットに入れた場合、どうでしょうか?
今度は、条件2に照らし合わせてみると、処置$T$→結果$Y$の有向道をブロックしてしまっている事が分かります。したがって、クリック数$M$は変数セットに加えるべきではない事が分かります。
以上より、今回の設定において、バックドア基準を満たす変数セットは、
\{広告費T, 景気C\}
となります。
では、次節からは、本当にこの変数セットでバイアスの無い因果効果を推定する事が出来るのかを擬似データにより検証していきます。
擬似データによる実証
今回は、重回帰分析を用いて、$広告費T→売上Y$の因果効果を調べていきます。
また、今回の因果ダイアグラムにおいて、以下のようなデータ生成過程を取っているとします。
\begin{aligned}
  T &= 1.5C + \epsilon_{T} \quad where \quad\epsilon_{T} \sim N(0,1) \\
  M &= 0.8T + \epsilon_{M} \quad where \quad\epsilon_{M} \sim N(0,1) \\
  Y &= 2.0T + 1.0M + 3.0C + \epsilon_{Y} \quad where \quad\epsilon_{Y} \sim N(0,1)
\end{aligned}
したがって、バイアスの無い形で、$広告費T→売上Y$の因果効果を算出する事ができれば、その効果は、おおよそ$+2.8pt$となるはずです。($T→Y$への直接効果が$+2.0pt$であり、$T→Y$の間接効果が$+0.8pt$であるから)
まずは下記のコードで、擬似データを生成していきます。
import numpy as np
import pandas as pd

np.random.seed(42)
N = 2000

# ============================================================
# データ生成過程(DGP)
# ============================================================
# DAG構造:
#   景気C → 広告費T → 売上Y
#   景気C → 売上Y          (分岐点: 交絡)
#   広告費T → クリック数M → 売上Y  (中間点: 過剰調整の罠)
#
# 真の因果効果(知りたい値)
#   広告費T → 売上Y の係数 = 2.0

# --- 外生変数 ---
C = np.random.normal(0, 1, N)          # 景気(交絡・分岐点)
eps_T = np.random.normal(0, 1, N)
eps_M = np.random.normal(0, 1, N)
eps_Y = np.random.normal(0, 1, N)
eps_K = np.random.normal(0, 1, N)

# --- 処置変数 ---
# 景気が良いほど広告費も増える(交絡の源泉)
T = 1.5 * C + eps_T                    # 広告費

# --- 中間変数(T→M→Y の経路) ---
M = 0.8 * T + eps_M                    # クリック数(中間点)

# --- 結果変数 ---
# T→Y の真の直接効果 = 2.0(これをバイアスなく推定したい)
# M→Y の効果 = 1.0(間接効果 = 0.8 * 1.0 = 0.8、合計因果効果 = 2.0 + 0.8 = 2.8)
# C→Y の効果 = 3.0(景気の直接効果)
Y = 2.0 * T + 1.0 * M + 3.0 * C + eps_Y

df = pd.DataFrame({
    "C": C,   # 景気(分岐点・交絡)
    "T": T,   # 広告費(処置)
    "M": M,   # クリック数(中間点)
    "Y": Y,   # 売上(結果)
})
次に、以下のコードで、いくつかの変数セットの組み合わせパターン毎に、重回帰分析を回していきます。
import statsmodels.api as sm

def run_ols(df, covariates):
    X = sm.add_constant(df[covariates])
    model = sm.OLS(df["Y"], X).fit()
    coef = model.params["T"]
    ci = model.conf_int().loc["T"]
    return coef, ci[0], ci[1]

patterns = {
    "何も入れない(バックドア開きっぱなし)":
        ["T"],
    "中間点Mを入れる(過剰調整)":
        ["T", "M", "C"],
    "分岐点Cのみ(バックドア基準を満たす)":
        ["T", "C"],
}

# 推定したいもの:
#   パターンA/B/C → 真の値(2.0 or 2.8)からズレる
#   パターンD     → 直接効果 2.0 に収束する

results = {}
for label, covs in patterns.items():
    coef, lo, hi = run_ols(df, covs)
    results[label] = {"coef": coef, "ci_low": lo, "ci_high": hi}

print(f"{'パターン':<45} {'推定値':>8} {'95%CI':>20}")
print("-" * 75)
for label, r in results.items():
    print(f"{label:<45} {r['coef']:>8.3f}  "
          f"[{r['ci_low']:.3f}, {r['ci_high']:.3f}]")
print(f"\n※ 真の直接効果 T→Y = 2.000")
print(f"※ 真の総因果効果 T→Y(M経由含む)= {2.0 + 0.8*1.0:.3f}")
結果として、以下のような推定値を得る事が出来ました。やはり、変数セットを$広告費T$と$景気C$にすることで、$広告費T→売上Y$の因果効果を適切に推定できている事が分かります。
| パターン | 推定値 | 95% CI | 真の値との比較 |
|---|---|---|---|
| 広告費Tのみ | 4.187 | [4.132, 4.242] | 過大バイアス(真値2.8より +1.4) |
| 広告費T, クリック数M, 景気C | 1.956 | [1.897, 2.015] | 直接効果2.0に近いが意図しない推定 |
| 広告費T, 景気C | 2.819 | [2.755, 2.883] | 総因果効果2.8に収束 ✓ |
真の値:直接効果 = 2.000 / 総因果効果(T→M→Y経由含む)= 2.800
まとめ
以上の結果から、バイアスの無い因果効果を推定するためには、バックドア基準を用いた変数選択が有効である事が分かりました。
ただ、実際のビジネス実務においては、「そもそもの因果ダイアグラム自体の設計の妥当性」 を担保しなければ、どれだけ精緻な変数選択をしようとも、意味のある分析結果になり得ません。
したがって、まずは現実の構造を理解した上で、因果ダイアグラムを設計する事が実務上必要な作業になっていきます。その上で、本記事のように、バックドア基準を用いて変数選択を行う事が有効であると言えるでしょう。
参考資料