
Jevをエージェントの判断に使ってみた
1. はじめに
こちらの記事で試したエージェントライクなRAGにおいて、Jevを試してみました。
結論としては、下記でした。
- 精度は落ちない
- コストは下がる:LLMへの入力トークンが14%減りました
2. Jevとは
Jevは、TypeSafe AIが提供する入力に対する判断を返すモデルです。
現状、Jevに関してはAPI経由でのみの提供になります(ローカルで動くJeffなどもあるようですが、今回は割愛します。)。
具体的には、以下のような質問をAPIに投げます。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
  {
    "state": "納品物にxxという不具合があります。大至急対応してください。",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "この質問は緊急性が高い?"
      }
    }
  }
EOF
レスポンスは、下記のようになります。
{
    "model": "jev-1.13.0",
    "answers" : {
        "urgency" : {
            "type":"noul",
            "noul":0.93
            }
        },
    "usage":{
        "input_tokens":308,
        "output_tokens":21
    }
}
簡単に言うと、回答候補がある質問に対して、現状がどの候補にマッチするかを返すような動きをします。
これを応用することで、「質問に対して、どのツールを使うべきか」や「現在の検索内容で十分か」といった判定を行うことが出来ます。
今回の例では、noulを使用しましたが、APIは下記の3パターンのリクエストを受け付けます
| 型 | 何を聞くか | どのような出力か |
|---|---|---|
| choice | 順序のない選択肢から1つ選ぶ | 選ばれた選択肢と、各選択肢の確率 |
| score | 順序のある段階のどこに当たるか | 段階の期待値(例: 3段階なら 0〜2 の小数)と、各段階の確率 |
| noul | yes / no で答える質問 | yes である確率(0〜1)のみ |
3. 簡単なテスト
色々と簡単なテストを実施してみたので結果を紹介します。
こちらは、実際のシステムで使用はしませんでしたが、一応試してみたという形です。
3.1 日本語で「検索するか/しないか」を振り分ける
エージェント的RAGの入口にある「検索する(search)/しない(direct)」の分岐を、日本語のまま判定させてみました。
direct の成功例
入力:
{
    "state": "1024 × 768 はいくつになりますか?",
    "questions": {
      "skill": {
        "type": "choice",
        "instructions": "この質問に答えるとき、どちらのスキルを使うべきですか?",
        "criteria": {
          "search": "技術記事のコーパスを検索してから答えるべき質問",
          "direct": "検索せずにそのまま答えてよい発話(挨拶・会話メタ・意見・計算など)"
        }
      }
    }
}
出力:
{
    "model": "jev-1.13.0",
    "answers": {
      "skill": {
        "type": "choice",
        "choice": "direct",
        "confidence": 0.98,
        "probabilities": {
          "direct": 0.99,
          "search": 0.01
        }
      }
    },
    "inputTokens": 404,
    "outputTokens": 31,
    "latencyMs": 237,
    "costUsd": 0.000016968
}
search の成功例
入力(questions は上と同じ):
{
    "state": "max-model-len ってどれくらいにしておけばいいんだっけ?",
    "questions": { "skill": { … } }
}
出力:
{
    "model": "jev-1.13.0",
    "answers": {
      "skill": {
        "type": "choice",
        "choice": "search",
        "confidence": 0.47,
        "probabilities": {
          "search": 0.74,
          "direct": 0.26
        }
      }
    },
    "inputTokens": 408,
    "outputTokens": 31,
    "latencyMs": 161,
    "costUsd": 0.000017136
}
search の失敗例
入力(questions は上と同じ):
{
    "state": "Slurm でジョブを投入するコマンドを教えてください",
    "questions": { "skill": { … } }
}
出力:
{
    "model": "jev-1.13.0",
    "answers": {
      "skill": {
        "type": "choice",
        "choice": "direct",
        "confidence": 0.25,
        "probabilities": {
          "direct": 0.63,
          "search": 0.37
        }
      }
    },
    "inputTokens": 407,
    "outputTokens": 31,
    "latencyMs": 183,
    "costUsd": 0.000017094
}
direct の失敗例
今回試した範囲では、direct が期待の質問(挨拶・計算・意見)はすべて正しく判定され、失敗例はありませんでした。
direct 側は confidence 0.9 以上で安定している一方、search 側は正解・不正解とも confidence が 0.5 を下回っていました。ラベルだけでなく確率を閾値に使うのがよさそうです。
3.2 「この根拠で答えられるか」を確率で聞く
エージェントのループで一番重要な「集めた根拠で答えられるか」を聞いてみました。2記事にまたがる質問に対して、LLaVA-Med 側の根拠だけが欠けた状態を渡しています。
入力:
{
    "state": "質問: LLaVAはLLMの学習段階のうち何を画像に対して実施しており、LLaVA-Medは医療画像を用いてどのような2段階の学習を行うことで医療画像チャットモデルを構築していますか?\n\n集まった根拠(5件):\n[1] 【Vision Language Model】LLaVAの論文を読んでみた > …(省略)",
    "questions": {
      "sufficient": {
        "type": "noul",
        "instructions": "集まった根拠だけで、質問のすべての要素に答えられますか?関連しているだけで、問われている値や手順そのものが書かれていない場合は「いいえ」です。"
      },
      "coverage": {
        "type": "score",
        "instructions": "質問の要素のうち、根拠でカバーされている割合はどの程度ですか?",
        "criteria": [
          "まったくカバーしていない",
          "一部だけカバーしている",
          "すべてカバーしている"
        ]
      }
    }
}
出力:
{
    "model": "jev-1.13.0",
    "answers": {
      "sufficient": {
        "type": "noul",
        "noul": 0.08
      },
      "coverage": {
        "type": "score",
        "score": 1,
        "confidence": 0.98,
        "probabilities": {
          "0": 0.01,
          "1": 0.98,
          "2": 0.01
        },
        "legend": {
          "0": "まったくカバーしていない",
          "1": "一部だけカバーしている",
          "2": "すべてカバーしている"
        }
      }
    },
    "inputTokens": 2446,
    "outputTokens": 36,
    "latencyMs": 207,
    "costUsd": 0.000102732
}
ちなみに、根拠が十分な場合は sufficient 0.84 / coverage 1.98、無関係な場合は 0.02 / 0.01 でした。3つの状態がきれいに分かれています。
3.3 同じ入力を3回投げる
判定が割れやすい上記の「片方欠け」を、Jev と LLM(本番パイプラインの判定処理)に3回ずつ投げました。LLM の出力は以下です。
{
    "sufficient": false,
    "missing": "LLaVAについては、画像に対して「指示チューニング」を実施することが根拠にあります。一方、LLaVA-Medについて、医療画像を用いた具体的な2段階(各段階の目的・データ・学習内容)と、それによって医療画像チャットモデルを構築する過程を示す根拠がありません。",
    "latencyMs": 5452,
    "inputTokens": 2330,
    "outputTokens": 290
}
どちらも3回とも「不十分」で、Jev の確率の揺れは ±0.01 でした。ただし latency は Jev が約0.2秒、LLM が3.6〜5.5秒です。一方で、LLM は「何が足りないか」まで返してくれます。
4. エージェントの判断に使ってみる
今回は、下記のように「検索が十分か?」という判定にJevを使用しました。
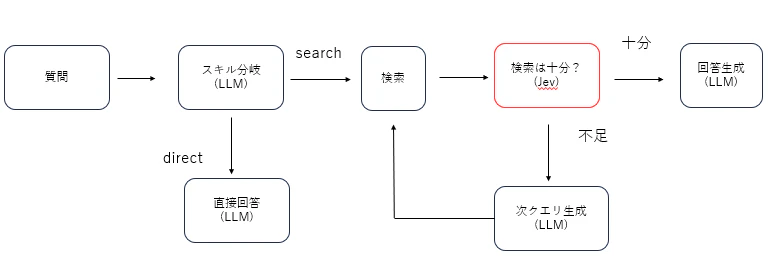
エージェントは「検索 → 根拠を集める → 十分か判定」を繰り返し、十分と判定されたら回答を生成します。この「十分か」の判定だけを、LLM から Jev に置き換えました。
4.1 判定は Jev、文章は LLM
Jev は文章を出せません。一方、元の判定処理では、不足と判定したときに「何が足りないか」と「次の検索クエリ」を LLM に書かせ、次の検索に使っていました。
そこで、役割を次のように分けました。
- 十分かどうか: Jev の noul で「根拠だけで質問に答えられる確率」を出し、0.5 以上なら収集を終える
- 何が足りないか: 不足と判定されたときだけ LLM を呼んで書かせる
const jev = await judgeEvidenceJev(question, docs);
if (jev.pSufficient >= 0.5) {
  // 十分: LLM は呼ばない
  return { sufficient: true };
}
// 不足: 何が足りないか・次の検索クエリだけ LLM に書かせる
const hint = await checkEvidenceLlm(question, docs, triedQueries);
return { ...hint, sufficient: false };
十分と判定された回は、LLM の判定呼び出しが丸ごと無くなります。
4.2 まずはオフラインで比べる
いきなりエージェントに組み込む前に、判定だけを取り出して比べました。エージェントは回さず、検索結果から「その時点で集まっている根拠」のスナップショットを184件作り、LLM と Jev に同じものを判定させています。
| スナップショット | 作り方 | 件数(うち十分) |
|---|---|---|
| natural_k5 | 検索上位5件 | 46(34) |
| natural_k2 | 検索上位2件 | 46(23) |
| forced_full | 正解の根拠を必ず含めた5件 | 46(46) |
| drop_one | 正解の根拠を1件抜き、その記事ごと除外して検索し直した5件 | 46(0) |
正解ラベルは「正解の根拠(チャンク)がすべて含まれているか」です。
結果は以下の通りです。見逃しは「足りないのに十分と判定した」、空振りは「十分なのに足りないと判定した」件数です。
| 判定器 | 正解率 | 見逃し | 空振り |
|---|---|---|---|
| LLM(1回目) | 86% | 12 | 13 |
| LLM(2回目) | 88% | 10 | 13 |
| Jev(閾値 0.5) | 87% | 5 | 19 |
| Jev(閾値 0.4) | 89% | 10 | 10 |
| Jev(閾値 0.7) | 83% | 2 | 29 |
閾値 0.5 では、正解率は LLM と同じくらいで、見逃しは約半分になりました。その代わり空振りが増えています。見逃すと根拠が足りないまま回答してしまい、空振りは検索が1回増えるだけなので、エージェントの判定としては見逃しが少ないほうが望ましいです。
LLM は true / false しか返さないので、しきい値による制御ができません。Jev は閾値を動かすことで、見逃しと空振りのどちらを優先するかを選べます。
また、Jev の確率はほぼそのまま信頼度として読めました。
| Jev の 出力確率 | 件数 | 実際に十分だった割合 |
|---|---|---|
| 0.0〜0.2 | 52 | 4% |
| 0.2〜0.4 | 29 | 28% |
| 0.4〜0.6 | 22 | 73% |
| 0.6〜0.8 | 16 | 88% |
| 0.8〜1.0 | 65 | 97% |
LLM と Jev で判定が分かれた17件は、Jev の確率がすべて 0.21〜0.54 の範囲でした。Jev が間違えるのは、迷っているとき(確率が中間のとき)だけでした。
スナップショットの種類ごとに見ると、得意・不得意がはっきり分かれました。
| 種類 | LLM | Jev |
|---|---|---|
| drop_one(話題は合っているのに、肝心の記述が無い) | 87% / 89% | 96% |
| forced_full(全部揃っている) | 83% / 80% | 74% |
LLM は「だいたい関連しているから十分」と判定しがちで、Jev はその逆に「揃っていても慎重」な傾向がありました。
4.3 エージェントに組み込んだ結果
収集完了の判定だけを Jev に差し替え、multihop の質問26問で LLM 判定版と比べました。生成モデル・プロンプト・検索は同じです。
| 判定器 | 完全ヒット | 部分recall | LLM呼び出し(1問平均) | 入力トークン(1問平均) | レイテンシ(平均 / 中央値) |
|---|---|---|---|---|---|
| LLM | 16/26(62%) | 73.1% | 12.8 | 60,394 | 36.9s / 23.3s |
| Jev | 17/26(65%) | 80.8% | 11.7 | 51,874(−14%) | 34.9s / 31.8s |
※完全ヒット: 必要な根拠をすべて集められた問題の数。部分recall: 必要な根拠のうち集められた割合。
精度は落ちず、入力トークンは14%減りました。
一方で、エージェント全体は速くなっていません。判定1回あたりは LLM 約3.2秒に対して Jev 約0.2秒ですが、1問あたり約12回ある LLM 呼び出しのうち、判定は1〜2回しかないためです。中央値が伸びたのは、3ターン以下で打ち切る問題が12問から10問に減ったことによります。
4.4 問題ごとの傾向
Jev 版で改善した例
- 「houtini/lm で Claude Code からローカル LLM へ委譲する方法が、ドキュメント生成に向いているのはなぜか」: LLM 版は3ターンで「十分」と判定して止まり、2記事のうち片方しか取れていませんでした。オフライン比較でも LLM の判定が割れていた問題です。
- 「CIFAR-10 の Optimizer 実験と vLLM × Qwen3 × cline の生成コード」: LLM 版は12ターン回しても片方が取れず、Jev 版は10ターンで両方を集めました。
Jev 版で劣化した例
- 「curl で呼び出した Qwen3-8B-FP8 のレスポンスから
<think>を除外する」: Jev 版は2ターンで「十分」と判定して止まりました
早めに検索を打ち切った
- 「Vite の React 開発環境と、vLLM サーバー・Jupyter Notebook の Docker 構成」: LLM 版は15ターン・27回の LLM 呼び出しを使って、正解の根拠を1件も取れませんでした。Jev 版は5ターン・7回で、半分を取れています。
この最後の例は、判定器ではなく検索側の限界です。「足りない」と正しく判定できても、検索がそこに辿り着けなければループは続いてしまいます。トークン削減のかなりの部分は、この早めに検索を打ち切ったことから来ています。
4.5 注意点
26問を各1回しか回していません。完全ヒットの1問差はノイズの範囲で、「Jev のほうが精度が高い」とまでは言えません。言えるのは「替えても精度は落ちず、トークンは減る」までです
5. まとめ
Jevを使用してエージェントの検索をするかの判断を実施してみました。
結論としては、LLMを使用した分岐と同程度の性能となりました。
6. 感想
- Jevは推論速度が速いのでエージェントの分岐や意思決定に使えそうだと感じました
- 一方で、判断基準などが出力されないので、そこが必要なケースでは工夫がいると考えています