
この記事の要点(3行)
- Kanzaki は、Markdownで書いたルールに従ってAIが成果物をレビューするCLI
- テキストなら何でもOK。エンジニアじゃなくても簡単に使えます
- 目的は「AIが書いたものを、別のAIが第三者視点で評価する自己修正ループ」
Kanzakiとは
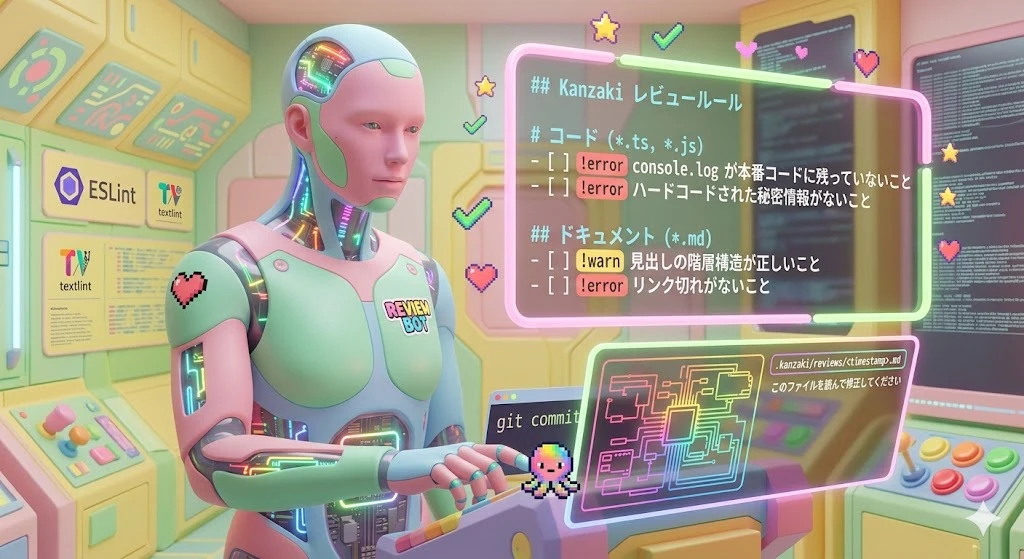
Kanzakiでは、ルールを記載するマークダウンファイルに以下のようにルールを書くだけ
## コード (*.ts, *.js)
- [ ] !error console.log が本番コードに残っていないこと
- [ ] !error 公開APIの型を変えたら docs/api.md が同じPRで更新されていること

## ドキュメント (*.md)
- [ ] !error リンク切れがないこと
- [ ] !warn 用語が文書全体で統一されていること
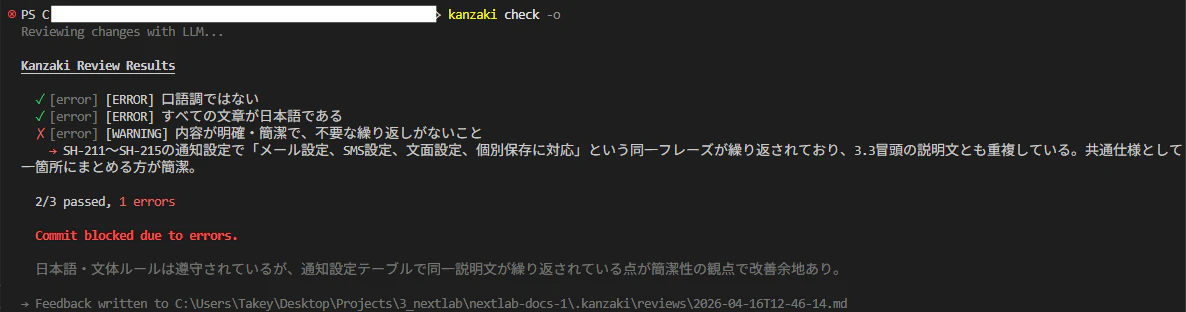
git add してから kanzaki check を叩くと、LLMが差分とルールを照合して違反を指摘します。pre-commit hookに仕込めば、違反があるうちはコミットできません。
それだけ。でも、これだけで既存のlinterでは拾えなかった「意味レベルの問題」が拾えるようになります。
具体的には、以下のようなチェックができます。
なぜ、このようなツールを作ろうと思ったのか
AIエージェントが書いたものを、同じセッション内で自己修正させるレイヤーが空いていたから。
| ツール | 得意 | 苦手 |
|---|---|---|
| ESLint / textlint | 構文レベルの機械チェック | 「意味が通ってるか」「ファイル間の整合性」は見えない |
| CodeRabbit / Greptile | PR時の人間レビュワー支援 | PR作成後に動く=エージェントのセッションはもう終わってる |
| Claude Codeのhook / skill | 自分の作業フロー整備 | "自分の延長"なので第三者視点が出せない |
Kanzakiはこの真ん中のレイヤー(コミット前に独立プロセスでレビュー)を埋めます。
Kanzakiが目指すこと:エージェントの自己修正ループ
結論: kanzaki check をパスすることが、エージェントのタスク完了条件(DoD)そのものになる。
流れはこうです。
1. エージェントが変更を加える
2. コミットしようとする
3. Kanzakiがブロック + フィードバックをMarkdownで出力(.kanzaki/reviews/)
4. エージェントは同じセッション内でそのMarkdownを読む
5. 自分で修正して再試行
6. 通るまで繰り返す
PRレビューAIだと、ここで人間が間に入る必要がある。コメントを読んで、要約して、エージェントに再プロンプトを投げ直す。Kanzakiはその手間をゼロにします。
これが単なる便利ツールじゃなくて、「エージェント時代のlinter」として設計した最大のポイントです。
なぜ"独立プロセス"であることが重要か
「hookやskillで似たことできないの?」と思うかもしれません。
結論: 自分で自分をレビューすると、自己正当化が入る。第三者視点は別プロセスでないと作れない。
セルフレビューの落とし穴
エージェントに自分の成果物をレビューさせると、こうなりがちです。
- 思考過程を引きずる — 「なぜこう書いたか」の推論が残ってるので、違反を「意図的」と正当化しがち
- 会話の空気を読む — ユーザーとのやり取り(「とりあえず動かしたい」など)に引っ張られ、ルール適用がブレる
- 盲点の再生産 — 書くときに見落としたものは、同じ文脈で見直しても見落としやすい
人間のセルフレビューと同じ構造ですね。
Kanzakiに渡す情報はこれだけ
- ルール(
.kanzaki/rules.md) - 差分とファイルの内容
- それだけ
会話履歴も、エージェントの思考過程も、一切渡されません。まっさらな第三者が、ルールだけを物差しに審判するモデルです。
「自前でhook書けば同じでは?」
その通りで、Kanzakiは要するに"理想的に書かれたhook"をパッケージ化したものです。
- Markdownルールのパーサ
- severity (
!error/!warn) と scope (@diff/@state) の処理 - OpenAI / Anthropic / ChatGPT / Claude CLI の切り替え
- フィードバックファイル出力
- ルールファイルの書式検証
これを毎回自分で書かずに、.kanzaki/rules.md を編集するだけで済む、という設計です。
誰が使える? 3つの具体例
① エンジニア:linterが拾えない"意味"を拾う
linterは単一ファイルの構文しか見ません。Kanzakiは複数ファイルにまたがる意味的整合性を判定できます。
## API とドキュメントの整合
- [ ] !error 公開APIの型を変えたら docs/api.md が同じPRで更新されていること
- [ ] !warn 新しい環境変数を追加したら .env.example にも追加されていること

## PII 取り扱い (*.ts, *.tsx)
- [ ] !error ログに email・phone・address を素のまま渡さないこと(maskPii() を経由する)
「型を変えたらドキュメントも更新」のようなファイル間の同期、「素のまま渡さない」のようなパターンマッチ困難な規約。これらはLLMが得意な領域です。
② 非エンジニア:リサーチ・論文の"意味チェック"
調査レポートや論文のレビューで一番労力がかかるのは、「主張と根拠の対応」「論理展開の妥当性」「用語の一貫性」。これ、textlintでは絶対に判定できません。
# リサーチレビュールール

再生可能エネルギーに関する調査レポート。
データに基づいた客観的な分析が求められる。

## 正確性
- [ ] !error 統計データには出典が明記されていること
- [ ] !error 事実誤認や誤解を招く主張がないこと

## 文体
- [ ] !warn 用語が文書全体で統一されていること(表記揺れを避ける)
こんな人たち向け: 調査会社のアナリスト / 研究室の院生・ポスドク / マーケティングリサーチャー / 政策提言を書く人
AIにドラフトを書かせる → Kanzakiで品質チェック → 修正 → 再チェック のループが、コード開発と同じように回せます。
③ プレゼン・レポートの"欠落検出"
経営陣向け決算、投資家向けピッチ、社内稟議。品質は「主張→根拠→結論の整合」と「欠落」で決まります。
## 内容
- [ ] !error すべてのグラフ・チャートにデータソースが記載されていること
- [ ] !error 前四半期との比較データが含まれていること
- [ ] !warn 結論がデータに基づいていること
スペルチェッカーは「ここにソースがない」「前四半期比較が欠けている」といった欠落を検出できません。Kanzakiは本文を通読するので「何がないか」を判定できます。
技術的な仕様(エンジニア向け)
使うだけなら読み飛ばしてOKです。
判定スコープ:@diff と @state
- [ ] !error @state console.log が残っていないこと
- [ ] !warn @state(docs/glossary.md) 用語が glossary と一致していること
-
@diff(デフォルト): この変更が新たに違反を持ち込んでいないか。既存違反はスルー -
@state: ファイルの現状を判定。既存違反も違反として扱う -
@state(<glob>): 変更されていない参照ファイルも追加コンテキストに含める
@diff はpre-commitで既存負債に毎回詰まらない用途、@state は静的解析的な用途に向きます。
認証方式
kanzaki login --provider openai        # OpenAIのAPIキー
kanzaki login --provider anthropic     # AnthropicのAPIキー
kanzaki login --use-chatgpt            # ChatGPT Plus/ProのOAuth
kanzaki login --use-claude             # ローカルのClaude Code CLIをサブプロセス利用
個人的な推しは --use-claude。Claude Codeを既に使っている人なら、APIキーの管理も追加利用料も増えません。
フォーマット検証
ルールファイルに書式エラー(閉じ括弧忘れ、空ルール、重複、不正なseverityタグなど)があると、LLMを呼ぶ前に検出して exit(1)。無駄なAPIコールを防ぎます。
フィードバック出力(エージェント連携)
kanzaki check --emit-feedback(または -o)で、違反内容を .kanzaki/reviews/<タイムスタンプ>.md に構造化Markdownで出力。Claude CodeやCursorに「このファイルを読んで修正して」と渡すだけで、エージェントが自律的に直してくれます。
長期的に目指しているところ
結論: エージェントアウトプット品質保障インフラを目指しています。
エージェントが数時間〜数日、タスクを自律実行する時代が近づいています。その時、アウトプットの品質を人間がリアルタイム監視するのは不可能。必要なのは、エージェントが自分のアウトプットを自分でチェックして、自分で直す仕組み。Kanzakiはそこを埋めにいきます。
将来的な方向性:
- ルールの自己改善 — 何度も指摘されるパターンのルール化、FPの多いルールの refine
- 判定の安定性向上 — 長時間ループで結果が揺れないような構造化出力の工夫
- コスト最適化 — ローカルモデル対応、差分サブセット判定、キャッシュ戦略
「linter」というよりは、エージェントアウトプット品質保障インフラと呼んだほうが実態に近くなっていくかもしれません。
使ってみよう
インストールはnpmから一発です。
npm install -g kanzaki
Node.js 20.6以上が必要です。
cd your-project
npx kanzaki init                  # .kanzaki/rules.md のテンプレを作成
kanzaki login --provider openai   # or --use-claude
kanzaki check                     # ステージ済みの変更をレビュー
pre-commitフックに組み込む場合:
npm install --save-dev husky
npx husky init
echo "npx kanzaki check" > .husky/pre-commit
あとは .kanzaki/rules.md をプロジェクトに合わせて自由に編集するだけ。Markdownが書ければ、誰でもルールを作れます。
おわりに:誰でも自由に使ってください
Kanzakiは、「AIエージェント時代に必要だけど、まだ誰も作っていないレイヤー」を狙って作ってみたツールです。
- エンジニア の方には、コード以外にも使える"意味レベル"のlinterとして
- 非エンジニア の方には、ドキュメント・レポート・プレゼンの品質をAIにチェックしてもらえるツールとして
- エージェント運用者 の方には、アウトプット品質を担保する自己修正ループのインフラとして
誰でも自由に使ってください。 OSS(MIT License)なので、フォークしてカスタマイズするのも、業務で使うのも、遊びで触るのも、全部大歓迎です。ルール例の共有やユースケースの報告も、どんどんお待ちしてます。
免責的なお知らせ
まだ出来立てのツールなので、アップデートで壊れたり、予期せぬ挙動をすることがあるかもしれません。その時はごめんなさい! バージョンを固定して使うか、気になる挙動があればIssueを立てていただけると助かります。
LLMの判定も100%正確ではないので、!error と !warn をうまく使い分けて、「ブロックしたい違反」と「気づきだけ欲しい違反」を運用で切り分けるのがおすすめです。
リンク
- GitHub: https://github.com/tkysi-mi/kanzaki
-
npm:
kanzaki - ドキュメント: リポジトリの README.md をどうぞ
「AIに書かせたものを、AIに審判させる」── そんな時代の最初の一歩として、気軽に触ってみてもらえたら嬉しいです。
フィードバックは Issue / PR / コメント欄まで、お気軽にどうぞ。