

はじめに
AI AgentにToolを接続すると、外部システムの状態確認だけでなく、サーバの再起動のような操作まで行えるようになります。
ただ、こうしたAgentを実際に運用するとしたら、どう管理すればよいのでしょうか。
例えば、Agentがサーバを再起動して正常に復旧できたとしても、それだけでは分からないことがあります。
「何を確認して再起動を判断したのか」「危険な操作に承認は必要だったのか」「復旧できたことをどう評価するのか」。
こうした実行過程や結果を後から確認できなければ、安心して運用するのは難しそうです。
そこで今回は、Langfuse・OpenTelemetry・Prometheusを組み合わせて、AI Agentの実行をどこまで観測・監視・評価できるのかを試してみました。
この記事では、構築手順よりも、実際に動かして確認できたことや、検証を通じて見えてきた課題を中心に紹介します。
なお、今回の検証には、自作したAI Agent「SimpleAgent」を使用しました。疑似サーバの状態を調査し、必要に応じて人間の承認を得たうえで再起動する仕組みとなっています。
まず結論
この記事は、完成したAgent運用基盤の紹介ではありません。
個人の検証環境でLangfuse・OpenTelemetry・Prometheusを組み合わせ、AI Agentの実行をどこまで観測・監視・評価できるかを確かめた技術検証(PoC)の記録です。
今回のPoCでは、サーバ状態の調査から承認、疑似的な再起動、復旧確認、Evaluationまでの一連の処理を実行しました。
そのうえで、次の5つの観点から、Agentの実行内容をどこまで確認できるか検証しています。
| 観点 | 今回確認できたこと |
|---|---|
| Observe(観測) | LLMやToolの呼び出し、実行経路をLangfuseのTraceで追跡できた |
| Control(制御) | Agent側のPolicy Gateで承認を要求し、Human Approval後に操作を実行できた |
| Audit(監査) | 操作対象、承認結果、実行時のMetadataを同じTraceで確認できた |
| Operate(監視) | Agentの実行情報をMetricsとして取得し、Prometheusの監視ルールが正常に評価されることを確認できた |
| Evaluate(評価) | Task SuccessとGroundednessを評価し、Langfuseの同じTraceにScoreを記録できた |
特に確認したかったのは、Agentの最終回答だけでなく、そこに至る実行過程や承認情報、Taskの達成状況まで追えるかという点です。
一方、今回の検証は1つのAgentと疑似インフラを対象としたPoCです。実際の本番サーバを操作したわけではなく、承認拒否などの異常系や長期間の運用監視までは検証していません。
このあたりも今後検証を進め、別の記事で紹介したいと考えています。
1. 何を試したのか ― 検証環境とシナリオ
まずは、今回使用した検証環境と、Agentに実行させたシナリオを紹介します。
検証環境
環境は1台のWindows PC上に、PythonプロセスとDockerコンテナを組み合わせて構築しています。
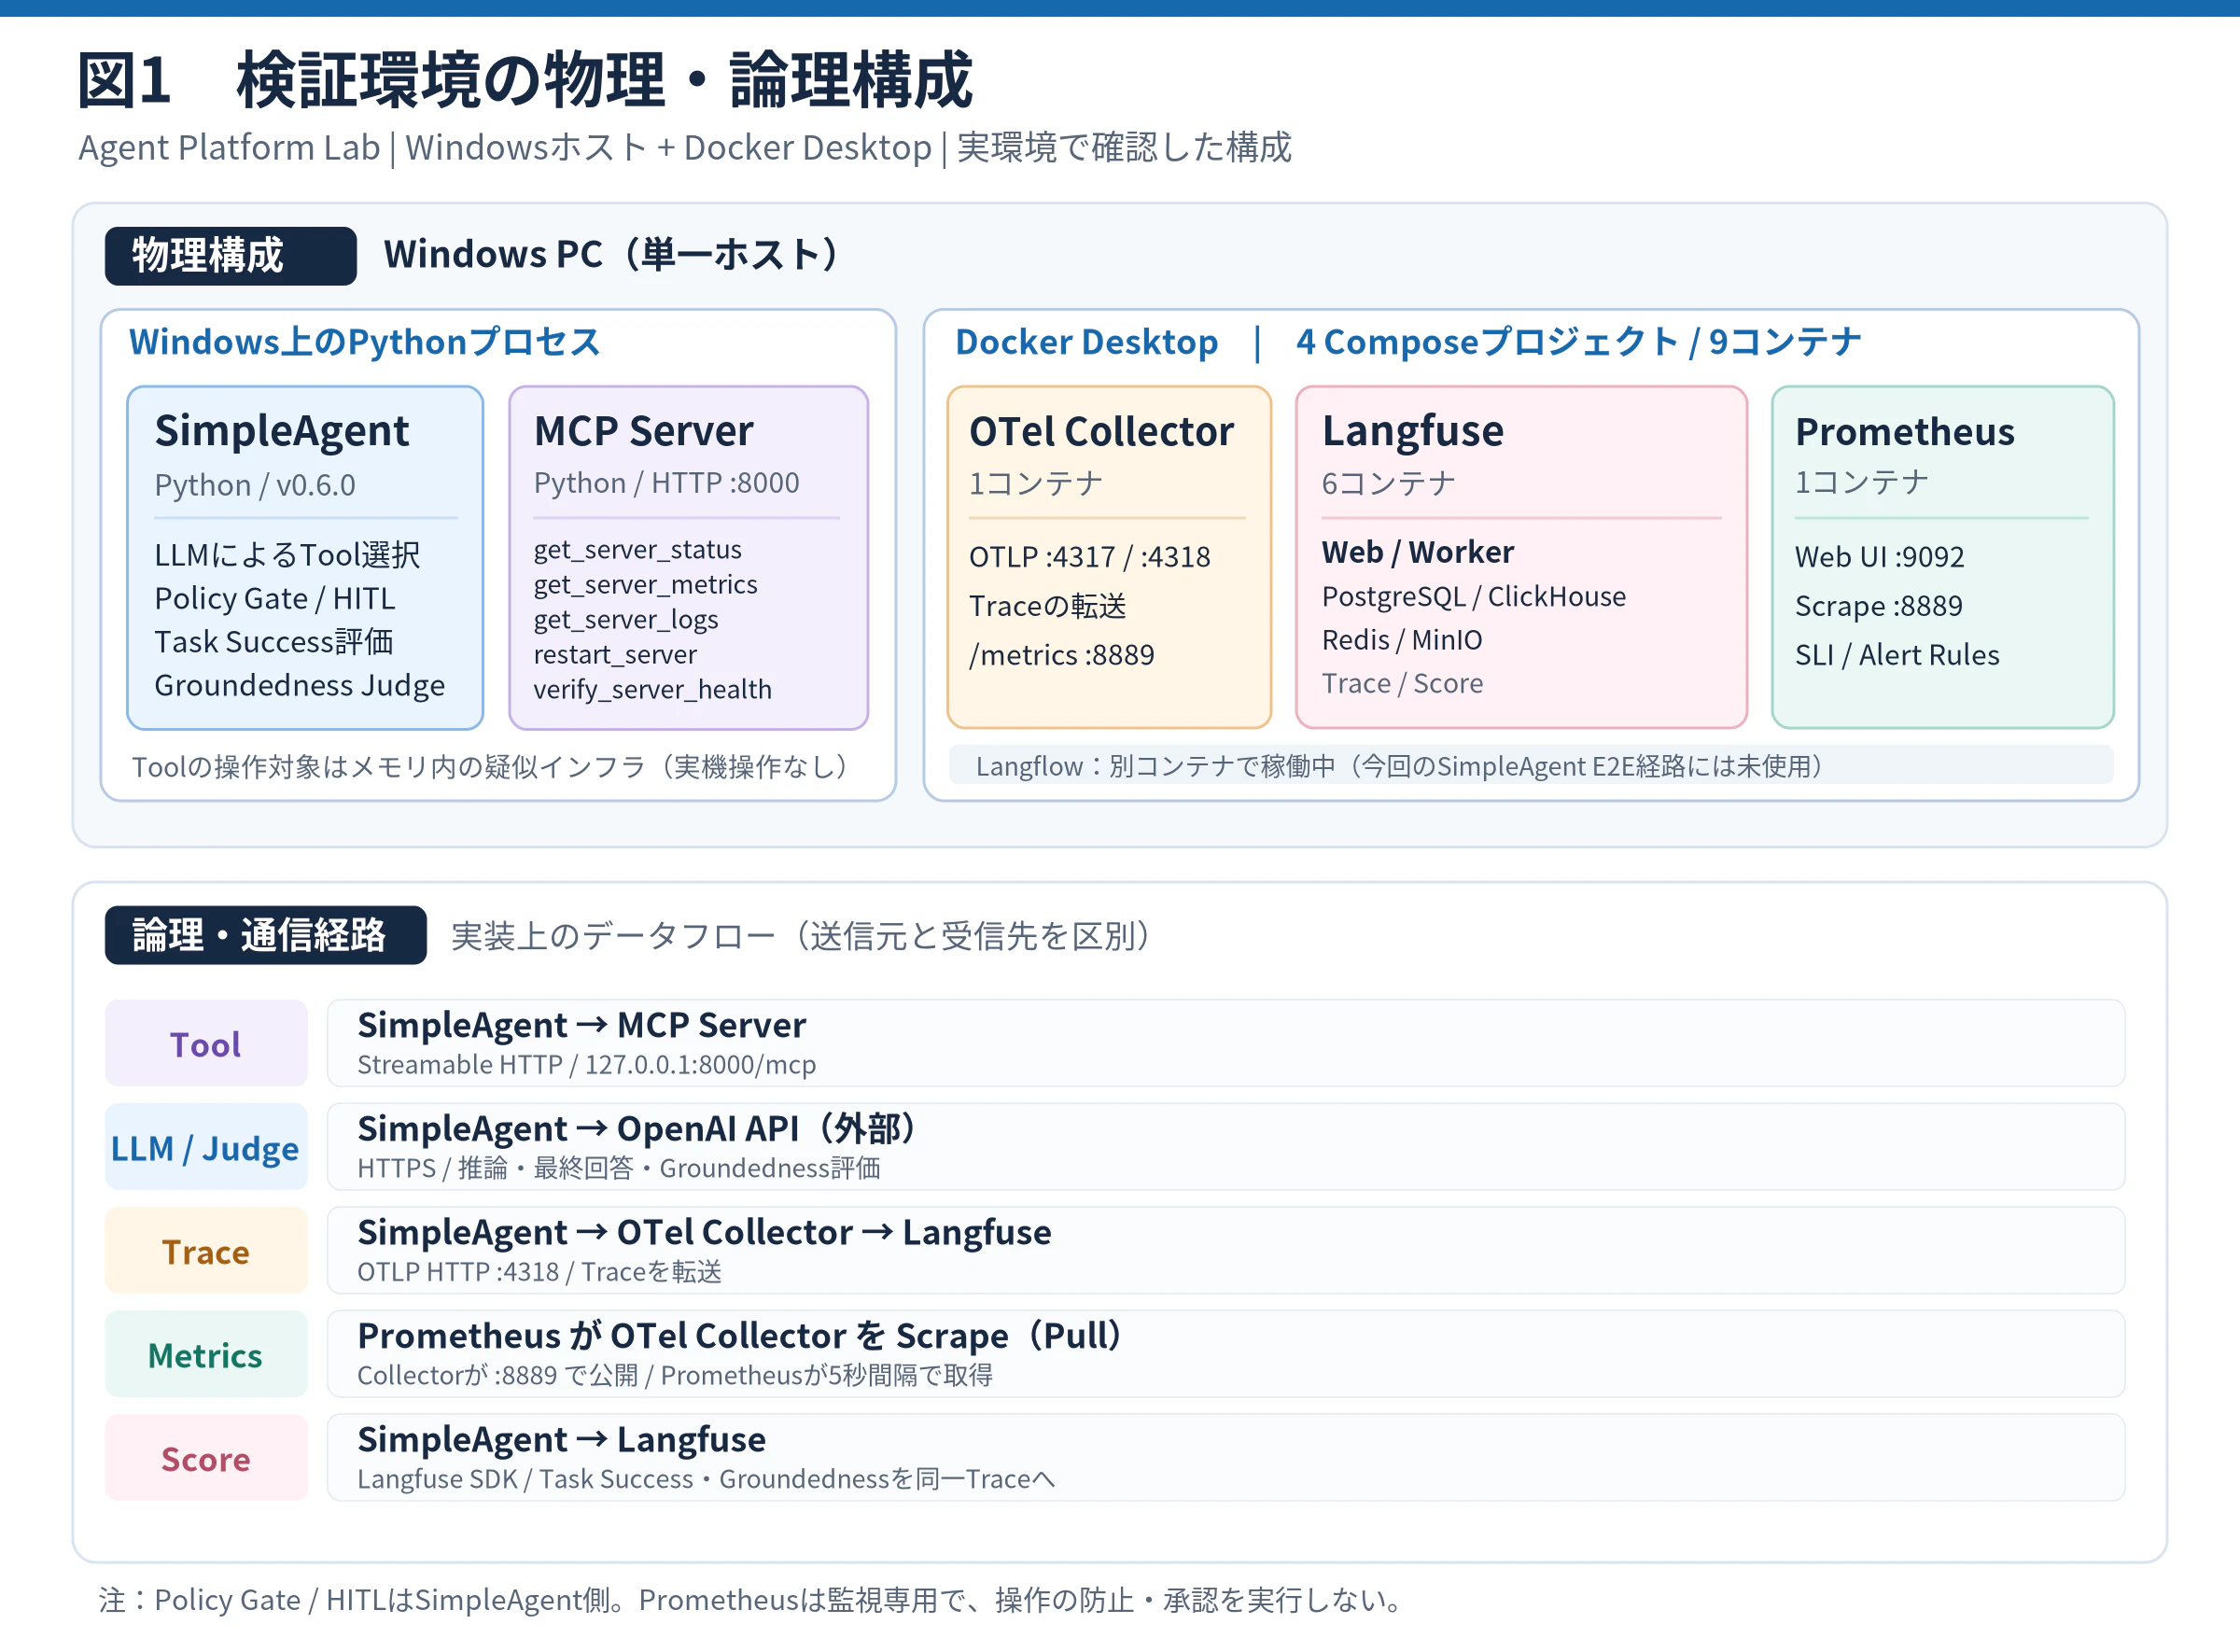
図1:検証環境の物理構成・論理構成
構成は大きく次のように分けています。
| コンポーネント | 今回の役割 |
|---|---|
| SimpleAgent | LLMによる判断、Policy Gate、Human Approval、Evaluationを実行する検証用Agent |
| MCP Server | サーバ状態取得や再起動などのToolを提供 |
| OpenTelemetry Collector | Traceの受信・属性の正規化・転送と、Span Metricsの生成 |
| Langfuse | Agentの実行TraceやEvaluation Scoreの確認 |
| Prometheus | Agent実行メトリクスの収集・監視 |
SimpleAgentとMCP ServerはWindows上のPythonプロセスとして実行しています。両者はStreamable HTTP(127.0.0.1:8000/mcp)で通信します。
Docker Desktop上では、OTel Collector、Langfuse、Prometheus、LangflowをDocker Composeで管理しています。
構成は4つのComposeプロジェクト・計9コンテナで、LangfuseはWeb・Worker・PostgreSQL・ClickHouse・Redis・MinIOの6コンテナ構成です。
なお、Langflowは同じ検証環境で起動していますが、今回のSimpleAgentの実行処理には使用していません。
また、LLMによる判断とGroundednessの評価には、外部のOpenAI APIを利用しています。
今回のデータの流れには、主に3つの経路があります。
- Trace:SimpleAgentからOTLP HTTP(4318)でCollectorへ送り、Langfuseに転送する
- Metrics:Collectorが生成したSpan Metricsを8889番ポートで公開し、PrometheusがScrapeする
- Evaluation Score:SimpleAgentで評価を実行し、Langfuse SDKから対象Traceに記録する
TraceとEvaluation Scoreは、どちらもLangfuseで確認できますが、記録経路は異なります。
検証シナリオ
今回使用するのは、WEB-SRV-01 という疑似本番サーバです。
Agentには、次のような依頼を与えました。
WEB-SRV-01の状態・メトリクス・ログを調査し、必要であれば再起動する。再起動する場合は人間の承認を受け、操作後に正常性を確認して結果を報告する。
MCP Serverには、以下の5つのToolを実装しています。
get_server_status
get_server_metrics
get_server_logs
restart_server
verify_server_health
このうちLLMが直接選択できるのは上から4つです。verify_server_health は、再起動後にSimpleAgent側から呼び出す復旧確認用Toolとしています。
サーバの初期状態には、意図的に高負荷やエラーを設定しました。
| 項目 | 初期状態 | 再起動後 |
|---|---|---|
| CPU使用率 | 96% | 38% |
| HTTP 5xx率 | 12.3% | 0.4% |
| レイテンシ | 3800ms | 220ms |
| サーバ状態 | warning | healthy |
今回のサーバ状態や再起動処理は、MCP Serverのメモリ上で再現したものです。実際の本番サーバを操作・計測した結果ではありません。
2. LangfuseでAgentの実行を追ってみる
実際にLangfuseへ記録されたTraceがこちらです。
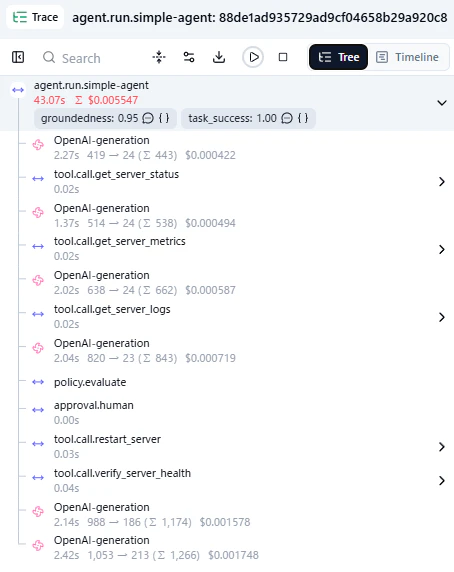
図2:SimpleAgentの実行Trace(Langfuse)
今回のAgentは、1回LLMを呼び出して回答するだけではありません。
まずサーバの状態を取得しMetricsやLogsを確認します。その結果を受けてLLMが次のToolを選択し、再起動が必要と判断した場合は、Policy判定と人間の承認を経て操作を実行します。
Langfuseではこうした一連の処理を1つのTraceにまとめて確認できます。
Trace上で注目したのは以下の項目です。
| Trace上の要素 | 確認できること |
|---|---|
agent.run.simple-agent |
Agentの実行全体 |
OpenAI-generation |
LLM呼び出しと記録された入出力 |
tool.call.* / MCP send tools/call
|
選択・実行されたToolやMCP通信 |
policy.evaluate |
危険な操作に対するPolicy判定 |
approval.human |
人間による承認処理 |
TraceにはTool呼び出しだけでなく、Policy判定と人間の承認処理も記録されていました。承認から再起動までの具体的な流れは、次章で確認します。
また、Toolの実行結果や処理時間も追えるため、問題が発生した際に、どの処理を調べればよいか判断する材料になります。
Traceで確認できるのは、記録されたLLMの入出力やTool実行などの情報であり、LLM内部の推論過程そのものではありません。
それでも、最終回答だけでは分からない実行経路を追えることは、今回の大きな収穫となりました。
3. 危険な操作に承認を入れてみる
Agentがサーバの状態を調査するだけならよいのですが、再起動のような操作まで自律的に実行するとなると、少し話が変わってきます。
特に本番環境を想定した場合、LLMが再起動を必要と判断しても、そのまま実行させるわけにはいきません。
そこで今回は、SimpleAgent側にPolicy GateとHuman Approvalを実装し、承認を経てから再起動する流れと、その証跡をLangfuseで確認できるかを試しました。
Policy Gateで承認を要求する
今回のPolicy Gateでは、以下の条件に該当する操作を承認対象としています。
| 条件 | 値 |
|---|---|
environment |
production |
action |
restart |
human_approved |
false(承認前) |
この場合、Policy Gateは REQUIRE_APPROVAL を返します。
LangfuseのTraceでも、再起動前に次の処理が記録されていました。
policy.evaluate → approval.human → tool.call.restart_server
Policy判定時点では、承認情報は以下の状態です。
| 属性 | 値 |
|---|---|
policy.decision |
REQUIRE_APPROVAL |
approval.required |
true |
approval.approved |
false |
ここで approval.approved = false となっているのは、まだ人間から承認を得ていないためです。
承認した記録は残るのか
続いて、Human Approvalの処理を確認しました。
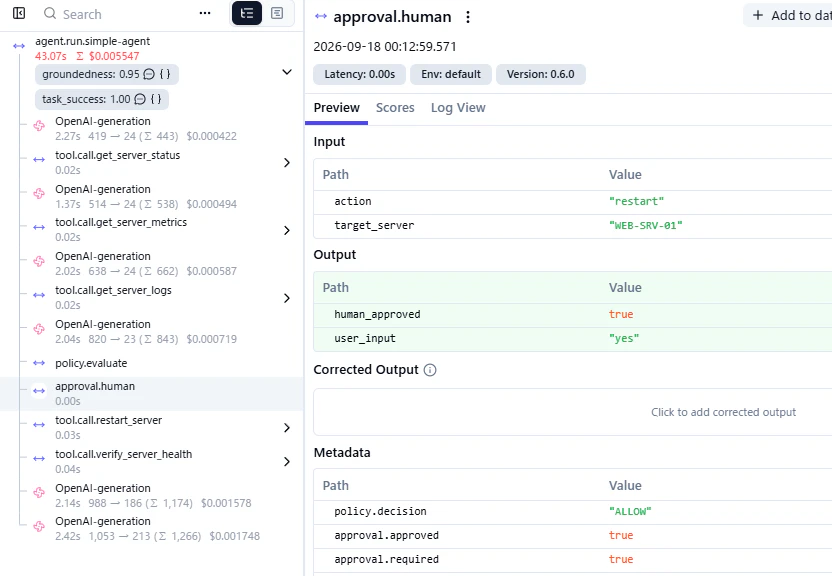
図3:Human Approvalの承認証跡(Langfuse)
今回は端末上で yes を入力し、疑似サーバの再起動を許可しました。Human Approvalは簡易的な実装であり、承認者の本人認証や権限確認までは行っていません。
Langfuseの approval.human には、対象操作(restart)、対象サーバ(WEB-SRV-01)、承認結果(human_approved = true)、入力値(user_input = yes)が記録されました。承認後のMetadataでも、policy.decision = ALLOW、approval.required = true、approval.approved = true を確認できます。
なお、ここでの ALLOW は承認後の実行許可状態を示す記録であり、Policy Gateの再判定結果ではありません。
今回のTraceからは、承認が必要な操作に対して、実際に承認を経て再起動したことを確認できました。
承認後の操作まで追えるか
承認後、SimpleAgentはMCP Serverの restart_server を呼び出します。
その実行情報がこちらです。
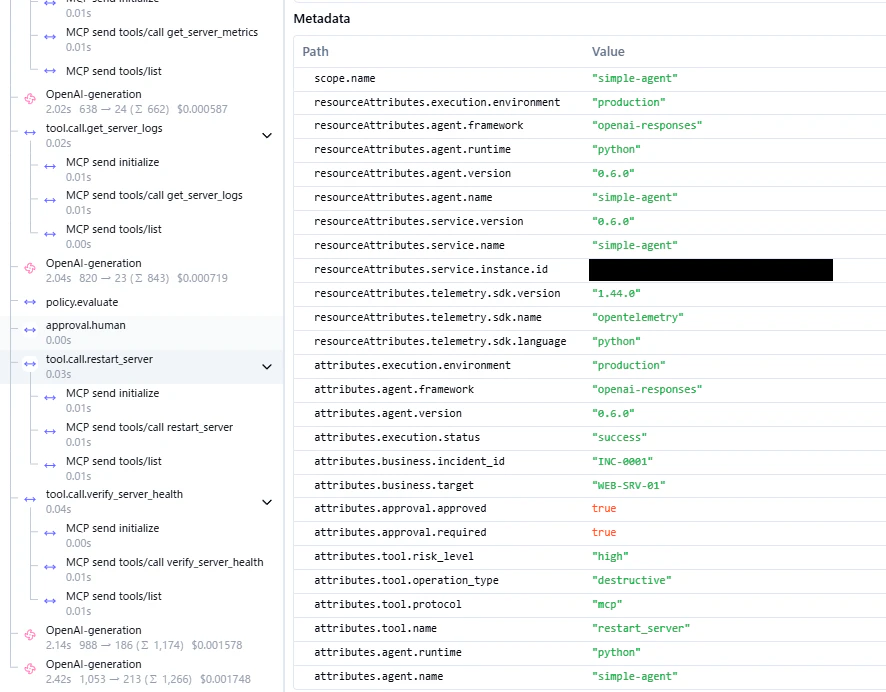
図4:restart_serverの実行情報と承認Metadata(Langfuse)
今回のTool Spanには、以下のようなMetadataを記録しています。
| 属性 | 記録された値 |
|---|---|
tool.name |
restart_server |
tool.protocol |
mcp |
tool.risk_level |
high |
tool.operation_type |
destructive |
execution.environment |
production |
execution.status |
success |
approval.required |
true |
approval.approved |
true |
business.target |
WEB-SRV-01 |
今回の production や destructive は、疑似環境で高リスク操作を想定するために設定した属性です。
このように、どのサーバに対して、どのようなリスクの操作を、承認を経て実行したのかを1つのTraceから追跡できました。
試して分かったこと
今回特に有用だと感じたのは、Toolの実行結果だけでなく、操作のリスクレベルや承認情報も同じTraceに記録できることです。
また、複数Agentでの利用を考えると、Telemetryの属性名を統一することも重要になります。そこで今回は、agent.*、execution.*、tool.*、policy.*、approval.*、business.* などを共通利用するObservability Schemaを定義しました。なお、これらにはPoC独自の属性も含まれており、すべてがOpenTelemetryの公式標準属性というわけではありません。
現時点では、Policy GateとHuman ApprovalはSimpleAgent側の実装です。Langfuseでは一連の実行経路と承認情報を追跡できましたが、承認拒否や承認証跡の欠落といった異常系は今後の検証課題です。
4. PrometheusでAgentの実行状況を監視してみる
Langfuseを使うことで、1回のAgent実行についてはかなり詳しく追えるようになりました。
ただ、実際の運用でAgentの実行回数が増えてくると、すべてのTraceを1件ずつ確認するのは現実的ではありません。
そこで、個々の実行を調べるLangfuseに加えて、Agent全体の実行状況をMetricsとして監視するためにPrometheusを組み合わせてみました。
LangfuseとPrometheusの役割を分ける
今回の構成では、両者の役割を次のように整理しています。
| Langfuse | Prometheus | |
|---|---|---|
| 見る対象 | 個々のAgent実行 | Agent全体の実行傾向 |
| 主な用途 | 実行経路の調査・評価結果の確認 | 成功率・エラー・異常の監視 |
| 扱う情報 | Trace / Observation / Score | Metrics / Recording Rule / Alert |
例えば、特定のAgentがなぜ再起動を実行したのかを確認するならLangfuse、Agent全体の実行失敗が増えていないかを確認するならPrometheus、という使い分けです。
通信経路は第1章の図1に示したとおりです。SimpleAgentのTraceはOTel Collectorを経由してLangfuseへ転送し、CollectorがSpanから生成したMetricsはPrometheusがScrapeします。一方、Task SuccessとGroundednessのScoreは、SimpleAgentからLangfuse SDKを使って対象Traceに直接記録します。
OpenTelemetryを採用したのは、特定のAgentやObservability製品に依存しにくい構成を試したかったためです。
Metricsが実際に取得できるか
今回の検証では、最初にPrometheusを確認した際、agent_platform_* のMetricsが見つかりませんでした。
そこでTelemetryの経路を確認し、SimpleAgentのE2Eテストを再実行しました。
実行直後にPrometheusで last_over_time(agent_platform_calls_total{agent_name="simple-agent"}[30m]) を確認したところ、Agent関連の16系列のデータを取得できました。
agent.run.simple-agent やTool呼び出しなど、Agentの実行情報がMetricsとして取得できていることを確認しています。
ここで分かったのは、監視ルールが正常に読み込まれていることと、実際の実行データが取得できていることは別々に確認する必要があるという点です。
blocked と error は分けて考える
Agentを監視するうえで、特に気になったのが実行状態の扱いです。
通常のアプリケーションと同じように、Agentにも成功率やエラー率は必要です。ただし、AgentにはPolicyによって操作を停止するケースがあります。
今回の設計では、実行状態を running、success、error、blocked に分けています。
例えば、承認が必要な操作をPolicyが正しく停止した場合、それを通常の実行エラーとして数えるのは適切ではありません。
そこで、Agent Execution Success Rateは次のように定義しました。
Agent Execution Success Rate

            success
= ---------------------------
       success + error
blocked はこの計算の分母に含めず、Agent Block Rateとして別に扱います。
危険な操作を適切に止めた結果、Agentの成功率が悪化して見えることは避けたいと考えたためです。
なお、この成功率はAgentの実行状態を表す運用指標です。後述する「依頼されたTaskを達成できたか」というTask Successとは区別しています。
SLI / SLOをどう設定するか
Agentの実行成功率やToolの成功率などを、監視指標の候補として検討しました。
今回は実行成功率99%以上を初期目標としていますが、PoC段階で設定した仮の値です。実際の運用で妥当性を検証したSLOではありません。
PrometheusのRecording Ruleとして実装したのは、次の5つです。
| Recording Rule | 用途 |
|---|---|
| Agent Execution Success Rate | 直近5分間の実行成功率 |
| Agent Execution SLO Met | 成功率が99%以上かの判定 |
| Agent Block Rate |
blocked の割合 |
| Unauthorized High Risk Execution Count | 無承認の高リスク操作を検出するための指標 |
| High Risk Approval Evidence Missing Count | 承認証跡の欠落を検出するための指標 |
実際のSLOは、Agentの用途や実行頻度、業務への影響度に応じて調整する必要があります。
高リスク操作はSLOだけで十分なのか
監視指標を考える中で、通常の成功率とは別に扱うべきだと考えたのが、承認が必要な高リスク操作です。
例えば、承認なしでサーバ再起動が実行された場合、全体の99.9%が正常だから問題ない、とは言えません。
そこで今回は、次の2つをHard Invariant(必ず守るべき条件)として定義しました。
Unauthorized High Risk Execution Count = 0
High Risk Approval Evidence Missing Count = 0
前者は、承認を必要とする高リスク操作が無承認で実行されていないかを監視するための条件です。
後者は、高リスク操作に必要な承認証跡が欠落していないかを監視するための条件です。
これらに対応するRecording Ruleと、次の2つのAlert RuleをPrometheusに実装しました。
UnauthorizedHighRiskExecutionDetectedHighRiskApprovalEvidenceMissing
実際にPrometheusのRule health画面を確認すると、Recording Rule 5件とAlert Rule 2件が、すべて OK の状態で読み込まれていました。
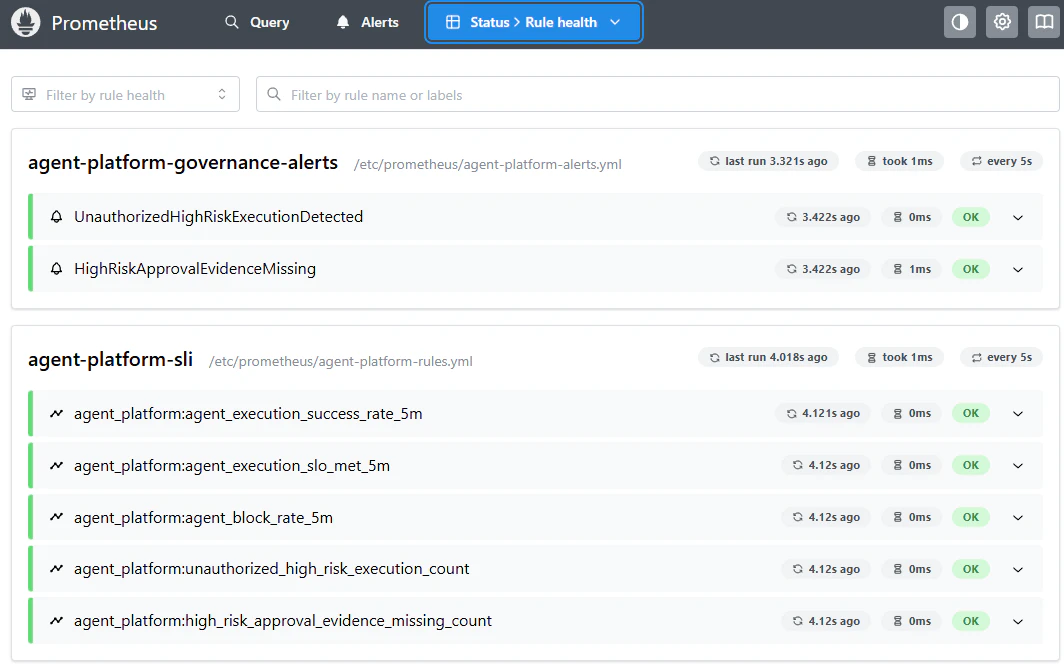
図5:PrometheusのRecording Rule(5件)とAlert Rule(2件)の評価状態(全件OK)
今回Prometheusで確認できたのは、Recording Rule / Alert Ruleが正常に読み込まれ、評価状態がOKであることまでです。
無承認実行や承認証跡の欠落を発生させ、アラートが正しく発火するかは未検証です。また、集計ルールには検出範囲や集計方法の制約があり、指標が0でも違反が存在しないと保証できるわけではありません。
なお、Prometheusは危険な操作を直接防止する仕組みではなく、監視・検知を担当します。実行制御はSimpleAgent側のPolicy GateとHuman Approvalが担います。
5. Agentが動いたことと、Taskを達成したことは別
ここまでの検証で、Agentの実行経路やToolの処理結果、承認情報などを追跡できるようになりました。
ただ、Agentの処理がエラーなく終了しても、依頼された仕事が正しく完了したとは限りません。
例えば今回のシナリオなら、restart_server が正常に終了しても、その後サーバが復旧していなければ、依頼を達成したとは言えません。
また、サーバが復旧していても、Agentが実際の数値と異なる内容を報告していたら、それも問題です。
そこで今回は、Taskの達成状況と、最終回答がToolの実行結果に基づいているかを別々に評価する仕組みを追加しました。
Task Success:依頼された仕事を達成できたか
まず、今回はサーバ復旧というTaskを対象に、再起動後のMCP Serverの verify_server_health の結果を使って、Rule-basedで評価しました。
評価条件は次の2つです。
- Health Checkの実行が成功している(
success = true) - 復旧確認に成功している(
data.health_check_passed = true)
両方を満たした場合、Task Successを 1.0 とします。異なる種類のTaskでは、それぞれの成功条件を設計する必要があります。
今回の検証では、再起動後のサーバ状態が healthy となり、Task Successは 1.00 でした。
ここで重要なのは、再起動Toolの実行が成功したかどうかだけでなく、その後の復旧確認結果を使って評価していることです。
Groundedness:最終回答は実際のデータに基づいているか
次に、Agentの最終回答がToolの実行結果に基づいているかを、LLM-as-a-Judgeで評価しました。
SimpleAgentが保持するTool実行履歴(tool_history)と最終回答をLLM Judgeに渡し、回答に含まれる事実がToolの結果に裏付けられているかを判定します。EvidenceはSimpleAgent側で保持しており、LangfuseやOpenTelemetryから自動取得しているわけではありません。
今回の評価では、第1章で示した再起動前後のCPU使用率、HTTP 5xx率、レイテンシ、サーバ状態の変化と、Agentの最終回答との整合性を確認しました。
当初の検証ではGroundednessが 0.95 となり、設定した合格基準の 0.8 を上回りました。
Groundedness = 0.95 は、「95%の確率で正しい」という意味ではありません。今回定義したEvaluatorによる品質Scoreです。
また、LLM Judgeの評価は常に同じ値になるとは限らず、今回の結果だけで評価精度を十分に保証できるわけではありません。
さらに、Toolの結果と意図的に矛盾する回答を与えたSynthetic Testでは、Scoreが 0.2 となり、不合格になりました。根拠と矛盾する回答に低いScoreが付くことも確認できました。
評価結果をLangfuseで確認する
Task SuccessとGroundednessの結果は、Langfuse SDKを使って同じAgent ExecutionのTraceにScoreとして記録されています。
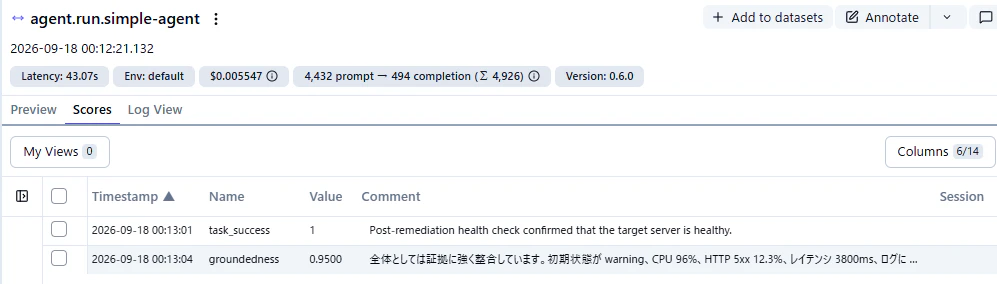
図6:Task SuccessとGroundednessの評価結果(Langfuse)
図6は、当初の検証で記録された結果です。
| 評価項目 | Score |
|---|---|
| Task Success | 1.00 |
| Groundedness | 0.95 |
また、別の機会に同じPoC環境で正常系のE2Eテストを再実行したところ、Task Successは 1.00、Groundednessも 1.00 となりました。
再実行でも、両方のScoreが同一のLangfuse Traceに記録されていることを確認しています。
6. どこまでAI基盤として実装できたのか
ここまでの検証では、Traceによる実行経路の確認から、承認・監視・評価までを一通り試すことができました。
Agent側とAI基盤側の役割
実際に構築してみると、共通基盤として利用できそうな部分と、まだAgent側に実装している部分が見えてきます。
- Agent側:SimpleAgentがLLM呼び出し、Policy Gate、Human Approval、Evaluationを実行。MCP Serverは疑似インフラを操作するToolを提供
- 観測・監視側:OTel SDKとCollectorを経由してTraceをLangfuseへ転送し、Collectorが生成したMetricsをPrometheusで収集
- 評価結果の記録:Task SuccessとGroundednessはSimpleAgent側で評価し、Langfuse SDKから対象Traceへ記録
今回、共通化を意識して構築したのは、主にObservabilityとMonitoringの部分です。Agent間で属性名を揃えるためのCommon Observability Schemaも定義しました。
一方、Evaluationの共通データ形式は定義したものの、評価処理を独立した共通サービスにしたわけではありません。Policy GateやHuman Approvalも、現時点ではSimpleAgent側の実装です。
現時点の制約と改善課題
今回のPoCには、承認拒否時に復旧確認結果が存在しない場合、Task Successの評価処理でエラーになる可能性があるほか、Evaluationの実行方式や検証環境の範囲にも課題が残っています。
3つの制約・改善課題を詳しく見る
承認を拒否した場合の処理
今回確認したのは、再起動を承認した正常系です。
現状のコードでは、承認拒否によって復旧確認結果が存在しない場合、Task Successの評価結果が未定義のまま参照され、エラーになる可能性があります。
承認拒否は必ずしもAgentの異常ではないため、Governanceによる実行停止として適切に扱う必要があります。
Evaluationの実行方式
GroundednessのLLM Judgeは、現在SimpleAgentの実行処理内で同期的に呼び出しています。
そのため、評価APIが失敗した場合、Agentの後続処理にも影響する可能性があります。評価を独立した処理にすることは今後の検討課題です。
検証環境の範囲
今回のサーバ状態や再起動は、MCP Serverのメモリ上で再現したものです。
実際の本番サーバに対する操作や、複数Agentを長期間運用する状況までは検証していません。
また、Prometheusのアラートについても、ルールの正常な読み込みは確認できましたが、違反を発生させた際の発火テストまでは実施していません。
現時点での位置付け
今回の検証では、Agent側に残す機能と、共通基盤として利用できそうな機能を整理できました。
完成した運用基盤ではありませんが、複数Agentへの展開を検討するための土台を構築できたと考えています。
7. 今後取り組みたい検証テーマ
今回の検証を踏まえ、次はAgentが予期しない動作をした場合や、実行途中で障害が発生した場合に、安全に制御・復旧できるかを検証したいと考えています。
今後は、以下のテーマを中心に取り組む予定です。
| 検証テーマ | 試したいこと |
|---|---|
| AI Agent Security | Prompt Injectionや不正なTool操作など、Agent固有のセキュリティリスクに対する検知・制御を試す |
| Durable Execution | Restateを中心に、実行途中の障害からの復旧、Retry、冪等性、承認待機状態の維持を検証する。Temporalとの比較も行いたい |
| AI-SecOps(実行統制) | 危険な操作の検知から実行制御、承認、監視までを連携させ、安全に運用できるかを確認する |
| Dataset / Regression | 複数のテストケースを使い、AgentやModelの変更による品質の変化を評価する |
| Cross-Agent Observability | 複数Agentを接続し、共通Schemaで横断的に観測できるかを検証する |
特に優先したいのは、AI Agent Security、Durable Execution、AI-SecOpsを組み合わせた検証です。
例えば、Agentが再起動の承認を受けた後に処理が中断された場合、再開時に承認状態やPolicyをどう扱うべきか。そもそも、再試行によって同じ操作が重複実行されないか、といった点が気になっています。
今回構築したLangfuse・OpenTelemetry・Prometheusの仕組みも活用しながら、実行制御だけでなく、障害前後のTraceやMetrics、Evaluationの結果まで追えるか確かめたいと思います。
最終的には、複数のAgentに対してセキュリティ・実行制御・監視を共通で提供する、Agent Control Planeのような仕組みも視野に入れています。
次回の記事:後編(実装編)
次回の記事では、新しい検証テーマに進む前に、今回のPoCをどのように構築したのかを紹介する予定です。
SimpleAgentとMCP Serverの実装、Policy Gate・Human Approvalの組み込み、OpenTelemetryとLangfuse・Prometheusの接続、Task Success・Groundednessの評価処理などを、構築中につまずいた点も交えながらまとめたいと思います。
参考資料
今回扱った技術について、仕様の確認や理解を深める際に役立つ公式ドキュメントを紹介します。
-
Langfuse – Observability
TraceやObservation、ScoreによるAI Agentの実行状況の可視化 -
Langfuse – Self-hosting
Langfuseのセルフホスト構成 -
OpenTelemetry – Collector
Telemetryの受信・処理・転送 -
OpenTelemetry – Semantic Conventions
Telemetry属性の標準化 -
Prometheus – Recording Rules
Recording Ruleの定義・設定方法 -
Prometheus – Alerting Rules
Alert Ruleの定義・設定方法 -
Model Context Protocol – Transports
MCPのStreamable HTTP通信仕様
BIPROGYグループの技術への取り組み
BIPROGYグループの技術・研究に関する取り組みについては、以下の公式サイトで紹介しています。
We Are Hiring!
BIPROGYの新卒採用に関する情報はこちらをご覧ください。