
はじめに
「なぜクオンツは最初にリターンを測るのか」 では、リターン=損益を測るところから始めた。次の問いは、複数の資産や戦略を持つと、損益がどう合わさるかである。その中心にあるのが相関だ。
相関は便利だが、数字をそのまま信じると設計を誤る。2022年には株と債券が同時に下がり、株60%・債券40%の典型的なポートフォリオは1937年以来の悪い年になった。「株と債券は逆に動く」という相関を前提にした分散が、肝心なときに効かなかったのである。
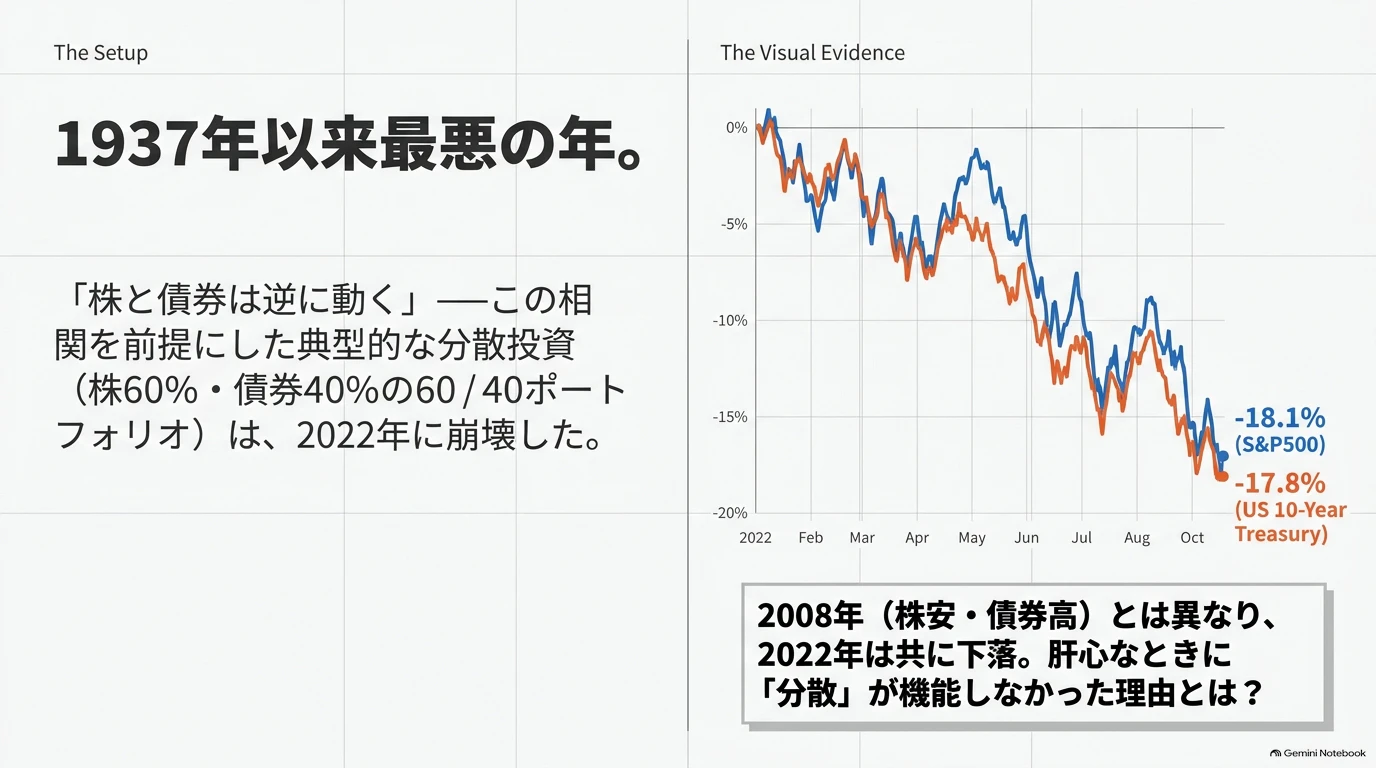
※右のグラフは値動きのイメージで、実際の推移ではない。数値は2022年の年間騰落率(出典は参考文献)。
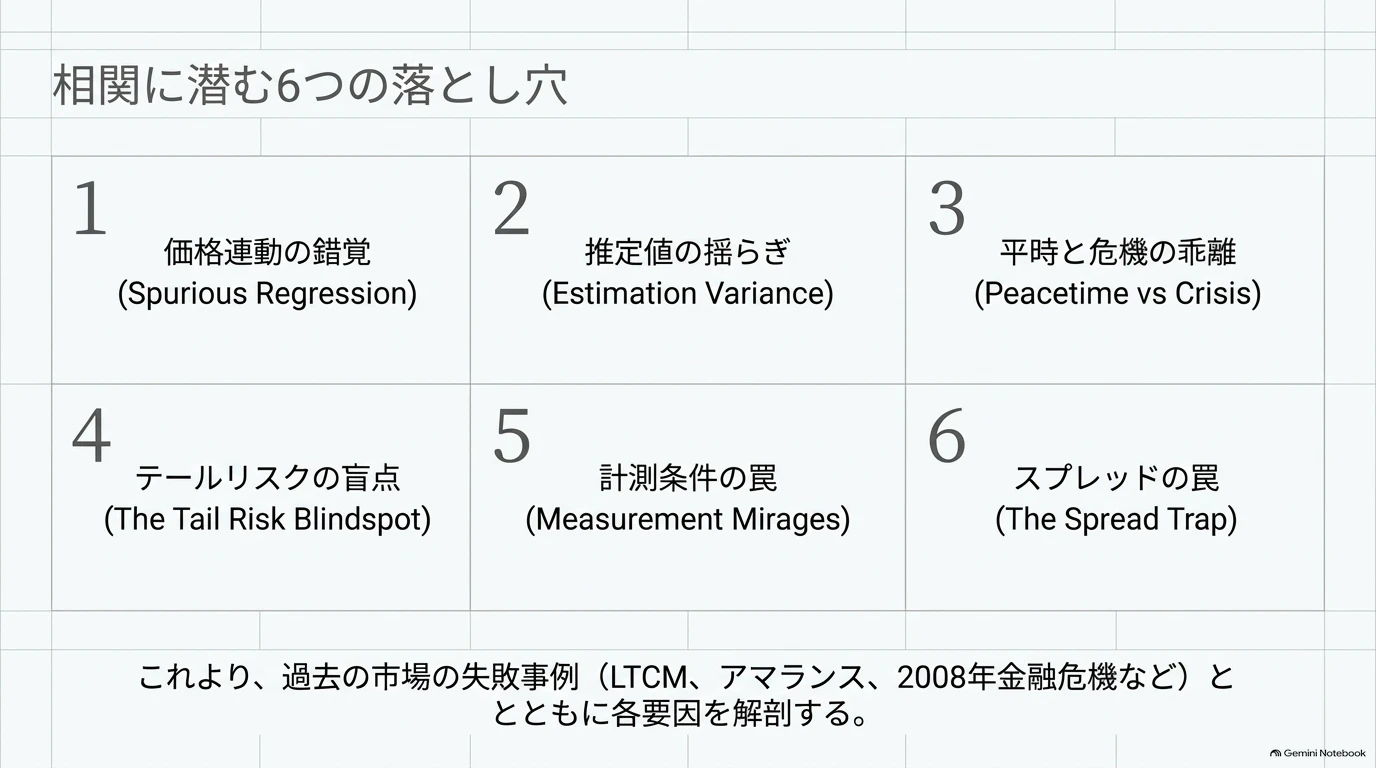
本記事では、相関を使うときに陥りやすい6つの落とし穴を、過去の事例とシミュレーションで見ていく。先に結論を書いておく。
相関は原因ではなく結果である。 しかし市場の因果は完全には特定できない。だから、相関の背後にある原因について検証できる仮説を持ち、その原因が続いているかを見張り、仮説が外れても致命傷にならない設計をする。
※本記事は筆者の学習の記録であり、特定の投資を推奨するものではない。
1. 相関は何に使うのか
相関係数は −1 から +1 の値をとり、2つの資産のリターンが同じ方向に動く度合いを表す。クオンツの実務では、主に分散、ヘッジ、戦略やシグナルの検証、分散が効いているかの監視に使われる。

相関がリスクを左右する理由は、2資産のポートフォリオの分散の式で分かる。相関 $\rho$ が低いほど最後の項が小さくなり、リスク $\sigma_p$ が下がる。同じボラティリティの2資産を半々に持つと、ポートフォリオのボラは、相関0.9なら1資産の97%、0.5なら87%、0なら71%になる。
便利な数字だが、どの使い方にも落とし穴がある。
2. 6つの注意点
注意点1:価格連動の錯覚
「価格が連動している=関係がある」という思い込み

チャートを重ねて「この2つは連動している」と判断し、売買やヘッジの根拠にするときに落ちる。
事例:1981〜1993年のS&P500は、バングラデシュのバター生産量だけで決定係数0.75まで「説明」できた(Leinweber)。米国のチーズ生産量と羊の頭数を加えると0.99まで上がる。もちろん関係はない。データを探し回れば、当てはまりのよい関係は必ず見つかるという皮肉な例である。
なぜ起きるか:価格は、日々のリターンを積み上げたものである。2つの資産の日々のリターンが互いに独立なら、リターンどうしの相関は、データが増えるほどゼロに近づく。ところが価格は過去のリターンをすべて足し込んだ値なので、一度ついた上昇や下落の流れがそのまま残る。2本の価格がたまたま同じ方向に流れれば、関係がなくても相関は高く出るし、逆方向に流れれば大きなマイナスになる。価格の相関は、データを増やしてもゼロに近づかず、どんな値にもなりうる。
実際に、日々のリターンが互いに独立な2本の価格(1,000日分)を2,000組作ると、約4割で価格の相関の絶対値が0.5を超えた。同じ2本を、価格から計算したリターンで測ると、相関は95%が±0.06の範囲に収まった。

避け方:相関は価格ではなくリターンで測る。「なぜ一緒に動くのか」を説明できない相関は使わない。
注意点2:推定値の揺らぎ
「測った相関=本当の相関」という思い込み

過去の相関が低い資産を分散先に選ぶとき、推定した相関をそのまま最適化に入れるときに落ちる。
事例:ビットコインとS&P500の相関は、2017〜19年には0.01だったが、2020〜21年には0.36に上がった(IMF)。株とほぼ無相関に見えた資産が、次の期間には株と一緒に動くようになった。1998年に破綻したLTCMも、短い期間の履歴に頼ってリスクを大きく過小評価していた(Jorion, 2000)。
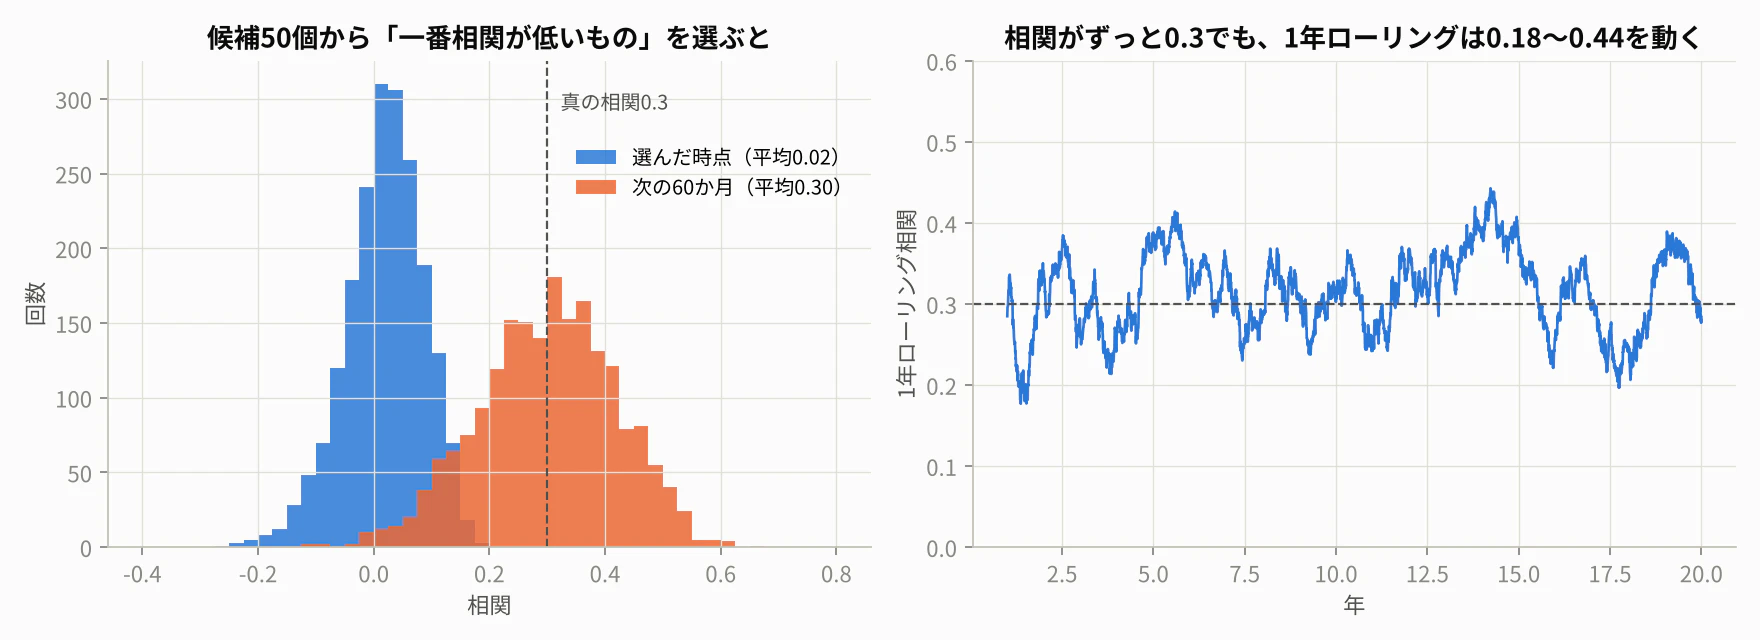
なぜ起きるか:相関は推定値で、思ったより揺れる。真の相関が0.3でも、1年分の日次データで測ると0.18〜0.41のどこにでも出る。そのため、真の相関がすべて0.3の候補50個から「一番相関が低いもの」を選ぶと、選んだ時点では平均0.02に見えるが、次の期間には0.30に戻る。低く見えたのは、ほとんどが推定の誤差だったことになる。
背後の原因:ビットコインの場合は誤差だけでなく、普及が進んで株と同じ投資家層が同じ理由で売買するようになったことも背景にあると考えられる。
避け方:相関は幅を持った推定値として扱う。低相関を理由に選んだら、別の期間で測り直す。
注意点3:平時と危機の乖離
「平時の相関で分散できている」という思い込み
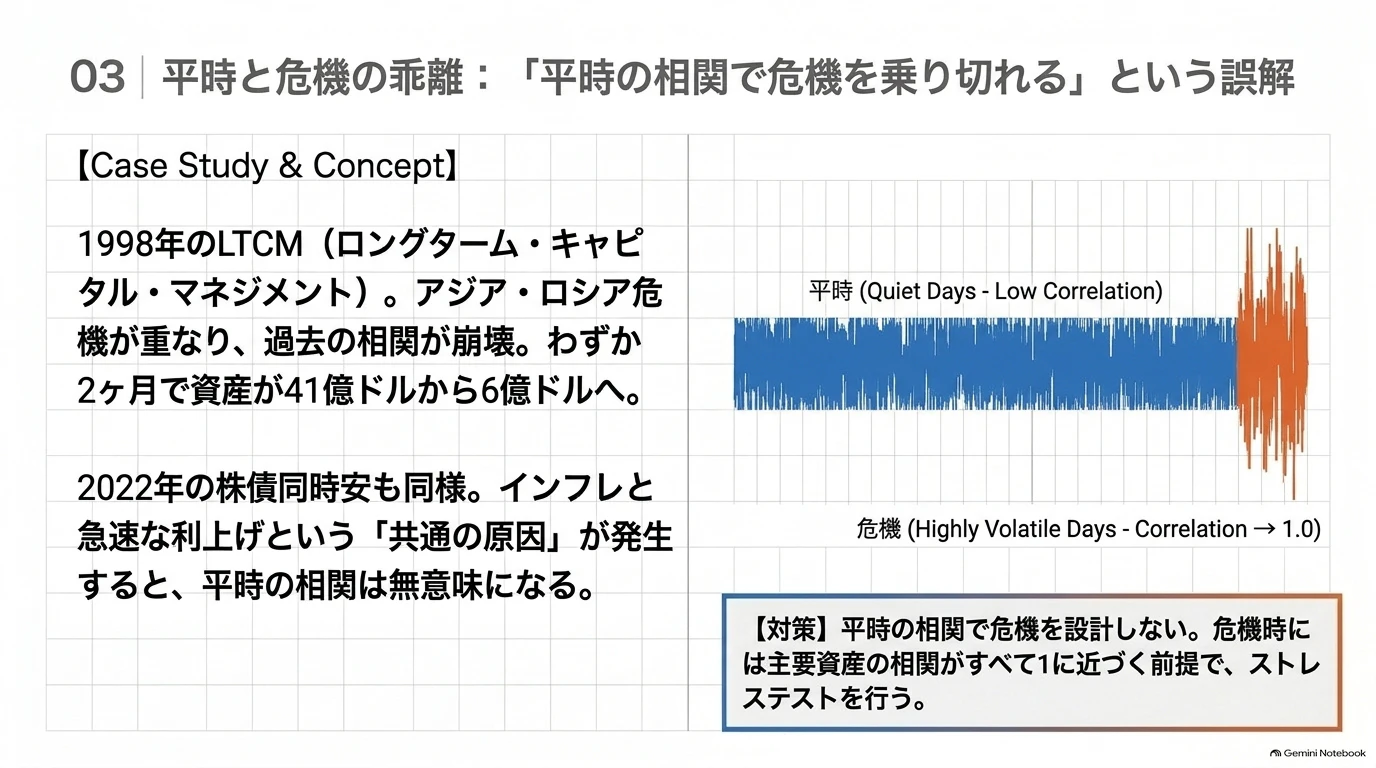
平時に測った相関で、分散投資の配分を決めるときに落ちる。
事例:2022年、S&P500は−18.1%、米10年国債は−17.8%で、株60%・債券40%のポートフォリオは約−18%だった。2008年は株が約−37%でも10年国債が+20.1%上がり、同じポートフォリオは−14.2%にとどまっていた。2000年ごろからの約20年、株と債券は実際に逆方向に動くことが多かったので、この前提は当時としては妥当に見えていた。
1998年のLTCMも、アジア危機とロシア危機が重なって過去の相関が崩れ、純資産が2か月足らずで41億ドルから6億ドルに減った。
背後の原因:2022年は、インフレと急速な利上げという共通の原因が、株と債券を同時に押し下げた。長期データでも、高インフレの環境では株債相関はプラスだった(Molenaar et al., 2023)。
コラム:「危機時に相関が上がった」も、切り出し方で作れる
真の相関を0.5に固定したまま、大きく動いた日だけを取り出すと相関は0.77に、下落した日だけを取り出すと0.23に見える。危機時の相関上昇には、本物の部分(Longin & Solnik, 2001)と、こうした見かけの部分(Forbes & Rigobon, 2002)の両方がある。危機の期間は、値動きではなく外部の日付で区切って比べたい。

避け方:平時の相関で危機を設計しない。危機時には主要な資産の相関がそろって高まる前提で、損失を点検しておく。
注意点4:テールリスクの盲点
同じ相関係数でも、同時に大きな損失が発生する確率は異なる
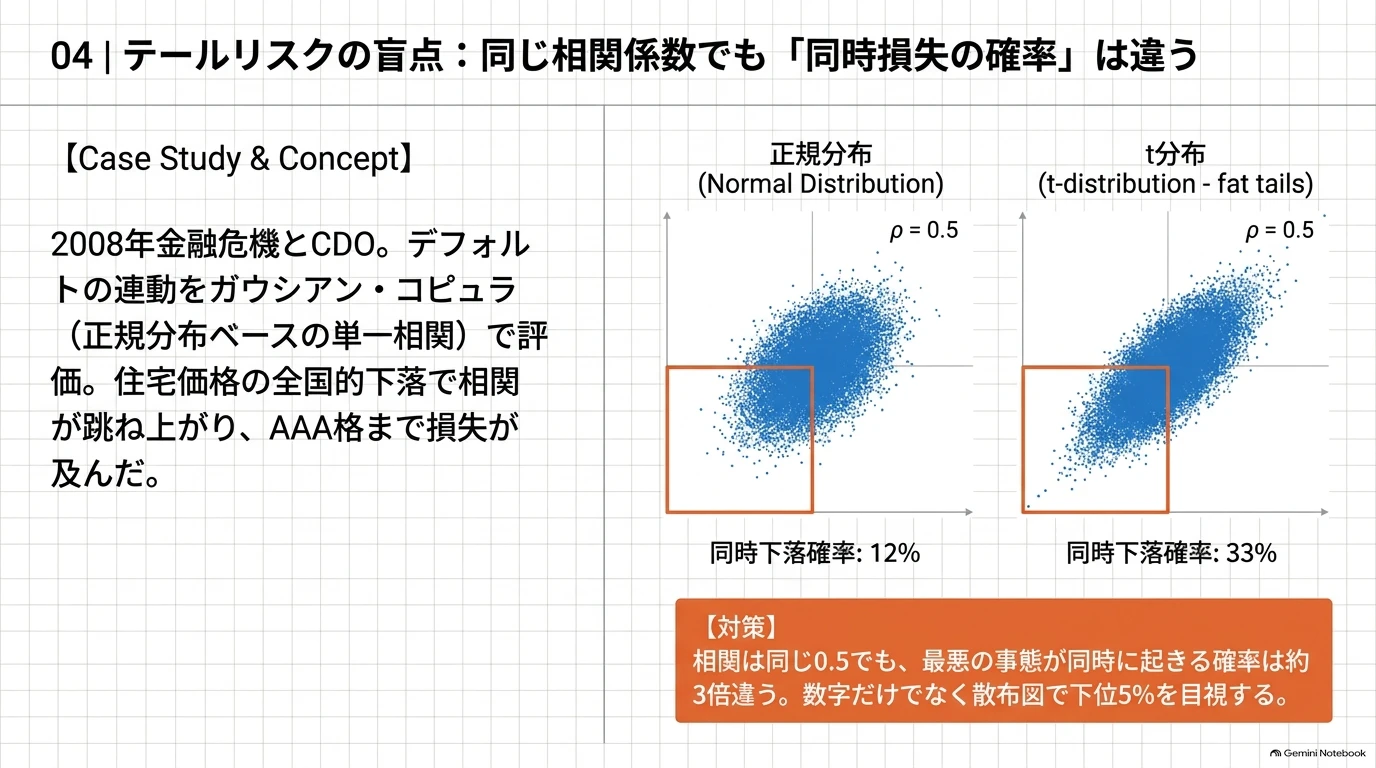
※スライドの「同時下落確率」は、Aが最悪1%に入った日にBも最悪1%に入る確率を指す。
相関と正規分布を前提に、同時に損失が出る確率やVaRを見積もるときに落ちる。
事例:CDOの評価に使われたガウシアン・コピュラは、デフォルトの連動を1つの相関で表し、一定と仮定した。その値は、住宅価格が上がり続けた10年足らずの期間のCDS価格から推定されていた。住宅価格が全国的に下がると相関は跳ね上がり、AAAとされたトランシェまで損失が及んだ(Salmon, 2009)。
なぜ起きるか:相関係数が同じでも、2つの資産が同時に大きく下落する確率が同じとは限らない。スライドの図では、正規分布とt分布(裾の厚い分布)のモデルを比べている。どちらも相関係数を0.5程度にそろえているが、Aが最悪1%に入った日にBも最悪1%に入る確率は、正規分布では12%、t分布では33%と、約3倍の差が生じた。つまり、相関係数という1つの数値だけでは、極端な市場環境での同時損失のリスクを十分に評価できない。
背後の原因:住宅価格の全国的な下落という共通の原因が、平時にはばらばらだったデフォルトを一斉に引き起こした。
避け方:相関の数字だけでなく散布図を見る。下位5%の局面で、同時に損失が出る頻度を数える。
補足:相関係数がゼロでも、2つの変数に関係がないとは限らない
ピアソン相関係数は、2つの変数の直線的な関係を測る指標である。たとえば、一方の変数が正の方向にも負の方向にも大きくなるほど、もう一方の変数が大きくなるようなU字型の関係では、はっきりした規則性があっても相関係数はゼロに近くなる。そのため、相関係数がゼロであることは、2つの変数が独立していることを意味しない。

注意点5:計測条件の罠
取引時間・集計する時間軸・評価通貨によって、相関係数は変わる
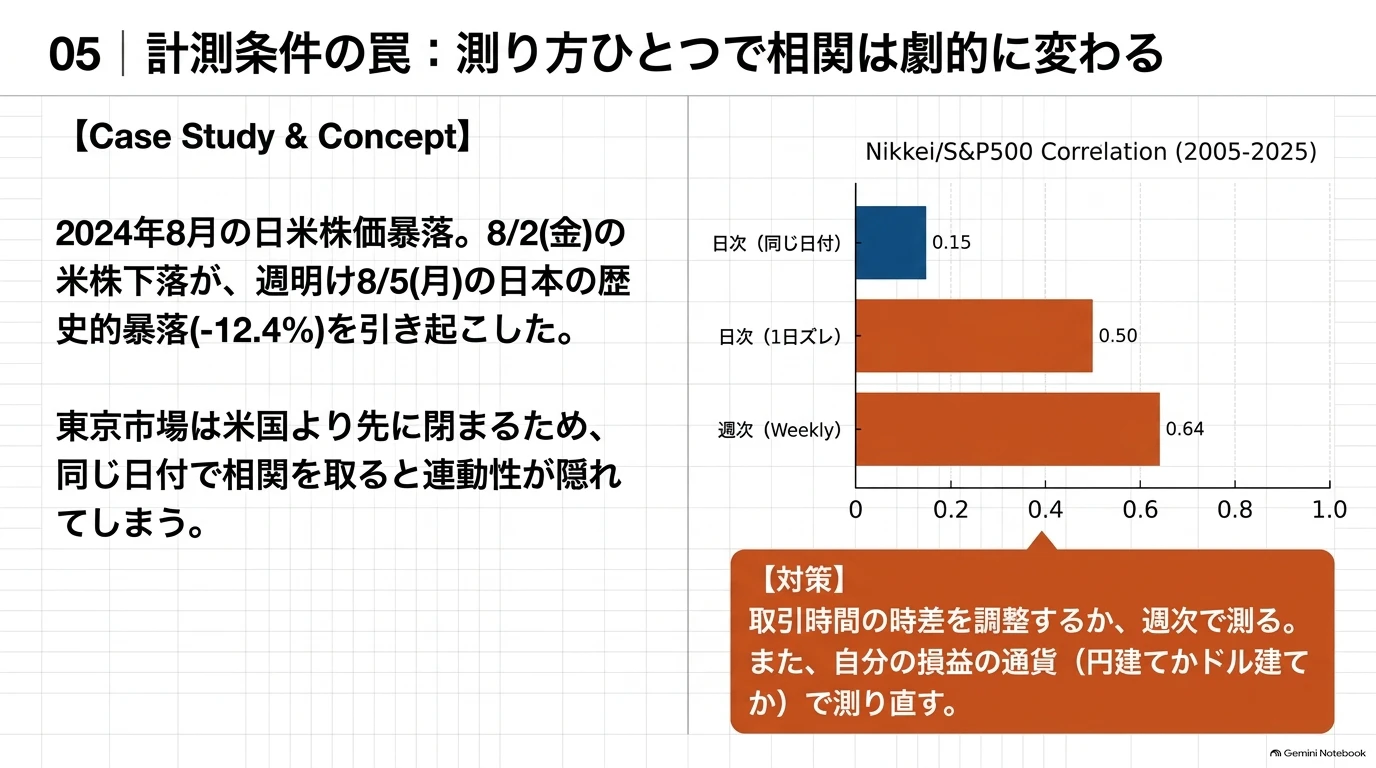
同じ2つの資産であっても、取引時間のずれ、リターンの集計単位、評価通貨の違いによって、計算される相関係数は変わる。そのため、相関係数を使って分散効果を評価するときは、何をどのような条件で比べているのかを明確にする必要がある。
日本株と米国株の分散効果を評価するとき、円建てで外国資産を評価するときに落ちる。
事例:2024年8月2日(金)の米雇用統計が予想を大きく下回り、米国株が下落した。週明け5日の日経平均は4,451円安(−12.4%)と下げ幅で過去最大になり、為替は一時1ドル142円台まで円高が進んだ。
なぜ起きるか:東京市場は米国市場より先に閉まるので、米国の動きは翌営業日の日本株に現れる。同じ日付どうしで相関を取ると、この連動が1日ずれて見えにくくなる。2005〜2025年の実データで日経平均×S&P500の相関を測ると、次のように変わった。
| 測り方 | 相関 |
|---|---|
| 日次(同じ日付どうし) | 0.15 |
| 日次(日経の当日と、前営業日のS&P) | 0.50 |
| 週次 | 0.64 |
同じ日付どうしの日次で測ると0.15で、日米の株はあまり連動していないように見える。ところが、前営業日の米国と合わせると0.50、週次では0.64になった。日次の数字だけで日米の分散効果を評価すると、連動を大きく見落とすことになる。
通貨でも数字は変わる。S&P500×米国債の月次相関は、ドル建てでは−0.07とほぼ無相関だったが、円建てでは0.37だった。円建てでは、両方に同じドル円の動きが掛かるためだ。ドル建てでは効いている分散が、円で損益を測る投資家には小さくなる。
避け方:取引時間のずれをそろえる(週次で測るか、時差を調整する)。集計単位を変えても結論が変わらないか確かめる。自分の損益の通貨で測る。
注意点6:スプレッドの罠
相関が高くても、ヘッジやペアトレードに適しているとは限らない

2つの資産のリターンに高い相関があっても、その組み合わせがヘッジやペアトレードに適しているとは限らない。相関係数は、2つの資産がどの程度そろって動くかを示す指標である。しかし、相関が高いからといって、両者の価格差が安定していることや、価格差が広がった後に元の水準へ戻ることが保証されるわけではない。
ここで重要になるのが、スプレッド(価格差) という考え方だ。たとえば資産Aが100円、資産Bが90円なら、価格差は10円である。その後Aが120円、Bが100円になると、両方とも上がっているが、価格差は20円に広がっている。2つの資産が同じ方向に動いていても、価格差が安定しているとは限らない(実際のペアトレードでは、取引数量やヘッジ比率で調整した価格差を使うことも多い)。
事例:アマランスの巨額損失(2006年)
米国のヘッジファンド、アマランス・アドバイザーズは、2006年に天然ガス先物の取引で約60億ドルの損失を出した。取引の一つが、受渡月の異なる先物の価格差を狙う「カレンダースプレッド取引」で、2007年3月限を買い、4月限を売るポジションを大量に持っていた。
この取引の損益は、天然ガス価格そのものの上下ではなく、「3月限−4月限」の価格差で決まる。価格差が広がれば利益、縮まれば損失になる。アマランスは、冬の需要期の最後にあたる3月限は上がり、在庫の積み増しが始まる4月限は下がると見て、価格差の拡大に賭けていた。ところが価格差は逆に急速に縮まった。8月最終週に約2.49ドルだった価格差は、9月15日には1.15ドル、その後0.58ドルまで縮小した(New York Times, 2006)。
この事例から学べること
同じ天然ガスを対象とする隣り合う限月の先物は、共通の需給要因の影響を受けるため、似た値動きをしやすい。それでも、価格差が安定しているとは限らない。3月限と4月限では、価格を決める需給(冬の需要と在庫の積み増し)が違うからだ。
ただし、アマランスの損失は、相関係数の使い方を誤ったことが直接の原因ではない。価格差の変動に対して巨大なポジションを持っていたことや、リスク管理の問題が、巨額の損失につながった。ここでの教訓は、値動きが似ていることと、その組み合わせによる戦略のリスクが小さいことは、別の問題だという点である。
なぜ起きるか:リターンの相関は日々の動きの揃い方であって、価格差が戻る力(共和分)とは別物だ。日次リターンの相関がどちらも0.95のペアに、同じ平均回帰ルールを10年間当ててみた。価格差が戻るペアでは損失で終わった例はなかったが、戻らないペアでは55%が損失で終わった。
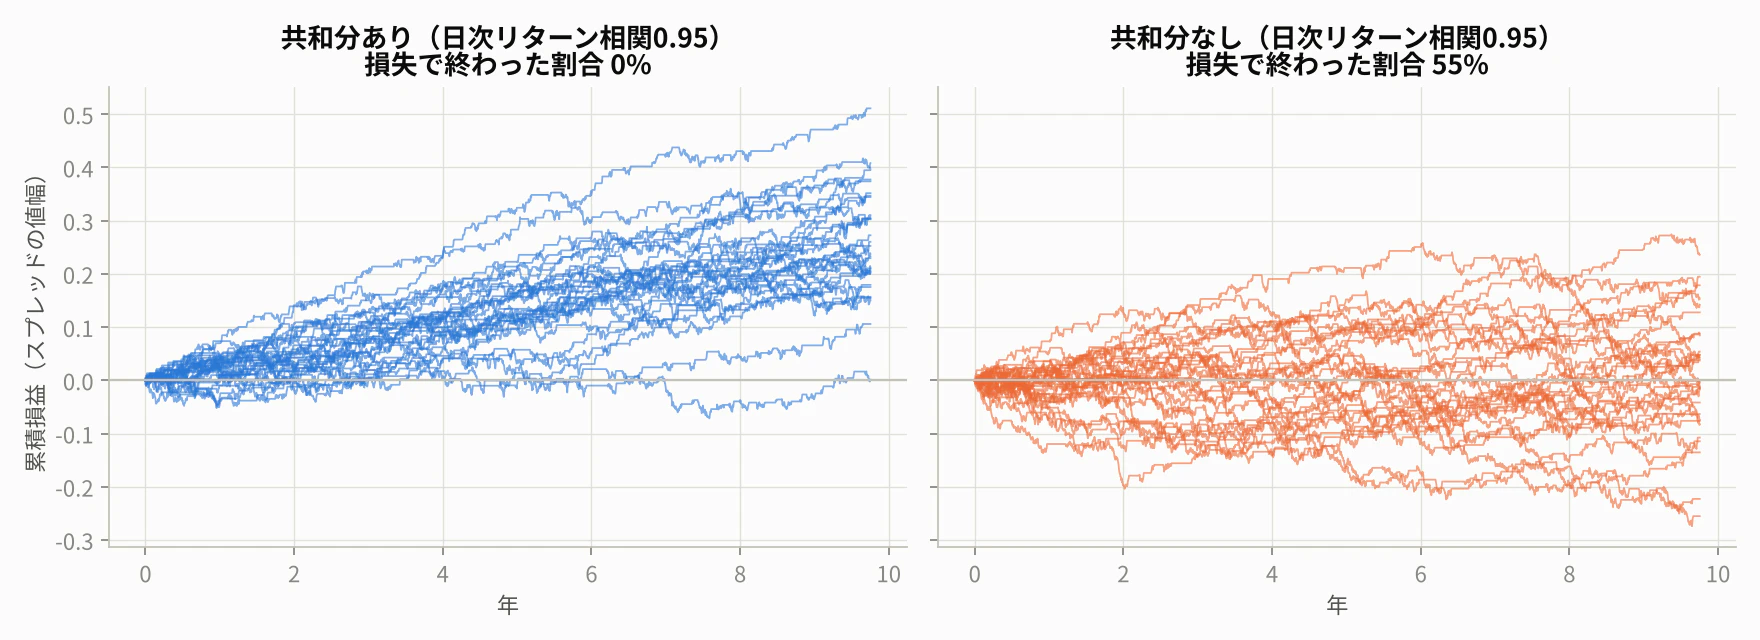
ヘッジの効き目も、相関から受ける印象より小さい。最小分散ヘッジをした後のボラは元の $\sqrt{1-\rho^2}$ 倍なので、相関0.7でもボラは29%しか減らない。
身近な例がNT倍率(日経平均÷TOPIX)である。日経平均とTOPIXは日々の値動きがよく似ているが、値がさの半導体関連株が日経平均だけを大きく押し上げ、NT倍率は2026年7月時点で17倍を超える過去最高水準にある。「いずれ戻る」と考えた逆張りは、戻らないまま損失が膨らみうる。
避け方:ヘッジやペアトレードは、相関係数だけで判断しない。ヘッジ比率、スプレッドの安定性、平均回帰性(共和分)、市場環境の変化、ポジションの大きさを合わせて確かめる。相関分析は戦略づくりの出発点にはなるが、それだけで戦略の有効性や安全性は判断できない。
3. 相関は原因ではなく結果
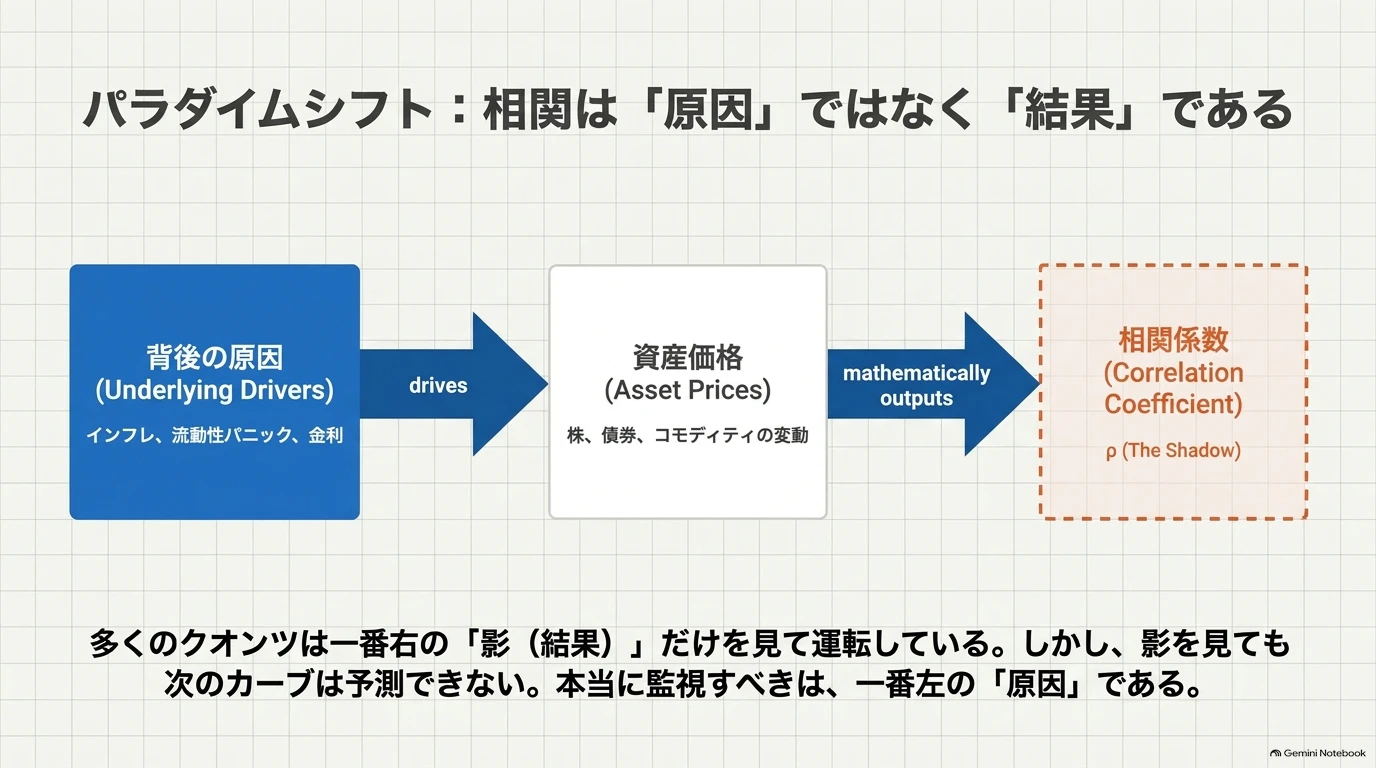
6つの事例を並べると、どの相関の背後にも原因があった。
| 事例 | 背後の原因 |
|---|---|
| バングラデシュのバター | 原因がない。両方がたまたまトレンドしていただけ |
| ビットコイン | 株と同じ投資家層が、同じ理由で売買するようになった |
| 2022年の株債同時安 | インフレと利上げが、株と債券の両方を押し下げた |
| LTCM | 似たポジションを多くの参加者が持ち、同時に崩れた |
| CDO | 住宅価格の全国的な下落が、デフォルトを一斉に起こした |
| 2024年8月5日 | 米雇用統計 → 利下げ観測 → 円高とリスク回避 → 翌営業日の日本株 |
| NT倍率、アマランス | 指数の構造や限月ごとの需給の違いで、価格差を戻す力がなかった |
相関の数字だけを見ていると、変化は事後にしか分からない。原因を見ていれば、相関が崩れる条件を事前に意識できる。
ただし、市場の因果は完全には特定できないと考えている。実験ができず、参加者の行動で関係そのものが変わり、原因の構造も時代で変わり、危機の数も少ないからだ。一方で、金利と債券価格のように仕組みとして確かな因果もあり、イベントの前後でどちらが先に動いたかは確かめられる。全部は分からないが一部は確かめられ、残りは仮説で埋める、という構図である。
その仮説は、次の3つを満たすように持ちたい。
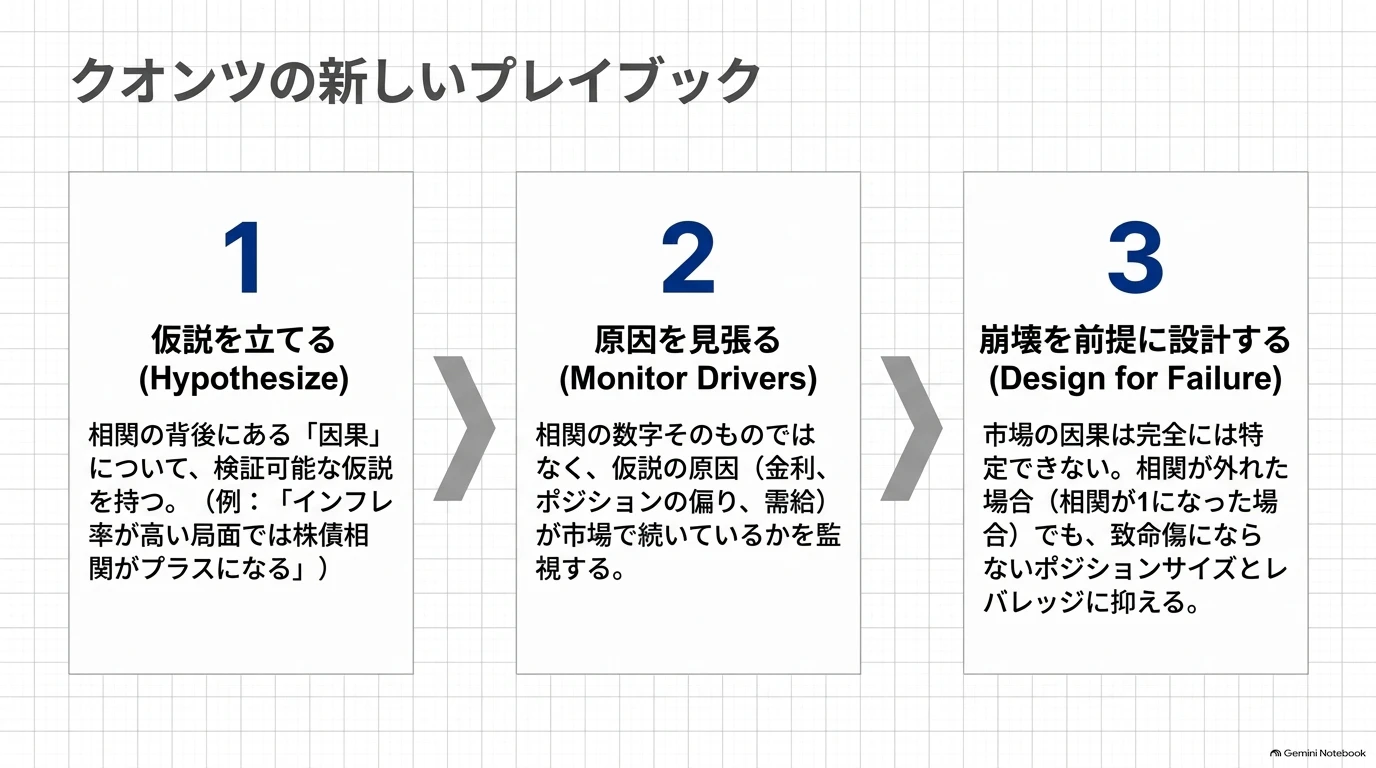
- 検証できる形で持つ:「インフレ率が高い局面では株債相関がプラスになる」のように、外れたと判断できる形にする。
- 原因を見張る:相関の数字より、仮説の原因(インフレ、金利、ポジションの偏り、指数の構成など)が続いているかを見る。
- 外れても致命傷にならない設計にする:LTCMやアマランスでは、ポジションの集中とレバレッジが、相関の見誤りを致命傷に変えた。
4. 使う前のチェックリスト
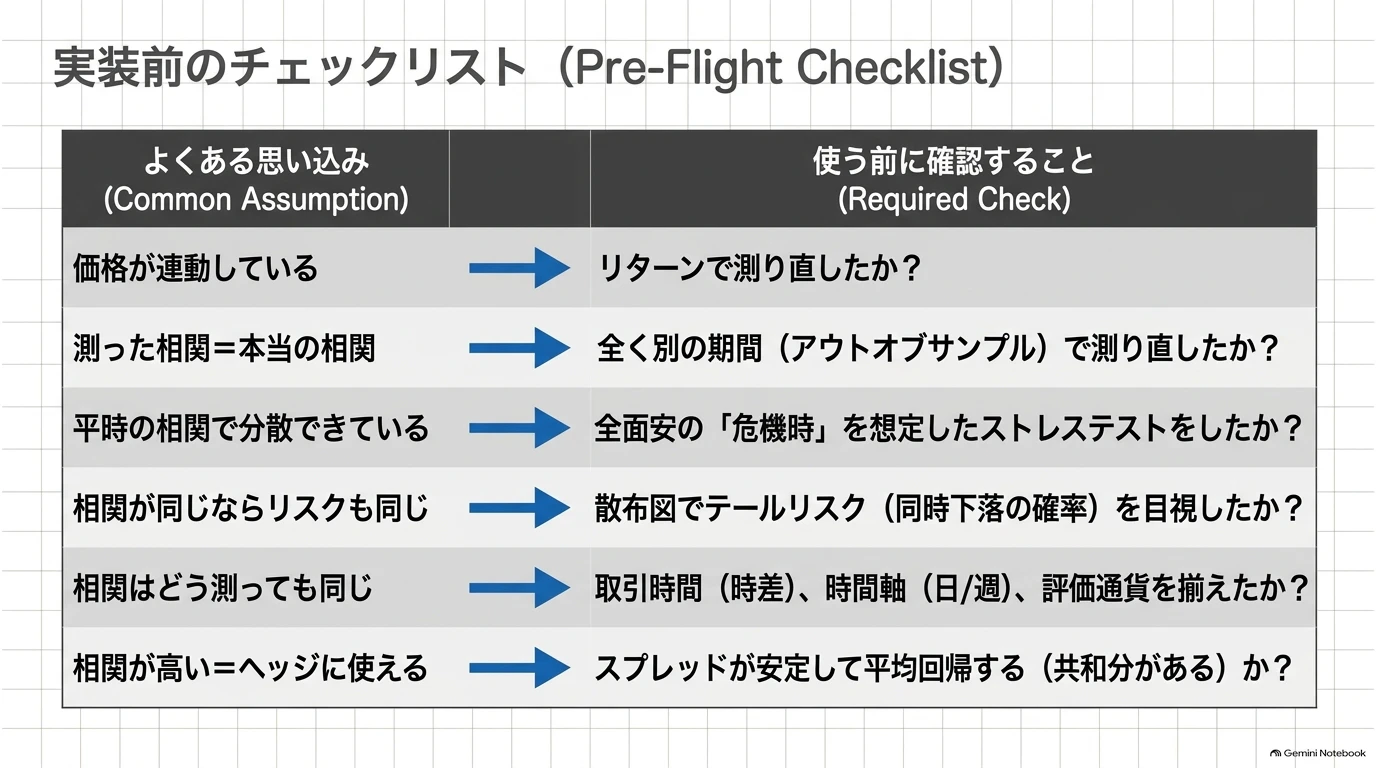
| よくある思い込み | 使う前に確認すること |
|---|---|
| ① 価格が連動している=関係がある | リターンで測ったか |
| ② 測った相関=本当の相関 | 別の期間で測り直したか |
| ③ 平時の相関で分散できている | 危機時の相関を別に想定したか |
| ④ 相関係数が同じなら、同時に大きな損失が出る確率も同じ | 散布図と、下落局面での同時発生を見たか |
| ⑤ 相関はどう測っても同じ | 取引時間・集計する時間軸・評価通貨はそろっているか |
| ⑥ 相関が高い=ヘッジやペアとして使える | スプレッドが安定して戻るか(共和分)、ポジションは大きすぎないか |
| 共通 | この相関を生んでいる原因は何か。その原因は続くか |
5. まとめ
相関は、複数の損益が一緒に動くかを測る便利な道具である。ただし、その数字は推定値で、測り方や局面で変わる。そして何より、相関は原因ではなく結果である。
相関は原因ではなく結果である。しかし市場の因果は完全には特定できない。だから、相関の背後にある原因について検証できる仮説を持ち、その原因が続いているかを見張り、仮説が外れても致命傷にならない設計をする。
相関を「当てにいく」のではなく、因果が分からないことを前提に設計する。これが相関とのつきあい方だと考えている。

次回は、資産の数が増えたときに相関行列がなぜノイズだらけになるのか(ランダム行列理論、縮小推定、HRP)を扱いたい。
参考文献
- Granger, C.W.J. & Newbold, P. (1974) Spurious Regressions in Econometrics. Journal of Econometrics, 2, 111–120.
- Embrechts, P., McNeil, A. & Straumann, D. (1999) Correlation and Dependence in Risk Management: Properties and Pitfalls.
- Jorion, P. (2000) Risk Management Lessons from Long-Term Capital Management. European Financial Management, 6(3), 277–300.
- Longin, F. & Solnik, B. (2001) Extreme Correlation of International Equity Markets. Journal of Finance, 56(2), 649–676.
- Forbes, K. & Rigobon, R. (2002) No Contagion, Only Interdependence: Measuring Stock Market Comovements. Journal of Finance, 57(5).
- Leinweber, D. (2007) Stupid Data Miner Tricks: Overfitting the S&P 500. The Journal of Investing.
- Alexander, C. Optimal Hedging Using Cointegration.
- Molenaar, R., Senechal, E., Swinkels, L. & Wang, Z. (2023) Empirical Evidence on the Stock-Bond Correlation.
- López de Prado, M. (2023) Causal Factor Investing: Can Factor Investing Become Scientific? Cambridge University Press.
- IMF Blog (2022) Crypto Prices Move More in Sync With Stocks, Posing New Risks
- Motley Fool (2023) 2022 was the worst year since 1937 for this investing strategy
- Harvard D3: LTCM: Intelligence and Investment Returns are Not Highly Correlated
- Salmon, F. (2009) Recipe for Disaster: The Formula That Killed Wall Street (Wired)
- PayPay証券(2024)8月5日の相場
- New York Times (2006) Amaranth's Trade(2006年10月2日の訂正を含む)
- Econbrowser (2006) Amaranth hedge fund losses
- マネックス証券(2026年7月)NT倍率に関する解説
付録:コード
本文の図1〜5とスライド内の数値は、シミュレーション(sim_figures.py、乱数シード固定)と実データ(real_data_checks.py、注意点5の数値)で計算した。実データはyfinanceで取得した日経平均・S&P500・ドル円・米国7-10年債ETF(IEF)の終値で、期間は2005年1月〜2025年12月30日である。
sim_figures.py(シミュレーション)
"""
相関係数を信じる前に ― シミュレーション図の生成スクリプト

使い方:
    pip install numpy matplotlib
    python sim_figures.py
出力:
    ./figures/ 以下にPNGを保存し、本文で使う数字を表示する(乱数シードは固定)。
"""
import os

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np

# ---------------------------------------------------------------- 見た目の設定
# 日本語フォントは環境にあるものを順に使う(Windows: Yu Gothic / Meiryo, Mac: Hiragino)
plt.rcParams["font.family"] = ["Noto Sans CJK JP", "Hiragino Sans", "Yu Gothic", "Meiryo",
                               "IPAexGothic", "sans-serif"]
plt.rcParams["axes.unicode_minus"] = False
SURFACE, INK, INK2, MUTED = "#fcfcfb", "#0b0b0b", "#52514e", "#898781"
GRID, AXIS = "#e1e0d9", "#c3c2b7"
BLUE, ORANGE = "#2a78d6", "#eb6834"
plt.rcParams.update({
    "figure.facecolor": SURFACE, "axes.facecolor": SURFACE, "savefig.facecolor": SURFACE,
    "axes.edgecolor": AXIS, "axes.labelcolor": INK2, "xtick.color": MUTED, "ytick.color": MUTED,
    "axes.grid": True, "grid.color": GRID, "grid.linewidth": 0.6,
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.titlesize": 12, "axes.titleweight": "bold", "axes.titlecolor": INK,
    "axes.labelsize": 10, "legend.frameon": False, "legend.fontsize": 9,
    "lines.linewidth": 1.6,
})
OUT = "figures"
os.makedirs(OUT, exist_ok=True)
rng = np.random.default_rng(2026)


def save(name):
    plt.tight_layout()
    plt.savefig(os.path.join(OUT, name), dpi=160)
    plt.close()


def corr2(rho, n):
    L = np.linalg.cholesky([[1, rho], [rho, 1]])
    return rng.standard_normal((n, 2)) @ L.T


# ---------------------------------------------------------------- 図S0 分散の効果
rhos = np.linspace(-1, 1, 201)
ratio = np.sqrt((1 + rhos) / 2)  # 同じボラの2資産を半々に持ったときのボラ / 1資産のボラ
fig, ax = plt.subplots(figsize=(6.4, 4))
ax.plot(rhos, ratio * 100, color=BLUE)
for r in [0.9, 0.5, 0.0]:
    y = np.sqrt((1 + r) / 2) * 100
    ax.plot([r], [y], "o", color=BLUE, ms=6, mec=SURFACE, mew=1.5)
    ax.annotate(f"相関{r:.1f} → {y:.0f}%", (r, y), xytext=(-8, 10), textcoords="offset points",
                ha="right", color=INK2, fontsize=9)
ax.set_xlabel("2資産の相関")
ax.set_ylabel("ポートフォリオのボラ(1資産を100%とする)")
ax.set_title("同じボラの2資産を半々に持つと、リスクは相関で決まる")
ax.set_ylim(0, 105)
save("s0_diversification.png")

# ---------------------------------------------------------------- 図S1 価格ではなくリターン
# 日々の対数リターン(ボラ1%)を互いに独立に作り、それを積み上げて価格にする。
# 価格水準の相関と、価格から計算し直したリターンの相関を比べる。
T, N = 1000, 2000
lv, rt = np.empty(N), np.empty(N)
example = None
for i in range(N):
    r = rng.standard_normal((T, 2)) * 0.01           # 独立な日次対数リターン
    price = 100 * np.exp(np.cumsum(r, axis=0))        # リターンを積み上げた価格
    ret = np.diff(np.log(price), axis=0)              # 価格から計算したリターン
    lv[i] = np.corrcoef(price.T)[0, 1]
    rt[i] = np.corrcoef(ret.T)[0, 1]
    if example is None and lv[i] > 0.8:
        example = (price, lv[i], rt[i])
share05 = (np.abs(lv) > 0.5).mean()
print(f"[S1] 価格水準の|相関|>0.5: {share05:.1%}, 中央値 {np.median(np.abs(lv)):.2f}, "
      f"リターン相関の95%範囲 [{np.percentile(rt, 2.5):.3f}, {np.percentile(rt, 97.5):.3f}]")
fig, ax = plt.subplots(1, 2, figsize=(11, 4))
price, c_lv, c_rt = example
ax[0].plot(price[:, 0], color=BLUE, label="資産A")
ax[0].plot(price[:, 1], color=ORANGE, label="資産B")
ax[0].set_title(f"無関係な2本:価格の相関 {c_lv:.2f}/リターンの相関 {c_rt:.2f}")
ax[0].set_xlabel("日"); ax[0].set_ylabel("価格(開始時=100)"); ax[0].legend(loc="upper left")
bins = np.linspace(0, 1, 41)
ax[1].hist(np.abs(lv), bins=bins, color=BLUE, alpha=0.85, label="価格水準の相関")
ax[1].hist(np.abs(rt), bins=bins, color=ORANGE, alpha=0.85, label="リターンの相関")
ax[1].set_title(f"2,000回の試行:価格の|相関|が0.5超は{share05:.0%}")
ax[1].set_xlabel("相関の絶対値"); ax[1].set_ylabel("回数"); ax[1].legend()
save("s1_random_walk.png")

# ---------------------------------------------------------------- 図S2 推定値は揺れる・選ぶと過小評価
K, T2, R = 50, 60, 2000
rho = 0.3
ins, oos = np.empty(R), np.empty(R)
for i in range(R):
    m = rng.standard_normal(2 * T2)
    x = rho * m[:, None] + np.sqrt(1 - rho ** 2) * rng.standard_normal((2 * T2, K))
    c_in = np.array([np.corrcoef(m[:T2], x[:T2, k])[0, 1] for k in range(K)])
    k = c_in.argmin()
    ins[i], oos[i] = c_in[k], np.corrcoef(m[T2:], x[T2:, k])[0, 1]
print(f"[S2] 候補{K}個(真の相関0.3)から最小を選ぶ: 選んだ時点 平均{ins.mean():.2f} → 次の期間 平均{oos.mean():.2f}")
for n in [60, 250, 1250]:
    est = [np.corrcoef(corr2(0.3, n).T)[0, 1] for _ in range(5000)]
    print(f"[S2] 真の相関0.3, {n}本: 95%範囲 [{np.percentile(est, 2.5):.2f}, {np.percentile(est, 97.5):.2f}]")
x = corr2(0.3, 252 * 20)
roll = np.array([np.corrcoef(x[i - 252:i].T)[0, 1] for i in range(252, len(x) + 1)])
print(f"[S2] 20年間ずっと相関0.3でも、1年ローリング相関は {roll.min():.2f}〜{roll.max():.2f}")

fig, ax = plt.subplots(1, 2, figsize=(11, 4))
bins = np.linspace(-0.4, 0.8, 49)
ax[0].hist(ins, bins=bins, color=BLUE, alpha=0.85, label=f"選んだ時点(平均{ins.mean():.2f})")
ax[0].hist(oos, bins=bins, color=ORANGE, alpha=0.85, label=f"次の60か月(平均{oos.mean():.2f})")
ax[0].axvline(0.3, color=INK2, lw=1, ls="--")
ax[0].annotate("真の相関0.3", (0.3, ax[0].get_ylim()[1] * 0.9), xytext=(6, 0),
               textcoords="offset points", color=INK2, fontsize=9)
ax[0].set_title("候補50個から「一番相関が低いもの」を選ぶと")
ax[0].set_xlabel("相関"); ax[0].set_ylabel("回数"); ax[0].legend(loc="upper right", bbox_to_anchor=(1, 0.86))
yrs = np.arange(len(roll)) / 252 + 1
ax[1].plot(yrs, roll, color=BLUE, lw=1.2)
ax[1].axhline(0.3, color=INK2, lw=1, ls="--")
ax[1].set_title(f"相関がずっと0.3でも、1年ローリングは{roll.min():.2f}〜{roll.max():.2f}を動く")
ax[1].set_xlabel("年"); ax[1].set_ylabel("1年ローリング相関"); ax[1].set_ylim(0, 0.6)
save("s2_estimation.png")

# ---------------------------------------------------------------- 図S3 切り出し方の罠
s = corr2(0.5, 2_000_000)
a, b = s[:, 0], s[:, 1]
c = lambda msk: np.corrcoef(a[msk], b[msk])[0, 1]
rows = [
    ("全期間", c(np.ones_like(a, bool))),
    ("Aが大きく動いた日だけ(上位10%)", c(np.abs(a) > np.quantile(np.abs(a), 0.9))),
    ("Aが静かな日だけ(下位50%)", c(np.abs(a) < np.quantile(np.abs(a), 0.5))),
    ("Aが下落した日だけ(下位10%)", c(a < np.quantile(a, 0.1))),
    ("A・Bとも−1σ未満の日だけ", c((a < -1) & (b < -1))),
]
for k, v in rows:
    print(f"[S3] {k}: {v:.2f}")
fig, ax = plt.subplots(figsize=(8, 3.6))
labels = [r[0] for r in rows][::-1]
vals = [r[1] for r in rows][::-1]
ax.barh(labels, vals, color=BLUE, height=0.55)
for y, v in enumerate(vals):
    ax.annotate(f"{v:.2f}", (v, y), xytext=(4, 0), textcoords="offset points", va="center",
                color=INK, fontsize=10)
ax.axvline(0.5, color=INK2, lw=1, ls="--")
ax.set_xlim(0, 0.9); ax.grid(axis="y", visible=False)
ax.set_title("真の相関は0.5のまま。切り出し方だけで、測れる相関が変わる")
ax.set_xlabel("測れた相関")
save("s3_slicing.png")

# ---------------------------------------------------------------- 図S4 同じ相関でも、同時に大きな損失が出る確率は異なる
n = 2_000_000
g = corr2(0.5, n)
t = corr2(0.5, n) * np.sqrt(3 / rng.chisquare(3, n))[:, None]
res = {}
for name, z in [("正規分布", g), ("t分布(自由度3)", t)]:
    q = np.quantile(z, 0.01, axis=0)
    res[name] = (np.corrcoef(z.T)[0, 1], ((z[:, 0] < q[0]) & (z[:, 1] < q[1])).mean() / 0.01, q)
    print(f"[S4] {name}: 相関 {res[name][0]:.2f}, Aが最悪1%の日にBも最悪1% {res[name][1]:.0%}")
xx = rng.standard_normal(100_000)
yy = xx ** 2 + 0.3 * rng.standard_normal(100_000)
cu = np.corrcoef(xx, yy)[0, 1]
print(f"[S4] U字型の関係: 相関 {cu:.2f}")

# 図S4:正規分布とt分布の比較(同時に大きな損失が出る確率)
fig, ax = plt.subplots(1, 2, figsize=(10, 4.4))
for i, (name, z) in enumerate([("正規分布", g), ("t分布(自由度3)", t)]):
    zz = z[:4000] / z[:, 0].std()
    q = res[name][2] / z[:, 0].std()
    ax[i].scatter(zz[:, 0], zz[:, 1], s=3, color=BLUE, alpha=0.5, linewidths=0)
    ax[i].axvline(q[0], color=ORANGE, lw=1); ax[i].axhline(q[1], color=ORANGE, lw=1)
    ax[i].set_xlim(-6, 6); ax[i].set_ylim(-6, 6)
    ax[i].set_title(f"{name}:相関{res[name][0]:.2f}\nAが最悪1%の日に、Bも最悪1%に入る確率 {res[name][1]:.0%}")
    ax[i].set_xlabel("資産A(標準化)"); ax[i].set_ylabel("資産B(標準化)")
fig.text(0.5, 0.005, "オレンジの線:各資産の最悪1%の水準。左下の領域が「同時に大きな損失」",
         ha="center", va="bottom", color=INK2, fontsize=9)
plt.tight_layout(rect=(0, 0.04, 1, 1))
plt.savefig(os.path.join(OUT, "s4_joint_loss.png"), dpi=160)
plt.close()

# 図S4b:U字型の関係(補足)
fig, ax = plt.subplots(figsize=(5.6, 4.2))
ax.scatter(xx[:4000], yy[:4000], s=3, color=BLUE, alpha=0.5, linewidths=0)
ax.set_title(f"U字型の関係:相関{cu:.2f}\n(はっきりした関係があるのに相関はほぼゼロ)")
ax.set_xlabel("X"); ax.set_ylabel("Y")
save("s4b_u_shape.png")

# ---------------------------------------------------------------- 図S6 ペアトレード
def make_pair(coint, T=2520):
    f = rng.standard_normal(T) * 0.01
    if coint:
        sp = np.zeros(T)
        for i in range(1, T):
            sp[i] = 0.98 * sp[i - 1] + rng.standard_normal() * 0.0032
    else:
        sp = np.cumsum(rng.standard_normal(T) * 0.0032)
    # pa, pb は対数価格。差分 np.diff は日次の対数リターン、pa - pb は対数価格比になる
    pa, pb = np.cumsum(f) + sp / 2, np.cumsum(f) - sp / 2
    return np.corrcoef(np.diff(pa), np.diff(pb))[0, 1], pa - pb


def mean_reversion(spread, look=60, z_in=2.0, z_out=0.5):
    """スプレッドのzスコアが±2を超えたら逆張りし、±0.5以内で手仕舞う"""
    pos, eq, path = 0, 0.0, []
    for i in range(look, len(spread) - 1):
        w = spread[i - look:i]
        z = (spread[i] - w.mean()) / w.std()
        if pos == 0 and abs(z) > z_in:
            pos = -np.sign(z)
        elif pos != 0 and abs(z) < z_out:
            pos = 0
        eq += pos * (spread[i + 1] - spread[i])
        path.append(eq)
    path = np.array(path)
    return path, np.max(np.maximum.accumulate(path) - path)


summ = {}
paths = {}
for coint, label in [(True, "共和分あり"), (False, "共和分なし")]:
    cs, fin, dd = [], [], []
    for j in range(300):
        cc, sp = make_pair(coint)
        path, mdd = mean_reversion(sp)
        cs.append(cc); fin.append(path[-1]); dd.append(mdd)
        if j < 30:
            paths.setdefault(label, []).append(path)
    summ[label] = (np.mean(cs), np.mean(np.array(fin) < 0), np.median(dd), np.array(fin))
    print(f"[S6] {label}: 日次リターン相関 {np.mean(cs):.2f}, 損失で終わった割合 {summ[label][1]:.0%}, "
          f"最大DDの中央値 {summ[label][2]:.3f}")
print(f"[S6] 最大DDの中央値の比(なし/あり): {summ['共和分なし'][2] / summ['共和分あり'][2]:.1f}倍")

fig, ax = plt.subplots(1, 2, figsize=(11, 4), sharey=True)
for i, (label, col) in enumerate([("共和分あり", BLUE), ("共和分なし", ORANGE)]):
    for pth in paths[label]:
        ax[i].plot(np.arange(len(pth)) / 252, pth, color=col, lw=0.8, alpha=0.6)
    ax[i].axhline(0, color=AXIS, lw=1)
    ax[i].set_title(f"{label}(日次リターン相関{summ[label][0]:.2f})\n損失で終わった割合 {summ[label][1]:.0%}")
    ax[i].set_xlabel("年")
ax[0].set_ylabel("累積損益(スプレッドの値幅)")
save("s6_pairs.png")
print("saved to", OUT)
real_data_checks.py(実データ)
"""
相関係数を信じる前に ― 実データの確認(注意点5)

使い方:
    pip install yfinance pandas numpy matplotlib
    python real_data_checks.py              # yfinanceから取得
    python real_data_checks.py --synthetic  # 合成データで動作確認だけ行う
出力:
    ./out/ に図を保存し、本文に入れる数字を表示する。
データ:
    ^N225 日経平均 / ^GSPC S&P500 / JPY=X ドル円 / IEF 米国7-10年債ETF
    期間は2005年1月〜2025年12月。yfinanceのendは当日を含まないため、実際の最終日は2025-12-30。
    (日経平均ETF・TOPIX ETFは、yfinanceの調整後価格に不整合があったため使わない)
"""
import argparse
import os

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

plt.rcParams["font.family"] = ["Noto Sans CJK JP", "Hiragino Sans", "Yu Gothic", "Meiryo",
                               "IPAexGothic", "sans-serif"]
plt.rcParams["axes.unicode_minus"] = False
BLUE = "#2a78d6"
START, END = "2005-01-01", "2025-12-31"
TICKERS = ["^N225", "^GSPC", "JPY=X", "IEF"]
OUT = "out"


def load(synthetic):
    if synthetic:  # 動作確認用(結果に意味はない)
        rng = np.random.default_rng(0)
        idx = pd.bdate_range(START, END)
        z = rng.standard_normal((len(idx), len(TICKERS))) * 0.01
        return pd.DataFrame(100 * np.exp(np.cumsum(z, axis=0)), index=idx, columns=TICKERS)
    import yfinance as yf
    return yf.download(TICKERS, start=START, end=END, auto_adjust=True, progress=False)["Close"]


def r(s):
    return np.log(s.dropna()).diff().dropna()


def corr(a, b):
    j = pd.concat([a, b], axis=1, join="inner").dropna()
    return float(j.iloc[:, 0].corr(j.iloc[:, 1]))


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--synthetic", action="store_true")
    px = load(ap.parse_args().synthetic)
    os.makedirs(OUT, exist_ok=True)
    wk = px.resample("W-FRI").last()
    mo = px.resample("ME").last()

    # 注意点5:時差 ― 日本の営業日に、それより前に終わった直近の米国セッションを対応させる
    jp, us = r(px["^N225"]), r(px["^GSPC"])
    a = pd.DataFrame({"date": jp.index, "jp": jp.values})
    b = pd.DataFrame({"date": us.index, "us": us.values})
    lag = pd.merge_asof(a, b, on="date", allow_exact_matches=False).dropna()
    res5 = {
        "日次(同じ日付どうし)": corr(jp, us),
        "日次(日経の当日と前営業日のS&P)": float(lag["jp"].corr(lag["us"])),
        "週次": corr(r(wk["^N225"]), r(wk["^GSPC"])),
    }
    usd = corr(r(mo["^GSPC"]), r(mo["IEF"]))
    jpy = corr(r(mo["^GSPC"] * mo["JPY=X"]), r(mo["IEF"] * mo["JPY=X"]))

    plt.figure(figsize=(7, 4))
    vals = list(res5.values())
    labels = ["日次\n同じ日付", "日次\n前営業日の米国", "週次"]
    plt.bar(labels, vals, color=BLUE, width=0.5)
    for i, v in enumerate(vals):
        plt.annotate(f"{v:.2f}", (i, v), xytext=(0, 4), textcoords="offset points", ha="center")
    plt.title("日経平均×S&P500:測り方で相関が変わる(2005〜2025年)")
    plt.tight_layout(); plt.savefig(os.path.join(OUT, "real_measurement.png"), dpi=160); plt.close()

    print("期間:", px.index.min().date(), "〜", px.index.max().date())
    print("[注意点5] 日経平均×S&P500")
    for k, v in res5.items():
        print(f"  {k}: {v:.2f}")
    print(f"[注意点5] S&P500×米国債(月次): ドル建て {usd:.2f} / 円建て {jpy:.2f}")

if __name__ == "__main__":
    main()