

1600年前の「3分割」
今から約1600年前、4世紀のラビ、イサク・バル・アハは資産配分について次のような教えを残したとされている(バビロニア・タルムード)。
資産は常に3つに分けよ。1/3を土地に、1/3を商品に、1/3をすぐ使える形で。
DeMiguel, Garlappi, Uppal (2009, Review of Financial Studies、ワーキングペーパー版タイトルは "1/N") は、この一節から議論を始めている。
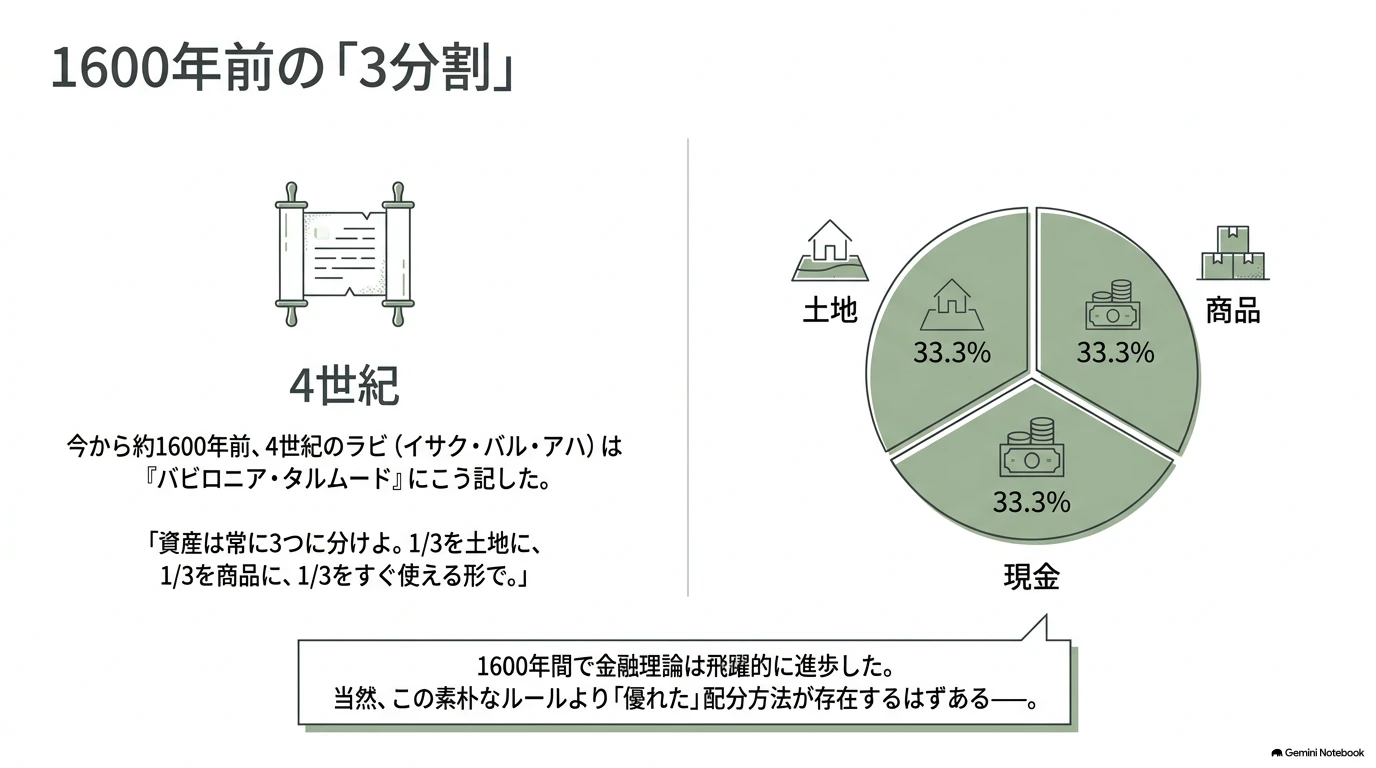
ここで素朴な疑問が浮かぶ。その後1600年も金融理論が発達したのだから、当然もっと優れた資産配分方法ができているはずではないのか。
この論文が扱っているのは、まさにその問いである。
現代金融工学の答え:平均分散最適化
1952年、Markowitzが平均分散法を提示した。各資産の期待リターン μ、ボラティリティ、そして資産間の共分散 Σ を使って、「同じリスクなら最もリターンが高い配分」を数学的に求める。考え方としては極めて合理的だ。
そして実際、真のパラメータが分かっているインサンプルでは、平均分散最適化は圧倒的に強い。
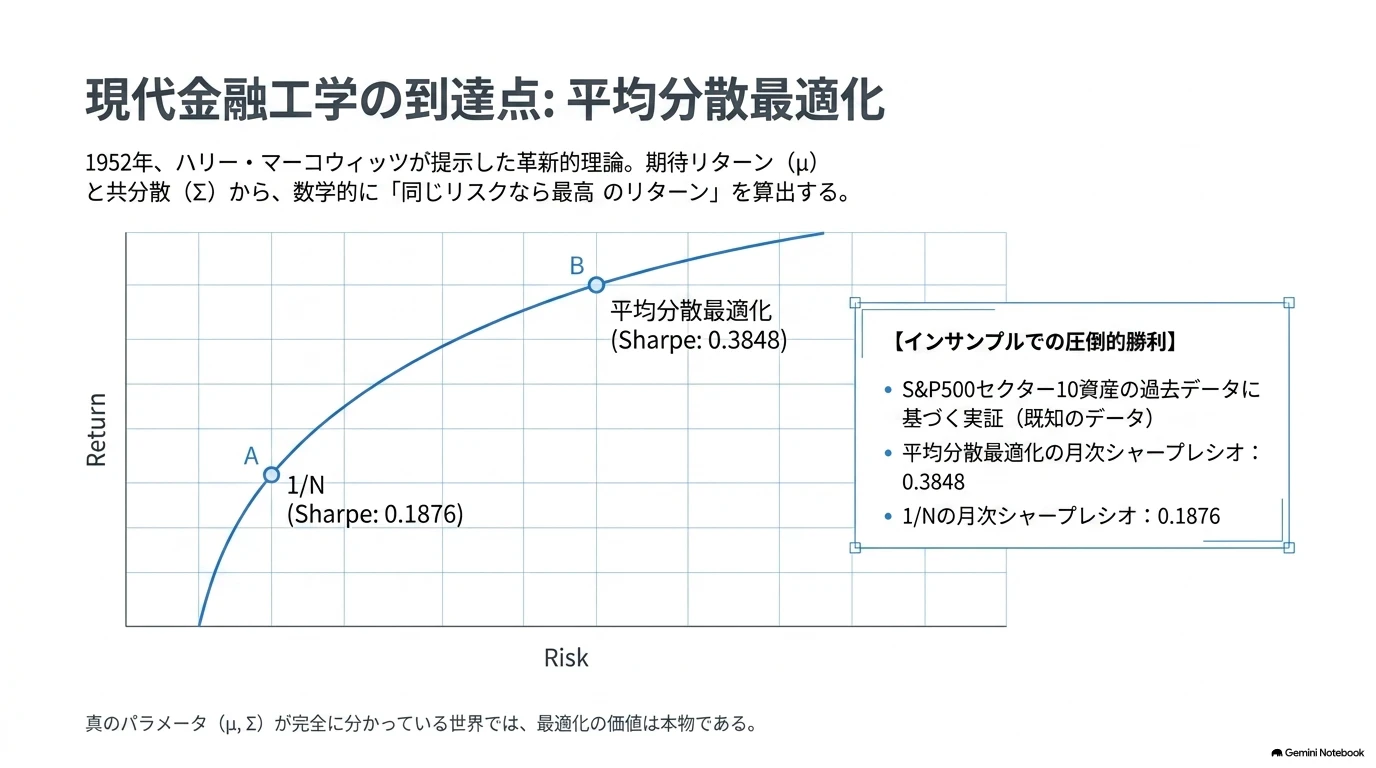
S&P500セクター10資産のデータでは、インサンプルの月次シャープレシオは平均分散が0.3848、1/Nは0.1876。倍以上の差がある。つまり「推定誤差がなければ」、最適化の価値は本物である。
問題は、誰も真の μ と Σ を知らないこと
Markowitzの理論が間違っているわけではない。問題は、将来の期待リターンと共分散を我々が知らない、という一点にある。
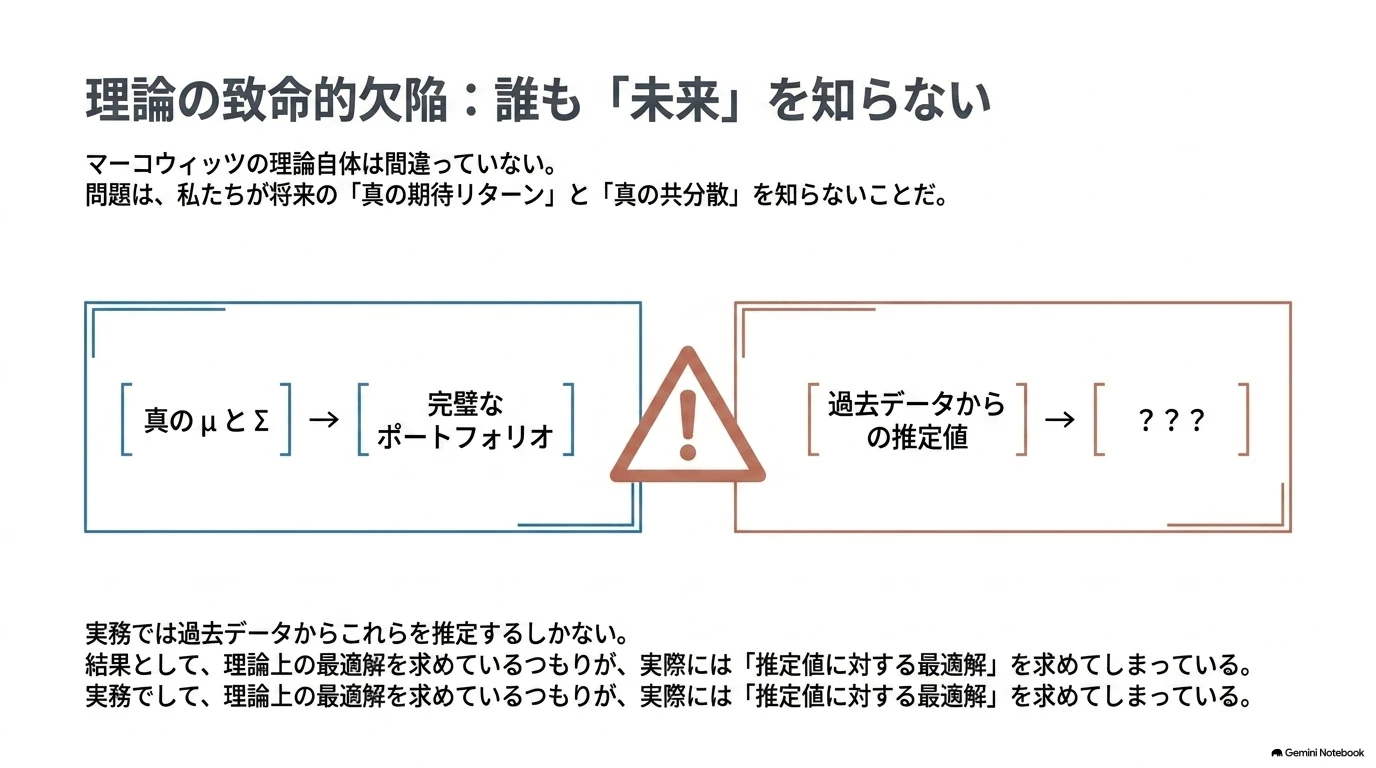
実務では過去データから推定する。したがって、
理論上の最適解を求めているつもりが、実際には「推定値に対する最適解」を求めている。
これが、この論文全体を貫く論点だと考えている。
最適化は「推定誤差」まで最適化してしまう
論文にある2資産の例が非常に分かりやすい。真の期待リターンは両方とも年8%、真のボラティリティは両方とも年20%、相関は0.99。2つの資産は実質的に同一なので、本来の最適配分は50:50である。
ところが、片方の期待リターンをたまたま 8% → 9% と推定してしまうと、平均分散最適化が出す答えは 資産1に+635%、資産2に−535% になる。

人間の目には「1%くらい推定を外しただけ」に見える。しかし最適化アルゴリズムから見れば、その1%は「利用すべき収益機会」である。そして最適化は、その差を最大限に利用しようとする。
つまり最適化は、エッジだけでなく推定誤差も増幅する。
しかも論文によれば、実データでのウェイトはこの例よりさらに極端になる。国際株式インデックスのデータでは、アウトオブサンプルの世界インデックスのウェイトが −80,009% から +256,461% の範囲で動いたと報告されている。もはやポートフォリオと呼べる状態ではない。
何も推定しない1/N
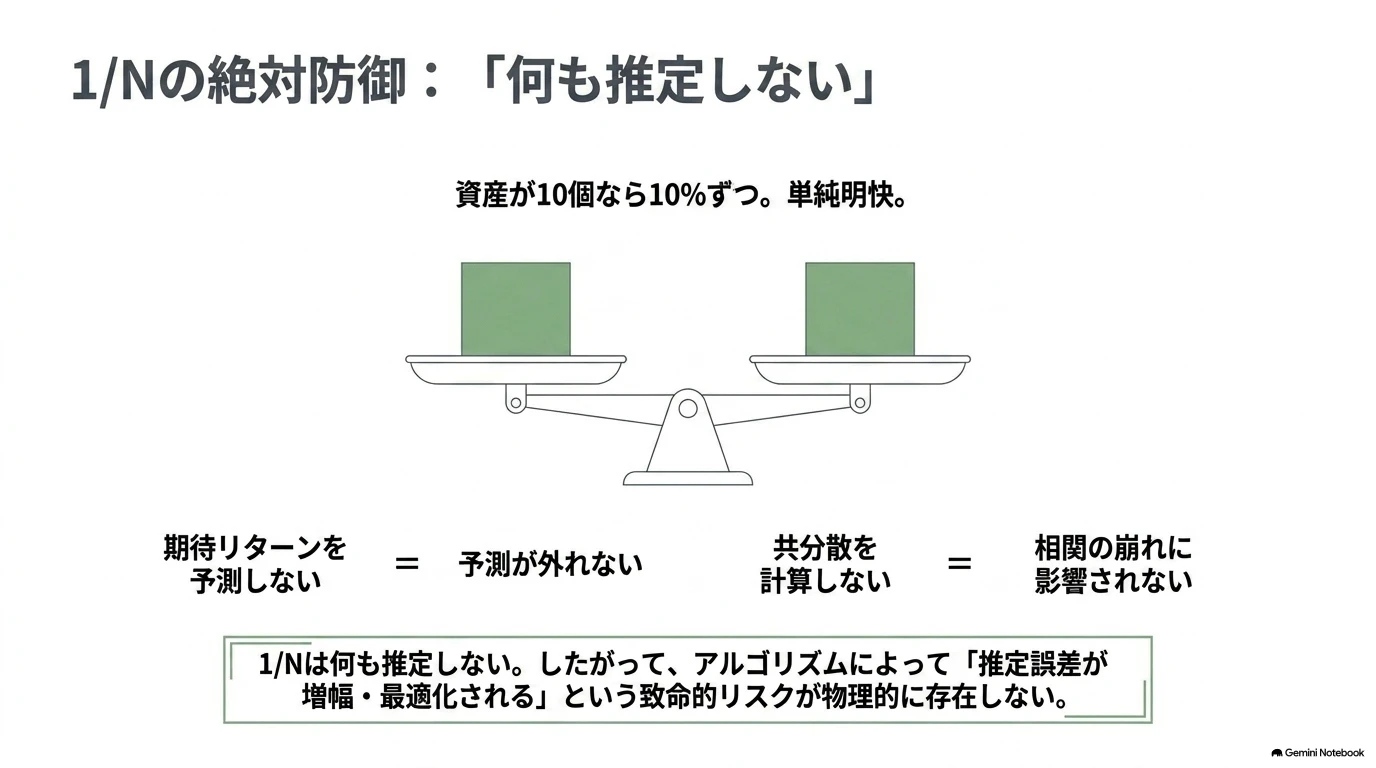
対する1/Nは極端に単純だ。資産が10個なら10%ずつ、20個なら5%ずつ。期待リターンも予測しない。共分散も最適化しない。
推定しないので、推定誤差も最適化しない。
14の最適化モデル vs 1/N
論文は、この1/Nをベンチマークとして、14種類の最適化モデル(サンプル平均分散、Bayes-Stein、Pástor流のData-and-Model、最小分散、MacKinlay-Pastor、空売り制約付き各種、Kan-Zhouの3ファンドなど)と7つの実証データセットで比較した。
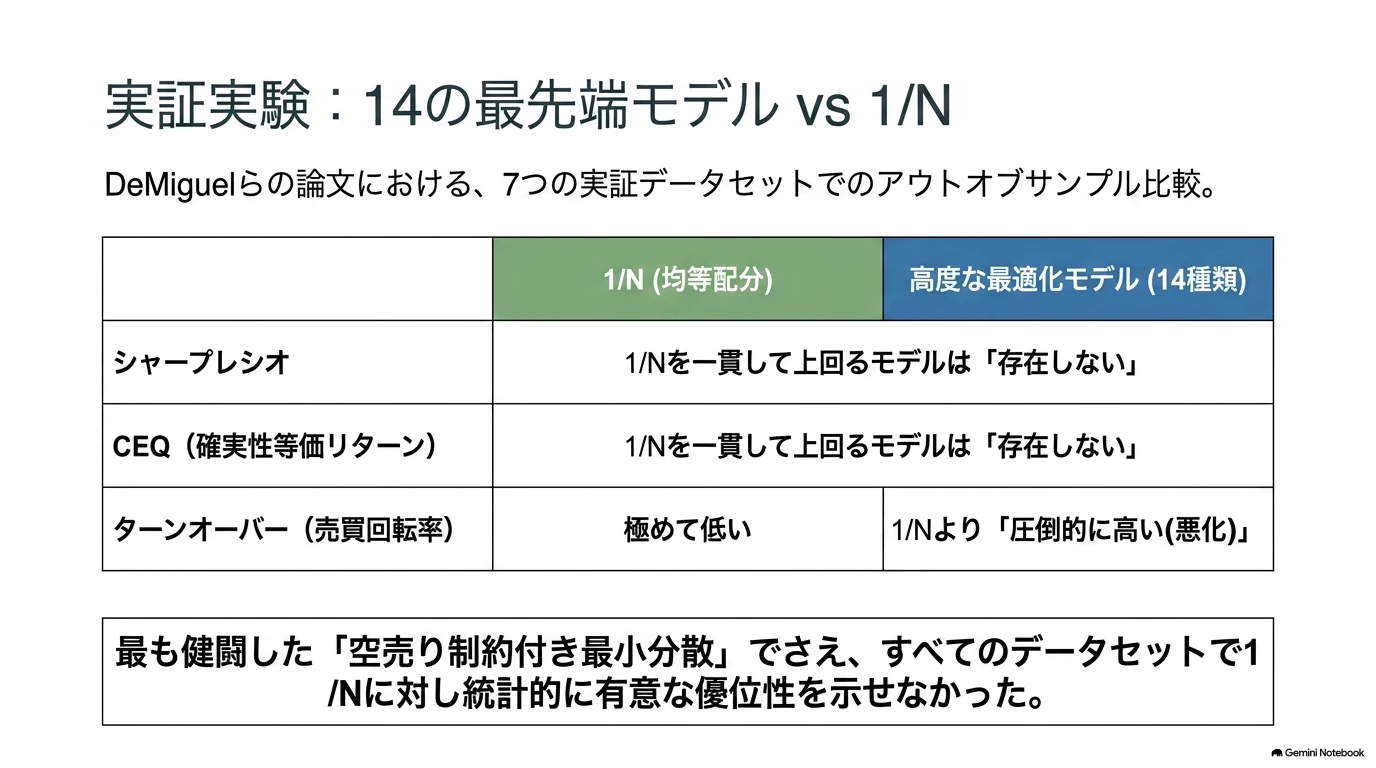
シャープレシオ、CEQ(確実性等価リターン)、ターンオーバーのすべてにおいて、1/Nを一貫して上回るモデルは存在しなかった。
最も成績が良かったのは空売り制約付き最小分散(Jagannathan and Ma 2003)だが、それでも7つのデータセットのどれにおいても1/Nに対して統計的に有意な優位を示せず、ターンオーバーは1/Nより高かった。
さらに驚くのは「必要なデータ量」
論文は、サンプル平均分散が1/NをCEQで上回るために必要な推定期間の長さを解析的に導出している。米国株式データにキャリブレーションした結果がこれである。

25資産で3,000か月超(約250年)、50資産で6,000か月超(約500年)。一方、実務で使われるのは通常60か月〜120か月である。
「500年分のデータがあれば最適化が機能する」と言われても、500年前には現代的な株式市場そのものが存在しない。この桁の乖離が、推定誤差問題の深刻さをよく表していると思う。
なお論文はシミュレーションでも、推定誤差対策として提案されてきた各種拡張モデル(ベイズ的手法、制約付き手法など)が、この必要推定期間をわずかしか短縮できないことを示している。
なぜ期待リターンの推定はこれほど難しいのか
論文が重視しているのは、共分散よりも期待リターンの推定誤差のほうが深刻という点である。

「来年の株式リターンは7.2%」という数字が、本当に7.2%なのか5%なのか10%なのか。これを当てるのは極めて難しい。一方、「資産Aと資産Bはかなり相関して動く」という構造は、期待リターンより相対的に安定して推定できる。
実際、期待リターンを完全に捨てて共分散だけを使う最小分散系の戦略のほうが、平均分散より安定していた。さらに、推定期間を6,000か月に延ばしても最小分散のパフォーマンスはほとんど改善しない。これも「誤差の主犯は平均の推定である」という解釈と整合する。
この論文の読み方を間違えないために
ここは重要なので明示しておきたい。この論文を「Markowitzは間違いだった」「1/Nが最強」と読むのは誤りである。著者自身がはっきり書いている。
1/Nをあらゆる状況における最良の資産配分戦略として推奨しているわけではなく、あくまで各種戦略の成否を測るベンチマークとして用いている。
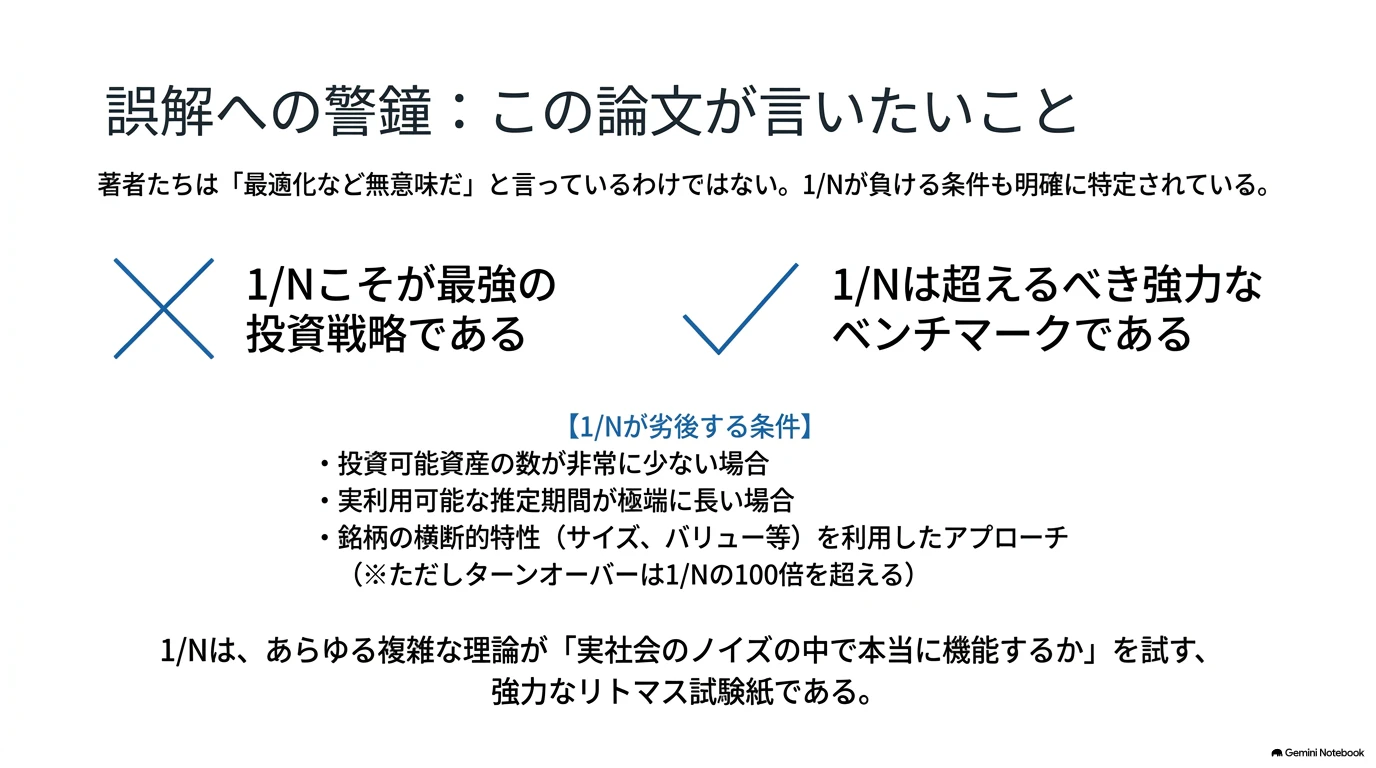
実際、論文は1/Nが負ける条件も特定している。投資可能資産の数が少ないとき、推定期間が長いとき、そして平均分散ポートフォリオの事前シャープレシオが1/Nより十分に高いときである。
また、リターンのモーメントだけでなく銘柄の横断的特性(サイズ、バリュー、モメンタム等)を使うBrandt, Santa-Clara, Valkanov (2005) 型のアプローチは、資産数が多い場合に1/Nを有意に上回った。ただしターンオーバーは1/Nの100倍を超える。
つまりメッセージは「最適化するな」ではなく、「理論上の最適化」ではなく「推定誤差を織り込んだ実現可能な最適化」を考えよ、ということだと考えている。
「最適なポートフォリオ」から「壊れにくいポートフォリオ」へ
問いを立て替えると分かりやすいと思う。

後者の視点に立つと、実務的な設計指針はこうなる。

論文でも、空売り制約や最小分散への制約によって推定誤差の影響がある程度抑えられることが示されている。空売り制約は、期待リターンをゼロ方向にシュリンクする効果を持つと解釈されている点が面白い。
おわりに
投資の世界では、「複雑であること」と「優れていること」は同じではない。より精密に予測し、より精密に最適化すればするほど良くなるとは限らない。なぜなら、私たちが最適化している数字そのものが間違っているかもしれないからだ。
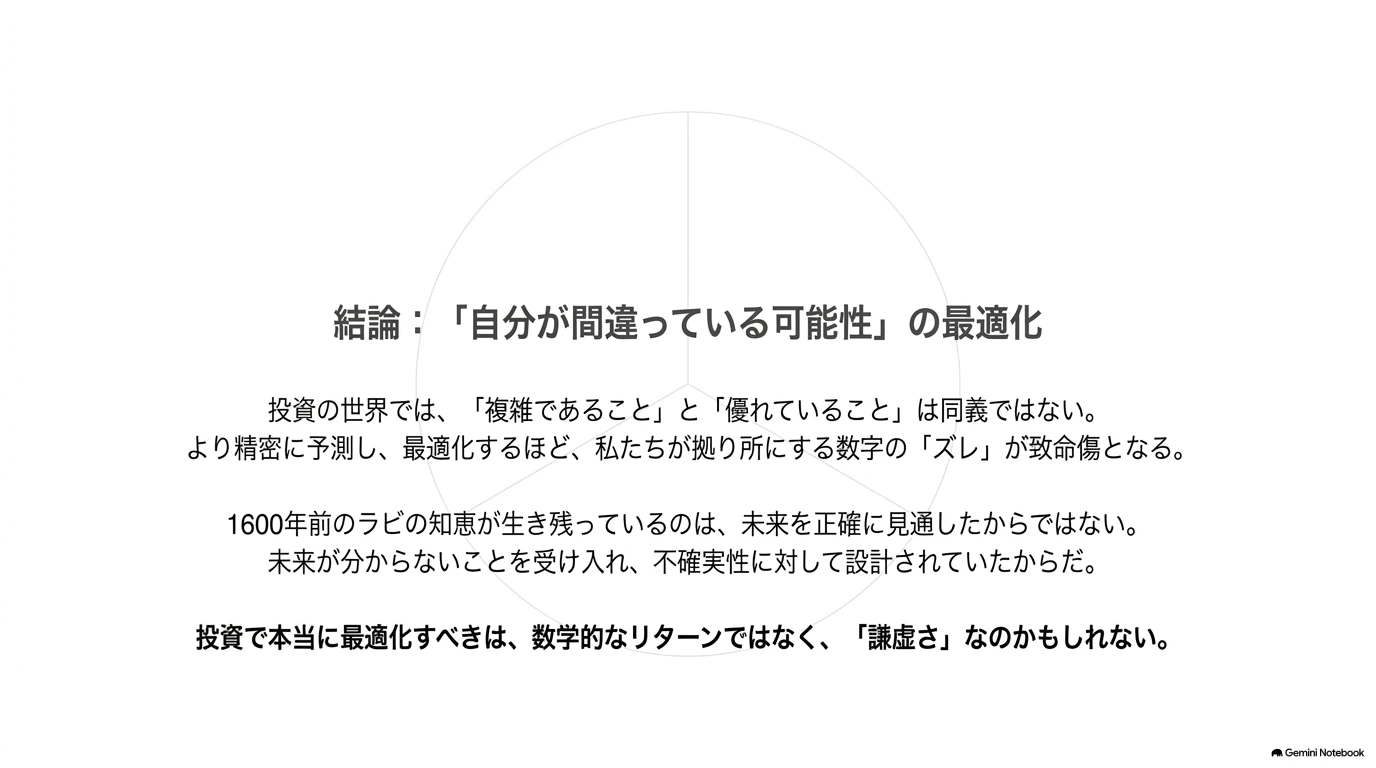
約1600年前のラビは、現代ポートフォリオ理論を知っていたわけではない。しかし「一つに賭けず、分けて持つ」という単純な知恵は、1600年後の金融工学に対しても、驚くほど手強いベンチマークとして残った。
DeMiguelらが示したのは「1/Nが最強」ということではない。未来を正確に推定できない以上、理論上もっとも美しいポートフォリオより、推定を外しても壊れないポートフォリオのほうが、現実には優れている場合がある——ということである。
投資で本当に最適化すべきなのは、リターンではなく、もしかすると「自分が間違っている可能性」なのかもしれない。
参考文献
- Victor DeMiguel, Lorenzo Garlappi, Raman Uppal, "Optimal Versus Naive Diversification: How Inefficient is the 1/N Portfolio Strategy?", Review of Financial Studies, 22(5), 2009(本記事はワーキングペーパー版 "1/N", June 2006 に基づく)
- Harry Markowitz, "Portfolio Selection", Journal of Finance, 7, 1952
- Ravi Jagannathan, Tongshu Ma, "Risk Reduction in Large Portfolios: Why Imposing the Wrong Constraints Helps", Journal of Finance, 58, 2003
- Michael Brandt, Pedro Santa-Clara, Rossen Valkanov, "Parametric Portfolio Policies: Exploiting Characteristics in the Cross Section of Equity Returns", 2005