
3年前のあの1枚は今どこに?
3年前に投稿した写真を、覚えていますか。もう見返すこともないその1枚は、今どこにあるのでしょうか。
Instagramには毎日1億枚を超える写真や動画が投稿され、蓄積された総数は何兆枚にのぼるといわれています。
この記事では、これだけの量の画像をどう保存し、必要なときにどう取り出し、壊れても失わないようにどう守っているか、大規模な画像ストレージで一般的に使われる設計の考え方として解説します。
↓同じ内容を動画でも解説しています。
https://www.youtube.com/channel/UClgdVrValAdR8gYSZ86DYEQ
1台には収まらないので分散し、IDで管理する
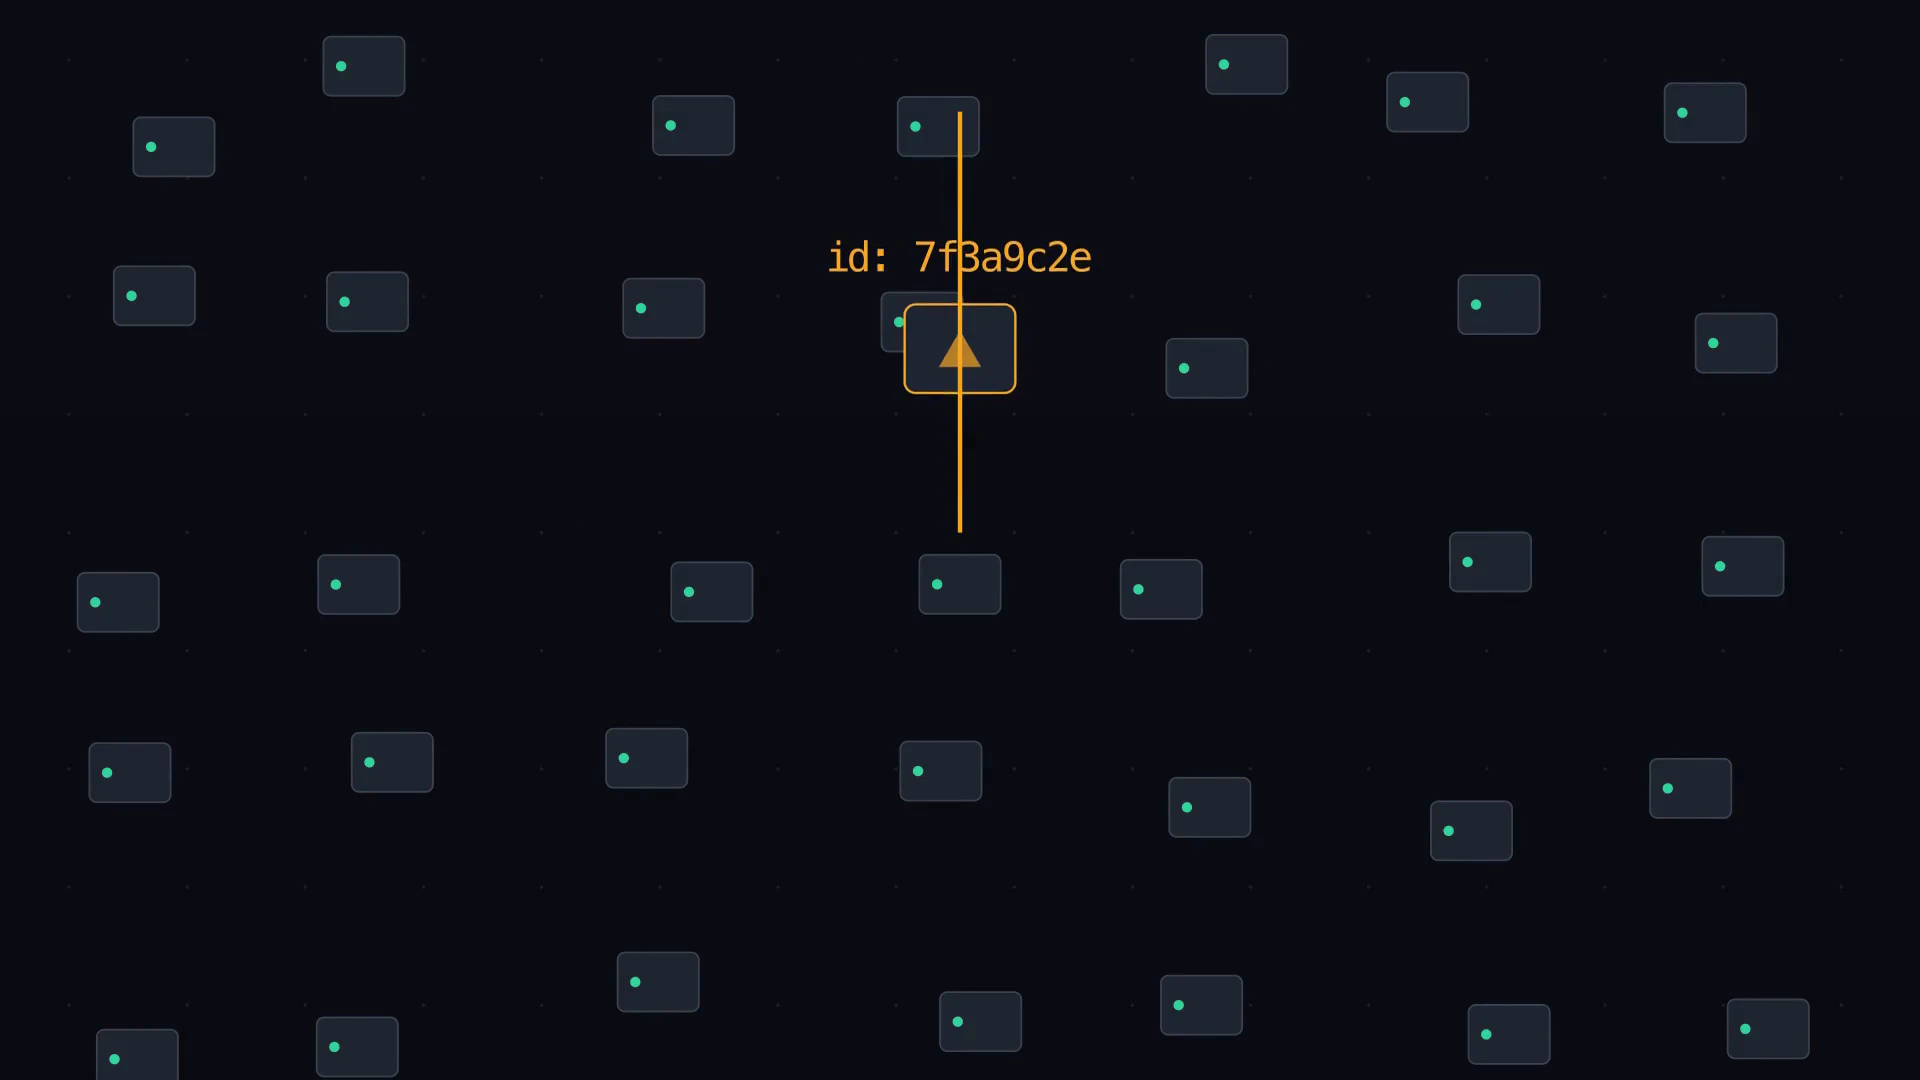
1台のディスク容量には上限があります。何兆枚もの画像を1台のサーバー、あるいは1つのデータベースに詰め込もうとすれば、すぐに容量が尽きます。だから、何十万台ものサーバーに分散して保存するしかありません。
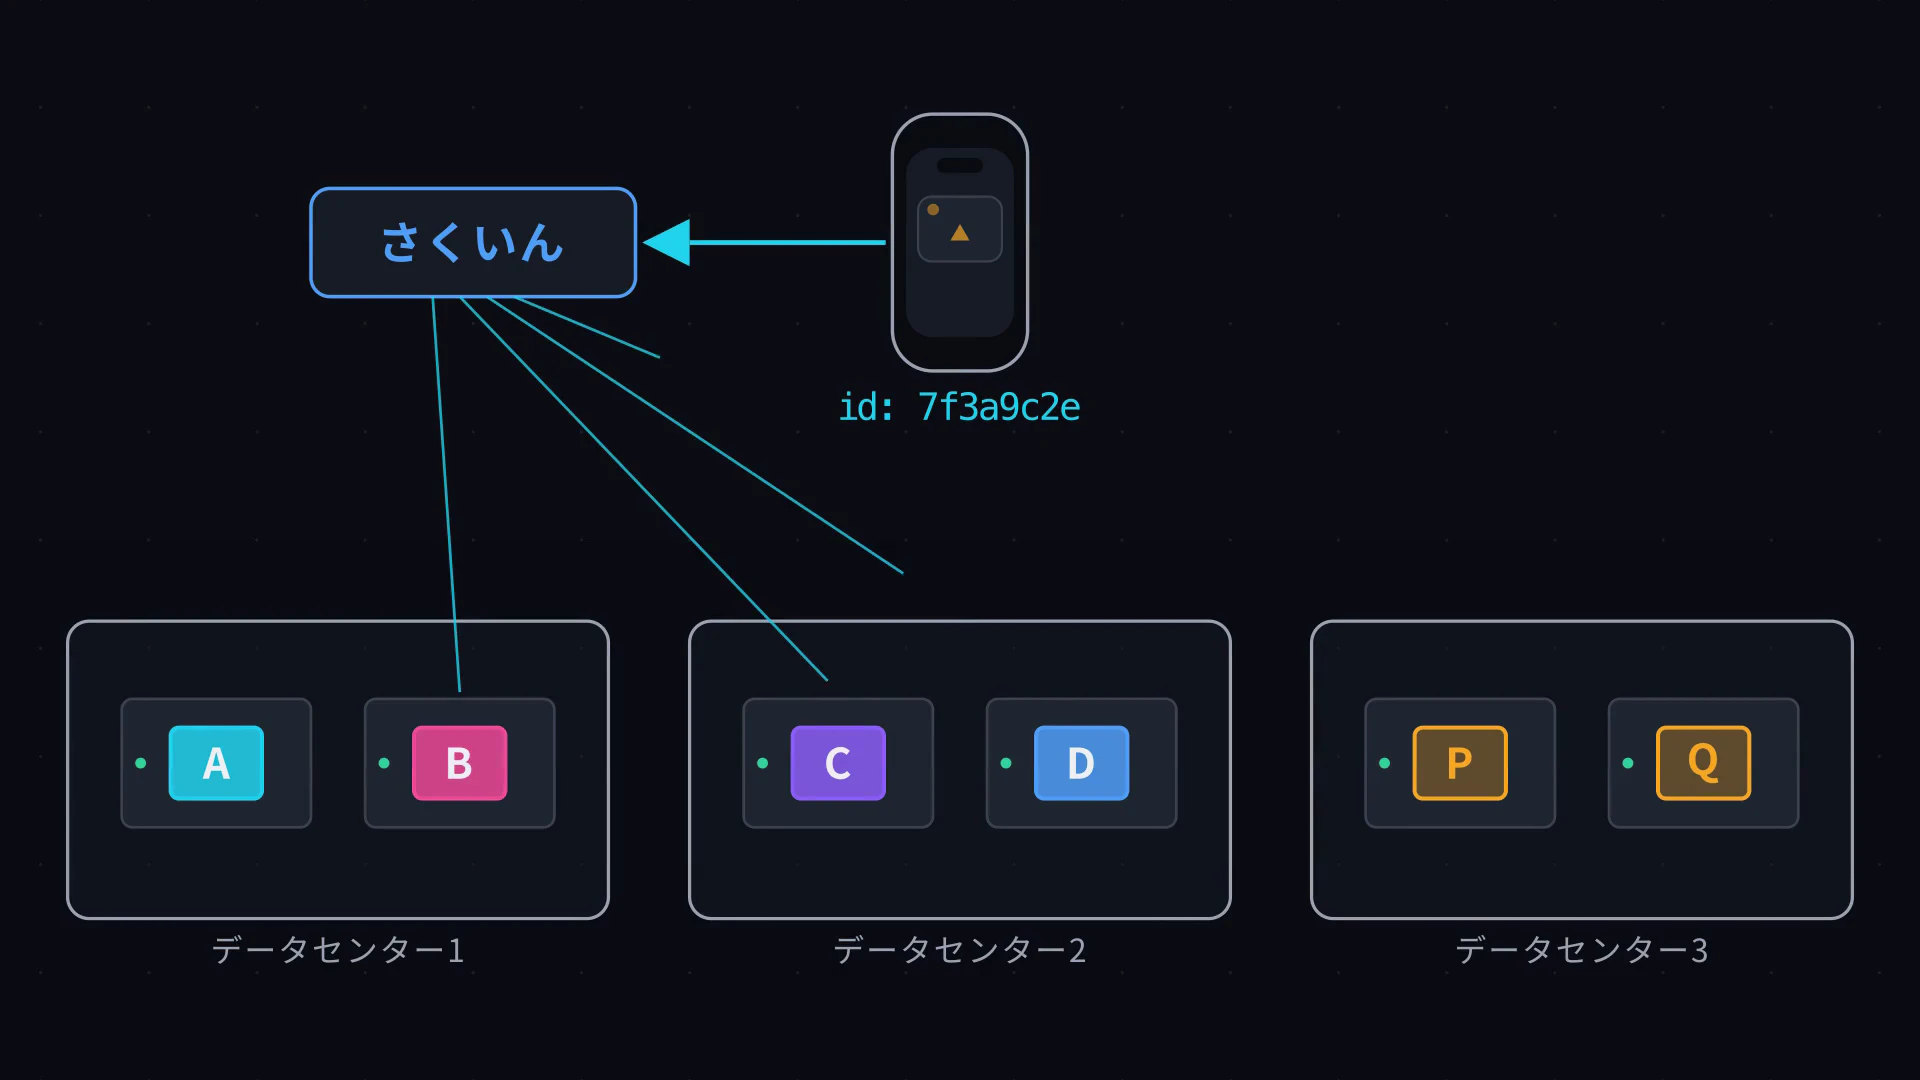
ただし、何十万台にも分散すると、「どのサーバーの、どこにあるか」という置き場所をいちいち把握してはいられません。そこで、置き場所ではなく、画像1枚ごとに振られたIDで管理します。IDさえ分かれば、実体が今どのサーバーにあっても取り出せます。
ファイルを1枚ずつ保存すると、メタデータの二度読みで遅くなる
分散した先の各サーバーでも、画像を1枚ずつ独立したファイルとして保存すると、別の問題にぶつかります。
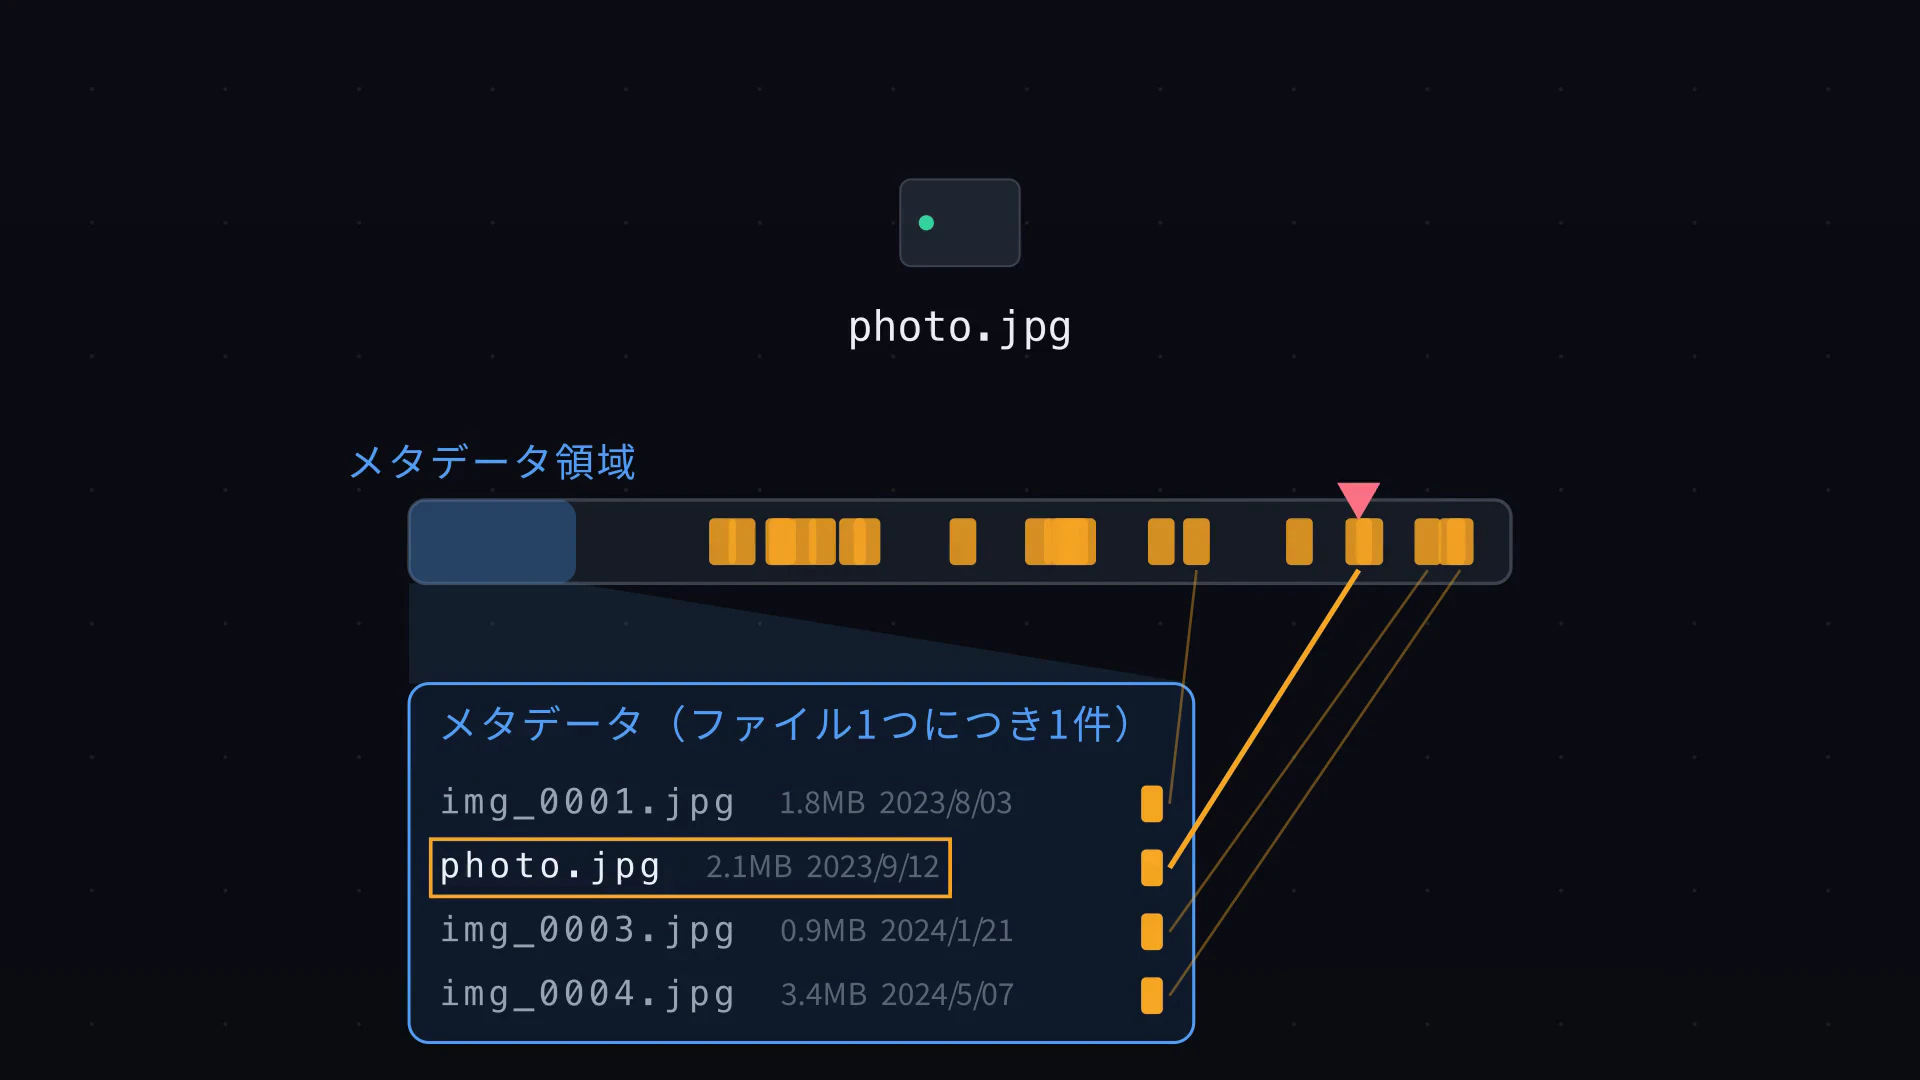
一般的なファイルシステムは、1つのファイルを読み出す際に、まずメタデータ(ファイルの場所やサイズなどの情報)を読みに行き、それから実データを読みに行きます。メタデータと実データはディスク上の別の場所にあり、実データの場所はメタデータを読むまで分からないため、この2回のアクセスは順番に行うしかありません。
画像の数が億単位になると、メタデータの総量も膨大になり、メモリに収まりきらなくなります。結果、読み出すたびにディスクからメタデータを読みに行くことになり、これが大きなボトルネックになります。
まとめて書き込み+メモリ上の索引
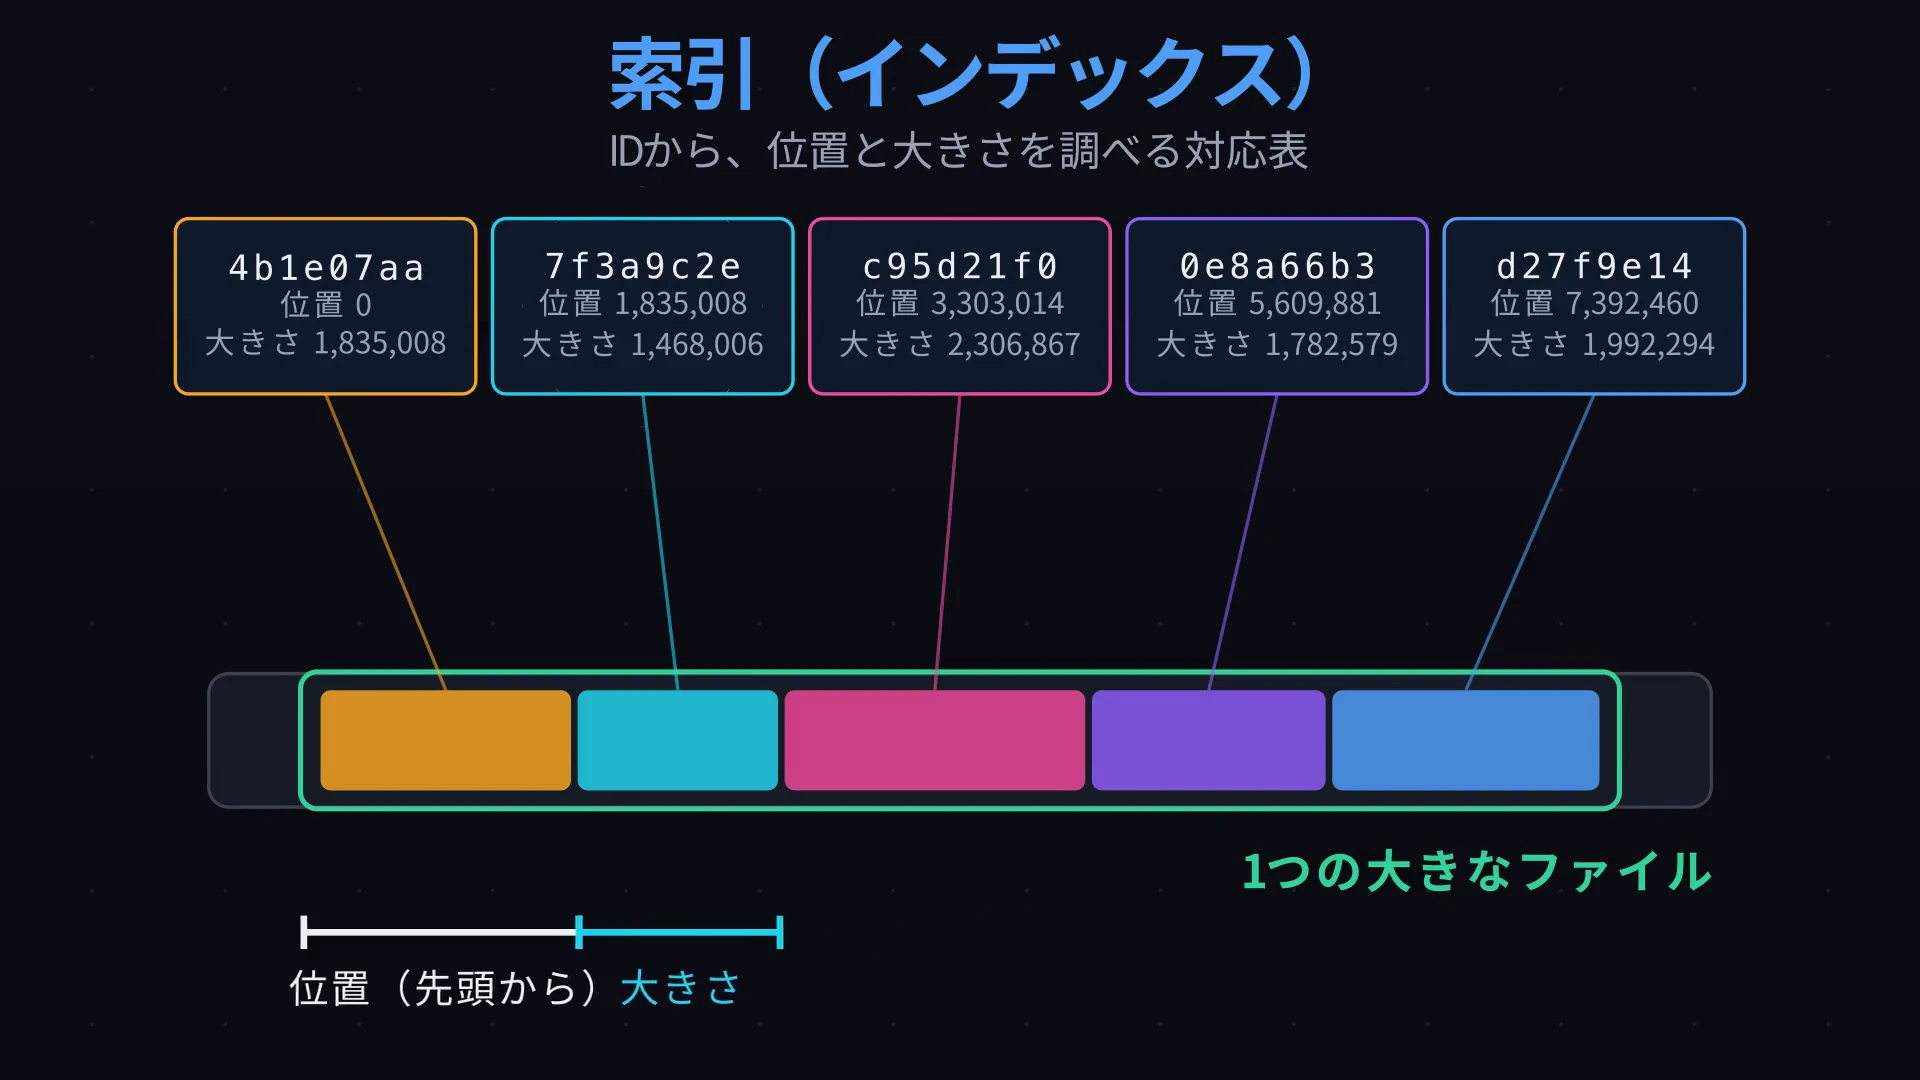
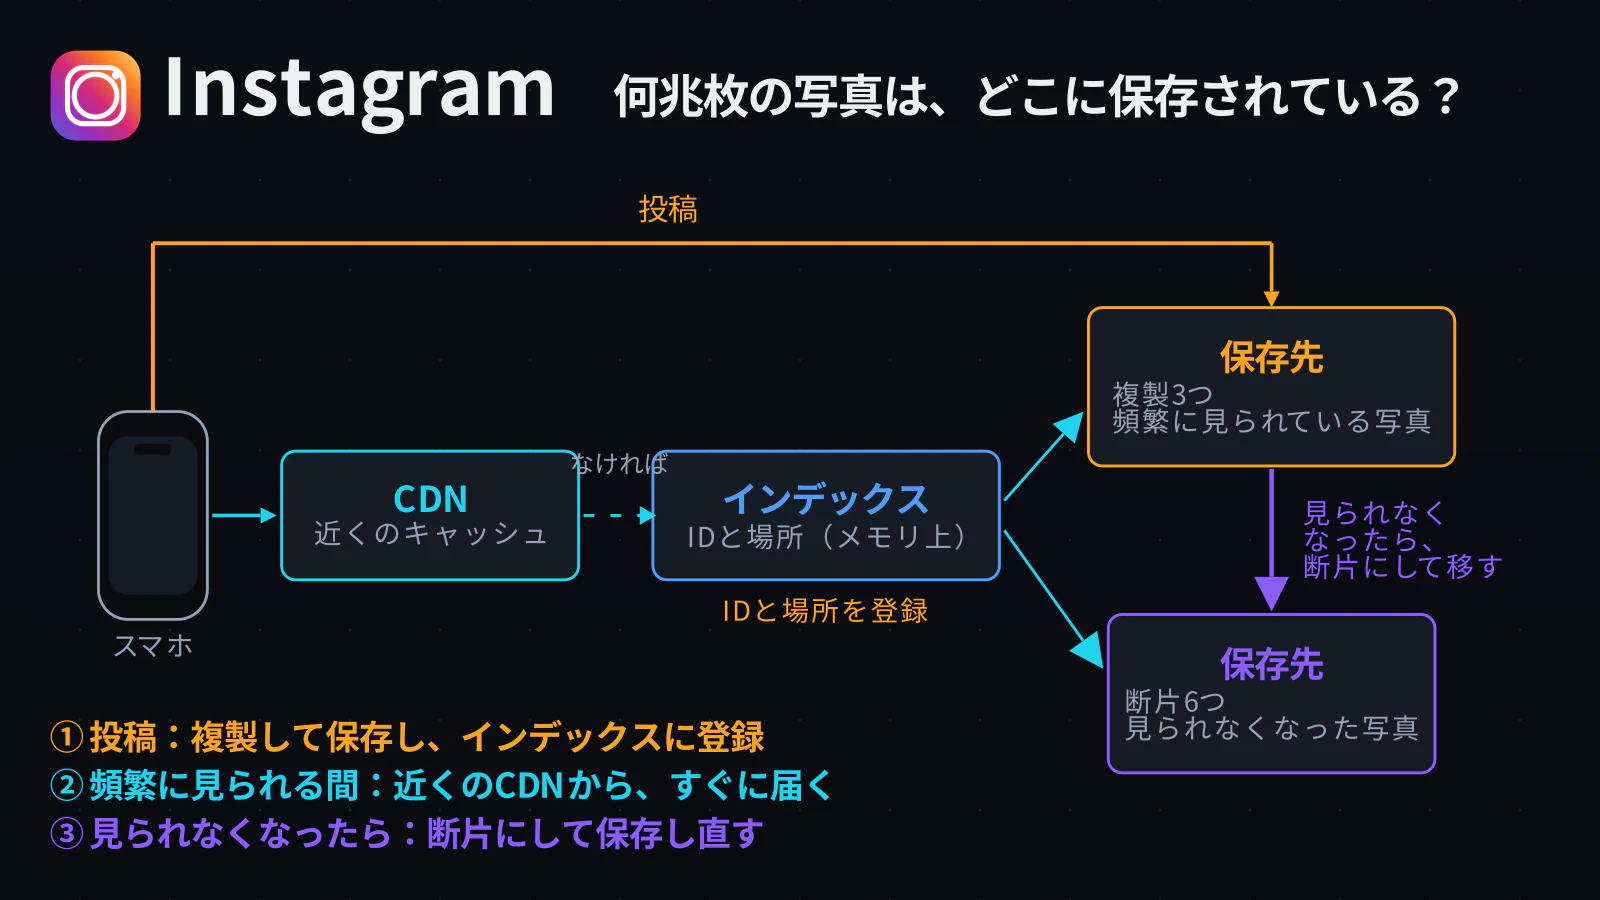
そこで、画像を1枚ずつファイルにするのをやめ、何百万枚もの画像を1つの大きなファイルにまとめて書き込みます。ファイルシステムから見れば対象は1つのファイルであり、メタデータも1件で済みます。
かわりに、「どの画像が、そのファイルの何バイト目から、何バイト分あるか」を示す索引を自前で持ちます。この索引は画像のIDから位置とサイズを引くだけの単純な対応表なので、1件あたり数十バイト程度に収まります。ファイルシステムのメタデータ(1件あたり数百バイト)よりずっと小さいため、何億件分でもメモリに載せられます。
索引がメモリ上にあれば、ディスクを調べずに位置が即座に分かります。画像を取り出すときは、索引を引いて位置とサイズを知り、その場所へ直接1回だけディスクを読みに行けば済みます。ディスクアクセスは実質1回になります。
アクセス頻度で保存の仕方を変える
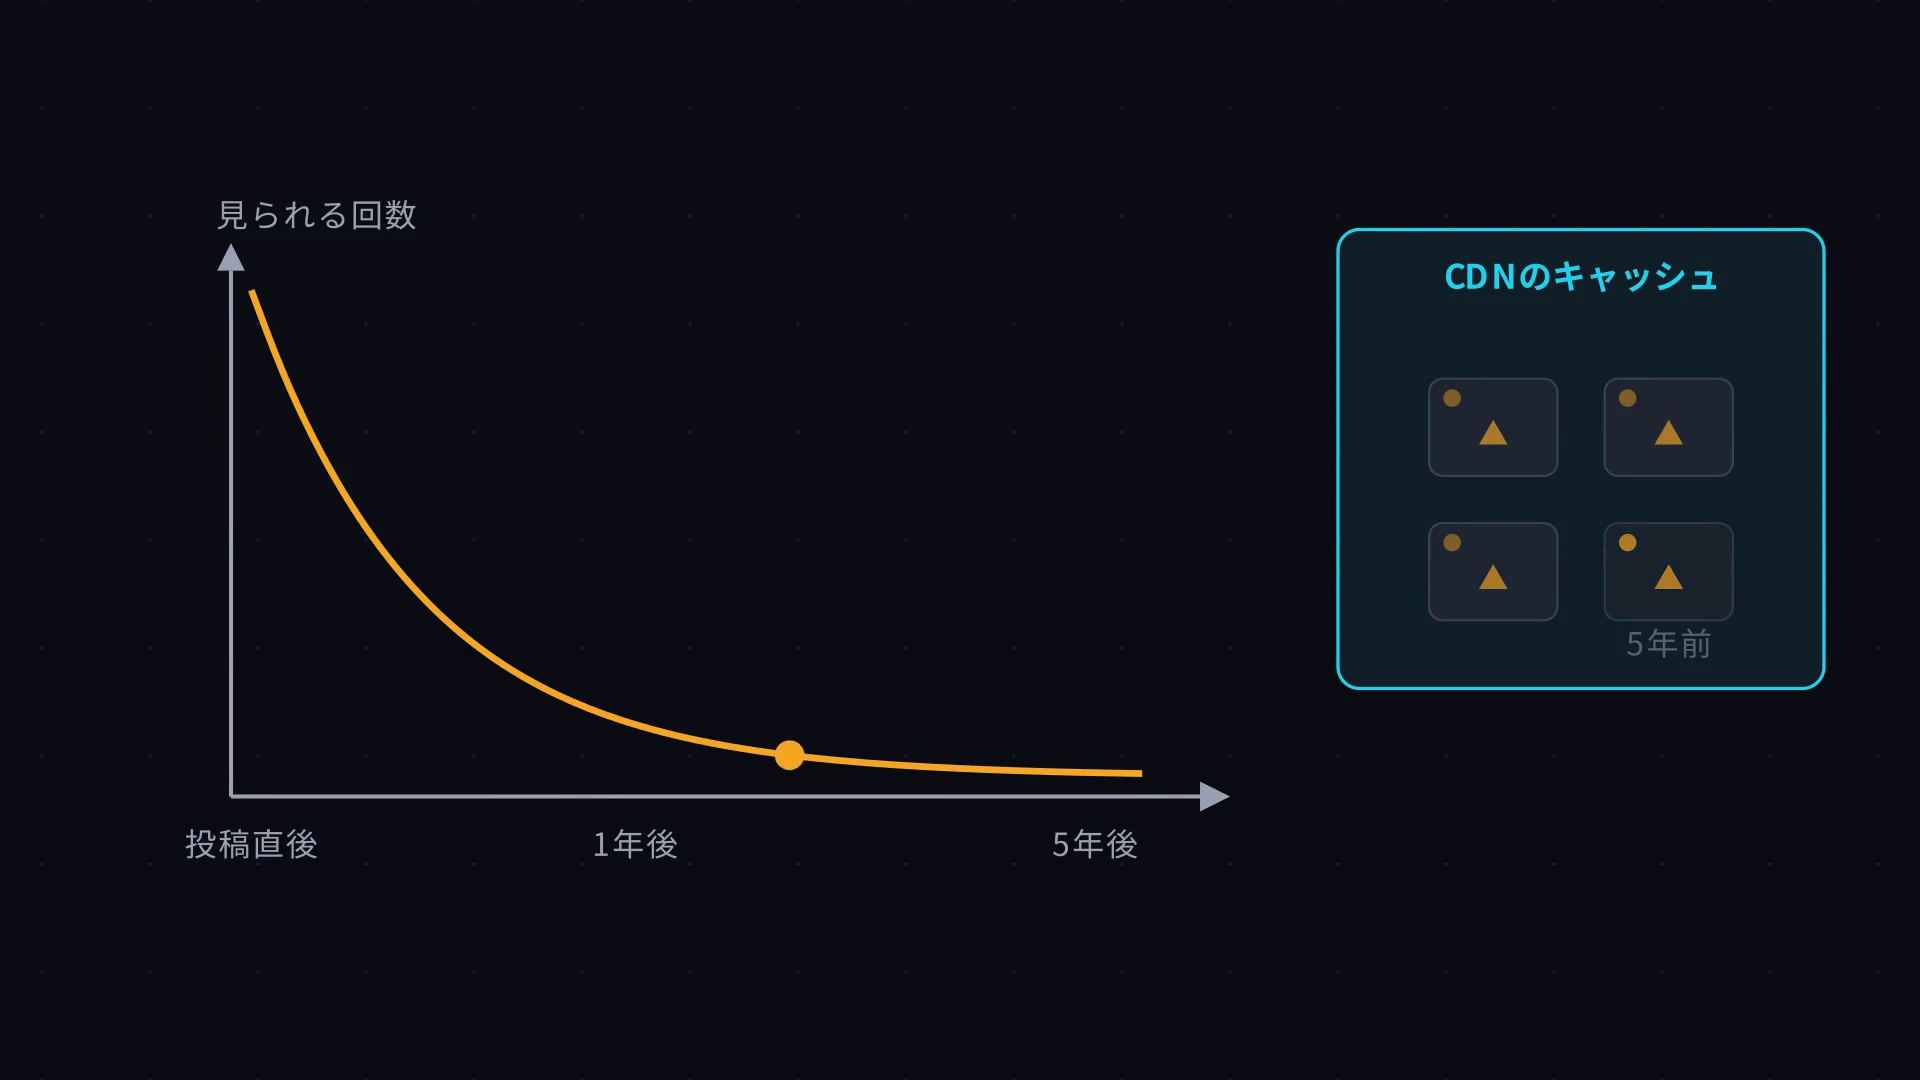
投稿されたばかりの画像と、5年前に投稿された画像は、同じ頻度でアクセスされるわけではありません。新しい画像は短期間に大量のアクセスが集中するため、世界中に配置したCDN(配信用のキャッシュサーバー)にあらかじめコピーを置いておき、利用者から地理的に近いCDNから配信します。これにより、保存元のサーバーへの負荷と、利用者までの応答時間の両方を抑えられます。
一方、時間が経つにつれてアクセスは減っていき、ほとんど見られなくなった画像は、CDN上のコピーからも順に外れていきます。
見られなくなった画像は複製ではなく断片化で守る
アクセスが減った画像を消していいわけではありません。ただし、サーバーは故障します。何十万台もあれば、どこかで故障が起きるのは珍しくないため、1台が壊れても画像を失わない仕組みが必要です。
単純な方法は、同じ画像を別々のサーバーに複数(たとえば3つ)複製することです。1つが壊れても残りから読み出せますが、容量は単純に3倍かかります。ほとんど読まれない画像に対して常に3倍の容量を使い続けるのは無駄が大きいため、複製の代わりに次の方法が使われます。
画像を複数の断片に分割し、その情報から計算で予備の断片(パリティ)を追加で作ります。たとえば4つの断片から2つの予備断片を作って計6つとし、それぞれを別々のサーバー、別々のデータセンターに保存します。6つのうち、どれか2つが失われても、残りの4つから元の画像を計算で復元できます。この方式はイレイジャーコーディングと呼ばれ、3複製よりずっと少ない容量(このケースでは元の1.5倍)で、同等の耐障害性を実現します。復元には計算コストがかかりますが、ほとんど読まれない画像であれば問題になりません。
まとめ
3年前に投稿した、もうほとんど見返さないあの1枚は、消えてなくなったわけではありません。世界のどこかのデータセンターで、断片になって、複数のサーバーに分かれて保存されています。もう一度その画像を開いた瞬間、IDから断片の場所が調べられ、集められた断片が計算によって元の1枚に復元され、画面に届きます。
膨大な量のデータを、壊れないように、無駄なく、必要なときにすぐ取り出せるように保存する設計は、Instagramに限らず、大規模なデータを扱うあらゆるサービスに共通する考え方です。
ここまでの流れをアニメーションで見たい場合はこちら↓
https://www.youtube.com/channel/UClgdVrValAdR8gYSZ86DYEQ