
Linux障害対応の初動を「確認できた事実」で組み立てる
この記事では、RHEL/AlmaLinux/Rocky Linux 8・9を対象に、障害連絡から最初の10分で行う読み取り確認を整理します。
目的は10分以内の復旧ではありません。対象・時刻・影響範囲を固定し、揮発しうる情報を残し、CPU、メモリ、容量、サービス、ログ、ネットワークのどこを深掘りするか決めることです。
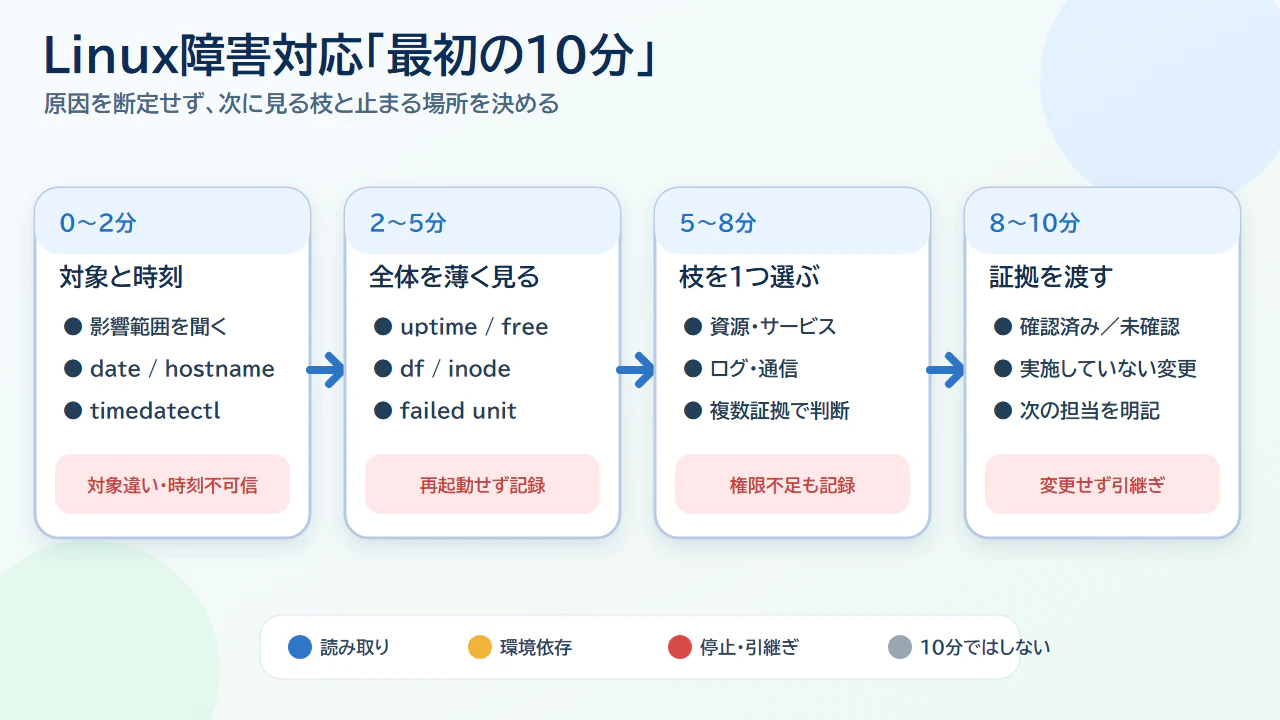
保存用の図解とチェックリスト
この記事の確認順序を、8枚の図解と4つのチェックリストで見返せる保存版にしています。
Linux障害対応「最初の10分」図解マップ(note有料記事)
前提と検証範囲
- 対象はRHEL系8・9です
- コマンドの仕様はRed Hat公式資料とupstreamのman pageで確認しています
- 出力の一部は既存のAlmaLinux 8.10/9.7検証記録を参照しています
- 今回の10分シナリオを一括実行した新規VM検証は行っていません
-
iostatはsysstatパッケージに含まれ、構成によって未導入です。vmstatを主経路にします - 固定のCPU・load・メモリ・I/Oしきい値は置きません。平常値、CPU数、SLO、監視条件と比較します
以下の出力は、見る場所を示すために省略した模式例です。実機検証結果の転載ではありません。
0〜1分:対象と時刻を固定する
date
hostname
timedatectl
date、hostnameの出力を作業記録の先頭に置きます。監視時刻、申告時刻、サーバ時刻を別々に記録します。
timedatectlでは次を見ます。
Time zoneSystem clock synchronizedNTP service
時刻同期に問題がある場合、後続ログを絶対的な時系列として扱いません。調査中に時刻を変更すると時系列をさらに壊すため、修正せず記録して引き継ぎます。
1〜3分:再起動と揮発情報を確認する
uptime
uptime -s
journalctl --list-boots
ps -eo pid,ppid,user,stat,%cpu,%mem,etimes,comm --sort=-%cpu
uptimeのload averageは1、5、15分の並びで傾向を見ます。loadには実行待ちだけでなく、割り込み不能な待ち状態も含まれるため、高い値だけでCPU不足とは決めません。
journalctl --list-bootsが1行でも「再起動していない」とは限りません。journalが非永続の環境では過去bootが残らないことがあります。
psのPID、STAT、commなどの一覧は取得時点のスナップショットです。ただし、%CPUは現在瞬間のCPU使用率ではなく、プロセス存続期間のCPU時間を経過時間で割った平均です。現在傾向はvmstat 1 5を主にします。
初動はcommまでを基本にします。argsが必要な場合は、token、password、URL、内部パスを含まないか採取前に確認します。採取する場合はアクセス制御された保存先と閲覧範囲を決め、原本とマスキング済みの共有用コピーを分けます。
SSH接続不能を止まった段階で分ける
宛先host/IP、申告TCP port、user、接続元、許可時刻・回数を先に確認します。lock/alert/rate limit方針が不明なら実行しません。placeholderは確認済みの値に置き換え、山括弧付きのまま実行しません。
ssh -vv -T -p <申告port> \
  -o BatchMode=yes \
  -o StrictHostKeyChecking=yes \
  -o PasswordAuthentication=no \
  -o KbdInteractiveAuthentication=no \
  -o ConnectTimeout=10 \
  -o ConnectionAttempts=1 \
  -o ClearAllForwardings=yes \
  -o ControlMaster=no \
  -o ControlPath=none \
  -o ForwardAgent=no \
  -o ForwardX11=no \
  -o PermitLocalCommand=no \
  <user>@<host> true
-pで申告portを指定し、password、keyboard-interactive、host key確認の入力を無効にします。未知・変更済みhost keyは受け入れません。pseudo-terminal、転送、多重化、local commandも無効です。認証とremote execに成功した場合はtrueで即時終了し、shell、セッション、転送を残しません。ただしForceCommand、MFA、restricted shell等では通常の対話loginと結果が異なりえます。
- timeout: TCP接続が時間内に完了していない。サーバ停止、経路、drop、宛先誤りのどれかは未確定
- refused: 接続拒否が返った。sshd停止、待受なし、別port、FW rejectのどれかは未確定
-
Authentications that can continue:/Permission denied: ネゴシエーション後の認証段階。user、鍵、権限、SELinux等のどれかは未確定 -
Host key verification failed: known_hosts照合で停止。鍵を削除せず、変更履歴と正規fingerprintを確認
debug出力は標準エラーへ出ます。接続先address/portが申告どおりかを確認し、TCP、version交換、key exchange、host key、認証のどこまで進んだかを見ます。ConnectTimeout=10はcommand全体の厳密な10秒上限ではありません。
出力にはuser、host、IP、port、鍵パス、公開鍵fingerprint、proxy構成が含まれうるため、全文貼付けを前提にしません。必要行だけを記録し、共有用コピーでは固有値をマスキングします。接続試行は各機器のログへ残りうるため1回だけにし、再試行が必要なら引き継ぎます。
3〜6分:CPU・メモリ・容量を分類する
CPUとI/O待ち
vmstat 1 5
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 1  0      0  ...     ...    ...     0    0     2     3  ...  ...  5  2 92  1  0
最初の行は起動後平均、後続行は指定間隔の値です。rとus/syが増えるならCPU側、bとwaが増えるならI/O側を疑う手掛かりになりますが、単独では断定しません。
iostat -xz 1 3は利用可能な場合だけ補助にします。列はsysstat版により異なりうるため、存在しない列を前提にしないようにします。
メモリとOOM
free -h
journalctl -k -b --no-pager | grep -Ei 'out of memory|oom-kill|killed process'
freeはfree列より先にavailableを見ます。swap使用量があるだけで、現在もメモリ逼迫中とは断定できません。vmstatのsi/so、OOM記録、アプリケーション症状を組み合わせます。
OOM検索が0件でも、OOMを否定できません。権限、ログ保持、再起動、検索語の違いを確認します。
容量・inode・read-only
df -hT
df -i
findmnt
journalctl -k -b --since '<開始時刻>' --no-pager
df -hTでは問題のあるパスが属するmount pointとFS種別を確認します。df -iは容量とは別にinode枯渇を確認します。
findmntは終了コード0だけで該当や安全を判断せず、出力があるか、OPTIONSにroがあるかを読みます。read-only、I/O error、FS errorを見つけたら、削除・再mount・修復へ進まずエスカレーションします。
6〜8分:サービスとログを絞る
systemctl --failed --no-pager
systemctl status <unit> --no-pager -l
systemctl show <unit> -p ActiveState -p SubState -p Result -p ExecMainStatus -p NRestarts
journalctl -u <unit> --since '<開始時刻>' --no-pager
journalctl --since '<開始>' --until '<終了>' -p warning --no-pager
systemctl --failedが0件でも、対象サービスの業務機能が正常とは限りません。対象unitのActive、since、Main PID、Resultを見て、対象時間のjournalと突き合わせます。NRestarts等のプロパティはsystemd版に依存する可能性があるため、ログ時刻、PID、終了理由、短時間反復を組み合わせます。
activeでも、待受、依存先、アプリケーション内部が正常とは限りません。逆に、journalが0件でも異常なしとは限りません。閲覧権限、優先度、時刻窓、保持設定を確認します。
8〜9分:通信経路を層ごとに見る
ip -br link
ip -br address
ip route show default
ip route get <対象IP>
順序はlink/address → 経路選択 → ICMP補助 → 対象IP・単一TCP port実接続 → NSS名前解決 → サーバ側listenerです。
ip route getのdev、src、表示される場合はviaを見ます。このコマンドはkernelが選ぶ経路を表示するだけでpacketを送信しないため、到達成功の証明ではありません。
組織が許可している場合だけ、申告されたgatewayと対象IPへ少数回のICMP補助確認を行います。
ping -n -c 3 -W 2 <gateway-IP>
ping -n -c 3 -W 2 <対象IP>
成功はICMP Echoの往復だけを示し、対象portやアプリケーション正常を証明しません。失敗もfilter、rate limit、応答抑止があるため、それだけでIP到達不可とは断定しません。pingが無ければ障害中に追加導入しません。
対象protocol用の承認済みhealth check/clientがある場合は、送るrequestと影響をサービス担当へ確認して優先します。無い場合は、Ncatが導入済みで単一TCP接続を許可されている場合だけ補助確認します。
command -v ncat
ncat -n -z -w 5 <対象IP> <対象port>
Ncatはnmap-ncatパッケージに依存します。未導入なら記録だけ行い、障害中に追加しません。zero-I/OでもTCP handshakeと切断は発生し、相手ログ、accept処理、IDS/IPS、監視、rate limitへ残りえます。許可された送信元から、申告された単一IP・単一portへ1回だけ実行します。許可や影響が不明なら実行しません。複数宛先・port範囲・port scanは行わず、UDPへ一般化しません。
getent ahosts <対象ホスト名>
# サーバ側で
ss -lntup
getent ahostsはDNSだけでなくNSS設定に従います。複数addressやIPv4/IPv6をサービス定義と照合し、IP・port接続との差を見ます。失敗や想定外addressだけで即座にDNS障害とは断定しません。
サーバ側ssは、そのnetwork namespace内のlistenerの証拠ですが、clientからroute、firewall、NAT、load balancer等を通った到達成功は証明しません。process欄が空でも、権限不足の可能性があります。
Permission deniedをUNIX権限とSELinuxに分ける
まず実効user/groupと、パス途中の各構成要素を確認します。
id
namei -l -- /対象/までの/パス
namei -lでは、各構成要素のmode、owner、groupを見ます。途中ディレクトリのxは、その先を名前で検索・通過する権限です。nameiはutil-linux由来で、全構成での可用性は今回未実測です。無い場合は、人間が確認したprefixを明示して確認します。
ls -ld -- / /対象 /対象/まで /対象/までの/パス
未知のパスを変数展開やevalで組み立てません。取得不能も記録し、無理にsudoへ切り替えません。ACLはgetfaclとaclパッケージが関係するため、保留枝とします。
UNIX権限で説明できなければ、SELinuxのmode、context、AVCを分けます。
getenforce
sestatus
ls -Zd -- /対象/パス
ps -p <PID> -o pid,user,label,comm
sudo ausearch -m AVC,USER_AVC,SELINUX_ERR,USER_SELINUX_ERR -ts recent -i
EnforcingだけでSELinuxが原因とは言えません。症状と同時刻のAVC、process/object contextまで突き合わせます。ausearchはauditの導入・稼働・保持と閲覧権限に依存するため、0件でもSELinux原因を否定しません。
パスやAVCには顧客名、user、hostname、IP等が含まれうるため、共有用コピーでは判断に不要な固有値を置換します。chmod、chown、setenforce 0、context変更、restorecon、policy追加は最初の10分で実行しません。
9〜10分:変更履歴と停止条件を整理する
組織の許可がある場合だけパッケージ履歴を確認します。
# RHEL 8の公式表記
sudo yum history

# RHEL 9
sudo dnf history
履歴は設定変更やアプリ配布を網羅しません。障害時刻と近いことは相関であって、原因確定ではありません。
最後に次を分けて記録します。
- 確認済み
- 未確認
- 権限不足、コマンド不存在、空出力
- 最初の異常ログ時刻
- 実施していない変更
- 次に必要な担当・権限・判断
journalやカーネルログにはhostname、IP、user、内部パス、認証失敗、アプリケーションが誤って出力したsecretが含まれる場合があります。時刻、unit、priorityで採取範囲を最小化し、アクセス制御された保存先と閲覧範囲を決めます。チケットや外部共有には必要箇所だけを抜いたマスキング済みコピーを使います。
最初の10分では実行しない操作
再起動、サービスstop/restart、削除、truncate、chmod/chown、setenforce、context変更、restorecon、policy追加、firewalld・NetworkManager・DNS・時刻の変更、mount/umount、ファイルシステム修復は実行しません。
ディスク100%、inode枯渇、read-only、I/O/FSエラー、OOM反復、複数ホスト影響、対象不明、時刻を信頼できない、証跡を安全に保存できない、といった状態は停止・エスカレーション条件です。
まとめ
最初の10分では、全部のコマンドを機械的に実行する必要はありません。対象と時刻を固定し、全体を薄く見て、症状に合う枝を1つ選びます。変更が必要になったら、確認済みと未確認をそろえて引き継ぎます。
参考資料
Red Hat Enterprise Linux 9: Monitoring and managing system status and performance
Red Hat Enterprise Linux 9: Configuring basic system settings
Red Hat Enterprise Linux 9: Configuring and managing networking
Red Hat Enterprise Linux 9: Using SELinux
OpenSSH manual index
ssh(1)
ssh_config(5)
ip-route(8)
Ncat upstream reference