
「ノーコードの Dify? コードで書くなら LangGraph? TypeScript 一本なら Mastra? それとも全部自前?」
PoC を動かすたびに、この 4択で足踏みしているチームをよく見かけます。機能比較表を並べても結論が出ないのは、「何に工数を割きたいか」 と 「ドメインをどれくらい汎用に保つか」 という別々の軸が、同じ選定議論に混ざって入ってきているからです。
この記事では、その2軸をほどいて 5ティアにマッピングし、自分のプロジェクトが「いま、どこに居て、どちらに動かすべきか」を判断できる形に整理しました。
この記事で得られること
- エージェント基盤の選定を「ドメイン × レイヤー」の2軸で切る判断フレーム
- Dify / LangGraph / Mastra / カスタムグラフを含む 5ティアの比較と、各ティアの向き・不向き
- Python ファースト(LangGraph)と TypeScript ファースト(Mastra)のスタック軸による分岐
- 候補から外した選択肢(Bedrock Agents、CrewAI、AutoGen / AG2 など)と、その理由
- LLM観測・RAG の選定が、エージェント層と連動する理由
- 選び間違いのアンチパターン
- 現在地を判定する選定チェックリスト
前提 — 何を選ぶ話か
本記事で扱うのは、単体のAIエージェントを本番運用する基盤の選定です。マルチエージェント協調やクラウドネイティブ前提の話題は外しています。
比較対象にするのは次の3系統です。ティア2 の「フレームワーク」層は、チームのメインスタックが Python か TypeScript かで実質的な選択肢が分かれるので、二つに分けて扱います。
- Dify — ノーコードの AIアプリケーションプラットフォーム(OSS 版とクラウド版があります)
- LangGraph / Mastra — 状態遷移型エージェントフレームワーク。Python / JS 両対応の LangGraph と、TypeScript ネイティブで同水準の機能を揃える Mastra の2ルート
- カスタムグラフ — フレームワーク非依存で自前実装する選択肢
また、本記事の内容は 2026-06 時点 の各プロダクトの状態を前提にしています。Dify / LangGraph / LangChain はいずれも四半期どころか月単位で機能が動くため、時期が離れた読者はバージョン差分を確認してください。コスト軸(LLM API・ベクター DB・ホスティングの月額試算)は選定に必須ですが、プロジェクトごとに見積もりが大きく変わるため、本記事では扱いません。
2軸で切る: ドメイン × レイヤー
軸1: ドメイン軸
プロダクトが対象とする業務が、どれくらい汎用か個別か、という軸です。
| 左端(汎用) | 右端(個別) |
|---|---|
| どの業界でも通用する | 個社・個業務に特化 |
| 例: 要約、分類、翻訳 | 例: 医療記録解析、法務文書検索 |
軸2: レイヤー軸
エージェント実装のどのレイヤーに工数を注ぐか、という軸です。
| 左端(ビジネスレイヤー) | 右端(システムレイヤー) |
|---|---|
| 業務ロジックの検証に集中 | 基盤まで踏み込んで作り込む |
| プラットフォームに乗る | ベンダー非依存・独自最適化 |
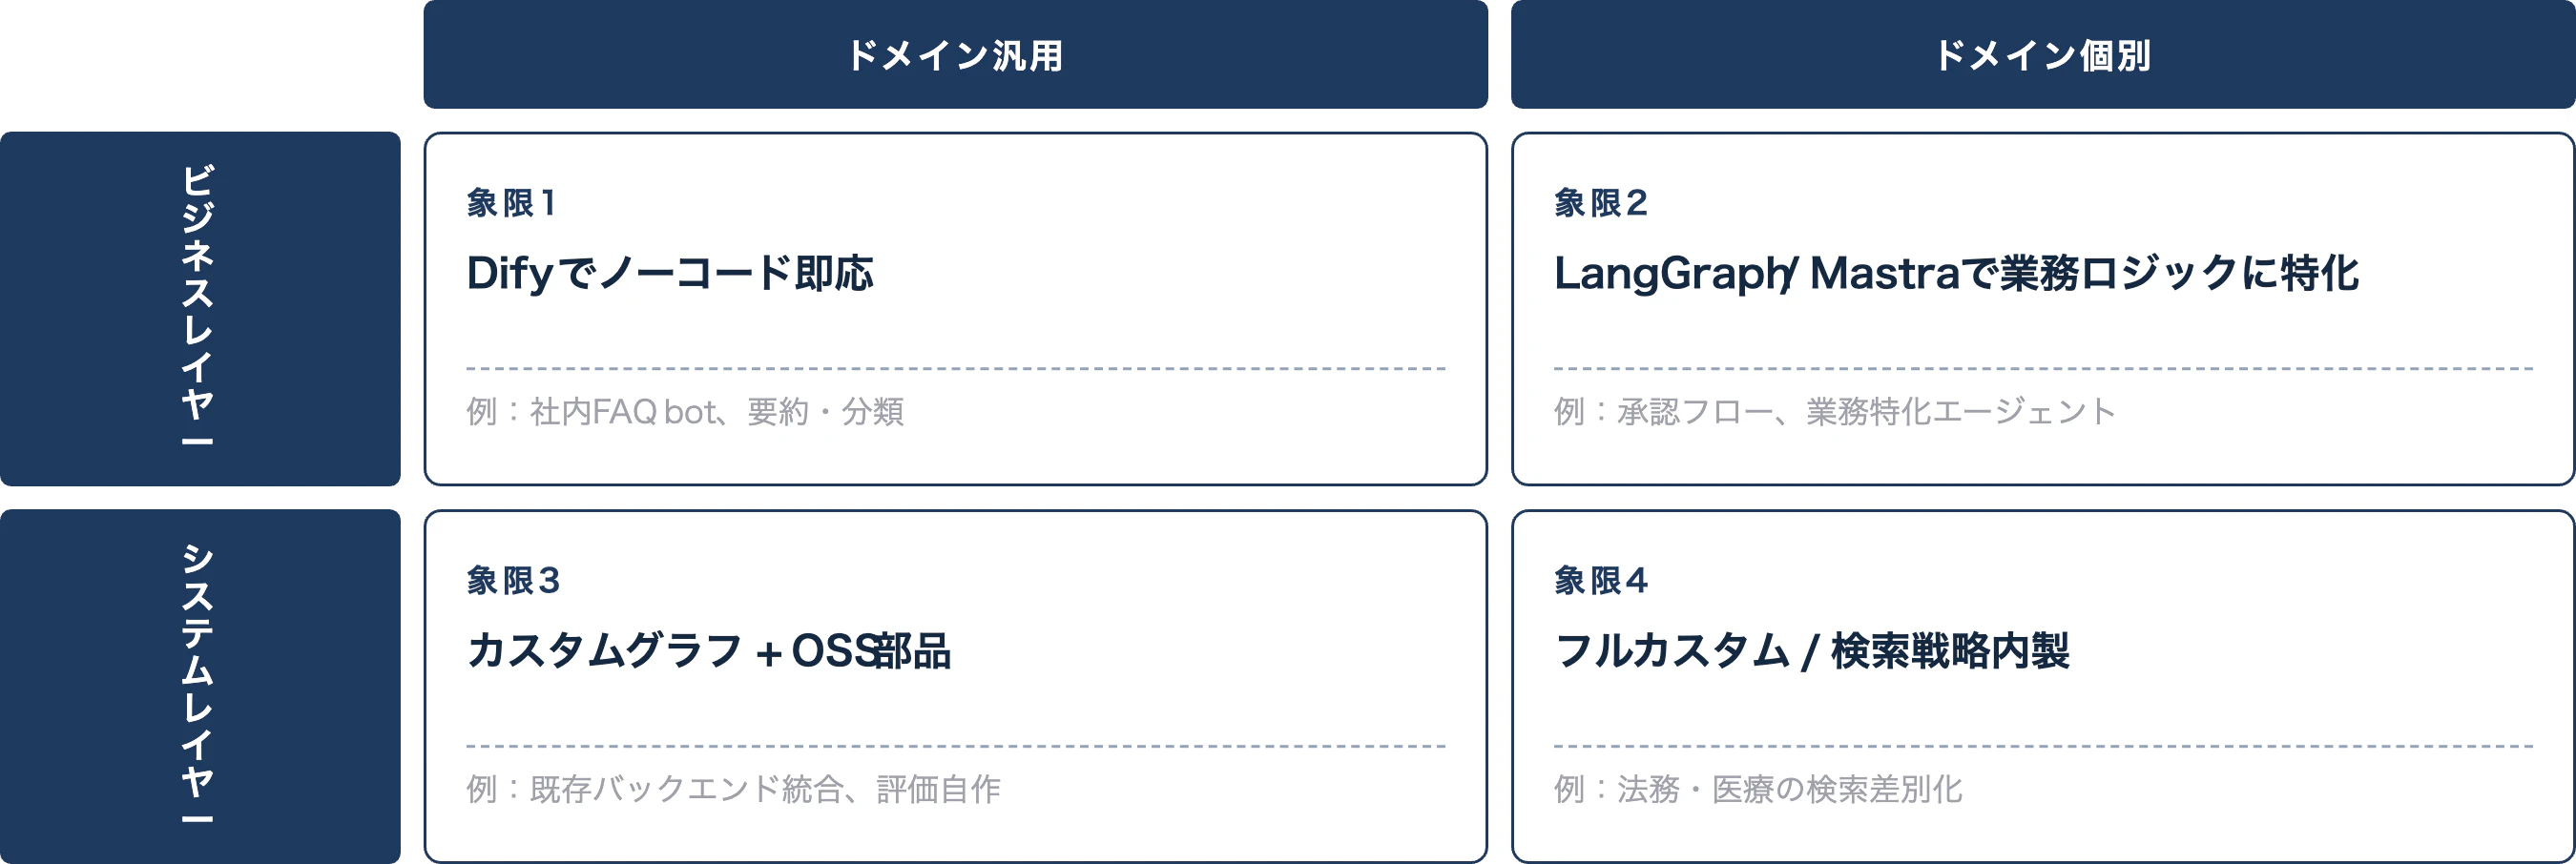
2軸を対角線でサンプリングする 5ティア
2軸マトリクスはそのまま描くと 2×2=4象限 になります。ただし現実のプロジェクトは「ビジネスレイヤー × 汎用」と「システムレイヤー × 個別」の対角線上に分布することが多く、反対側の2象限(ビジネス寄りだが個別、システム寄りだが汎用)は採算が合わず選ばれにくい傾向があります。
そこで本記事では、この対角線を 5 点にサンプリングし、ティアとして扱います。4象限マトリクスとは独立した補助的な座標だと考えてください。
| ティア | エージェント層 | 観測・評価 | RAG | 想定ポジション |
|---|---|---|---|---|
| 1 | Dify(ノーコード) | LangFuse / LangSmith | Dify のナレッジ機能(多数のベクター DB に対応、デフォルト Weaviate) | 汎用 × ビジネスレイヤー |
| 2-Py | LangGraph(Python/JS) | LangFuse / LangSmith | LangChain Retrievers + マネージド VDB or マネージド PG+pgvector | 汎用〜やや個別 × ビジネス寄り |
| 2-TS | Mastra(TypeScript) | Mastra Studio + LangFuse exporter | Mastra RAG(Pinecone / Qdrant / Chroma / pgvector など) | 汎用〜やや個別 × ビジネス寄り |
| 3 | カスタムグラフ + OSS | LangFuse / LangSmith | LlamaIndex / Bedrock KB / Azure AI Search | やや個別 × 中間 |
| 4 | カスタムグラフ + 検索戦略自作 | LangFuse / LangSmith + 独自評価 | ハイブリッド検索 + Rerank | 個別 × システム寄り |
| 5 | フルカスタム | 自前観測 + 自前評価 | pgvector / 自前ストア | 個別 × システム |
ティア1 から 5 に向かうほど 柔軟性と工数が上がり、ベンダーロックインが下がります。
ティア5 から 1 に向かうほど 立ち上がり速度が上がり、ビジネスロジックの検証に集中できます

各ティアの向き・不向き
ティア1: Dify
向くケース
- 社内向けツール、問い合わせ bot、要約・分類
- 業務担当者が UI 上で運用に参加する
- PoC を短期で出して、ビジネス側の合意を取りたい
向かないケース
- 複数ステートマシンにまたがる承認フロー
- 独自の評価メトリクスを組み込みたい
- バックエンドの RPC を多段で叩く必要がある
Dify は自らを「ノーコード・非開発者の参加を前提とした構成」としてポジショニングしています。無理に状態遷移を作り込みすぎると、ワークフロー画面が数十ノードに膨らみ、後で LangGraph 相当に書き直す羽目になります。
なお 2026 年に入って Dify 側も機能を広げており、2026 年早期にアナウンスされた v1.13.0 で、人手レビューのために実行を一時停止して承認・編集・再ルーティングを差し込める Human Input ノードが入り、MCP(Model Context Protocol)連携も追加されました(v1.14 系、2026-05 時点)。単発の人間介在を挟む程度の承認なら Dify でも扱えるようになっていますが、複数ステートマシンにまたがる本格的なフロー制御を求める段では、やはり LangGraph 側へ寄せたほうが見通しは良くなります。
ティア2: LangGraph / Mastra
向くケース(共通)
- 条件分岐・リトライ・人間介在を明示したい
- 数時間〜数日にわたる長期状態を扱う
- コードで書ける開発体制がある
向かないケース(共通)
- そもそもエージェントが 1ステップで終わる用途
- 業務担当者がノードを直接編集したい
- 即時 PoC で意思決定者の合意を取る必要がある
ティア2 は、チームのメインスタックによって LangGraph と Mastra のどちらを採るかが分かれます。機能範囲は重なる部分が大きいので、スタック適合で選ぶのが合理的です。
ティア2-Py: LangGraph(Python ファースト)
LangChain / LlamaIndex エコシステムとの統合が厚く、Python で既存バックエンドを書いている場合に自然な選択肢になります。公式ドキュメントは、プリビルトのエージェント API(create_agent など。旧 create_react_agent は v1.0 で非推奨)で足りる用途では、StateGraph の低レベル API に降りる必要はない、という立場を取っています。状態遷移を明示する orchestration を選ぶのは、分岐・長期状態・人間介在が本当に必要な場面に限ったほうが、費用対効果は高くなります。
LangGraph は 2026-05 時点で v1.2 系(安定版 v1.2.2、2026-05-26)まで進んでおり、ノード単位のタイムアウト・エラーハンドラ(Saga/補償パターン向け)や、長時間スレッドのチェックポイント負荷を抑える差分チャネル、コンテンツブロック中心の新ストリーミング API(v3)などが入っています。また LangGraph は状態を永続化する Checkpointer(メモリ / Redis / Postgres)を差し替える設計になっています。長期状態やマルチターン対話を扱うなら、この永続化ストアの選定がスケーリングに直結する点は、早い段階で見ておきたいところです。
ティア2-TS: Mastra(TypeScript ファースト)
フロントエンド資産が強く、バックエンドも Node.js / TypeScript で揃っているチームでは、Mastra のほうが開発の流れに乗りやすくなります。型定義をフロントと共有でき、ツールチェーンも一本化されるため、言語を行き来するコストが減るからです。2026-01 に v1.0 へ到達し、Agents / Workflows / RAG / Evals / Memory をフレームワーク一体で持つ設計になっています。リリースから 15 か月ほどで GitHub 22,000+ stars・週 30 万 npm ダウンロードに達し、2026-04 のアップデートでは予測可能性・運用向け観測・移行パスの整備が進みました。観測は Mastra Studio(組み込み)に加えて、LangFuse / LangSmith / Braintrust などに OpenTelemetry 経由でエクスポートできます。
「TS だから Mastra」という短絡はしないほうがよく、LangGraph も JS 版を提供しているため TS で LangGraph を使う選択も現実的です。Mastra を選ぶ強い理由は、RAG・Evals・Memory・Observability を個別ライブラリで寄せ集めるのではなく、フレームワーク標準のまま本番まで持っていけることにあります。LangChain 系の Python 資産を強く持っているチームでは、逆に LangGraph のほうが接続コストは低くなります。
ティア3〜5: カスタムグラフ
カスタムのティア内でも、3つに分けて考える意味があります。
- ティア3(カスタム + OSS): LangChain や LlamaIndex の部品を使いつつ、グラフは自前で組みます。既存バックエンドの上に薄く載せる場合の現実解です。
- ティア4(検索戦略自作): RAG の検索段を自前で作り込みます。ハイブリッド検索・Rerank・GraphRAG が差別化の要になる領域です。
- ティア5(フルカスタム): 観測・評価・プロンプト管理まで全部内製します。ベンダー非依存で長期運用するための選択肢です。
ティア3以降を選ぶ理由は、多くの場合「検索精度」と「既存基盤との深い結合」に集約されます。単にコントロールを握りたいだけでティア5を選ぶと、PoC が半年〜1年ほど後ろ倒しになることが多いです。
候補から外した選択肢と、その理由
選定議論の深度を出すには「なぜそれを採らなかったか」も整理しておきます。
| 候補 | 外した / 外す理由 |
|---|---|
| Pydantic AI | Python 型安全に加え Graph(型ヒントベースのグラフ定義)と Durable Execution を備え、LangGraph に近い機能範囲まで拡大しています(17k+ stars、2026-06 時点で v1 系が継続更新中、v2 系のベータも並行して進行中)。ただし Python 限定でエコシステム規模は LangGraph に及ばないため、本記事の比較軸を簡潔にするため外します |
| n8n / Flowise | Dify と役割が被ります。比較軸には入れません |
| Bedrock Agents / Vertex AI Agent Builder | クラウドロックイン前提です。汎用比較からは外します |
| CrewAI | 複数エージェント協調を一級市民として扱う設計思想のため、単体エージェント用途では抽象度が高すぎます。Flows 機能でシングルエージェント用途にも対応しますが、本記事のスコープ外です |
| AutoGen / AG2 / Semantic Kernel | AutoGen と Semantic Kernel は Microsoft Agent Framework(MAF)へ統合され、MAF は 2026-04 に 1.0(.NET / Python、長期サポート)へ到達しました。これに伴い AutoGen・Semantic Kernel はいずれも保守モード(バグ修正・セキュリティ対応のみ)へ移行しています。コミュニティフォークの AG2 が独立開発を継続中です。いずれもマルチエージェント協調が主眼のため本記事では外します |
※ Mastra は当初「候補から外した」側で書いていましたが、2026-01 の v1.0 到達と機能範囲(Agents / Workflows / RAG / Evals / Memory)を踏まえ、ティア2 の TS ファースト分岐として扱い直しました。
比較記事の大半は「機能表を並べて良し悪しを判定する」構図になりがちですが、2軸で切って位置づけたあとは「その位置に必要な機能だけで良い」と判断できます。候補を外す理由が軸ベースで言語化されていれば、後から候補が増えても再評価しやすくなります。
観測・評価・RAG の選定は、エージェント層に連動する
5 ティアの表を見直すと、観測・評価と RAG の選択肢は、エージェント層の選択に引きずられることがわかります。
観測(トレース)
ティア1〜4 では LangFuse / LangSmith が第一候補になります。LangChain 系エコシステムで標準的な trace 規格が整っており、追加実装がほぼ要らないからです。Mastra を選んだ場合でも、組み込みの Mastra Studio で手元の観測が完結し、必要に応じて LangFuse / LangSmith / Braintrust などへ OpenTelemetry 経由でエクスポートできます。ティア5 でフルカスタムに踏み込んだ場合だけ、OpenTelemetry 直叩きや自前のメトリクス基盤を検討する価値が出てきます。
評価(オフライン)
観測と評価は別軸です。プロンプトを変えたときに性能が落ちていないかを見る回帰テストは、本番運用で最大の運用負荷の一つになりやすい部分です。評価データセットと採点メトリクスは、エージェント層の選択と独立に設計できる資産であり、ティアを跨いでも持ち運べます。LangFuse / LangSmith にもデータセットとオフライン評価の機能はありますが、CI/CD に組み込む際は「エージェント層の外側で管理する」姿勢で設計したほうが、後からの移行コストを下げられます。
RAG
RAG は「エージェント基盤と同じティアで選ぶ」のが整合的です。ここで混同しがちなのは「マネージド VDB」という括りです。Pinecone や Weaviate Cloud は SaaS のベクター検索サービスですが、pgvector は PostgreSQL の拡張であり、Supabase / Neon / RDS 上に載せて初めて「マネージド PostgreSQL + pgvector」として機能します。層が違うので混ぜずに書きます。
- ティア1: Dify のナレッジ機能(多数のベクター DB に対応、デフォルト Weaviate)で十分対応できる範囲
- ティア2-Py: LangChain Retriever + マネージドベクター検索(Pinecone、Weaviate Cloud など)、またはマネージド PostgreSQL + pgvector(Supabase、Neon、RDS)
- ティア2-TS: Mastra RAG — フレームワーク標準で Pinecone / Qdrant / Chroma / pgvector などに接続し、チャンキング・埋め込み生成・Rerank までカバー
- ティア3: LlamaIndex / Bedrock Knowledge Bases / Azure AI Search などを目的別に選ぶ
- ティア4〜5: ハイブリッド検索(BM25 + ベクター)、Rerank、GraphRAG / LightRAG
ここで注意が要るのは、「RAG を入れるかどうか」はエージェント選定とは別の議論だ、という点です。RAG が本当に要るかは、データが構造化か非構造化か、データ量が Context に収まるかなどの別フレームで判断したほうがよいでしょう。この点は別記事で掘り下げます。
選び間違いのアンチパターン
実装の現場でよく見かける、失敗パターンをいくつか挙げます。
アンチパターン1: Dify で状態遷移を頑張りすぎる
ワークフロー画面が数十ノードに膨れ、分岐が視認できなくなります。途中で LangGraph 相当に書き直すことになり、その時点までのプロンプト・ナレッジ接続・UI 設定をほぼ捨てることになります。
回避策: Dify のノードが 15〜20 を超えたら、LangGraph への移行を検討する合図と考えます。
アンチパターン2: いきなりフルカスタム着手
PoC からティア5 で始めると、観測・評価・プロンプト管理・検索基盤を同時に組む羽目になり、PoC 完了が半年〜1年ほど後ろ倒しになります。
回避策: まずは Dify か LangGraph で動かし、ボトルネックが明確になった時点で下のティアへ降ります。
アンチパターン3: フレームワーク乗り換え時の資産分断
Dify → LangGraph(または Dify → Mastra)の乗り換え時に、プロンプト、評価データセット、ナレッジ(RAG)接続の3点が分断されます。結果として移行コストが想定より 2〜3倍に膨らみやすくなります(筆者の観測範囲での感覚値です)。とくに評価データセットは、ティア1 で Dify の UI 内部に溜めていると、そのままでは取り出せない形式で残ることが多いです。
回避策: ティアを跨いでも持ち運べるアセット(プロンプト・評価データセット・メトリクス定義)を、エージェント層とは独立した場所で管理します。具体的には、プロンプトは Git、評価データセットは CSV / JSONL、メトリクス定義はコードとして外に出しておくとよいでしょう。
アンチパターン4: 機能表だけで選ぶ
「Dify はノーコード、LangGraph はコード」という表面的な比較で選ぶと、運用に入った段階で「ビジネス層に踏み込みたいのにコードが必要」「システム層を作り込みたいのにノーコード制約が重い」といったミスマッチが出ます。
回避策: 機能表ではなく、2軸(ドメイン × レイヤー)での位置づけで判断します。
選定チェックリスト
自プロジェクトの現在地を判定するための問いです。
レイヤー軸の判定
- 業務担当者が運用に参加するか?(Yes → ビジネス寄り)
- 既存バックエンドの API を多段で呼ぶか?(Yes → システム寄り)
- 評価メトリクスを独自設計するか?(Yes → システム寄り)
ドメイン軸の判定
- 業界横断で使えるか?(Yes → 汎用)
- 特定業務のデータ構造に強く依存するか?(Yes → 個別)
- 検索精度がプロダクト差別化の核になるか?(Yes → 個別)
スタック軸の判定
- メインスタックは Python か TypeScript か?(Python → LangGraph、TS → Mastra が第一候補)
- フロント資産が強く、フロント側の型体系でバックまで揃えたいか?(Yes → Mastra)
- LangChain / LlamaIndex の Python 資産を既に抱えているか?(Yes → LangGraph)
運用要件の確認
- ピーク QPS と平均応答時間の要件は決まっているか?(長期状態を扱うなら LangGraph Checkpointer や Mastra Memory の選定も連動します)
- 月額コスト試算(LLM API・ベクター DB・ホスティング)は作ったか?
- 回帰テストのための評価データセットを、エージェント層と独立した場所に置けるか?
ティア仮決めの手順
- 2軸の Yes / No から、ティア1〜5 のどこに近いかを当てます
- PoC フェーズでは 1つ上のティア(よりビジネス寄り)から始めます
- 3ヶ月運用した段階で、下に降りる必要性を再評価します
まとめ
エージェント基盤の選定は、機能表ではなく 2軸(ドメイン × レイヤー) で切ると、自分のプロジェクトの現在地と動かす方向が見えてきます。5ティアのマッピングは、選定議論の共通言語として機能します。
選ぶ段で迷ったら、次の順に自問してみてください。
- この業務は汎用か、個別か?
- 工数はビジネス層に集中したいか、システム層に踏み込みたいか?
- 3ヶ月後にティアを降りる可能性はどのくらい高いか?
正解は時期によって変わります。PoC は Dify で立ち上げ、運用フェーズで LangGraph または Mastra(スタック次第)に移り、検索差別化が必要になったらカスタムに降りる、という順序は現実的です。一度の選定で長期最適を狙うよりも、ティアを跨げる資産設計のほうが、結果的に運用コストを下げられることが多いです。
参考
- Dify 公式 / GitHub(OSS 版 / クラウド版。v1.14 系、2026-05 時点)
- LangGraph 公式 / GitHub(安定版 v1.2.2、2026-05-26 時点)
-
LangGraph v1.0 リリースノート —
create_react_agent非推奨化、create_agentへの移行 - LangGraph Checkpointer(Redis) — 状態永続化ストアの選択肢
- LangFuse 評価機能 — データセット・オフライン評価
- Mastra — TypeScript AI エージェントフレームワーク(v1.0、2026-01。以降も継続アップデート)
- Mastra × LangFuse 連携 — OpenTelemetry 経由のトレースエクスポート
- Mastra RAG ドキュメント — チャンキング・埋め込み・Rerank まで一体
- Pydantic AI — Python 型安全エージェントフレームワーク(Graph / Durable Execution 対応)
- Microsoft Agent Framework — AutoGen / Semantic Kernel の統合先(v1.0、2026-04)
- CrewAI Flows — マルチエージェント協調 + シングルエージェントワークフロー