
何を確かめたいか
「所得が高い街ほど、人が流入しているのか?」を、全国1,740市区町村の e-Stat データで確かめました。結論は、そのまま比べると関係があるように見えるが、年齢構成などをそろえると0と区別できなくなる、というものです(結果の読み方は note の記事に書いています)。
この記事では、その確かめ方の実装に絞ります。ポイントは次の3つです。
- 説明変数を標準化して、「1標準偏差あたり何人違うか」でそろえる
- 条件を1つずつ足した4本の回帰を回し、同じ係数がどう動くかを表にする
- 表をそのまま係数の階段図にして、0をまたいだら灰色にする
使ったライブラリは pandas・numpy・statsmodels・matplotlib です。
データの取り方と整形
データは e-Stat の「社会・人口統計体系 市区町村データ」と「統計でみる市区町村のすがた2026」を、項目コードの列名のまま1つの CSV(data/municipal_base.csv)にまとめたものです。1行が1市区町村で、A1101(総人口)、C120110(課税対象所得)のような項目コードが列名になっています。
使った変数は次のとおりです。
| 変数 | 定義(項目コード) | 年 |
|---|---|---|
| 転入超過 | (転入者数 A5103 − 転出者数 A5104)÷ 住民基本台帳人口 A2301 × 1,000 | 2024 |
| 納税者1人あたり所得(対数) | 課税対象所得 C120110 ÷ 納税義務者数 C120120 | 2024年度 |
| そのほかの条件 | 65歳以上の割合・大卒の割合・人口密度・第1次/第2次産業の割合・単独世帯の割合 | 2020 |
読み込みと変数づくりは、ほかの記事と共通の common.py の load() にまとめています。比率を作ったあと、条件に使う変数を全部 z 値(平均0・標準偏差1)にしているのが大事なところです。
LABEL = {"log_inc": "納税者1人あたり所得(対数)", "old": "65歳以上の割合", "univ": "大学・大学院卒の割合",
         "log_density": "人口密度(可住地、対数)", "mfg": "第2次産業で働く人の割合", "primary": "第1次産業で働く人の割合",
         "single": "単独世帯の割合"}
CONTROLS = ["log_inc", "old", "univ", "log_density", "mfg", "primary", "single"]


def load():
    d = pd.read_csv(ROOT / "data" / "municipal_base.csv")
    d = d[(d["A1101"] > 0) & (d["C120120"] > 0) & (d["A2301"] > 0)].copy()
    d["inc"] = d["C120110"] / d["C120120"] * 100                 # 万円(2024年度=2023年の所得)
    d["log_inc"] = np.log(d["inc"])
    d["old"] = d["A1303"] / d["A1101"]
    d["univ"] = d["E9106"] / d["E9101"]
    d["mfg"] = d["F2211"] / d["F1102"]
    d["primary"] = d["F2201"] / d["F1102"]
    d["single"] = d["A810105"] / d["A710101"]
    d["ward23"] = d["code"].between(13101, 13123)
    for c in CONTROLS:
        d["z_" + c] = (d[c] - d[c].mean()) / d[c].std()
    return d
標準化しておくと、単位の違う変数(割合・対数・人数)の係数を「1標準偏差あたり、転入超過が1,000人あたり何人違うか」という同じ物差しで並べられます。
被説明変数の転入超過は、分析スクリプト側で1行で作っています。
d = load()
d["net_mig"] = (d["A5103"] - d["A5104"]) / d["A2301"] * 1000        # 住民1,000人あたりの転入超過(2024年)
全国1,740市区町村のうち、転入が転出を上回ったのは26%(share_positive 0.257)で、中央値は1,000人あたり −3.7人でした。
手法の実装:条件を1つずつ足す4本の回帰
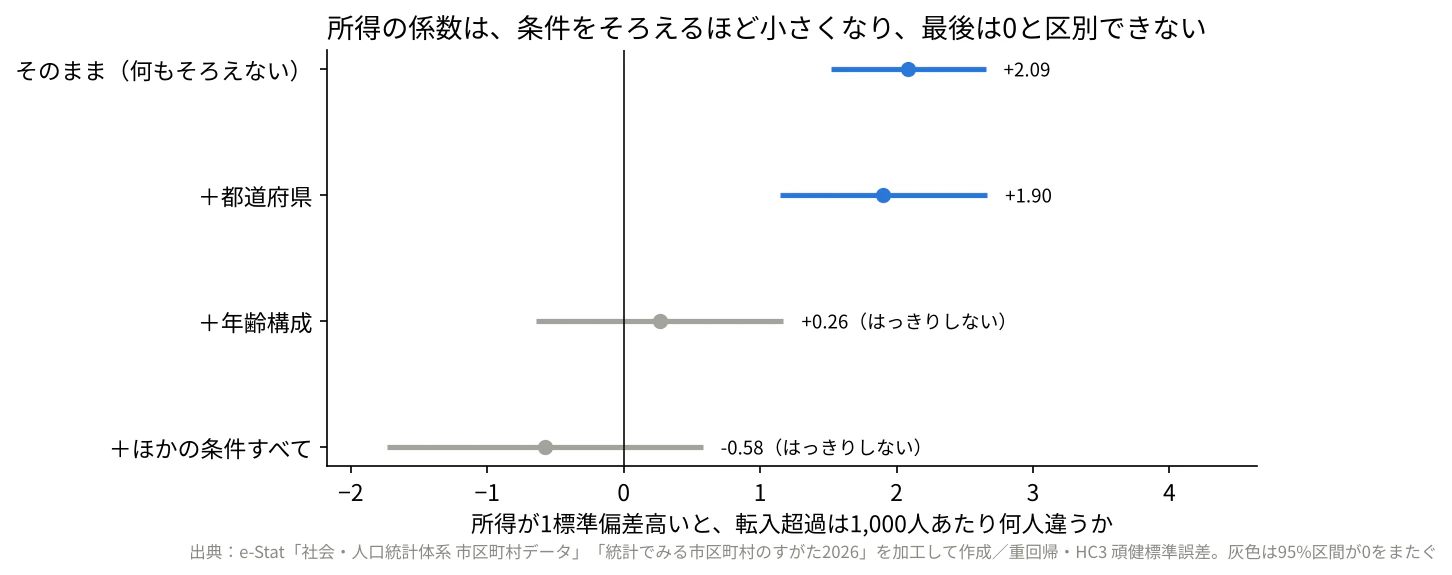
「条件をそろえると答えが変わる」を見せるために、同じ係数(ここでは所得)を、条件を足しながら4回推定します。
- そのまま(何もそろえない)
- +都道府県(
C(pref_code)で都道府県の固定効果) - +年齢構成(65歳以上の割合)
- +ほかの条件すべて
これを関数 steps() にしています。statsmodels の式(formula)を文字列で組み立てて、cov_type="HC3" で不均一分散に頑健な標準誤差にしています。市区町村は人口の規模がばらばらで、残差のばらつきがそろっている前提を置きにくいためです。
def steps(d, y, key, label_key, extra=None):
    """key の係数が、条件を足すとどう変わるか(標準化した1標準偏差あたり)"""
    others = [c for c in CONTROLS if c != key]
    specs = [("そのまま(何もそろえない)", f"{y} ~ z_{key}"),
             ("+都道府県", f"{y} ~ z_{key} + C(pref_code)"),
             ("+年齢構成", f"{y} ~ z_{key} + z_old + C(pref_code)" if key != "old" else f"{y} ~ z_{key} + C(pref_code)"),
             ("+ほかの条件すべて", f"{y} ~ z_{key} + " + " + ".join("z_" + c for c in others) + " + C(pref_code)")]
    rows = []
    for name, f in specs:
        r = smf.ols(f, d).fit(cov_type="HC3")
        k = "z_" + key
        rows.append({"model": name, "coef": r.params[k], "lo": r.conf_int().loc[k, 0], "hi": r.conf_int().loc[k, 1],
                     "p": r.pvalues[k], "r2": r.rsquared, "n": int(r.nobs)})
    return pd.DataFrame(rows)
この関数は「どの変数の係数を追うか(key)」と「被説明変数(y)」を引数にしているので、同じリポジトリのほかの記事(出生と所得、昼夜間人口と所得など)でもそのまま使い回しています。
全部の条件を同時に入れたモデルの係数表は full_model() で作ります。
def full_model(d, y):
    f = f"{y} ~ " + " + ".join("z_" + c for c in CONTROLS) + " + C(pref_code)"
    r = smf.ols(f, d).fit(cov_type="HC3")
    out = pd.DataFrame({"var": [LABEL[c] for c in CONTROLS], "coef": [r.params["z_" + c] for c in CONTROLS],
                        "lo": [r.conf_int().loc["z_" + c, 0] for c in CONTROLS], "hi": [r.conf_int().loc["z_" + c, 1] for c in CONTROLS],
                        "p": [r.pvalues["z_" + c] for c in CONTROLS]})
    out["r2"], out["n"] = r.rsquared, int(r.nobs)
    return out
呼び出し側はこれだけです。
t = steps(d, "net_mig", "log_inc", "所得")
t.round(3).to_csv(RES / "a3_steps.csv", index=False, encoding="utf-8-sig")
fm = full_model(d, "net_mig"); fm.round(3).to_csv(RES / "a3_full.csv", index=False, encoding="utf-8-sig")
結果(results/a3_steps.csv)
| モデル | 所得の係数 | 95%区間 | 決定係数 |
|---|---|---|---|
| そのまま(何もそろえない) | +2.086 | 1.518〜2.653 | 0.050 |
| +都道府県 | +1.904 | 1.143〜2.664 | 0.146 |
| +年齢構成 | +0.263 | −0.646〜1.171 | 0.181 |
| +ほかの条件すべて | −0.577 | −1.734〜0.579 | 0.234 |
都道府県をそろえても係数はほとんど変わらず、年齢構成を足したところで一気に0付近まで落ちています。「同じ県の中で比べても関係はあるが、若い人が多いかどうかで説明できてしまう」という形です。
結果の出し方:散布図と係数の階段図
散布図(対数目盛・人口で円の大きさ)
所得は右に長い分布なので、横軸を対数目盛にしています。目盛を「250, 300, 400…」と読める数字にするため、set_xticks でラベルを指定し、補助目盛のラベルは NullFormatter で消しています。東京23区だけ色を変えています。
fig, ax = plt.subplots(figsize=(8, 5))
o = d[~d.ward23]; w = d[d.ward23]
ax.scatter(o.inc, o.net_mig, s=np.clip(o.A2301 / 5000, 4, 120), color=GRAY, alpha=0.5, lw=0)
ax.scatter(w.inc, w.net_mig, s=np.clip(w.A2301 / 5000, 4, 120), color=BLUE, alpha=0.8, lw=0, label="東京23区")
ax.axhline(0, color=INK, lw=0.8); ax.set_xscale("log")
ax.set_xticks([250, 300, 400, 500, 700, 1000, 1500], ["250", "300", "400", "500", "700", "1,000", "1,500"])
from matplotlib.ticker import NullFormatter; ax.xaxis.set_minor_formatter(NullFormatter())
ax.set_ylim(-40, 40); ax.set_xlabel("納税者1人あたり所得(万円、対数目盛)"); ax.set_ylabel("転入超過(住民1,000人あたり、2024年)")

相関は0.22です。
係数の階段図
steps() の表を、そのまま横向きの区間つき点の図にします。95%区間が0をまたいだ段(p ≥ 0.05)は灰色にして、「はっきりしない」と書き添えます。数字のラベルが区間の右端に重ならないよう、x 軸の右側を広めに取っています。
def plot_steps(t, title, xlabel, path, color=BLUE):
    fig, ax = plt.subplots(figsize=(8, 3.6))
    y = np.arange(len(t))[::-1]
    for yi, (_, r) in zip(y, t.iterrows()):
        c = color if r.p < 0.05 else GRAY
        ax.hlines(yi, r.lo, r.hi, color=c, lw=2.5); ax.scatter(r.coef, yi, color=c, zorder=3, s=40)
        ax.text(max(r.hi, r.coef) + (t.hi.max() - t.lo.min()) * 0.03, yi, f"{r.coef:+.2f}" + ("" if r.p < 0.05 else "(はっきりしない)"), va="center", fontsize=9)
    ax.axvline(0, color=INK, lw=0.8); ax.set_yticks(y, t.model); ax.set_xlabel(xlabel)
    ax.set_xlim(min(t.lo.min(), 0) - (t.hi.max() - t.lo.min()) * 0.1, t.hi.max() + (t.hi.max() - t.lo.min()) * 0.45)
    ax.set_title(title, loc="left")
    fig.text(0.01, -0.06, SOURCE + "/重回帰・HC3 頑健標準誤差。灰色は95%区間が0をまたぐ", fontsize=8, color="#8a8984")
    fig.savefig(path); plt.close(fig)
全部入りモデルの係数図
full_model() の表は、係数の大きさ順に並べ、プラスで有意なら青、マイナスで有意ならオレンジ、0をまたげば灰色にしています。
def plot_coefs(t, title, xlabel, path):
    t = t.sort_values("coef")
    fig, ax = plt.subplots(figsize=(8, 4.2)); y = np.arange(len(t))
    col = [(BLUE if v > 0 else ORANGE) if p < 0.05 else GRAY for v, p in zip(t.coef, t.p)]
    ax.hlines(y, t.lo, t.hi, color=col, lw=2.2); ax.scatter(t.coef, y, color=col, zorder=3)
    ax.axvline(0, color=INK, lw=0.8); ax.set_yticks(y, t["var"]); ax.set_xlabel(xlabel); ax.set_title(title, loc="left")
    fig.text(0.01, -0.05, SOURCE + "/都道府県固定効果・HC3。灰色は95%区間が0をまたぐ", fontsize=8, color="#8a8984")
    fig.savefig(path); plt.close(fig)
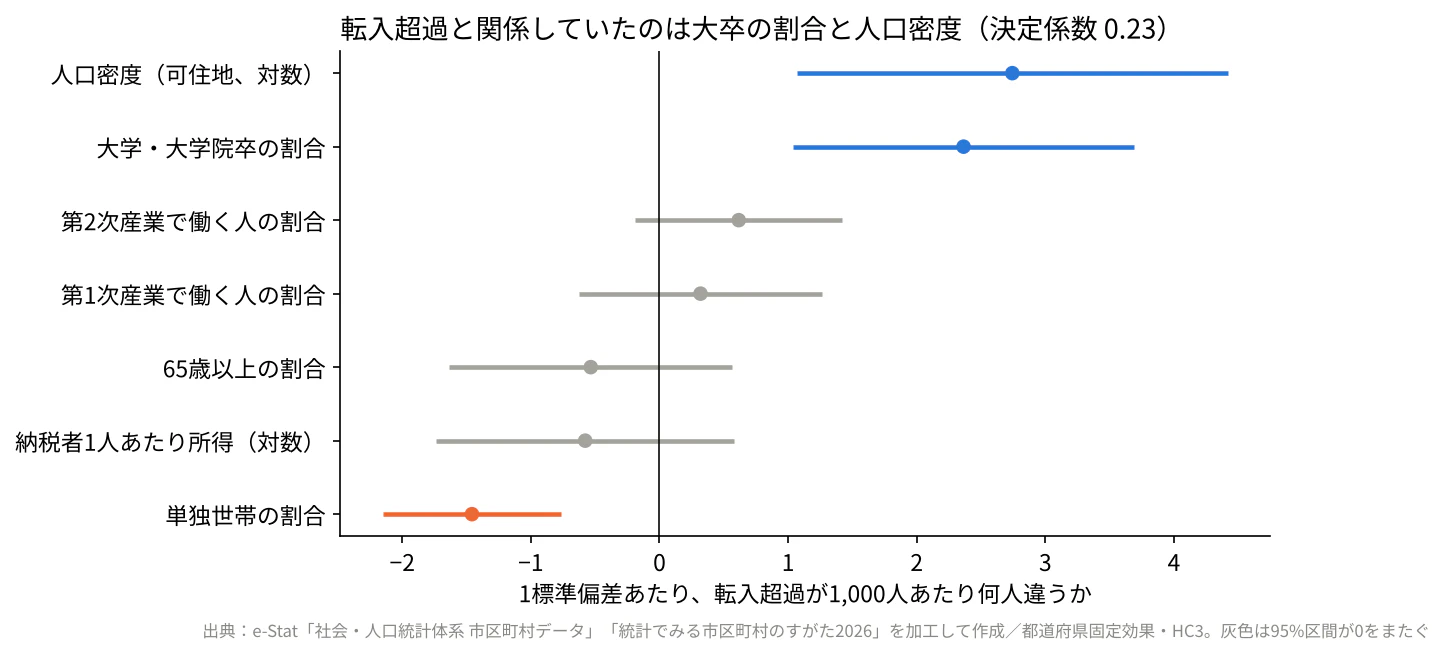
はっきり残ったのは、大学・大学院卒の割合(+2.364)、人口密度(+2.743)、単独世帯の割合(−1.458)でした。決定係数は0.234です。
つまずいた点と落とし穴
-
係数の物差しをそろえる:標準化しないと、割合(0〜1)と対数の係数が並んでも大きさを比べられません。
load()の最後で z 値の列(z_付き)を作っておき、式では必ずz_の列を使うようにしました - 年のずれ:所得は2024年度(2023年の所得)、転入超過は2024年、ほかの条件は主に2020年の国勢調査です。年がそろっていないことは、結果を読む前提として残ります
-
分母の違い:転入超過は住民基本台帳人口(
A2301)で割り、65歳以上の割合などは国勢調査の人口(A1101)で割っています。どの分母を使ったかは README の表に書いて、後から追えるようにしました - 散布図の外れ値:転入超過は人口の少ない町村で大きく振れるので、縦軸を ±40 で切り、そのことを図の注に書いています
- 「消えた」の読み方:係数が0と区別できなくなっても、「関係がない」の証明ではありません。「年齢構成などで説明できる」という意味です。また観察データの横断分析なので、因果(所得が高いから人が来る)は言えません
参考
- note の記事:人が集まっている街は、所得が高い街か? 全国1,740市区町村で「条件をそろえる」と答えが変わった
- コード・データ・図:GitHub articles/008_migration_income
出典:政府統計の総合窓口(e-Stat)(https://www.e-stat.go.jp/)「社会・人口統計体系 市区町村データ」「統計でみる市区町村のすがた2026」(総務省統計局)を加工して作成