
何を確かめたいか
私の分析リポジトリ(記事ごとに README・src・requirements.txt・results/ を置いたもの)が、別の人の環境でも同じ数字を出せるのかを確かめました。この記事では、その確かめ方の実装に絞って書きます。結果の読み方は note の記事に書いています。
コードはすべて GitHub の articles/F165_reproducibility_audit にある実行済みのもので、抜粋して載せています。
全体は6本のスクリプトです。
| スクリプト | やること |
|---|---|
01_棚卸し.py |
379本を動かさずに読み、危ない点を数える |
02_抽出.py |
4つの層から10本ずつ、無作為に40本を選ぶ |
03_実行.py |
記事ごとに新しい仮想環境を作り、README の手順を上から実行する |
04_比較.py |
作り直した results/ を元のファイルと相対誤差で比べる |
05_集計.py |
判定・重み付きの推定・頑健性チェック |
06_図.py |
図を書く |
1. 動かさずに棚卸しする(01)
379本すべてを、実行せずにコードと requirements.txt だけ読んで数えます。import は正規表現ではなく ast(Python の構文木)で拾い、標準ライブラリは sys.stdlib_module_names で除きます。
def imports(code):
    mods = set()
    try:
        tree = ast.parse(code)
    except SyntaxError:
        return None
    for n in ast.walk(tree):
        if isinstance(n, ast.Import):
            for a in n.names: mods.add(a.name.split(".")[0])
        elif isinstance(n, ast.ImportFrom) and n.module and n.level == 0:
            mods.add(n.module.split(".")[0])
    return mods
n.level == 0 で相対 import(from . import x)を外し、同じフォルダの自作モジュール(local = {p.stem for p in py})も外します。残ったものを requirements.txt の名前と比べますが、import 名と pip の名前は一致しないことがあるので、対応表を置いています。
ALIAS = {"sklearn": "scikit-learn", "PIL": "pillow", "cv2": "opencv-python", "bs4": "beautifulsoup4",
         "yaml": "pyyaml", "mpl_toolkits": "matplotlib", "dateutil": "python-dateutil", ...}
ネット接続・他の記事フォルダの参照・絶対パスは、正規表現で拾います。
NET = re.compile(r"requests\.(get|post|Session)|urllib\.request|urlopen|urlretrieve|httpx|wget|curl |pd\.read_(csv|excel|html|json)\(\s*['\"]https?://|aiohttp")
XREF = re.compile(r"\.\./\.\./|\.\./(F\d+|\d{3})_|articles/(F\d+|\d{3})_")
乱数は「使っているか」と「種を固定しているか」を別々に見ます。RandomForest や train_test_split のように、乱数を内部で使う呼び出しも「使っている」に数えています。
結果(379本)は、README の再現手順と requirements.txt はすべてにあり、版を全部 == で固定していたのは5本、コードがネットにつなぐのは66本、requirements.txt に書いていない部品がある記事は13本でした。
2. 層別に40本を選ぶ(02)
看板記事(手順の長い記事)と通常記事を、番号の前半・後半に分けた4層から10本ずつ選びます。種は165です。
rng = np.random.default_rng(165)
parts = []
for s, g in d.groupby("stratum"):
    idx = rng.choice(len(g), size=min(10, len(g)), replace=False)
    parts.append(g.iloc[sorted(idx)].assign(N_stratum=len(g)))
各層の大きさ N_stratum を一緒に持たせておき、あとで379本全体への重み付けに使います。
3. 記事ごとに新しい環境で動かす(03)
ここがいちばん大事なところです。記事ごとに uv で仮想環境を作り、その記事の requirements.txt だけを入れます。版は、記事を書いた環境と同じものに制約ファイル(-c)でそろえます。
subprocess.run([UV, "venv", "-q", "--python", sys.executable, str(wd / ".venv")], env=ENV0, capture_output=True)
cmd = [UV, "pip", "install", "-q", "--python", str(wd / ".venv" / "bin" / "python"), "-r", str(wd / "requirements.txt")]
if a.constraints: cmd += ["-c", a.constraints]
-c は「入れるなら、この版にする」という指定で、requirements.txt に書いていない部品を勝手に入れることはしません。こうすると、版の違いではなく「書いたものだけで動くか」を確かめられます。
実行の前に、元の results/ と figures/ を別の場所へ退避して、空のフォルダにします。こうしないと、手順が途中で止まっても古い結果が残っていて「一致」と判定してしまいます。
for sub in ("results", "figures"):
    if (wd / sub).exists():
        shutil.move(str(wd / sub), str(exp / sub)); (wd / sub).mkdir()
手順は README のコードブロックから読みます。cd は作業フォルダの移動として追い、python / bash で始まる行を手順にします。
blocks = re.findall(r"```(?:bash|sh|shell|console)?\n(.*?)```", t, re.S)
for b in blocks:
    cmds, cwd = [], "."
    for line in b.splitlines():
        line = line.split("#")[0].strip().lstrip("$ ").strip()
        for c in [x.strip() for x in line.split("&&") if x.strip()]:
            if c.startswith("cd "):
                cwd = os.path.normpath(os.path.join(cwd, c[3:].strip()))
            elif re.match(r"^(python3?|bash|sh)\s+\S+", c):
                cmds.append((cwd, c))
実行時は、仮想環境の bin を PATH の先頭に置き、PYTHONNOUSERSITE=1 でユーザーのフォルダに入っている部品も見えなくします。1本あたり600秒が上限です。
env = dict(ENV0); env["PYTHONNOUSERSITE"] = "1"
if not a.system:
    env["PATH"] = str(wd / ".venv" / "bin") + ":" + env["PATH"]; env["VIRTUAL_ENV"] = str(wd / ".venv")
止まった手順は、エラー文から原因を分類します(通信・部品の記載漏れ・ファイルがない・版の違い など)。この作業環境は政府サイトにつながらないので、「最初の取得だけが通信で止まった」ものは別に数えます。
4. 元の結果と比べる(04)
作り直した results/ の CSV・JSON・テキストを、元のファイルと比べます。CSV は列名と形をまず比べ、文字の列は完全一致、数値の列は相対誤差で段階をつけます。
LEVELS = [("完全一致", 0.0), ("1e-6以内", 1e-6), ("1e-3以内", 1e-3), ("1e-2以内", 1e-2)]

def level(a, b):
    a = np.asarray(a, float); b = np.asarray(b, float)
    if a.shape != b.shape: return "形が違う"
    ...
    scale = np.nanmax(np.abs(b)) if np.isfinite(b).any() else 1.0
    den = np.maximum(np.abs(b), 0.01 * scale + 1e-300)
    rel = np.abs(a - b) / den
分母に下限(その列の最大の絶対値の1%)を入れているのは、0 に近い値で相対誤差が大きく出すぎるのを防ぐためです。JSON やテキストは、数字だけを抜き出して同じ基準で比べます。実行ログのファイルは、時刻が入るので除きました。
記事ごとに「いちばん悪いファイル」の段階を取り、1e-3(0.1%)以内なら「数字が一致」とします。
5. 判定と重み付け(05)
手順の通り方と数字の一致を組み合わせて、4つに分けます。
if not match: v = "数字がずれた"
elif steps == "全部動いた": v = "そのまま再現"
elif steps == "取得だけ通信で止まった": v = "取得以外は再現"
else: v = "手順が止まったが数字は一致"
379本全体の割合は、層の大きさで重み付けし、有限母集団の補正 (1 - n/N) を入れた層別の標準誤差で区間を出します。
for s, g in df.groupby("stratum"):
    N, n = g.N_stratum.iloc[0], len(g); p = cond(g).mean()
    est += N / Ntot * p; var += (N / Ntot) ** 2 * (1 - n / N) * p * (1 - p) / max(n - 1, 1)
結果は、40本のうちそのまま再現が29本、数字が一致したのが33本(83%)、重み付けした379本全体の推定は85%(95%区間 77〜94%)でした。通常記事は20本すべてそのまま再現し、看板記事は20本中9本でした。
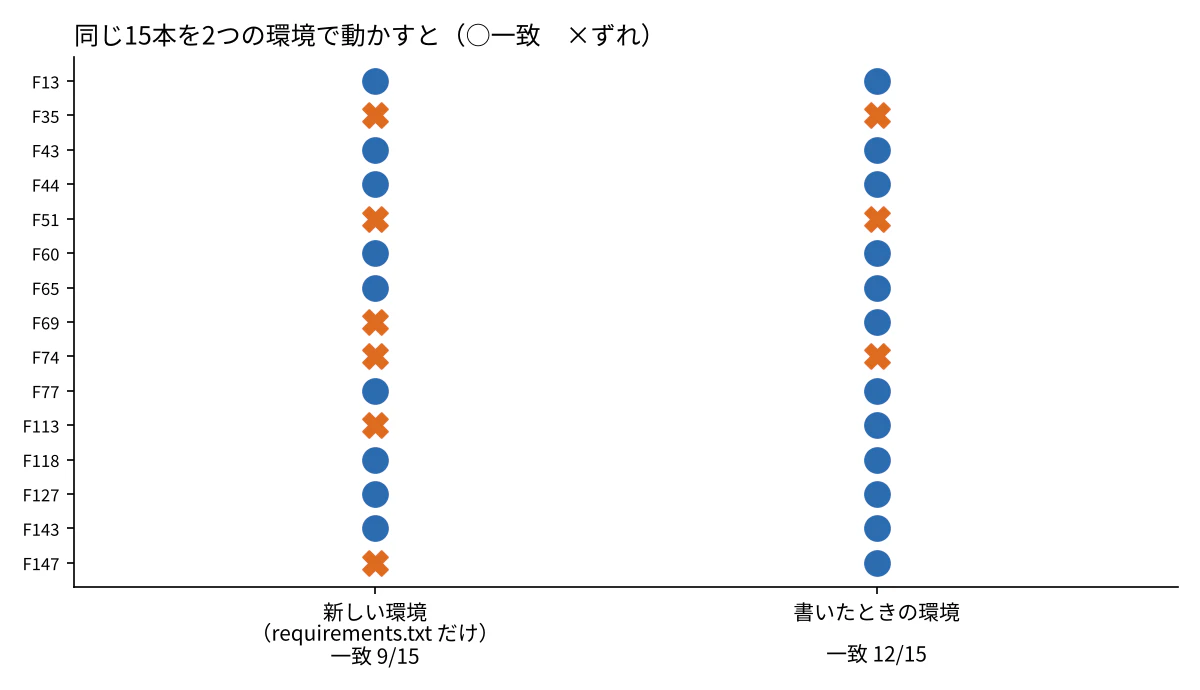
頑健性チェックとして、同じ verdict() を許容誤差(1e-6・1e-3・1e-2)と「並び順を無視するか」で回し直しています。一致は33〜35本で、ほとんど動きませんでした。また、03_実行.py --system で、仮想環境を作らずに記事を書いた環境のまま看板記事15本を動かすと、一致は9本から12本に増えました。
6. 図(06)
図は matplotlib の横棒グラフで、判定の内訳、看板記事ごとの結果ファイルの一致の割合、2つの環境の比較(○と×)、棚卸しの項目別の本数、許容誤差ごとの一致数の5枚です。

つまずいた点と落とし穴
-
空のフォルダは git に残らない:取得したファイルの保存先
data/raw/がリポジトリになく、取得の手順が止まった記事がありました。手元では動くので気づけません。 - 結果を空にしないと、止まっても一致に見える:results/ を退避してから動かさないと、古いファイルとの比較になります。
- 「自分の環境で動く」は確認にならない:版をそろえても、requirements.txt に書いていない部品のあり・なしで結果が変わった記事が3本ありました。どの部品が効いたのかは特定していません(推測)。
- 並び順のずれ:同じ値の行の順番が入れ替わるだけで「ずれ」と判定される記事がありました。比べる前に並べ替えるかどうかは、頑健性チェックで分けて数えています。
-
import 名と pip の名前は違う:
sklearnとscikit-learnのような対応表がないと、記載漏れを多く数えすぎます。
言えないこと
- 図(PNG)は比べていません。数字が一致しても、図が同じとは限りません。
- 通信で止まった取得の手順は確かめていません。
- 40本の抽出なので、379本全体の割合には±9ポイントくらいの幅があります。
- 「新しい環境」でも Python の版と OS は同じです。
- 比べたのは保存してある results/ で、記事の本文の数字とは照らし合わせていません。
参考
- note:データ分析の「再現できる形」は、どこまで作れたか?
- コード・データ・図:GitHub articles/F165_reproducibility_audit
- 出典:takayuki-0127/japan-open-data-notes(コミット de944aa)の記事フォルダを実行・集計して作成