
何を確かめたいか
国会の発言に「賃上げ」「物価」などの語がいつ増え、どんな言葉と一緒に語られてきたかを、1985〜2026年について調べました。この記事では、その分析を Python でどう実装したかに絞って書きます。結果の読み方は note の記事にまとめています。
コードはすべて GitHub の articles/F09_diet_text/ にあり、ここに載せるのはそこから抜き出したものです。
全体の流れ
pip install -r requirements.txt
cd src
python 01_fetch_api.py   # API から取得(約1,200回、30分ほど)。data/ にある取得済みファイルを使うなら飛ばす
sh run_all.sh            # 02 形態素解析 → 03 頻度 → 04 共起・トピック → 05 図
| ファイル | やること |
|---|---|
01_fetch_api.py |
API から発言数と抜粋を取得(キャッシュつき) |
02_tokenize.py |
形態素解析(名詞だけ、人名・定型語を除く) |
03_freq.py |
出現率、統計との相関、会議の範囲・表記ゆれの頑健性 |
04_cooc_topics.py |
年代別の特徴語、共起ネットワーク、LDA と頑健性、語の割合 |
05_figures.py |
図5枚 |
使ったライブラリは pandas・numpy・matplotlib・scikit-learn・networkx・fugashi・unidic-lite・requests です。
1. データの取り方:国会会議録検索システム API
国立国会図書館の国会会議録検索システムには、発言単位で検索できる API(https://kokkai.ndl.go.jp/api/speech)があります。語(any)と期間(from・until)を指定すると、その語を含む発言の件数(numberOfRecords)と本文が JSON で返ってきます。
キャッシュつきの取得関数
同じ条件で何度もアクセスしないよう、パラメータの MD5 をファイル名にしてキャッシュします。サーバーに負担をかけないよう、取得のたびに1.2秒あけています。
BASE = "https://kokkai.ndl.go.jp/api/speech"
ROOT = Path(__file__).resolve().parents[1]
CACHE = ROOT / "data" / "raw" / "cache"
CACHE.mkdir(parents=True, exist_ok=True)


def get(params):
    key = hashlib.md5(json.dumps(params, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
    f = CACHE / f"{key}.json"
    if f.exists():
        return json.loads(f.read_text())
    for _ in range(3):
        try:
            r = requests.get(BASE, params={**params, "recordPacking": "json"}, timeout=60)
            r.raise_for_status()
            j = r.json()
            f.write_text(json.dumps(j, ensure_ascii=False))
            time.sleep(1.2)
            return j
        except Exception:
            time.sleep(5)
    raise RuntimeError(params)
json.dumps(..., sort_keys=True) にしておくと、辞書のキーの順番が違っても同じキャッシュに当たります。途中で止まっても、再実行すれば取得済みの分は飛ばせます。
件数だけを取る:maximumRecords=1
出現率の分子と分母は「件数」だけあれば足ります。maximumRecords=1 にして本文をほとんど受け取らず、numberOfRecords だけを読みます。語を指定しない(any なし)ときの件数が、その年の発言の総数(分母)になります。
KEYWORDS = ["", "賃上げ", "物価", "少子化", "デフレ", "インフレ", "円安", "物価高", "好循環",
            "非正規", "生産性", "最低賃金", "働き方改革", "賃金引上げ", "賃金の引上げ", "ベースアップ"]
MAIN4 = ["", "賃上げ", "物価", "少子化", "デフレ"]
SCOPES = ["本会議", "予算委員会"]          # nameOfMeeting(部分一致)
YEARS = range(1985, 2027)
LAST_DAY_2026 = "2026-10-24"


def span(y):
    return f"{y}-01-01", (LAST_DAY_2026 if y == 2026 else f"{y}-12-31")


def counts():
    rows = []
    for y in YEARS:
        fr, un = span(y)
        jobs = [(k, "") for k in KEYWORDS] + [(k, s) for s in SCOPES for k in MAIN4]
        for k, s in jobs:
            p = {"from": fr, "until": un, "maximumRecords": 1}
            if k:
                p["any"] = k
            if s:
                p["nameOfMeeting"] = s
            rows.append([y, k, s, int(get(p)["numberOfRecords"])])
    ...
語×年×会議の範囲の組み合わせで、約1,100回のアクセスになりました。
本文の抜粋:無作為な位置から連続100件
話題の中身を見るために、「賃上げ」「物価」それぞれについて、年ごとに無作為な位置(startRecord)から連続100件の発言を取り、語の前後150字を最大5か所まで抜き出します。
def sample(rows, k_list=("賃上げ", "物価"), per=100, window=150, seed=12345):
    """年×語ごとに、ランダムな位置から連続100件の発言を取り、語の前後150字を抜き出す"""
    rnd = random.Random(seed)
    n_of = {(y, k): n for y, k, s, n in rows if s == ""}
    out = gzip.open(ROOT / "data" / "raw" / "contexts_sample.jsonl.gz", "wt", encoding="utf-8")
    for y in YEARS:
        for k in k_list:
            n = n_of.get((y, k), 0)
            if not n:
                continue
            st = 1 + rnd.randrange(n - per + 1) if n > per else 1
            fr, un = span(y)
            j = get({"from": fr, "until": un, "any": k, "maximumRecords": per, "startRecord": st})
            for r in j.get("speechRecord", []):
                sp = r["speech"]
                ctx, i, c = [], sp.find(k), 0
                while i >= 0 and c < 5:
                    ctx.append(sp[max(0, i - window): i + window]); i = sp.find(k, i + window); c += 1
                ...
発言の全文を使わず前後150字に絞ったのは、長い答弁の中でその語と関係のない部分まで拾わないためです。抜粋は合計6,632発言になりました。
2. 前処理:fugashi で名詞だけを残す
形態素解析(文を単語に分け、品詞をつける処理)には fugashi(MeCab の Python ラッパー)と辞書の unidic-lite を使いました。
正規化と発言者名の除去
会議録の本文は「○委員長(…) 」のように発言者名で始まります。これを正規表現で消し、数字も消しておきます。
def clean(s):
    s = unicodedata.normalize("NFKC", s)
    s = re.sub(r"○\S+? ", " ", s)          # 発言者名
    s = re.sub(r"[0-90-9,,..%%]+", " ", s)
    return s
NFKC 正規化で全角英数字や半角カナがそろうので、先に正規化してから正規表現をかけています。
品詞での絞り込み
    tagger = fugashi.Tagger()
    ...
        for w in tagger(clean(r["ctx"])):
            f = w.feature
            if f.pos1 != "名詞" or f.pos2 in ("数詞", "代名詞") or f.pos2 == "助動詞語幹" or f.pos3 == "人名":
                continue
            lemma = f.lemma if f.lemma and f.pos2 != "固有名詞" else w.surface
            lemma = w.surface if lemma is None else lemma
            if len(w.surface) < 2 or w.surface in STOP or lemma in STOP:
                continue
            toks.append(w.surface)
-
pos1 == "名詞"だけを残し、数詞・代名詞を除く -
pos3 == "人名"で人名を除く(特定の議員の評価にならないようにするため) - 1文字の語と、ストップワード(「こと」「問題」「大臣」「答弁」など国会でどの話題にも出る語)を除く
ストップワード(STOP)には、定型語のほかに、日銀総裁や首相などの名前も入っています。pos3 == "人名" だけでは落としきれない名前を補うためだと思います(推測)。
3. 出現率と統計との相関
発言1万件あたりに直す
国会の発言数は年によって違う(1年に7万〜16万件)ので、件数を「発言1万件あたり」に直してから比べます。
c = pd.read_csv(DATA / "counts_by_year.csv", keep_default_na=False)
tot = c[c.keyword == ""].set_index(["scope", "year"]).n
c = c[c.keyword != ""].copy()
c["total"] = [tot[(s, y)] for s, y in zip(c.scope, c.year)]
c["per10k"] = c.n / c.total * 1e4
keep_default_na=False が大事です。語なし(総数)と会議の範囲なし(全会議)を空文字で保存しているので、これを付けないと pandas が空文字を NaN にしてしまい、keyword == "" で総数の行を取り出せなくなります。
3年ブロックのブートストラップで相関の幅を見る
年ごとの値は前の年と似やすい(自己相関がある)ので、1年ずつばらばらに取り直すと幅が狭く出すぎます。3年ずつのかたまりで取り直して、相関の95%区間を出しました。
def boot_ci(a, b, n=2000, seed=1):
    rng = np.random.default_rng(seed); idx = np.arange(len(a)); v = []
    for _ in range(n):
        # 3年のブロックブートストラップ(自己相関を考える)
        starts = rng.integers(0, len(a) - 2, size=len(a) // 3 + 1)
        ii = np.concatenate([idx[s:s + 3] for s in starts])[:len(a)]
        v.append(np.corrcoef(a.values[ii], b.values[ii])[0, 1])
    return np.round(np.percentile(v, [2.5, 97.5]), 3).tolist()
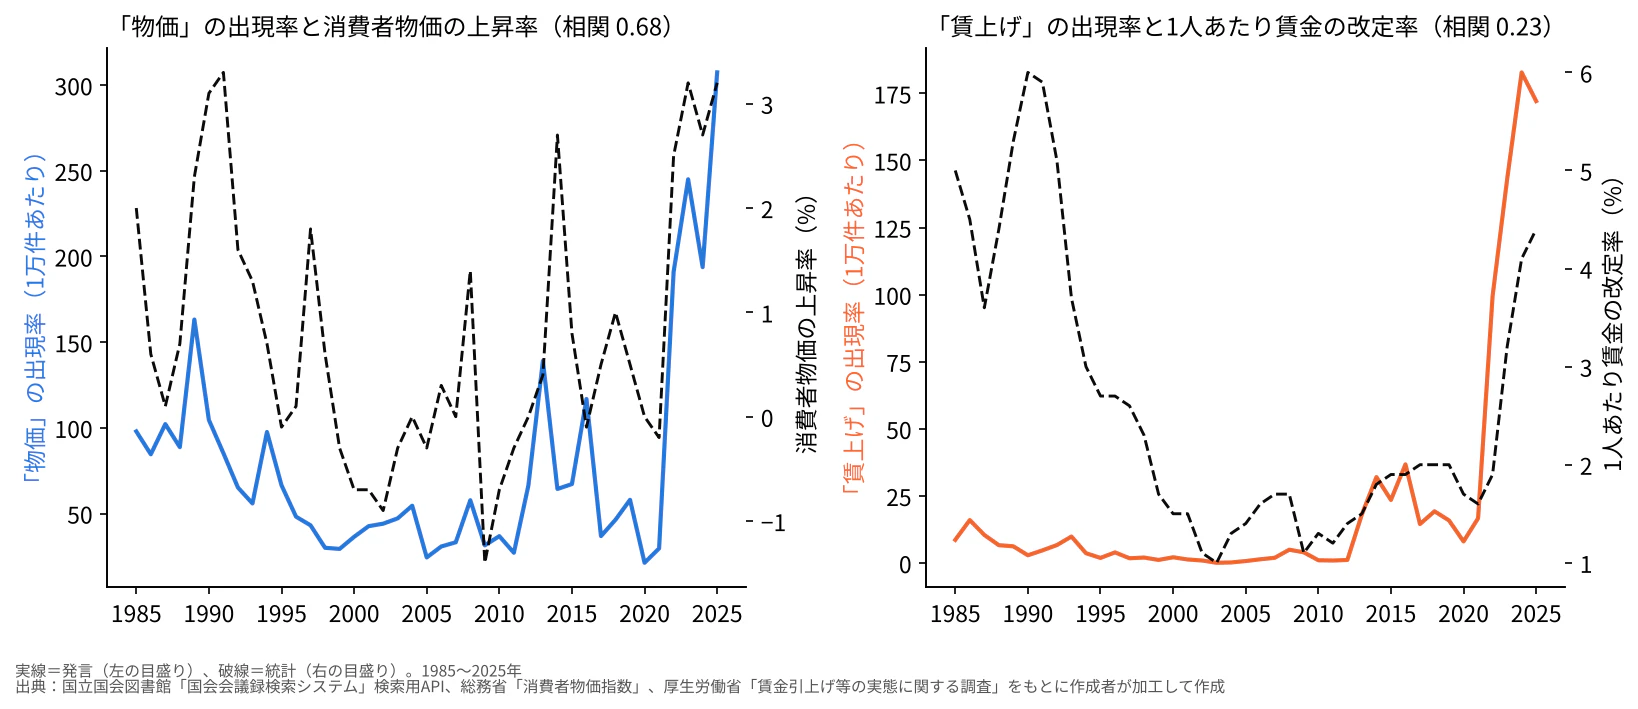
結果は、「物価」の出現率と消費者物価の上昇率が相関0.68(95%区間0.27〜0.84)、「賃上げ」の出現率と賃上げ率が全期間で0.23(−0.20〜0.66)でした。同じスクリプトで、期間を2013〜2025年に限った相関(賃上げは0.92)と、前後1〜2年ずらした相関も出しています。
4. 年代ごとの特徴語:重み付き対数オッズ比
「賃上げ」と一緒に出る言葉を単純に数えると、どの年代でも「賃金」「企業」のような語が上位に来て、年代の違いが見えません。そこで、Monroe ほか(2008)の事前分布つきの重み付き対数オッズ比を使い、「その年代でほかの年代より目立つ語」を z 値で並べました。
def log_odds(cnt_a, cnt_b, prior, a0):
    """重み付き対数オッズ比(Monroe ほか 2008、事前分布つき)。z 値を返す"""
    na, nb = sum(cnt_a.values()), sum(cnt_b.values())
    out = {}
    for w in set(cnt_a) | set(cnt_b):
        ya, yb, aw = cnt_a.get(w, 0), cnt_b.get(w, 0), prior[w] * a0
        da = np.log((ya + aw) / (na + a0 - ya - aw)); db = np.log((yb + aw) / (nb + a0 - yb - aw))
        var = 1 / (ya + aw) + 1 / (yb + aw)
        out[w] = (da - db) / np.sqrt(var)
    return out
ポイントは2つです。
-
数え方:
set(t)にして「その語が出た発言の数」で数えています。1つの長い答弁で同じ語が何度も出ても、1件です -
事前分布:全年代の語の割合(
prior)にa0=500をかけた分を足しています。出現回数が少ない語ほど、全体の割合に引き寄せられるので、たまたま数回出ただけの語が上位に来にくくなります
呼び出し側では、さらに「その年代で8発言以上に出た語」だけを候補にし、z 値の上位12語を残しています。
検索語そのもの(「賃上げ」の抜粋なら「賃上げ」「賃金」)は KW で除いています。
5. 共起ネットワーク:Jaccard 係数
よく一緒に出る言葉どうしを線で結ぶ図です。年代ごとに、出た発言の数が多い30語をノードにし、2語の組み合わせを数えて Jaccard 係数(両方が出た発言の数 ÷ どちらかが出た発言の数)で強さを測ります。
    sets = [set(t) - KW["賃上げ"] for t in sub.toks]
    df_ = Counter(w for s in sets for w in s)
    nodes = [w for w, _ in df_.most_common(30)]
    co = Counter()
    for s in sets:
        for a, b in itertools.combinations(sorted(s & set(nodes)), 2):
            co[(a, b)] += 1
    edges = []
    for (a, b), n in co.items():
        jac = n / (df_[a] + df_[b] - n)
        edges.append((a, b, jac))
    edges = sorted(edges, key=lambda e: -e[2])[:45]
sorted(...) してから combinations を取ると、(A, B) と (B, A) が同じキーになります。単純な共起回数ではなく Jaccard 係数にしたのは、どちらもよく出る語どうしが、それだけで強く結ばれてしまうのを避けるためです。
描画は networkx の spring_layout で、乱数の種を固定しています(seed=3)。種を固定しないと、実行のたびに配置が変わります。

6. トピックモデル(LDA)
LDA は、1つの文書が複数の話題の組み合わせでできていると考え、よく一緒に出る語のまとまりを「話題」として取り出す方法です。scikit-learn の LatentDirichletAllocation を使いました。
texts = [" ".join(t) for t in d.toks]


def fit(K, seed):
    vec = CountVectorizer(tokenizer=str.split, lowercase=False, min_df=10, max_df=0.4, token_pattern=None)
    X = vec.fit_transform(texts)
    lda = LatentDirichletAllocation(n_components=K, random_state=seed, learning_method="batch", max_iter=60,
                                    doc_topic_prior=0.1, topic_word_prior=0.05)
    th = lda.fit_transform(X)
    vocab = np.array(vec.get_feature_names_out())
    tops = [list(vocab[np.argsort(-lda.components_[j])[:15]]) for j in range(K)]
    return th, tops, lda.perplexity(X), X.shape
CountVectorizer の設定で気をつけた点です。
-
tokenizer=str.split:形態素解析はすでに済んでいるので、空白で区切るだけにしています。既定のままだと英語向けの区切り方(2文字以上の英数字)になり、日本語の語が正しく切れません -
token_pattern=None:tokenizerを渡すときにこれを付けないと、使われないtoken_patternについて警告が出ます -
lowercase=False:日本語には不要なので切っています -
min_df=10, max_df=0.4:10発言未満にしか出ない語と、4割を超える発言に出る語を除いています
doc_topic_prior=0.1(文書ごとの話題の偏りやすさ)と topic_word_prior=0.05(話題ごとの語の偏りやすさ)は、どちらも scikit-learn の既定値(1/K)より小さくしています。
各発言の話題の割合(th)を年ごとに平均すれば、話題の構成比の推移になります。
話題の名前は、上位の語を見て私が付け、lda_labels.py に書いています。

7. 頑健性チェックの実装
トピック数・乱数の種を変えたときの対応づけ
LDA は、トピック数や乱数の種を変えると、トピックの番号も中身も変わります。そこで、K=8 の各トピックについて、上位15語の Jaccard 係数がいちばん高いトピックを相手として選び、年ごとの構成比の相関を見ました。
for K, seed in [(6, SEED), (10, SEED), (8, SEED + 1), (8, SEED + 2)]:
    th2, tops2, ppl2, _ = fit(K, seed)
    sh2 = pd.DataFrame(th2).assign(y=d.y.values).groupby("y").mean()
    for j in range(8):
        jac = [len(set(tops[j]) & set(t)) / len(set(tops[j]) | set(t)) for t in tops2]
        m = int(np.argmax(jac))
        rob.append({"K": K, "seed": seed, "topic_k8": j, "best_match": m, "jaccard": round(jac[m], 2),
                    "share_corr": round(base_share[f"t{j}"].corr(sh2[m]), 3)})
構成比の相関の中央値は0.90〜0.97でした。
トピックモデルを使わない確認
LDA の結果だけに頼らないよう、「賃上げ」の抜粋のうち、決めた語のどれかを含む発言の割合も出しています。
groups = {"労使系(春闘・労使・組合・交渉)": {"春闘", "労使", "組合", "交渉"},
          "政策系(税制・支援・補助・助成)": {"税制", "支援", "補助", "助成"}}
rows = []
for lab in [p[2] for p in PERIODS]:
    sub = d[(d.k == "賃上げ") & (d.period == lab)]
    for g, ws in groups.items():
        rows.append({"period": lab, "group": g, "share": round(np.mean([bool(set(t) & ws) for t in sub.toks]), 3), "n": len(sub)})
労使系の語を含む割合は1985〜94年の50%から2015〜26年は17%に、政策系は5%から37%になり、LDA と同じ向きでした。
会議の範囲と表記ゆれ
03_freq.py では、全会議と本会議・予算委員会の出現率の相関(「賃上げ」0.98・0.99)と、「賃上げ」と「賃金の引上げ」(0.85)・「賃金引上げ」(0.75)・「ベースアップ」(0.35)の出現率の相関も、同じ pivot の形で出しています。

8. 図の出し方
05_figures.py で5枚の図を作っています。出現率の推移の図では、2026年は10月24日までの途中の値なので、最後の1区間だけ点線にし、凡例の代わりに線の右端に語を書いています。日本語フォントは common.py で Noto Sans CJK を探して登録しています。

つまずいた点と落とし穴
-
会議名の指定は部分一致:
nameOfMeeting="予算委員会"は分科会・公聴会も含みます。「予算委員会だけ」の数字として読むと少しずれます -
1発言1件:
numberOfRecordsは「その語を含む発言の数」で、出てきた回数ではありません。長い答弁が増えると、同じ件数でも語られた量は違います - 連続100件の抜粋は固まる:無作為なのは開始位置だけなので、同じ会議の発言がまとまって入ることがあります。1995〜2004年の「賃上げ」は発言そのものが少なく、173件しかありません
-
抜粋は取り直すと少し変わる:記事では同じ手順をブラウザのページ内で実行して取得しており、抜粋を取る位置の乱数だけ
01_fetch_api.pyと違います。01で取り直すと、抜粋の中身は少し変わります -
人名の除去:品詞の
pos3 == "人名"に加えて、ストップワードにも人名が入っています。辞書だけでは落としきれない名前があったためと思われます(推測) - LDA のトピックは種で混ざる:「春闘と労使交渉」は乱数の種によってほかの話題と混ざることがあり(構成比の相関0.50の組がありました)、そのために語の割合での確認を足しました
言えないこと
- 発言の量は「国会でどれだけ話題になったか」の目安で、政策の効果や良し悪しを表すものではありません
- 特定の政党・議員の評価はしていません(会派・発言者では分けておらず、人名は分析から除いています)
- トピックの名前は、上位の語を見て私が付けたものです
参考
- note の記事:国会で「賃上げ」はいつから語られるようになったのか?
- コードと集計結果:GitHub articles/F09_diet_text
- 国立国会図書館「国会会議録検索システム」検索用API:https://kokkai.ndl.go.jp/api.html
- Monroe, Colaresi, Quinn (2008) "Fightin' Words: Lexical Feature Selection and Evaluation for Identifying the Content of Political Conflict", Political Analysis
出典:国立国会図書館「国会会議録検索システム」検索用API、総務省「消費者物価指数」、厚生労働省「賃金引上げ等の実態に関する調査」をもとに作成者が加工して作成