

この記事について
前回の記事では、脆弱性対応という1つの仕事を、Sysdig Secureの中にいるエージェントと、私の手元のClaude Codeがどう分担するのかを実測しました。その結びで、次にやることとして「Posture(設定の健全性)のドメインでも、同じ『判定と実行の分担』が成り立つかを確かめる」と予告しました。
この記事は、その宿題への答えです。
脆弱性対応が「古くなった部品を新しい部品に取り替える仕事」だとすれば、今回のテーマであるPosture対応は、「工場の設定盤に並んだスイッチを、正しい位置に戻す仕事」に近いものです。パッケージのバージョンではなく、設定ファイルやカーネルパラメータの値そのものが検査対象になります。対象が変わっても、Sysdig SecureとClaude Codeの役割分担は同じ形を保つのか——それを、前々回の記事で構築した自宅ラボのサーバに対して、実際に1件の設定を検査・修正・確認するところまで走らせて確かめます。
作業を実行したのは、これまでと同じくFalcoya-co-CTO——Claude Codeを使って組み上げたAIエージェントです。検査結果の読み解き、修正手順の作成、設定ファイルの追加、サーバへの適用、そして結果の再確認まで、手を動かしたのはこのエージェントでした。私がやったのは、承認と方針判断だけです。この記事の文章自体も、Falcoya-co-CTOとの対話を通じてAIエージェントが書いています。
この記事の数値について: 登場する件数・要件名・コマンド・ログは、すべて2026年9月15日に自宅ラボ環境で実際に取得した実測値です。ホスト名やIPアドレスは自宅ラボの構成例として一般化した表記です。
舞台の説明: 前々回の記事で構築した「クラスタの外に立てた単体のLinuxサーバ」が、今回の主役です。このサーバは日常的にAnsibleで構成管理されていて、変更はすべてGitHub経由のレビュー・承認を経て適用されます。今回はその仕組みを使って、Sysdig Secureが検査した設定項目のうち1つを、実際に直します。
1. 今日の相棒は「検査官」——脆弱性とは少し違う仕事
最初に、今回の仕事がどういう性質のものかを整理します。
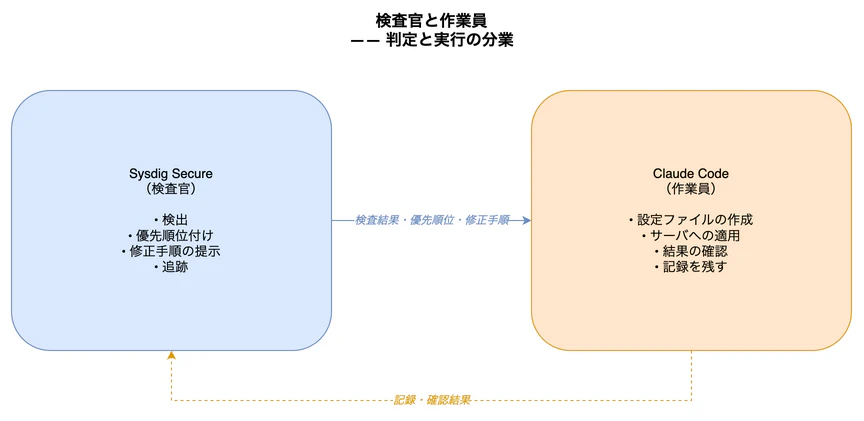
Sysdig Secureは、サーバの設定ファイルやカーネルパラメータを、CIS Benchmarkという業界標準の基準表と1つずつ照合し、「このスイッチが正しい位置にない」と指摘してくれます。CIS Benchmarkは、Center for Internet Securityという非営利団体が公開している、OSやミドルウェアの「安全な設定はこうあるべき」という基準集です。いわば、検査官の役割です。
一方のClaude Codeは、その指摘を受け取って、実際に現場(自宅ラボのサーバ)へ足を運び、設定ファイルを書き換え、変更の記録(プルリクエスト)を残す——作業員の役割を担います。
前回の記事で確かめた境界線と、実はまったく同じ形です。判定・優先順位付け・追跡はSysdigの領分。実際に手を動かして直すのは、Sysdigの外側で起きる。 対象が「パッケージのバージョン」から「設定ファイルの値」に変わっても、この境界線は揺らぎません。
💡 補足: Sysdig Secure AIのエージェント群には、実は最初から「Posture Agent」という専任の担当も用意されています。今回はそちらを使わず、Claude Code側に用意した専用の手順(前回の記事で言う経路B)で進めました。同じ検査結果を、どちらの担い手が引き継いでもよい——という設計自体は、前回確認した「2つの道」の考え方とつながっています。
📌 この章のまとめ: Postureドメインでも、「検査官」と「作業員」の分業は変わりません。今回は、その分業を実際に1周走らせて確かめます。
2. 「何が問題か」——あらかじめ描かれた基準表との照合
この章で分かること: Sysdigの「検査」が、実際には何をしているのか。前回記事で確認した「事前計算済みの読み出し」という発想が、Postureドメインでも同じ形で成り立っていること。
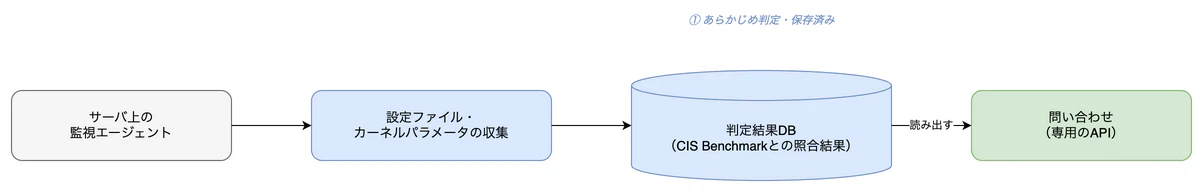
- サーバ上の監視エージェントが、設定ファイルやカーネルパラメータ、パッケージの状態を定期的に収集します。
- CIS Benchmarkとの照合(Sysdig Secure側の処理)が、収集結果を基準表と突き合わせ、各項目の合格・不合格を判定します。
- 判定結果があらかじめ保存され、問い合わせを受けるとそこから読み出されます。
これは前回記事で確認した脆弱性検出の仕組み——「その場でスキャンする」のではなく「あらかじめ評価済みの結果を読み出す」——と、まったく同じ発想です。対象が変わっても、Sysdigの基本設計は一貫しています。
💡 知っておくと得をする点(問い合わせの窓口): 前回記事では、グラフ型のクエリ言語を使って脆弱性データに直接問い合わせていました。今回のような、クラスタの外に立つ単体サーバの設定検査には、そのクエリ言語ではなく専用の窓口(API)を使います。対象がコンテナイメージか、単体のサーバかによって、適切な入口を選ぶ——これも、実際に手を動かして初めて分かったコツの1つです。
💡 知っておくと得をする点(時間差): 検出の間隔と、実際の設定変更のタイミングには時間差が生じます。今回も、修正を適用した直後に再確認したところ、Sysdig側はまだ「未修正」と報告しました(詳しくは第7章で扱います)。これは仕組みそのものの性質であり、次回の検査で正しく反映されます。
📌 この章のまとめ: 検査は「あらかじめ描かれた地図」からの読み出しです。脆弱性ドメインで確認した発想が、設定の健全性チェックでも同じ形で成り立っています。
3. どれから直すか——単純明快な優先順位信号
この章で分かること: 優先順位の付き方。そして、前回記事とは対照的に「今回はシンプルな指標がよく効いた」という発見。
3-1. severityでは並べられない
今回のサーバでは、CIS Ubuntu Linux 24.04 LTS Benchmarkという基準表に対して、150件の項目が不合格でした。前回記事では、CVSSやEPSS、悪用実績の有無など複数の指標を合成したランキングが主役でしたが、今回はまったく違う事情がありました。
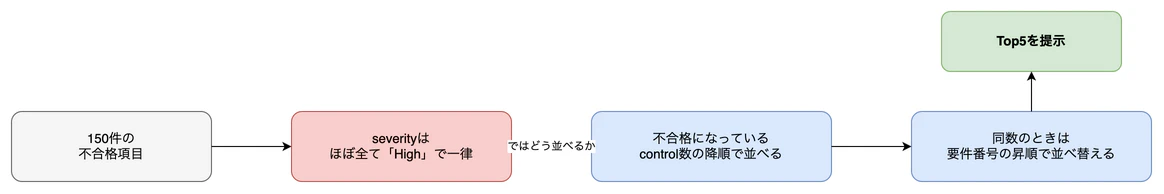
不合格項目のseverityが、ほぼすべて「High」で一律だったのです。 ネットワーク関連の基準はこの表自体がHighに統一されているため、severityだけでは優先順位を区別できません。そこで使ったのが、「この項目1つが、実際に何個の細かい検査(control)を落としているか」という件数です。単純な指標ですが、今回はこれが実務的な優先順位そのものとして、よく機能しました。
3-2. 実測したTop5
| # | 検査項目 | 重大度 | 落としている検査の数 |
|---|---|---|---|
| 1 | 送信元ルーティングされたパケットを受け付けない設定 | High | 5 |
| 2 | SUID/SGIDファイルの定期レビュー | High | 4 |
| 3 | IPv6ルーター広告を受け付けない設定 | High | 4 |
| 4 | 不審なパケットのログ記録 | High | 4 |
| 5 | 逆方向パスフィルタリングの有効化 | High | 4 |
💡 知っておくと得をする点: 2位から5位までは、落としている検査の数がすべて「4」で同じでした。同じ件数の項目が並ぶときは、基準表の番号が小さい順に自分で並べ替えると、結果が安定します。これは今回、実際に手を動かしてみて分かったコツです。
📌 この章のまとめ: 今回は複数の指標を合成する必要がなく、「落としている検査の数」という1つのシンプルな指標が、そのまま実務の優先順位になりました。前回記事の「指標の選び方が戦略そのもの」という発見と対をなす、もう1つの姿です。
4. どう直すか——修正手順の読み方のコツ
この章で分かること: Sysdigが提示する修正手順の中身。そして、「これは自動で実行できる手順なのか、それとも人間が目で確認すべき指示なのか」を見分けるコツ。
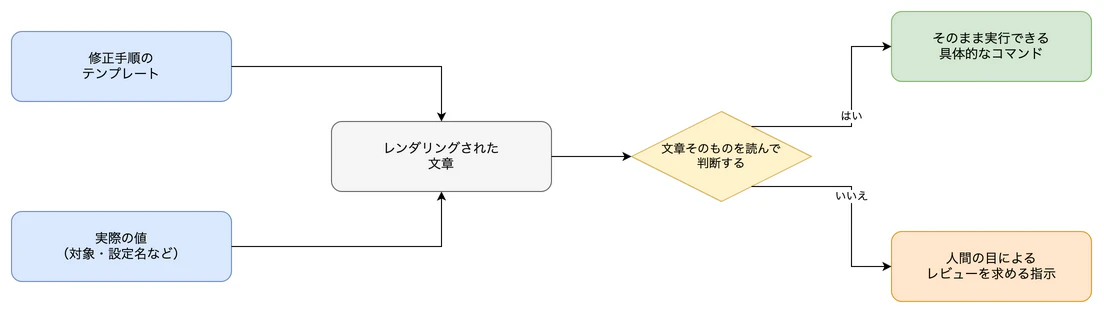
Sysdigが返す修正手順は、テンプレートに実際の値を埋め込んで生成されます。今回のTop1(送信元ルーティングされたパケットを受け付けない設定)は、5件の検査すべてに具体的な修正コマンドが用意されていました。
| 検査 | 修正内容 |
|---|---|
| 1 |
sysctl コマンドでその場の値を0に変更し、ルーティングテーブルを再読み込みする |
| 2〜5 | 設定ファイル(/etc/sysctl.confまたは/etc/sysctl.d/配下)に、IPv4・IPv6それぞれのall・default向けの設定を4行追加する |
一方、Top2(SUID/SGIDファイルの定期レビュー)のように、「不審なプログラムが導入されていないか確認せよ」という人間の目によるレビューを求める指示もあります。
💡 読み方のコツ: この2種類は、見た目が似ていることがあります。「自動フラグが立っているかどうか」だけを見るのではなく、レンダリングされた文章そのものを読んで、シェルにそのまま貼り付けられる具体的なコマンドか、それとも確認や判断を求める文章かを見分けるのが確実です。今回、実際に手を動かしてはじめて気づいたポイントでした。
📌 この章のまとめ: 修正手順は「そのまま実行できる指示」と「人間の判断を求める指示」の2種類があります。テンプレートを一目見るだけでなく、実際の文章を読んで見分けるのが確実です。
5. 通しで見る——1周の流れ
この章で分かること: 検査から実際の適用まで、誰が何をどの順で行うかの全体地図。
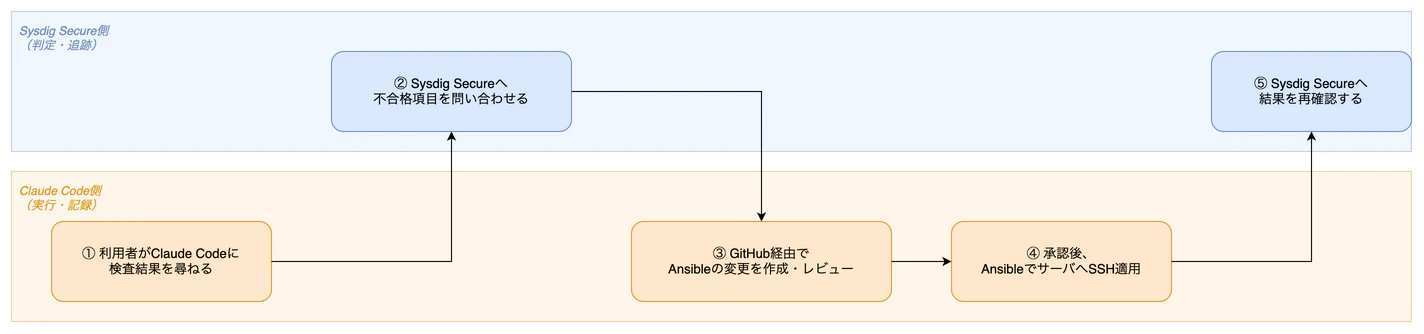
図の左端(利用者とClaude Codeの対話)と右端(実際のサーバへの作業)がClaude Codeの領分、中央(Sysdig Secureに矢印が伸びている部分)が検査・データの領分です。前回記事で確認した境界線と、同じ形がここにも現れています。
サーバへの適用の内部構造は、前々回の記事で組んだアーキテクチャそのものです。
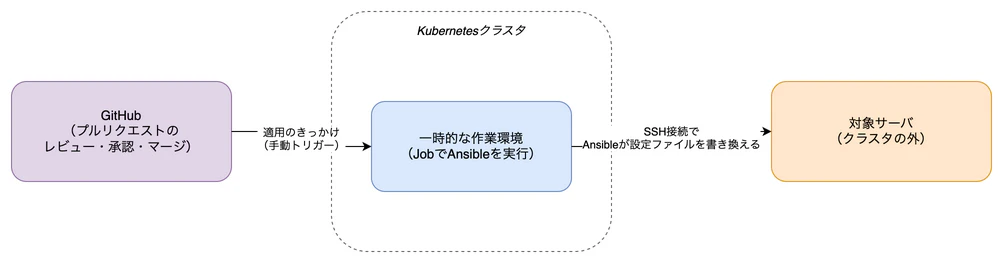
対象サーバ自身はKubernetesクラスタのノードではなく、クラスタ内で一時的に起動する作業環境(Job)が、SSH経由で外から接続するという構造です。前々回の記事で「PRのマージが、サーバへの適用を自動的にはトリガーしない」という設計を紹介しましたが、今回もその設計をそのまま踏襲しています。
📌 この章のまとめ: 検査から適用までの1周は、脆弱性ドメインで確認したのと同じ形の境界線を保ちながら、前々回に構築したAnsibleのパイプラインの上を流れていきます。
6. 実機で、実際に直してみた
この章で分かること: 実際にサーバの設定を1つ、最初から最後まで書き換えた記録。dry-run(試験運転)から本適用、そして「もう一度実行しても意味のある変更が起きない」ことの確認まで、省略せずに載せます。
6-1. 選んだ理由
Top1(送信元ルーティングされたパケットを受け付けない設定)を、実際の修正対象に選びました。理由は3つです。
- 5件すべてに、具体的で実行可能な修正コマンドが用意されていた(人間のレビューを求める指示ではない)
- この設定変更は、自宅ラボの通常の通信(SSHやHTTPなど)に影響しない
- 設定ファイルを削除すれば即座に元の状態へ戻せる、可逆的な変更である
6-2. Ansibleへの変更(追加した設定ファイルの内容)
既存のAnsibleの手順に、新しいタスクを追加しました。書き込む内容はこの4行です。
net.ipv4.conf.all.accept_source_route = 0
net.ipv4.conf.default.accept_source_route = 0
net.ipv6.conf.all.accept_source_route = 0
net.ipv6.conf.default.accept_source_route = 0
この設定ファイルを配置したあと、sysctl --systemコマンドで即座に反映させ、実際に有効になった値を読み出して報告する、という4段構成のタスクにしました。
💡 今回の小さな発見: 標準的な設定変更用のAnsibleモジュール(
ansible.posix.sysctl)は、今回の環境には入っていませんでした。代わりに、既存のタスクと同じ「ファイルを書き込む」+「コマンドで即時反映する」という組み合わせで実装しました。特別な部品が無くても、いつも使っている部品の組み合わせで同じことができる、という発見です。
前々回の記事で触れたとおり、この作業を行ったMacにはdockerが入っていなかったため、今回も同じ理由でpodmanを使ってパイプラインを再現しました。一度確立した代替手段は、次の作業でもそのまま使えます。
6-3. dry-run(試験運転)——生ログ
まずは実際には変更を加えない「試験運転」モードで、想定どおりに動くかを確認しました。
TASK [設定ファイルを書き込む] ****************************************
changed: [対象サーバ]

TASK [設定を即時反映する] ********************************************
ok: [対象サーバ]

TASK [反映後の値を読み出す] ******************************************
ok: [対象サーバ]

TASK [結果を報告する] ************************************************
ok: [対象サーバ] => {
    "msg": "設定ファイルは書き込まれました: True。
    反映後の値 = 1(期待値は0)..."
}

PLAY RECAP *********************************************************************
対象サーバ                  : ok=33   changed=5    unreachable=0    failed=0    skipped=4
failed=0。既存のタスクへの影響もありません。この時点での実際の値はまだ「1」——Sysdigが検出した「不合格」の状態と、サーバの実際の状態がぴったり一致していることを、ここで再確認できました。
6-4. 本適用——生ログ
試験運転が問題ないことを確認したうえで、実際に反映するモードで適用しました。
TASK [設定ファイルを書き込む] ****************************************
changed: [対象サーバ]

TASK [結果を報告する] ************************************************
ok: [対象サーバ] => {
    "msg": "設定ファイルは書き込まれました: True。
    反映後の値 = 0(期待値は0)..."
}

PLAY RECAP *********************************************************************
対象サーバ                  : ok=37   changed=5    unreachable=0    failed=0    skipped=0
「1」から「0」へ。実際に設定が変わりました。
6-5. もう一度実行してみる——変化が起きないことの確認
GitOpsの前提は「同じ手順を何度実行しても、意味のある変化が起きない」ことです。これを確かめるため、同じ手順をもう一度実行しました。
TASK [設定ファイルを書き込む] ****************************************
ok: [対象サーバ]

TASK [結果を報告する] ************************************************
ok: [対象サーバ] => {
    "msg": "設定ファイルは書き込まれました: False。
    反映後の値 = 0(期待値は0)..."
}

PLAY RECAP *********************************************************************
対象サーバ                  : ok=37   changed=3    unreachable=0    failed=0    skipped=0
2回目は、設定ファイルを書き込むタスクが「変化なし」に変わりました。すでに正しい状態になっているので、何もしない——これで、この変更が安全に何度でも再適用できることを確認できました(残りのchanged=3は、この設定変更とは無関係な、既存タスク側の仕様によるものです)。
すべての変更は、GitHub上でのレビュー・承認を経て、複数のプルリクエストに分けて反映しました。試験運転用の切り替え・本適用・切り替えの復帰、というそれぞれの段階を、前々回記事と同じ運用で1つずつ記録に残しています。
📌 この章のまとめ: 設定ファイルを追加し、試験運転で安全性を確認し、本適用で実際に値を変え、もう一度実行して「意味のある変化が起きない」ことまで確かめました。前々回記事で確立したdry-run→本適用→再現性確認、という手順が、対象が変わっても同じ強さで機能しています。
7. 本当に直ったのか——反映を確認する
この章で分かること: 修正が本当に効いたのかを、Sysdig側でどう確認するか。そして、検査には少し時間差があるという、素直な事実と、その後どうなったか。
サーバの実際の値が「1」から「0」に変わったことは、自分たちの手順の中で確認できました。次に気になるのは、Sysdig側の検査結果にも、それが反映されるかです。
適用の直後に、同じ検査項目を問い合わせてみたところ、この時点ではまだ「不合格」のままでした。 これは、前の章で触れた「検出には時間差がある」という性質そのものです。検査は定期的なサイクルで行われるため、設定変更の直後には反映が追いつかないことがあります。今回は、次回の検査で結果が変わったことを確認するための記録を残し、後日あらためて確認する運用にしました。
7-1. 後日、あらためて確認した結果
その後日を迎えたので、あらためて同じ検査項目を問い合わせてみました。結果は「合格」——5件の検査すべてが不合格から外れていました。 比較として、まだ手を付けていないTop2(SUID/SGIDファイルの定期レビュー)を同じ方法で確認したところ、こちらは今も変わらず不合格のままでした。同じ問い合わせ方法で「直った項目は合格に変わり、直していない項目は変わらず不合格のまま」という対比がきれいに取れたことで、今回の確認が偶然ではなく、実際の反映を捉えたものだと言えます。
📌 この章のまとめ: サーバ側の実際の値はすでに変わっています。Sysdig側の検査結果への反映には少し時間差がありましたが、後日あらためて確認したところ、5件の検査すべてが不合格から合格へ変わっていることを確認できました。「直した」で終わらせず「直ったことを確認する」まで一区切りをつけられたのは、時間差を認めたうえで後から追跡する、という素直な運用のおかげです。
8. 今回分かったこと——脆弱性ドメインとの対比
同じ「Sysdigが判定し、Claude Codeが直す」という分業の形が、対象が変わってもどう保たれ、どう変わるのかを、前回記事と並べて整理します。
| 観点 | 脆弱性対応(前回) | 設定の健全性チェック(今回) |
|---|---|---|
| 検査対象 | パッケージのバージョン番号 | 設定ファイル・カーネルパラメータの値 |
| 優先順位の付け方 | 複数の指標を合成したスコア | 「落としている検査の数」という単純な指標 |
| 修正の内容 | パッケージのアップグレード | 設定ファイルの書き込みと即時反映 |
| 修正の元に戻しやすさ | アップグレード先次第で戻しにくい場合もある | 設定ファイルを削除すればすぐ元に戻せる |
| 試験運転→本適用→再現性確認という型 | 前々回記事で確立 | 今回もそのまま通用した |
一言でまとめると——対象が「パッケージ」から「設定」に変わっても、Sysdigが「何が違っていて、何を優先すべきか」を判定し、Claude Codeが「実際に手を動かして直し、記録を残す」という境界線は揺らぎませんでした。 シリーズを通して確認してきたこの分業の形が、今回、もう1つのドメインで裏付けられたことになります。
9. 用語の小辞典
| 用語 | 定義 |
|---|---|
| CIS Benchmark | Center for Internet Securityが公開する、OSやミドルウェアの安全な設定基準集 |
| Posture(構成の健全性) | 設定ファイルやパラメータが、基準に沿っているかどうかという観点 |
| 検査項目(要件) | CIS Benchmarkの中の1つの基準(例: 「送信元ルーティングされたパケットを受け付けない」) |
| 検査(control) | 1つの要件を判定するための、より細かい個別チェック。1つの要件が複数のcontrolから成ることがある |
| dry-run(試験運転) | 実際には変更を加えず、手順が正しく動くかだけを確認するモード |
| 冪等性(べきとうせい) | 同じ手順を何度実行しても、状態が変わらなければ何も起きない、という性質 |
おわりに
今回の1周で確かめたことを、ひとことにまとめます。Sysdigは「見つけて・並べて・判定して・追跡する」役割を、対象が変わっても一貫して担います。そして、実際に手を動かして直す仕事は、必ずその外側で起きます。 前回は脆弱性というパッケージの世界で、今回は設定というもう1つの世界で、同じ境界線を確かめることができました。
印象に残ったのは、今回の優先順位付けが「驚くほど単純」だったことです。複数の指標を組み合わせる必要がある場面もあれば、「落としている検査の数を数えるだけでよい」という場面もある——どちらが正しいかではなく、対象に応じて適切な指標を選べることが、この仕組みの強さなのだと感じました。
次にやること
シリーズはまだ続きます。今回までに、
- 脆弱性対応(前回)
- 構成の健全性チェック(今回)
という2つのドメインで、Sysdig SecureとClaude Codeの役割分担を実測してきました。次は、脅威検知への対応——サーバやコンテナが実際に動いている最中に検知される、不審な振る舞いへの対応です。「事前に分かっている弱点を直す」脆弱性対応・Postureとは違い、「その場で起きたことにどう向き合うか」という、時間との勝負が入ってくるドメインです。同じ枠組みがそこでも成り立つのか、実際にやってみたら、また書きます。
この記事は、Falcoya-co-CTO(Claude Codeで構築したAIエージェント)との対話を通じて作成しました。登場する数値・コマンド・ログは2026年9月15日の実測値です(第7章の後日確認のみ2026年9月28日の実測値)。