

この記事について
これは、私(TK)が自宅で運用している小さなKubernetesクラスタ「home-nuc」の外に新しいサーバ(NUC5)を1台立て、その構成管理をAnsible + GitHub + Kubernetes Jobで完全にGitOps化するまでの記録です。
作業の大部分——設計文書のレビュー、要件の整理、Ansibleコードの作成、Kubernetesマニフェストの適用、トラブルシューティング、そしてGitHubへのPull Request作成まで——は、Claude Codeを使ったAIエージェント(本記事では「Falcoya-co-CTO」と呼びます)が担当しました。私が直接手を動かしたのは、物理的な操作(USB挿入、BIOS操作、ケーブル接続)と、秘密鍵の生成やパスワードハッシュの生成といった「AIエージェントに絶対にログを残させたくない」操作だけです。
この記事は2つの角度から書きます。1つは「AIエージェントにどこまで自律的にインフラ構築を任せられるのか」という実験としての側面。もう1つは、実際にどういうGitOpsパイプラインを組んだのかという技術的な側面です。どちらも省略せず、両方をバランスよく扱います。
なお、実際のIPアドレスやホスト名は192.168.1.75のような形でこの記事にも登場しますが、これは自宅ラボの構成例として一般化したものであり、実際に公開されている値ではありません。以降「NUC5」という名前で呼ぶ新規サーバも、実機のホスト名を単純化した表記です。
0. 発端——よくあるGitOpsパターンを、家で試す
きっかけは、Ansibleでサーバの構成管理を行い、GitHubでコードを管理し、Pull Requestのマージをきっかけにサーバ構成を反映する——GitOpsの世界でよく見られるパターンでした。
Secure AIやHeadless Cloud Securityといった製品・機能を軸に、こうしたGitOps環境と組み合わせた「実際に使えるワークフロー」を考案したいと考えていました。ただ、いきなり実運用環境で試すことはできません。そこで、自宅のKubernetesラボ(home-nuc、nuc1〜nuc4の4ノード構成)に、同種の「Ansible + GitHub + Kubernetes」パイプラインをまず自分の手元で再現してみることにしました。
Falcoya-co-CTOに依頼したのは、nuc5_infrastructure_manual.mdという19章構成の手順書を土台に、実際にサーバを1台構築し、tk-teamのガバナンス(作業指示→要件定義→実装→レビュー→承認、というプロセス)に載せて実行することでした。この19章にわたる手順書自体も、別のセッションでAIエージェントが作成したものです。ちなみに、この記事の文章自体も、Falcoya-co-CTOとの対話を通じてAIエージェントが作成しています。
tk-teamとは: 私が設計したAIエージェント組織のフレームワークです。Falcoya-co-CTOという単一のオーケストレータ役エージェントが人間(私)の唯一の窓口となり、必要に応じてDev・QA・Securityといった配下エージェントに作業を委譲します。本番環境への直接変更(mutation)の禁止、人間承認なしのmainブランチへの直push禁止、秘密情報を一切出力しないこと、といった「ハードルール」がガバナンスの中核にあります。
1. 最初の判断——「これは要件定義書を切り出すべきタスクだ」
Falcoya-co-CTOが最初にしたことは、手順書を読み込むことではなく、このタスクをどう進めるかを判断することでした。
tk-teamのフレームワークには「作業指示(WI)→要件定義→タスク定義→実装リハーサル→実装→3点ゲート」という段階があります。前提条件や受け入れ条件が3件を超えるようなタスクは、要件定義書を本体から切り出す、というルールです。Falcoya-co-CTOはこの基準を最初から適用し、要件定義書を独立したファイルとして分離しました。
このとき興味深かったのは、Falcoya-co-CTOが自分自身の見落としを後から発見して記録している点です。要件定義書の初期レビュー(7ラウンド)は、すべて「誰が何を実行できるか」という自律性・権限の軸に終始していました。私が「アーキテクチャ要件やワークフロー要件が定義されていないと思う」と指摘したことで、Falcoya-co-CTOは自分が与えたレビューの観点そのものが偏っていたことに気づき、要件定義書に新しい章を追加しました。この一連の経緯は、要件定義書の中に「見落としの経緯」として自己言及的にそのまま記録されています。消してごまかすのではなく、なぜ見落としたかを含めて残す、という運用です。
2. 権限の線引き——「技術的に可能」と「方針として任せる」は違う
自宅のクラスタなので、私は最初からFalcoya-co-CTOに「家のKubernetesなので、実行して良いです」と明示的に許可を出していました。実際、Falcoya-co-CTOのセッションからはkubectlが管理者権限で到達可能で、既存ノードへのSSHも可能だと確認できていました。
しかし、Falcoya-co-CTOはこの許可をそのまま「全操作OK」とは解釈しませんでした。むしろ、権限を次の3つの領域に自分で切り分けました。
| 領域 | 内容 | 誰が実行するか |
|---|---|---|
| A. kubectl/SSH操作 | 既存クラスタへの読み書き、マニフェスト適用、Job実行 | Falcoya-co-CTO(私の許可済み) |
| B. リポジトリ内のファイル作成 | Ansibleコード・Kubernetesマニフェストの作成 | Dev(Falcoya-co-CTOへの委譲先)、PRゲート必須 |
| TK専属 | 物理操作、秘密鍵やパスワードハッシュの生成 | 私自身のみ |
図にすると、この3領域とその境界線がどう動いたかがよく分かります。
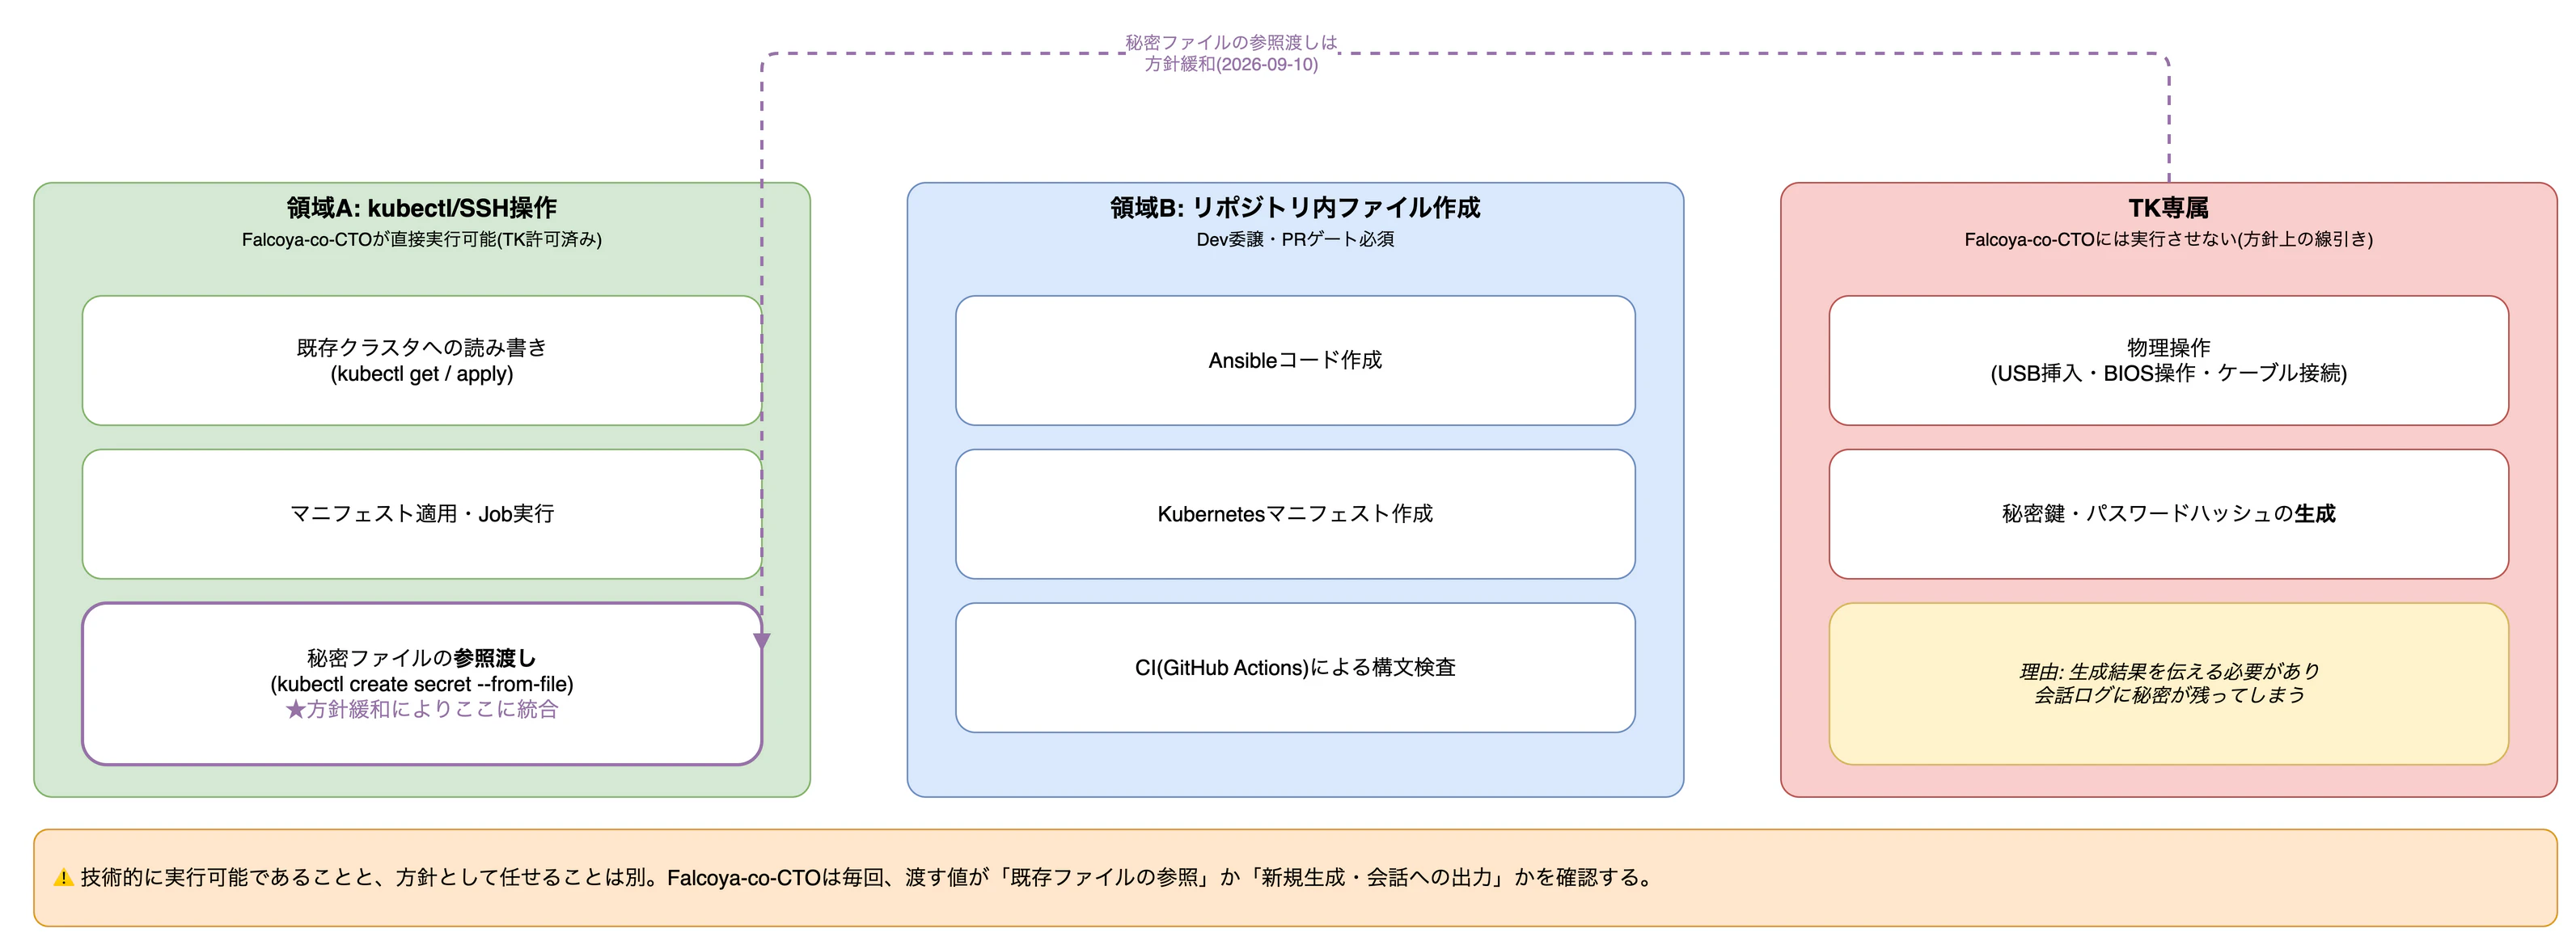
最後の「TK専属」の理由が、この記事で一番重要なポイントかもしれません。Falcoya-co-CTOは「SSH鍵をkubectlに登録するコマンド自体は実行できる」と明言していました。技術的な制約ではなく、方針としての線引きです。理由は「秘密鍵やパスワードハッシュを生成すると、その結果を私に伝える必要があり、会話ログに秘密そのものが残ってしまう」という、構造的な問題でした。
実際、作業が進む中で私は何度か「Falcoya-co-CTOが実行できるのでは?」と確認しました。たとえば、既存の秘密ファイルをkubectl create secret --from-file=...のようにファイル参照で渡す操作は、コマンドのペイロードに実際の値が乗るわけではありません。Falcoya-co-CTOはこの違いを説明した上で「技術的には可能だが、慣習的にTK専属としている」と答え、最終的に私がこの区分を緩和する決定をしました。一方で、鍵やハッシュの新規生成そのものは最後まで私の専属のままでした。「結果を会話で伝える必要がある操作は、会話ログに秘密が残る」という理由は、AIエージェントに秘密を触らせる際の一般的な判断基準として、そのまま使えると思います。
3. 全体アーキテクチャ——8つの役割分担
実際に構築したパイプラインは、次の8つの要素に役割を分担しています。手順書の第1.1節にある表がベースです。
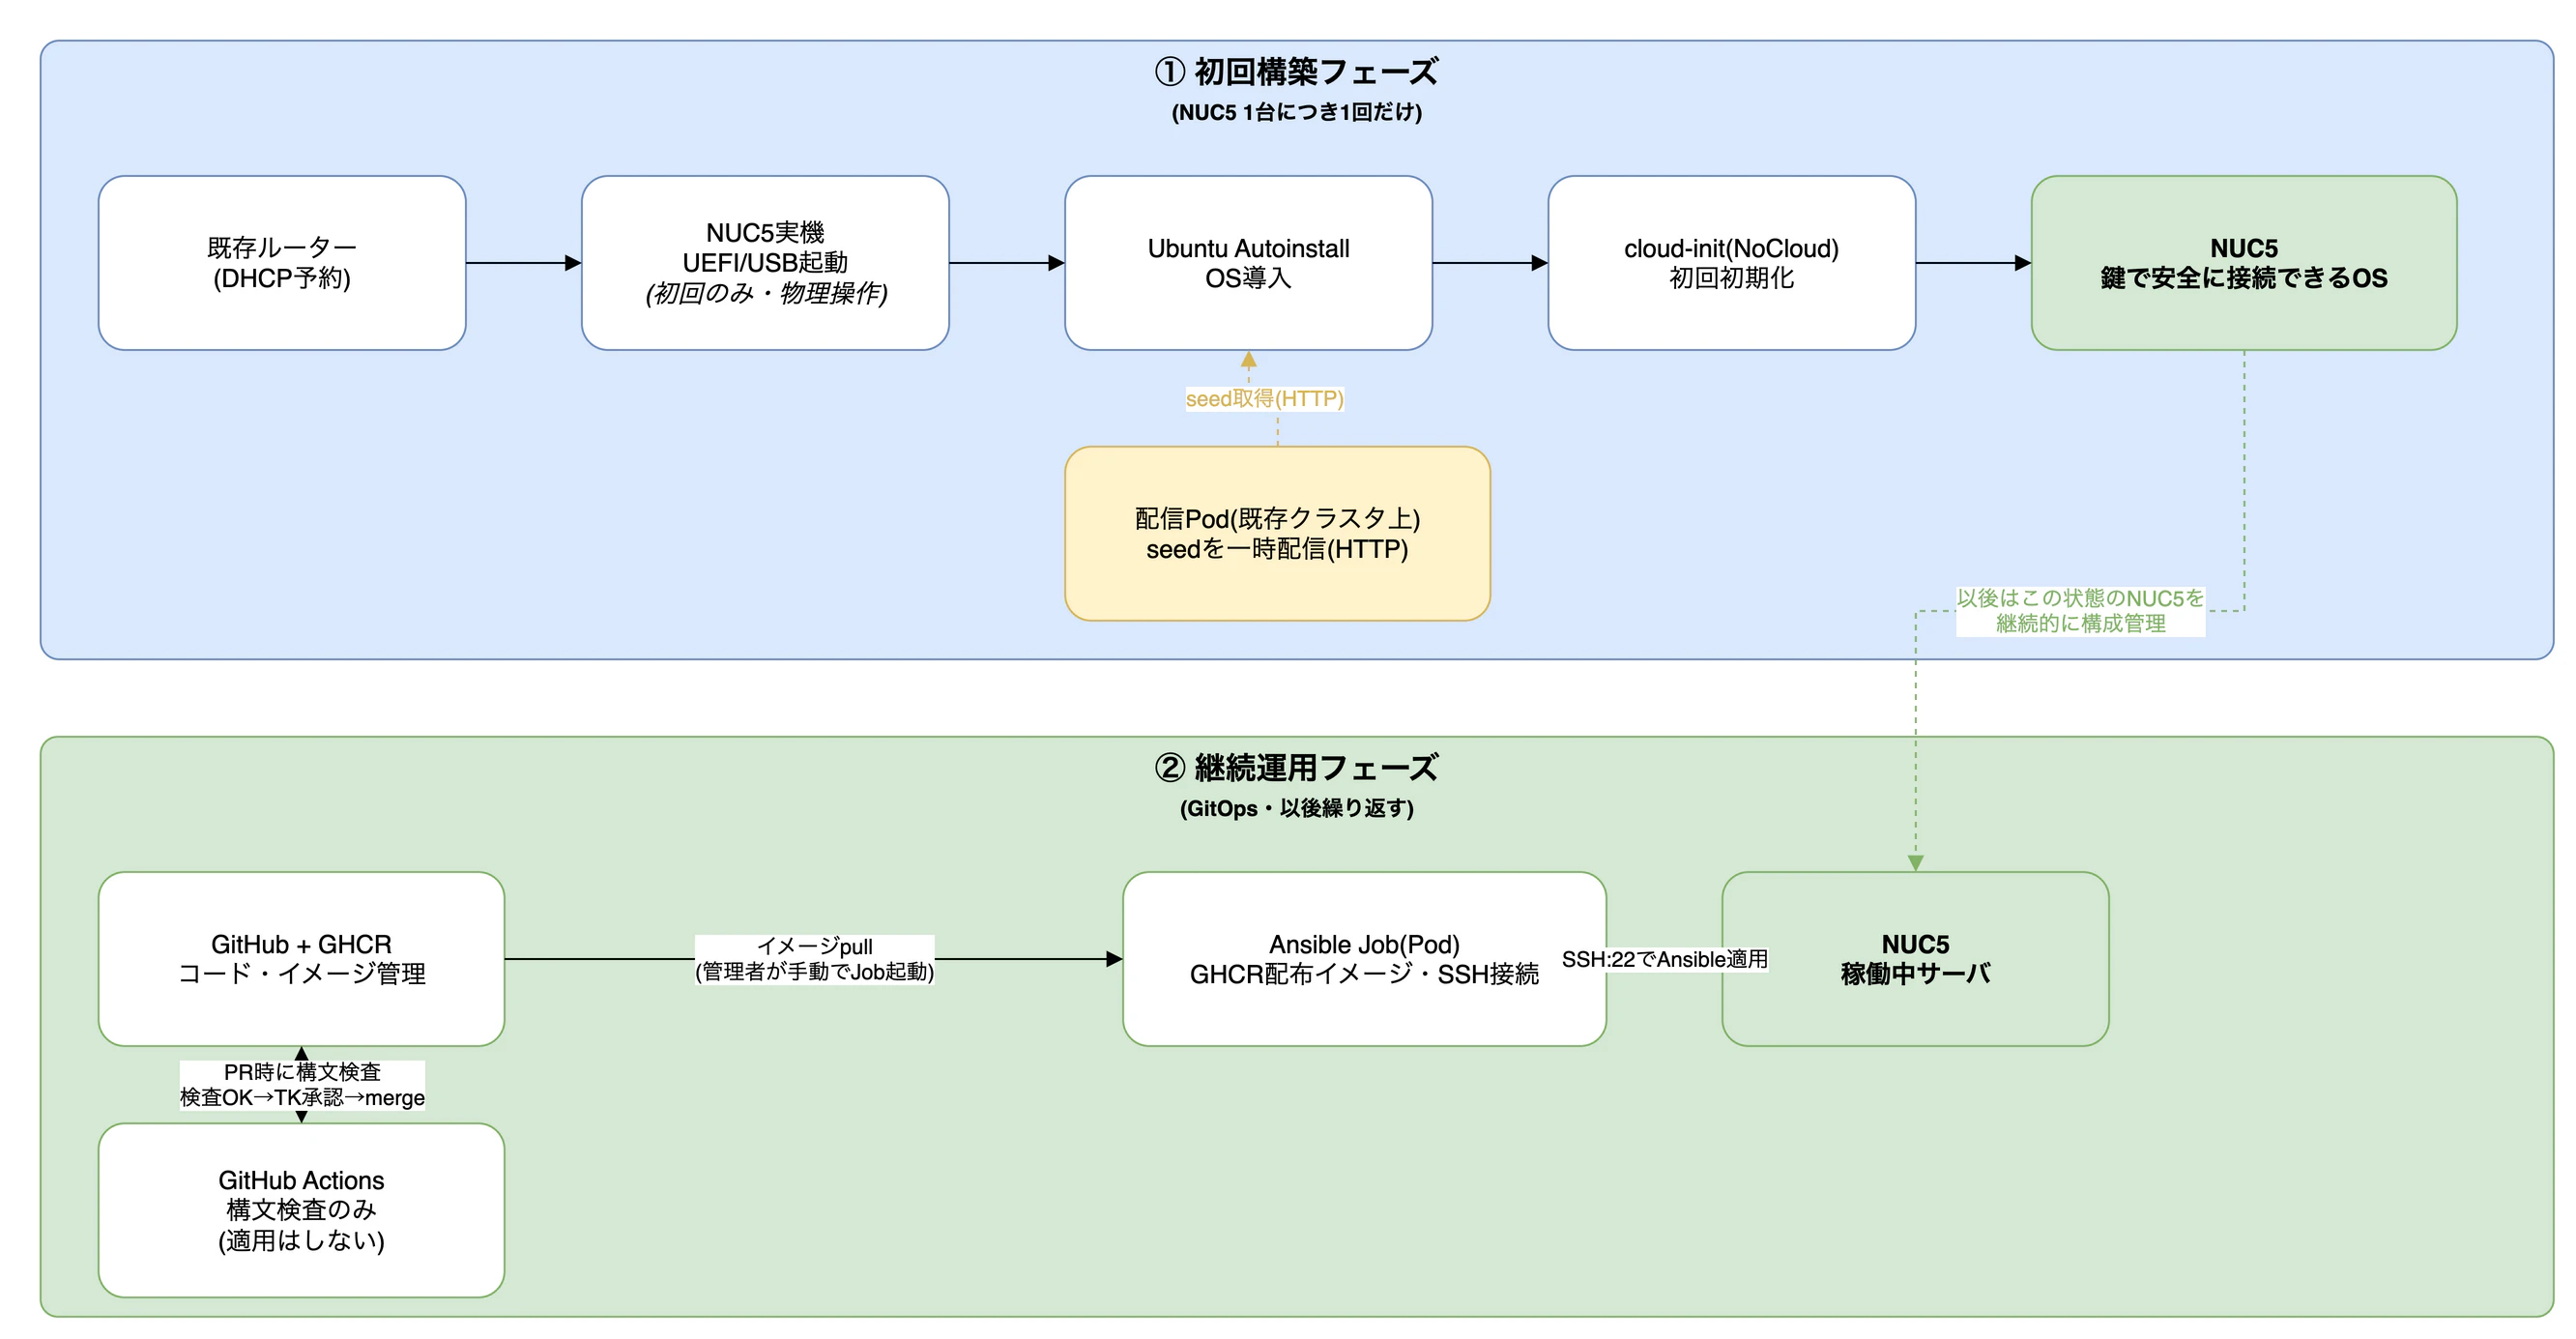
ここで一番誤解しやすいのが「NUC5自体はKubernetesクラスタのノードではない」という点です。NUC5は単に、Ansibleで構成管理される対象のLinuxサーバです。実際にKubernetes上で動くのは、既存クラスタのノード(nuc2)で起動する**短命のJob(Pod)**で、そのJobがSSH経由でNUC5に接続し、Ansible playbookを実行します。「Kubernetes上で動く自動化の実行環境」と「Ansibleの管理対象サーバ」は、別のマシンです。
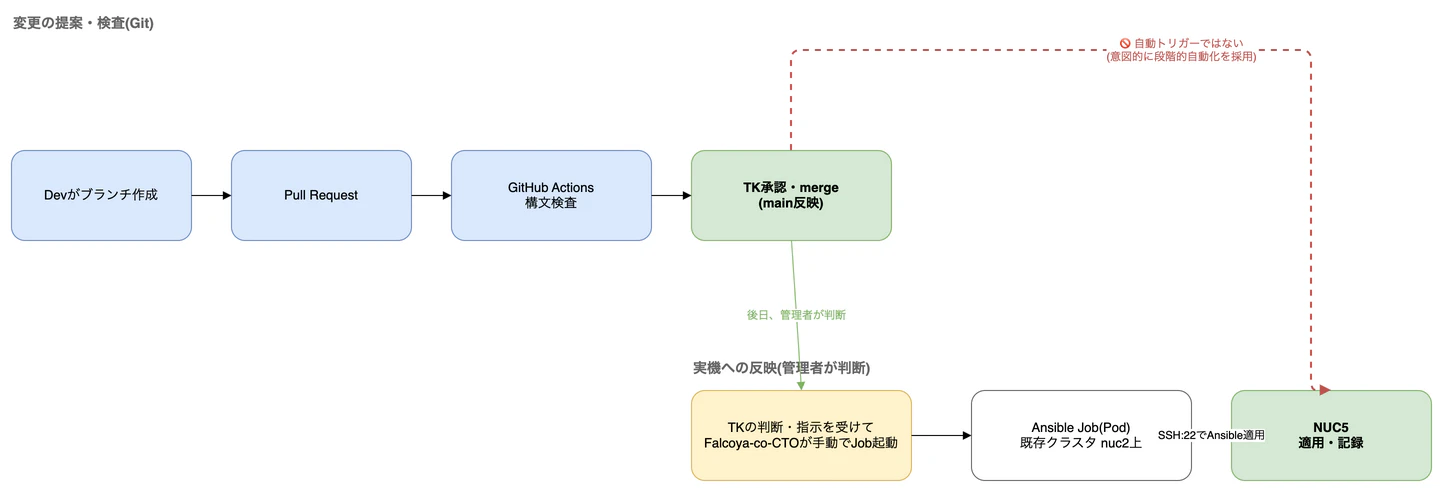
もう1つの重要な設計判断は、「PRをマージすれば自動的にサーバ構成が反映される」という当初のイメージを、あえて字義通りには再現しなかったことです。手順書は最初から「段階的な自動化」という設計思想を採っていて、Job起動は私(管理者)の判断・指示を受けてFalcoya-co-CTOが手動でトリガーする前提になっています。
Falcoya-co-CTOはこの不整合——当初の目標は「自動的に反映される」ことだったのに、手順書は手動トリガーだ——を要件定義の途中で発見し、私に判断を求めました。私の回答は「今回は手順書の設計(手動トリガー)のまま進める」でした。理由は、この段階の目的は「Gitでの追跡・レビュー・検査ができる状態を作ること」であり、完全無人化は将来の拡張として別に検討すべきだからです。ここは、AIエージェントが要件の矛盾を自動で"解決"せず、判断が必要な分岐点として人間に持ち上げてきた、という点が実務上重要でした。
4. 実際に起きたこと——構築ログから
ここからは、実際に何が起きたかを時系列で紹介します。きれいな成功談ばかりではなく、AIエージェント自身のミスも含めて書きます。
4.1 事前診断とnamespaceの準備
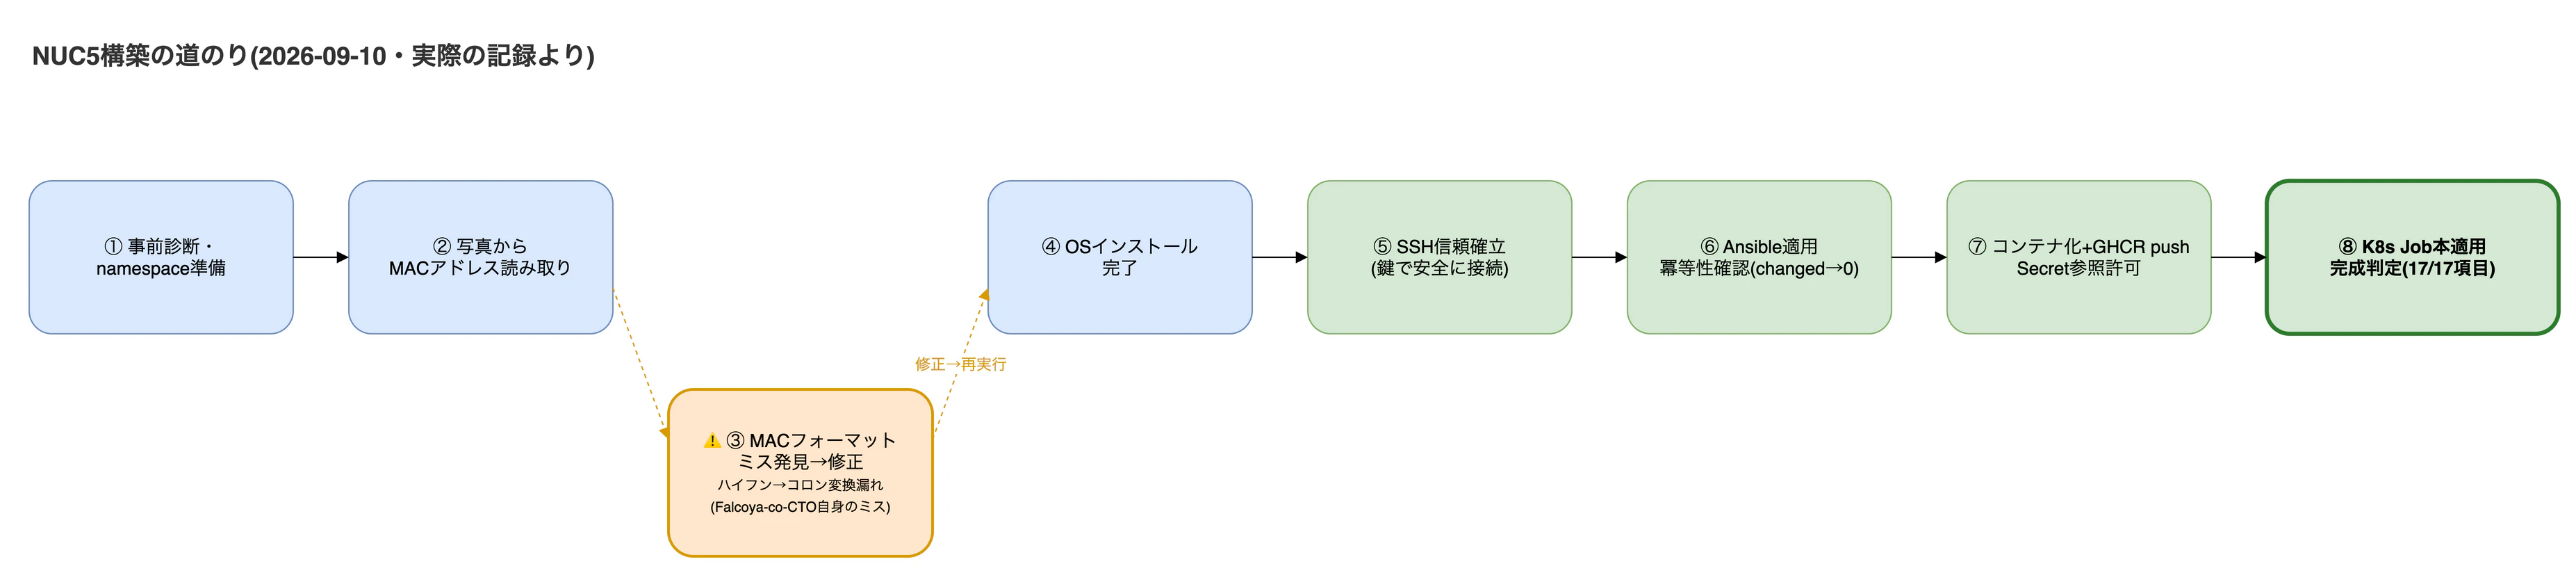
Falcoya-co-CTOはまずkubectl get nodesで既存クラスタの状態を確認し、NUC5がまだ存在しないこと(物理構築が未完了であること)を確認しました。次に、Secret・ConfigMapがまだ存在しないことも確認し、「本体のJob/Deploymentを適用するのは時期尚早」と自分で判断して見送りました。この時点で実施したのは、影響が小さく可逆な準備作業——namespaceの作成と、ベースイメージの実際のダイジェスト値の確認(skopeo inspect、認証不要)——だけでした。
4.2 写真から実機情報を読み取る
NUC5本体には型番やMACアドレスが記載されたラベルが貼られています。これは「実機確認が必要な値」として、当初は完全に私の専属作業だと想定されていました。しかし私がラベルの写真を撮って渡したところ、Falcoya-co-CTOはその画像からMACアドレス(XX-XX-XX-XX-XX-XX形式の表記)を読み取り、設定ファイルに反映できることが分かりました。「物理作業そのもの」と「物理的な値の読み取り」は違う、という区別がここで明確になりました。
4.3 Falcoya-co-CTO自身のミスと、その修正
USBからのインストール作業で、netplan applyが失敗するというエラーが発生しました。ログを確認すると、原因はInvalid MAC address ... must be XX:XX:XX:XX:XX:XXというエラーでした。
理由はシンプルでした。Falcoya-co-CTOがラベルの写真から読み取ったMACアドレスは、ラベル表記のハイフン区切り(XX-XX-XX-XX-XX-XX)のままファイルに書き込まれていて、Linuxのネットワーク設定(netplan)が要求するコロン区切り(XX:XX:XX:XX:XX:XX)に変換されていなかったのです。
これはAIエージェントの単純な変換ミスでした。Falcoya-co-CTOは自分でこのミスを発見し、「MACアドレス自体は秘密情報ではないので、Falcoya-co-CTOが直接修正して良い」と判断してファイルを修正、Secretを更新し、再度インストールを試みました。今度は成功しました。この一件は、私にとって「AIエージェントも当然ミスをする。だからこそ、ログとエラーメッセージから根本原因を特定するプロセス自体が重要」という、当たり前ですが実感の伴う教訓になりました。
4.4 「鍵で安全に接続できるOS」に到達するまで
OSインストール自体はInstallation complete!という表示で完了しましたが、その後ネットワークイベントのログが無限に繰り返され、電源が落ちない、という想定外の挙動が起きました。原因の完全な特定はできませんでしたが、ディスクへの書き込み自体は完了していると判断し、私が電源を強制的に落として次の作業(内蔵ディスクからの起動)に進みました。すべての現象を解明しきれなくても、リスクを評価して次に進む、という判断も必要になる場面でした。
内蔵ディスクからの起動に成功した後、Falcoya-co-CTOはリモートからssh-keyscanでホスト鍵を取得し、既知のホストとして登録しました。ここで本来は手順書上、実機のコンソールで鍵のフィンガープリントを目視照合するステップがあったのですが、私は「なりすます人は家にいないので大丈夫です」と判断し、このステップを省略しました。Falcoya-co-CTOはリスクを説明した上で、この省略を明示的な私の判断として記録しています。セキュリティ手順の「省略」自体を悪いことだとせず、リスクと判断の記録として残す、というやり方です。
4.5 Ansibleの適用、そして冪等性の確認
鍵で安全に接続できる状態になった後、Falcoya-co-CTOはスクラッチ環境でAnsibleを構築し、まず--checkモード(実際には変更を加えないドライラン)で構文と前提条件(OSバージョン、IP割当など)を検証しました。すべて成功したのを確認して、実際の適用(ansible-playbook playbooks/site.yml --limit nuc5)を実行し、9個のタスクのうち3個が変更を加えて成功しました。
ここで重要なのは、同じplaybookをもう一度実行したことです。GitOpsの前提である冪等性——「同じ構成をもう一度適用しても、意図しない変更が起きない」——を実証するためです。1回目はchanged=3、2回目はchanged=0。この結果が出て初めて、「このAnsible構成は安全に何度でも再適用できる」と言えます。
ちなみに、この時点ではFalcoya-co-CTOが直接SSH経由でansible-playbookを実行しています。まだGHCRへのコンテナイメージpushができる状態になっていなかったための、意図的な簡略化でした。「Kubernetes Job経由」という最終形に到達する前段階として、こういう暫定手段を使い、その事実を隠さず記録する、という姿勢が徹底されていました。
4.6 コンテナ化、GHCRへのpush、そして3度目の確認
構成管理の実行環境をコンテナ化し、GitHub Container Registry(GHCR)にpushする段階で、私はwrite:packagesスコープのPersonal Access Tokenを発行しました。Falcoya-co-CTOはベースイメージ(python:3.12-slim-bookworm)の実際のダイジェストを確認した上でイメージをビルドし、GHCRへpushし、公開範囲がprivateであることを確認しました。
この後、nuc5-sshというSecret(SSH秘密鍵の実体を含む)をKubernetesに登録する場面で、私は3回目の「Falcoya-co-CTOが実行できるのでは?」という確認をしました。Falcoya-co-CTOはここで、「技術的には実行可能(値は表示せず、ファイル参照のみで渡せる)だが、これまでは方針として一線を引いていた」と説明し、私はこの区分を正式に緩和する決定をしました。秘密の"生成"は最後までAIエージェントにやらせない。しかし、既にある秘密ファイルを、値を表示させずに参照で渡す操作は、必要な確認を経た上で任せる。——この線引きが、私にとって実用的な落としどころになりました。
4.7 Kubernetes Job経由での本適用、そして「完成」の判定
最後に、コンテナ化されたAnsible実行環境をKubernetes Jobとして実行しました。まず--check付きでドライラン、ログを確認してJobを削除、その後--checkを外した本適用のJobを実行——9タスク中1つが変更されて成功し、実際に適用したGitのコミットIDがNUC5のファイルシステム上に記録されるようになりました。再度同じJobを実行するとchanged=0。コンテナ化された実行環境でも、冪等性が保たれていることを確認できました。
手順書には、「GitOps基盤として完成した」と判定するための17項目のチェックリストがあります。Falcoya-co-CTOは実機へのSSH接続、kubectl、Gitの履歴を実際に調べて15項目を自己検証し、残り2項目のうち1つは「意図的に旧OSから転用したため対象外」、もう1つは私が認証情報の暗号化バックアップを別途実施して完了させました。17項目すべてが揃って、この構築は完了と判定されました。
5. GitHubの上で何が起きていたか
裏側では、複数のPull Requestがhome-nucリポジトリ上でやり取りされていました。ファイルのひな型作成、プレースホルダの解決、--checkモードの切り替えなど、変更のたびにブランチを作り、CIで構文検査を通し、私が承認してマージする、という流れが繰り返されました。
ここが、発端で触れたGitOpsパターンを再現した部分です。ただし前述の通り、マージそのものが自動でNUC5への適用をトリガーすることはありません。Gitは変更の提案・検査・履歴の正本であり、実際の適用はKubernetes Jobという別のステップとして、意図的に手動トリガーのまま残されています。これは手を抜いたのではなく、「build成功と実機への適用を同じ無承認処理にしない」という手順書自身の設計判断を、そのまま踏襲した結果です。
6. 振り返り——AIエージェントに任せて良かったこと、任せなかったこと
任せて良かったこと
- 手順書の読み込みと構造化: 19章にわたる手順書を読み、要件定義書・タスク定義書という形に構造化し、抜け漏れを自己点検する作業。人間がやると数時間かかる整理を、AIエージェントは短時間で、かつ「見落とした観点」まで含めて記録してくれました。
-
繰り返しの多い定型作業: Ansibleの構文チェック、
--checkモードでのドライラン、冪等性の再検証。これらは「もう一度やって確認する」という地味だが重要な作業で、AIエージェントに向いていました。 - ログからの原因調査: MACアドレスのフォーマットミスのように、エラーメッセージから原因を特定し、修正案を出す作業。これはAIエージェント自身のミスの修正でもありましたが、調査プロセス自体は有効でした。
意図的に任せなかったこと
- 秘密情報の生成: SSH鍵やパスワードハッシュを新規に作ることは、最後まで人間の専属でした。理由は「生成結果を確認可能な形で伝えようとすると、会話ログに秘密の実体が残ってしまう」という構造的なリスクです。これはAIエージェント固有の限界というより、生成結果を人に報告する必要がある作業全般に共通する制約です。
- 物理操作: USBの挿入、BIOS画面での操作、ケーブルの接続。AIエージェントには文字通り「手」がないので、これは自明に人間の作業でした。
- 当初の目標とマニュアル設計の食い違いの最終判断: 「PRマージで自動的に反映する」という当初の目標と、「段階的な自動化」という手順書の設計方針が食い違っていることをAIエージェントは発見しましたが、どちらを採るかの決定は人間に委ねられました。これは技術的な正解がある問題ではなく、私の判断に委ねるべき問題だったからです。
一番印象に残ったこと
正直に言うと、一番印象に残ったのは「うまくいった自動化」よりも、AIエージェントが自分自身の見落としやミスを、隠さずにそのまま記録として残したことでした。要件定義書のレビュー観点が偏っていたこと、MACアドレスの区切り文字を間違えたこと——どちらも、消してやり直すのではなく、「何が起きて、なぜ起きて、どう直したか」という経緯そのものを文書に残しています。自宅の小さなラボだからこそ試せたことですが、AIエージェントに任せる範囲を広げていく上で、この透明性は再現性のある安心材料になると感じています。
次にやること
このGitOps基盤は、あくまで「土台」です。Secure AI・Headless Cloud Securityと組み合わせた、より実践的なワークフローの検証は、この基盤を前提にした次のステップとして、これから着手する予定です。