

はじめに
SQL言語リファレンスに time_bucket という関数が増えています。タイムスタンプを固定幅の時間バケットに丸めて、そのバケットの開始時刻を返す関数です。
適用対象はDatabricks SQLとDatabricks Runtime 19以上。「5分ごとに集計したい」を date_trunc で書こうとして詰まった経験がある人には、それだけで用途が想像つく関数だと思います。
ただ、実際にノートブックで一通り触ってみると、origin の効き方と日次バケットのタイムゾーン依存のところで、ドキュメントを読んだだけの理解とは少し違う結果が出てきました。そのあたりも含めて書いていきます。検証はサーバーレスノートブック (Spark 4.2.0) で実施しています。
time_bucketの基本
構文はこれだけです。
time_bucket(bucketSize, ts [, origin])
-
bucketSize: INTERVAL定数。日時間隔 (SECOND / MINUTE / HOUR / DAY) と年月間隔 (MONTH / YEAR) の両方が使えます。正の非ゼロ値であること -
ts: バケット化するTIMESTAMPまたはTIMESTAMP_NTZ -
origin: バケットグリッドの起点。省略時は1970-01-01 00:00:00
戻り値は ts と同じ型で、半開区間 [start, start + bucketSize) の start です。
まずは素直に丸めてみます。
SELECT
  time_bucket(INTERVAL '15' MINUTE, TIMESTAMP '2024-01-01 11:27:00') AS bucket_15min,
  time_bucket(INTERVAL '1'  HOUR,   TIMESTAMP '2024-01-01 11:27:00') AS bucket_1hour,
  time_bucket(INTERVAL '5'  MINUTE, TIMESTAMP '2024-01-01 11:27:00') AS bucket_5min,
  time_bucket(INTERVAL '90' SECOND, TIMESTAMP '2024-01-01 11:27:00') AS bucket_90sec
| bucket_15min | bucket_1hour | bucket_5min | bucket_90sec |
|---|---|---|---|
| 2024-01-01 11:15:00 | 2024-01-01 11:00:00 | 2024-01-01 11:25:00 | 2024-01-01 11:27:00 |
90 SECOND が 11:27:00 ちょうどになっているのは偶然ではありません。1日 (86400秒) は90で割り切れるので、90秒グリッドは毎日同じ位置に並びます。11:27:00は起点から数えてちょうど境界にあたる時刻です。
半開区間で切られる
バケットは [start, start + bucketSize) の半開区間です。境界値まわりを並べて確認します。
SELECT
  ts,
  time_bucket(INTERVAL '15' MINUTE, ts) AS bucket
FROM VALUES
  (TIMESTAMP '2024-01-01 11:14:59.999'),
  (TIMESTAMP '2024-01-01 11:15:00.000'),
  (TIMESTAMP '2024-01-01 11:15:00.001'),
  (TIMESTAMP '2024-01-01 11:29:59.999'),
  (TIMESTAMP '2024-01-01 11:30:00.000')
AS t(ts)
ORDER BY ts
| ts | bucket |
|---|---|
| 2024-01-01 11:14:59.999 | 2024-01-01 11:00:00 |
| 2024-01-01 11:15:00.000 | 2024-01-01 11:15:00 |
| 2024-01-01 11:15:00.001 | 2024-01-01 11:15:00 |
| 2024-01-01 11:29:59.999 | 2024-01-01 11:15:00 |
| 2024-01-01 11:30:00.000 | 2024-01-01 11:30:00 |
バケット開始ちょうどの値は自分自身のバケットに入り、次の開始の直前まで同じバケットに留まります。時系列の集計で境界の重複や取りこぼしが起きない、素直な作りです。
date_truncとどう違うのか
date_trunc はカレンダー単位 (MINUTE / HOUR / DAY / MONTH など) にしか丸められません。任意幅を扱えるのが time_bucket の役割です。並べて確認します。
SELECT
  ts,
  date_trunc('HOUR', ts)                AS date_trunc_hour,
  time_bucket(INTERVAL '1' HOUR, ts)    AS time_bucket_1hour,
  date_trunc('HOUR', ts) = time_bucket(INTERVAL '1' HOUR, ts) AS same,
  time_bucket(INTERVAL '5' MINUTE, ts)  AS time_bucket_5min,
  time_bucket(INTERVAL '4' HOUR, ts)    AS time_bucket_4hour,
  time_bucket(INTERVAL '10' DAY, ts)    AS time_bucket_10day
FROM VALUES
  (TIMESTAMP '2024-01-01 11:27:00'),
  (TIMESTAMP '2024-03-15 23:58:12'),
  (TIMESTAMP '2024-07-04 00:00:00')
AS t(ts)
ORDER BY ts
| ts | date_trunc_hour | time_bucket_1hour | same | time_bucket_5min | time_bucket_4hour | time_bucket_10day |
|---|---|---|---|---|---|---|
| 2024-01-01 11:27:00 | 2024-01-01 11:00:00 | 2024-01-01 11:00:00 | true | 2024-01-01 11:25:00 | 2024-01-01 08:00:00 | 2023-12-29 00:00:00 |
| 2024-03-15 23:58:12 | 2024-03-15 23:00:00 | 2024-03-15 23:00:00 | true | 2024-03-15 23:55:00 | 2024-03-15 20:00:00 | 2024-03-08 00:00:00 |
| 2024-07-04 00:00:00 | 2024-07-04 00:00:00 | 2024-07-04 00:00:00 | true | 2024-07-04 00:00:00 | 2024-07-04 00:00:00 | 2024-06-26 00:00:00 |
カレンダー単位に一致する幅なら両者は同じ結果になります。カレンダー境界でよければ date_trunc のままで構いません。
面白いのは time_bucket_10day です。2024-01-01が2023-12-29のバケットに入っています。10日幅のグリッドは月や年の境界とは無関係に、origin (デフォルトは1970-01-01) から10日刻みで延びているためです。「10日ごと」は「毎月1日・11日・21日」ではない、というのは意識しておく価値があります。月の区切りに合わせたいなら、date_trunc('MONTH', ts) と日付の割り算を組み合わせる方が意図に合います。
originをずらしても区切りが動かないことがある
origin は区切り線が通る点を指定する引数です。「毎時00分区切りではなく毎時05分区切りにしたい」といった業務都合の区切りに合わせられます。
先に結論を図で出しておきます。bucketSize が1時間のとき、origin をずらしても区切り線が動く場合と動かない場合があります。
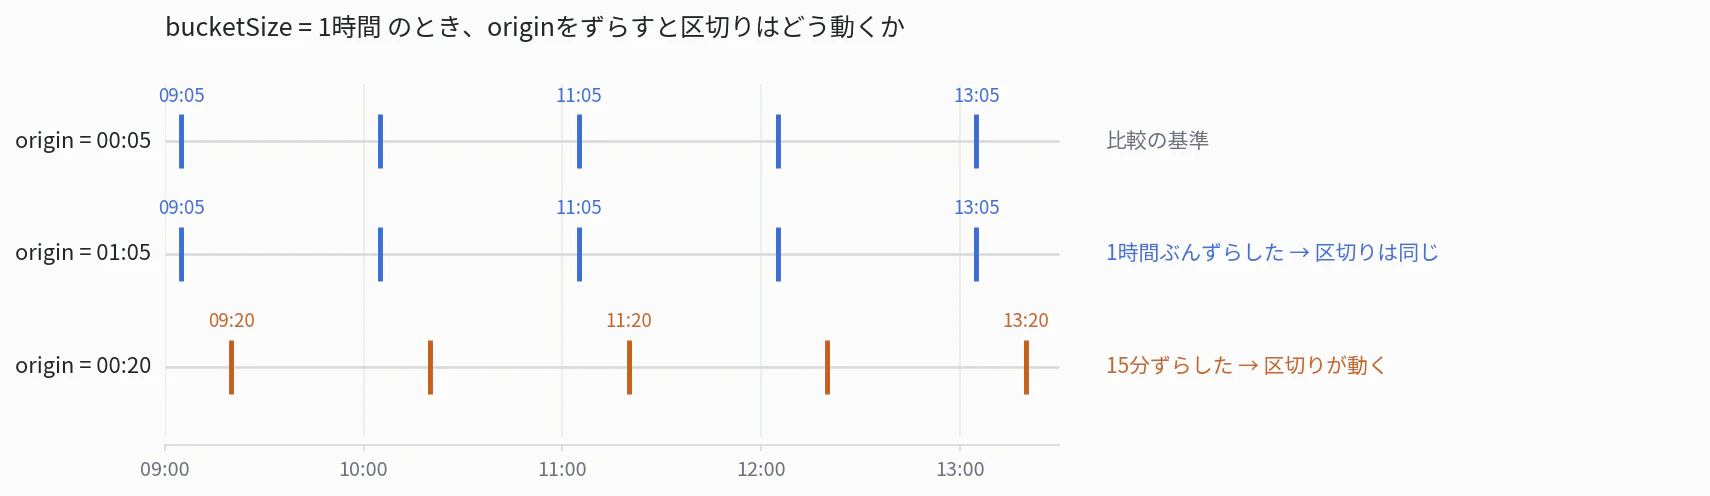
origin を 00:05 から 01:05 にずらしても線の位置は変わりません。00:20 にずらしたときだけ動きます。この違いがどこから来るのかを、以下で順に見ていきます。
SELECT
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00')                                  AS default_origin,
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '1970-01-01 00:05:00') AS origin_05min,
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '1970-01-01 00:30:00') AS origin_30min,
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '2025-01-01 00:30:00') AS origin_in_future
| default_origin | origin_05min | origin_30min | origin_in_future |
|---|---|---|---|
| 2024-01-01 11:00:00 | 2024-01-01 11:05:00 | 2024-01-01 10:30:00 | 2024-01-01 10:30:00 |
注目したいのは origin_in_future です。origin に2025年を渡していますが、エラーにもNULLにもならず、2024年の値がきちんと丸められています。グリッドは origin から両方向に無限に延びるので、ts より後の時刻を指定しても構いません。
そしてここが一番の勘所です。
origin をずらしても、ずらした幅が bucketSize の整数倍なら区切りは変わりません。
SELECT
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '1970-01-01 00:05:00') AS origin_00_05,
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '1970-01-01 01:05:00') AS origin_01_05,
  time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP '2030-06-15 23:05:00') AS origin_far_future
| origin_00_05 | origin_01_05 | origin_far_future |
|---|---|---|
| 2024-01-01 11:05:00 | 2024-01-01 11:05:00 | 2024-01-01 11:05:00 |
3つとも同じです。1時間幅では「何分の位置か」しか意味を持たないので、日付や時が違っても同じ区切りになります。
origin を「ここから数え始める開始日」だと読むと、この結果は直感に反します。実際には開始日ではなく、区切り線が通る点を1つ指定しているだけです。区切り線は bucketSize 間隔で過去にも未来にも無限に並んでいるので、どの線の上の点を指しても同じ区切りになります。先ほどの図で、00:05 と 01:05 が同じ線の並びになっていたのはこのためです。
3か月幅でoriginを4月にしても何も変わらない
同じことが年月間隔でも起きます。しかも、こちらのほうが引っかかりやすい。会計年度に合わせた四半期集計をやりたくて、origin を4月に置いてみたときの結果です。
先ほどと同じ図を3か月幅で描くとこうなります。

1970-01 と 1970-04 は区切り線が完全に重なります。2か月ずらした 1970-03 だけが動きます。SQLの結果もこの通りになりました。
SELECT
  ts,
  time_bucket(INTERVAL '3' MONTH, ts)                                  AS q_default,
  time_bucket(INTERVAL '3' MONTH, ts, TIMESTAMP '1970-04-01 00:00:00') AS q_origin_apr,
  time_bucket(INTERVAL '3' MONTH, ts, TIMESTAMP '1970-03-01 00:00:00') AS q_origin_mar,
  time_bucket(INTERVAL '1' YEAR,  ts)                                  AS yearly,
  time_bucket(INTERVAL '1' YEAR,  ts, TIMESTAMP '1970-04-01 00:00:00') AS fiscal_year_apr
FROM VALUES
  (TIMESTAMP '2024-02-15 11:27:00'),
  (TIMESTAMP '2024-03-31 23:59:59'),
  (TIMESTAMP '2024-04-01 00:00:00'),
  (TIMESTAMP '2024-05-15 10:00:00'),
  (TIMESTAMP '2024-11-30 10:00:00')
AS t(ts)
ORDER BY ts
| ts | q_default | q_origin_apr | q_origin_mar | yearly | fiscal_year_apr |
|---|---|---|---|---|---|
| 2024-02-15 11:27:00 | 2024-01-01 | 2024-01-01 | 2023-12-01 | 2024-01-01 | 2023-04-01 |
| 2024-03-31 23:59:59 | 2024-01-01 | 2024-01-01 | 2024-03-01 | 2024-01-01 | 2023-04-01 |
| 2024-04-01 00:00:00 | 2024-04-01 | 2024-04-01 | 2024-03-01 | 2024-01-01 | 2024-04-01 |
| 2024-05-15 10:00:00 | 2024-04-01 | 2024-04-01 | 2024-03-01 | 2024-01-01 | 2024-04-01 |
| 2024-11-30 10:00:00 | 2024-10-01 | 2024-10-01 | 2024-09-01 | 2024-01-01 | 2024-04-01 |
q_default と q_origin_apr が全行で一致しました。3か月の区切りはデフォルトの origin (1970年1月) の時点ですでに1月/4月/7月/10月に並んでいます。そこから4月へのずらしはちょうど3か月ぶん、つまり bucketSize の整数倍なので、何も変わりません。日本の会計四半期の境界とデフォルトが最初から一致していた、というのが結論です。
区切りの位置をずらしたいなら、3か月の整数倍にならないずらし方、つまり1か月か2か月だけずれた月を指定する必要があります。q_origin_mar は3月を指定したもので、こちらは12月/3月/6月/9月の区切りに動いています。
一方 fiscal_year_apr は1年幅なので、4月の指定がそのまま効きます。2024-02-15が2023-04-01のバケットに入っていて、会計年度として正しく切れています。四半期と年度で origin の効き方の見え方が変わるので、思い込みで書かずに一度結果を確認するのが安全です。
月末をoriginにすると境界が月ごとに動く
年月間隔でもう一つ確認しておきたいのが、origin に「31日」を指定したときの挙動です。31日が存在しない月をどう扱うのかが気になります。
SELECT
  ts,
  time_bucket(INTERVAL '1' MONTH, ts, TIMESTAMP '1970-01-31 00:00:00') AS origin_day31,
  time_bucket(INTERVAL '1' MONTH, ts, TIMESTAMP '1970-01-15 00:00:00') AS origin_day15
FROM VALUES
  (TIMESTAMP '2024-02-10 12:00:00'),
  (TIMESTAMP '2024-03-01 12:00:00'),
  (TIMESTAMP '2024-03-20 09:00:00'),
  (TIMESTAMP '2023-03-01 12:00:00'),
  (TIMESTAMP '2024-04-30 12:00:00')
AS t(ts)
ORDER BY ts
| ts | origin_day31 | origin_day15 |
|---|---|---|
| 2023-03-01 12:00:00 | 2023-02-28 | 2023-02-15 |
| 2024-02-10 12:00:00 | 2024-01-31 | 2024-01-15 |
| 2024-03-01 12:00:00 | 2024-02-29 | 2024-02-15 |
| 2024-03-20 09:00:00 | 2024-02-29 | 2024-03-15 |
| 2024-04-30 12:00:00 | 2024-04-30 | 2024-04-15 |
月の日数に合わせてクランプされます。2023-03-01は平年なので2023-02-28、2024-03-01はうるう年なので2024-02-29です。
結果としてグリッドは 2024-01-31 → 2024-02-29 → 2024-03-31 のように月ごとに境界が動きます。2024-03-20が2024-02-29のバケットに入っているのは、次の境界である2024-03-31にまだ届いていないからです。日付を丸めた結果として整合を取るならこうするしかない挙動だと思いますが、「毎月31日始まり」を業務ルールとして採用すると集計期間の長さが月ごとに変わってしまいます。月中を起点にしたいなら、どの月にも存在する15日あたりを指定しておくのが無難です。
日次バケットはセッションタイムゾーンで切られる
ここが実務で一番効いてくるところです。ドキュメントには次の2点が書かれています。
- TIMESTAMP_NTZに対してはUTC基準でバケット化する
- TIMESTAMPに対しては、年月間隔とカレンダー日成分がセッションタイムゾーンに合わせられる
読んだだけだと分かった気になりますが、実際にどうずれるのかは手を動かさないと掴めません。確かめるには、同じインスタントを別のセッションタイムゾーンでバケット化して、結果のインスタントが動くかを見るのが確実です。タイムゾーンオフセット付きのリテラルを使えばセッション設定に関係なくインスタントが固定できるので、unix_timestamp でエポック秒に落として比較します。
SET TIME ZONE 'Asia/Tokyo';
SELECT
  current_timezone() AS tz,
  time_bucket(INTERVAL '1' DAY, TIMESTAMP '2024-01-01T08:30:00+09:00')                 AS ltz_day,
  unix_timestamp(time_bucket(INTERVAL '1' DAY, TIMESTAMP '2024-01-01T08:30:00+09:00')) AS ltz_day_epoch,
  time_bucket(INTERVAL '1' DAY, TIMESTAMP_NTZ '2024-01-01 08:30:00')                   AS ntz_day
同じクエリを SET TIME ZONE 'UTC'; のあとにもう一度実行します。結果を並べるとこうなりました。
| tz | ltz_day | ltz_day_epoch | ntz_day |
|---|---|---|---|
| Asia/Tokyo | 2024-01-01T00:00:00+09:00 | 1704034800 | 2024-01-01T00:00:00 |
| UTC | 2023-12-31T00:00:00Z | 1703980800 | 2024-01-01T00:00:00 |
ltz_day_epoch が食い違いました。日次バケットの開始時刻が、セッションタイムゾーンによって別のインスタントになっています。TIMESTAMPの日次バケットはUTC固定ではなく、セッションタイムゾーンの深夜0時に揃う、ということです。
差はオフセットの9時間とは限らない
差を計算すると 1704034800 - 1703980800 = 54000秒、つまり15時間です。JSTとUTCのオフセットである9時間ではありません。
理由を追うと納得できます。対象のインスタントは 2024-01-01T08:30:00+09:00 = 2023-12-31T23:30Z。JSTから見ればこれは2024-01-01の日で、その日の始まりは2023-12-31T15:00Z。UTCから見れば2023-12-31の日で、始まりは2023-12-31T00:00Z。日付そのものがずれているので、差は 24 - 9 = 15時間になります。
裏を返すと、同じJSTとUTCの比較でも対象時刻によって差が変わります。たとえば2024-01-01T05:00Z (JST 14:00) なら両者とも「1月1日」扱いなので、差は9時間ちょうどです。日次バケットのずれは「オフセット分だけ」ではなく、日境界をまたぐかどうかで変わります。 ジョブのセッションタイムゾーン設定が環境ごとに違っていて集計値が合わない、という調査をするときに、9時間ぴったりのずれを探していると見つけられません。
なお、時分秒幅 (HOUR / MINUTE / SECOND) はエポックからの経過時間で割るだけなので、セッションタイムゾーンの影響を受けません。影響が出るのはDAY以上のカレンダー成分を持つ幅です。
TIMESTAMP_NTZは動かない
ntz_day は両方のセッションで 2024-01-01T00:00:00 のまま変わりませんでした。TIMESTAMP_NTZはタイムゾーンを持たないので、セッション設定に左右されません。
日次以上の粒度をJSTで切りたいならTIMESTAMPを使ってセッションタイムゾーンを合わせる、環境によらず壁時計そのままで切りたいならTIMESTAMP_NTZを使う、という使い分けになります。
センサーデータをダウンサンプリングする
実務での使い道を確認するため、37秒間隔のセンサー読み取りを模したビューを作ります。あとで欠損の話をするので、10:00から10:30は意図的に落としてあります。
CREATE OR REPLACE TEMP VIEW sensor_readings AS
SELECT
  id AS reading_id,
  CASE WHEN id % 3 = 0 THEN 'sensor_a'
       WHEN id % 3 = 1 THEN 'sensor_b'
       ELSE 'sensor_c' END AS sensor_id,
  TIMESTAMP '2024-01-01 09:00:00' + INTERVAL '37' SECOND * id AS ts,
  -- rand のシードを固定して、再実行しても同じデータになるようにします
  round(20 + 5 * sin(id / 10.0) + rand(42) * 2, 2) AS temperature
FROM range(0, 300)
-- 10:00 から 10:30 は意図的に欠損させる
WHERE NOT (
      TIMESTAMP '2024-01-01 09:00:00' + INTERVAL '37' SECOND * id >= TIMESTAMP '2024-01-01 10:00:00'
  AND TIMESTAMP '2024-01-01 09:00:00' + INTERVAL '37' SECOND * id <  TIMESTAMP '2024-01-01 10:30:00'
);
10分バケットに集約します。GROUP BY ALL が使えるので、バケット式を二度書かずに済みます。
SELECT
  time_bucket(INTERVAL '10' MINUTE, ts) AS bucket_start,
  count(*)                              AS n,
  round(avg(temperature), 2)            AS avg_temp,
  round(min(temperature), 2)            AS min_temp,
  round(max(temperature), 2)            AS max_temp
FROM sensor_readings
GROUP BY ALL
ORDER BY bucket_start
| bucket_start | n | avg_temp | min_temp | max_temp |
|---|---|---|---|---|
| 2024-01-01 09:00:00 | 17 | 23.87 | 20.17 | 26.54 |
| 2024-01-01 09:10:00 | 16 | 23.92 | 20.86 | 26.13 |
| 2024-01-01 09:20:00 | 16 | 17.53 | 15.69 | 20.56 |
| 2024-01-01 09:30:00 | 16 | 18.46 | 15.57 | 22.0 |
| 2024-01-01 09:40:00 | 17 | 24.51 | 21.77 | 26.22 |
| 2024-01-01 09:50:00 | 16 | 23.08 | 18.97 | 26.5 |
| 2024-01-01 10:30:00 | 17 | 22.45 | 18.82 | 26.12 |
書き心地は素直です。GROUP BY time_bucket(...) と書けば、それ以上の工夫は要りません。
バケット化を図で見る
表だけだとどこで切られているのか掴みにくいので、生の観測点とバケット平均を重ねて描きました。破線がバケットの境界です。

バケット平均が階段状になるのは、バケットの中では1つの代表値に潰れるためです。図にすると当たり前のことですが、集計後のデータをそのまま折れ線で繋いで見せている場面では、この階段が滑らかな線として描かれていることになります。
バケット幅を変えると平滑化の強さが変わります。同じデータを5分/15分/30分で切り直したものがこちらです。

30分幅まで広げると短周期の変動は完全に消えます。ダウンサンプリングの幅は「見たい周期」から決めるものだ、というのが目で見て分かります。
origin の効果も図にすると直感的です。30分幅で、デフォルト (毎時00分・30分区切り) と15分ずらしたものを重ねました。

境界の位置が変われば各バケットに入る点の集合が変わり、平均値も変わります。origin は見た目の区切りを変えるだけでなく、集計値そのものを変えます。
存在しないバケットは返ってこない
先ほどの集計結果をもう一度見ると、09:50の次が10:30になっています。10:00から10:30のバケットが返ってきていません。GROUP BY はデータが存在するバケットしか返さないので、当然といえば当然の結果です。
等間隔の時系列がほしい場合は、sequence でグリッドを作ってLEFT JOINします。
WITH agg AS (
  SELECT
    time_bucket(INTERVAL '10' MINUTE, ts) AS bucket_start,
    count(*)                              AS n,
    round(avg(temperature), 2)            AS avg_temp
  FROM sensor_readings
  GROUP BY ALL
),
grid AS (
  SELECT explode(sequence(
    TIMESTAMP '2024-01-01 09:00:00',
    TIMESTAMP '2024-01-01 12:10:00',
    INTERVAL '10' MINUTE
  )) AS bucket_start
)
SELECT
  g.bucket_start,
  coalesce(a.n, 0) AS n,
  a.avg_temp,
  CASE WHEN a.n IS NULL THEN 'GAP' ELSE '' END AS note
FROM grid g
LEFT JOIN agg a USING (bucket_start)
ORDER BY g.bucket_start
| bucket_start | n | avg_temp | note |
|---|---|---|---|
| 2024-01-01 09:50:00 | 16 | 23.08 | |
| 2024-01-01 10:00:00 | 0 | null | GAP |
| 2024-01-01 10:10:00 | 0 | null | GAP |
| 2024-01-01 10:20:00 | 0 | null | GAP |
| 2024-01-01 10:30:00 | 17 | 22.45 |
これが効くのは、集計結果をそのままグラフにするときです。上段が GROUP BY の結果をそのまま繋いだもの、下段がグリッドとLEFT JOINしたものです。

上段では10:00から10:30が直線で繋がっていて、データがないことに気付けません。むしろ「その時間帯は緩やかに変化していた」という誤った読み取りを誘います。下段はNaNで線が途切れるので、欠損がそのまま図に出ます。センサーやログの監視ダッシュボードでは、この違いは無視できません。
バケットあたりの件数は揺れる
もう一つ、集計に入る前に押さえておきたいのが件数です。バケットごとの行数を数えるとこうなりました。
| 1バケットあたりの行数 | バケット数 |
|---|---|
| 0 | 4 |
| 8 | 1 |
| 16 | 11 |
| 17 | 4 |

観測が37秒の等間隔でも、10分 (600秒) は37で割り切れないので、1バケットに16件入ったり17件入ったりします。端の8件は、最後のバケットが途中で終わっているためです。
平均値を扱うぶんには問題になりにくいのですが、合計値を比較するときは件数の揺れがそのまま効いてきます。バケット集計では count(*) も一緒に持っておくと、あとから「この山は本当に増えたのか、行数が多かっただけなのか」を切り分けられます。
bucketSizeとoriginは定数でなければならない
最後に引数の制約を確認します。ノートブックが途中で止まらないよう、Python側で例外を捕まえて1行目だけ表示しました。
queries = {
    "ゼロ幅": "SELECT time_bucket(INTERVAL '0' SECOND, TIMESTAMP '2024-01-01 11:00:00')",
    "負の幅": "SELECT time_bucket(INTERVAL '-15' MINUTE, TIMESTAMP '2024-01-01 11:00:00')",
    "bucketSize が列 (非定数)":
        "SELECT time_bucket(make_dt_interval(0, 0, id, 0), TIMESTAMP '2024-01-01 11:27:00') FROM range(1, 3)",
    "origin が列 (非定数)":
        "SELECT time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', ts) "
        "FROM (SELECT TIMESTAMP '1970-01-01 00:05:00' AS ts UNION ALL SELECT TIMESTAMP '1970-01-01 00:10:00')",
    "ts と origin の型が不一致":
        "SELECT time_bucket(INTERVAL '1' HOUR, TIMESTAMP '2024-01-01 11:27:00', TIMESTAMP_NTZ '1970-01-01 00:05:00')",
    "ts が DATE": "SELECT time_bucket(INTERVAL '1' DAY, DATE '2024-01-01')",
}

for label, q in queries.items():
    try:
        # collect() まで実行しないと解析エラーが出ないケースがあります
        result = spark.sql(q).collect()
        print(f"[OK]   {label}: {result}")
    except Exception as e:
        # メッセージが長いので1行目だけ出します
        print(f"[ERR]  {label}: {str(e).splitlines()[0]}")
    print()
6件すべてエラーになりました。抜粋します。
[ERR]  ゼロ幅: [DATATYPE_MISMATCH.VALUE_OUT_OF_RANGE] ... The `bucketSize` must be between (0, inf)
       (current value = INTERVAL '00' SECOND). SQLSTATE: 42K09

[ERR]  bucketSize が列 (非定数): [DATATYPE_MISMATCH.NON_FOLDABLE_INPUT] ... the input `bucketSize`
       should be a foldable "INTERVAL DAY TO SECOND" expression; however, got
       "make_dt_interval(0, 0, id, 0)". SQLSTATE: 42K09

[ERR]  ts が DATE: [DATATYPE_MISMATCH.UNEXPECTED_INPUT_TYPE] ... The second parameter requires the
       "(TIMESTAMP OR TIMESTAMP WITHOUT TIME ZONE)" type, however "DATE '2024-01-01'" has the type
       "DATE". SQLSTATE: 42K09
bucketSize と origin は定数畳み込み可能である必要があり、列を渡すと NON_FOLDABLE_INPUT になります。「テナントごとに集計粒度を変える」のような使い方はできないので、粒度ごとにクエリを分けるか、CASE で切り替えることになります。実行計画を組む段階でグリッドが決まっている必要があるので、この制約は設計上そうなるものだと思われます。
DATEが暗黙キャストされない点も、日付テーブルを持っているとうっかり踏みます。CAST(d AS TIMESTAMP) を挟んでください。
なお、いずれかの引数がNULLの場合は結果がNULLになり、エラーにはなりません。
まとめ
time_bucket を一通り触って分かったことをまとめます。
- 任意幅のバケットに丸められる。5分、90秒、4時間、10日のようにカレンダー単位に乗らない粒度が一発で書ける
- カレンダー単位に一致する幅なら
date_truncと同じ結果になる。カレンダー境界でよければdate_truncのままでよい - バケットは半開区間
[start, start + bucketSize) originをずらしても、ずらした幅がbucketSizeの整数倍なら区切りは変わらない。3か月幅では1970年1月と1970年4月が同じ区切りになる-
originはtsより未来でもよい。グリッドは両方向に無限に延びる - 年月間隔で
originの日が存在しない月では月末にクランプされ、境界が月ごとに動く - TIMESTAMPのDAY以上の幅はセッションタイムゾーン基準。ずれ幅はオフセットぶんとは限らず、日境界をまたぐかどうかで変わる
- TIMESTAMP_NTZはセッションタイムゾーンに左右されない
-
GROUP BY time_bucket(...)はデータのあるバケットしか返さない。等間隔が必要ならsequenceグリッドとLEFT JOINする -
bucketSizeとoriginは定数のみ。列は渡せない。DATEも渡せない
一番の収穫は、origin を「集計の開始日」だと思って読んでいた自分の誤解に気付けたことでした。会計四半期に合わせようとして4月を指定し、結果が1ミリも変わらないのを見て初めて、これは開始日ではなく区切り線の位置を決めるものなんだと腑に落ちました。ドキュメントには「バケットグリッドの配置アンカー」と正しく書いてあるので、読み違えていたのは完全にこちらです。小さい関数ほど、想定と違う入力を並べて一度に流してみる価値があります。