

はじめに
Data + AI Summit 2026 で、Genie Code に機械学習向けのアップグレードとフルページのコマンドセンターが追加されました。発表内容は Data + AI Summit 2026 における Genie Code の最新情報 にまとまっています。要点は次の3つです。
- 新しいフルページのコマンドセンターで, 複数スレッドの並行作業や長時間タスクを1か所で管理できる
- MLflow / Model Serving / コンピュートとネイティブ統合し, 本番 ML エンジニアリング (特徴量エンジニアリングからデプロイまで) を支援する
- まもなくスケジュールされたタスクに対応し, インタラクティブな支援から自律的な作業へ広がる
「機械学習向けの Genie Code」は新しいツールではなく, 既存の Genie Code に組み込まれた機能とインテリジェンスのアップグレードです。本記事では, このうち ML ワークフローの部分を実際に試した記録を残します。ダミーデータでチャーン (解約) 予測を題材に, データ探索からモデルのデプロイ手前までを Genie Code 単独でどこまで回せるかを検証しました。
結論から言うと, ノートブックの UI を一度も触らずに, 探索 → データ品質判断 → 特徴量エンジニアリング → 学習 → 自己デバッグ → 閾値最適化 → 可視化までを完走できました。途中で起きたエラーや評価指標の不具合も, エージェントが自分で診断して直しています。以下, その過程を順に見ていきます。
なお Genie Code 全般の仕様は Genie Code のドキュメント, フルページ版は フルページの Genie Code を参照してください。本記事の挙動は2026年6月時点のものです。
検証用データの準備
Genie Code for ML の強みは, ブログによれば2つのソースに基づきます。1つは Databricks が本番 ML で蓄積した知見 (不均衡データの補正, 特徴量の品質チェックなど), もう1つは Genie Ontology を通じたチーム固有のパターンです。これらを試すために, あえて次の特性を仕込んだダミーデータを用意しました。
- 静的属性とラベルを持つ
customersと, 生イベントログのcustomer_eventsの2テーブル構成にする - チャーンに効く行動シグナル (最終利用からの日数, ログイン頻度, サポート件数) は
customersに保存せず,customer_eventsにのみ持たせる -
ageとtotal_chargesに意図的な欠損を入れる - チャーン率を約2割にしてクラス不均衡をつくる
- チャーンラベルは契約属性とイベント由来シグナルのロジットから生成し, ランダムノイズにしない (学習可能にする)
データモデルは次のとおりです。

この設計のポイントは, 予測に効く特徴量を customer_events 側にだけ置いたことです。customers テーブル単体では契約属性やデモグラフィックしかなく, 予測力の高い特徴量は events を顧客単位で集約しないと得られません。これにより, Genie Code が「events から recency / frequency 系の特徴量を作る」と自分で気づけるかどうかを試せます。
生成コードの要点は以下です (全体は別途ノートブックにまとめています)。
import numpy as np
import pandas as pd

np.random.seed(42)
N = 10000
REF_DATE = pd.Timestamp("2026-06-01")

# customers: 静的属性
# age に約3%, total_charges に約2%の欠損を仕込む
age = np.random.normal(42, 14, N).clip(18, 85)
age[np.random.rand(N) < 0.03] = np.nan
contract = np.random.choice(["Monthly", "OneYear", "TwoYear"], N, p=[0.55, 0.3, 0.15])
is_premium = np.random.rand(N) < 0.25

# customer_events: 顧客ごとに可変件数の生イベント
# login / page_view / purchase / support_ticket を時系列で生成

# イベントから潜在シグナルを集計 (ラベル生成にのみ使用, テーブルには出さない)
# recency_days, ticket_cnt, login_cnt, purchase_cnt

# チャーンラベル: 契約属性 + イベントシグナルのロジット
logit = (
    -1.9
    + 0.9 * (contract == "Monthly")
    - 0.7 * (contract == "TwoYear")
    + 0.018 * recency_days       # 最終利用から日が空くほどチャーン
    + 0.12 * ticket_cnt
    - 0.05 * login_cnt
    - 0.04 * purchase_cnt
    - 0.015 * tenure_months
    - 0.6 * is_premium
    + 0.3 * (payment == "ConvenienceStore")
    + np.random.normal(0, 0.4, N)
)
prob = 1 / (1 + np.exp(-logit))
churned = (np.random.rand(N) < prob).astype(int)
Unity Catalog に書き込むときは, テーブルとカラムにコメントを付与しておきます。Genie Ontology / Genie Code はスキーマのメタデータを参照するため, コメントがあるとエージェントがテーブルの意味を理解しやすくなります。
spark.sql(f"COMMENT ON TABLE {customers_fqn} IS "
          "'顧客マスタ。静的属性とチャーンラベルを持つ。行動特徴量は customer_events から作成する想定。'")
spark.sql(f"ALTER TABLE {customers_fqn} ALTER COLUMN churned COMMENT "
          "'チャーンラベル。1=解約, 0=継続 (予測ターゲット)'")
データ探索とデータ品質チェック
最初のプロンプトは, 探索とデータ品質チェック, 特徴量エンジニアリング方針の整理だけに絞りました。
takaakiyayoi_catalog.genie_code_ml_demo.customers と
takaakiyayoi_catalog.genie_code_ml_demo.customer_events を探索して,
データ品質 (欠損, 外れ値, クラス不均衡) と, 両テーブルの結合キーや使えそうな特徴量を整理してください。
チャーン予測モデルを作る前提で, 特徴量エンジニアリングの方針を提案してください。
Genie Code はこのタスクを自分で複数ステップに分解し, 指示していない品質チェックの観点を自分で立てました。仕込んだ粗さもすべて検出しています。
| 観点 | Genie Code の検出結果 |
|---|---|
| 欠損値 | age 303件 (3.0%), total_charges 212件 (2.1%), customer_events は欠損なし |
| 外れ値 (IQR×1.5) | monthly_charges 39件, age 27件 → いずれも実データとして妥当, 除外不要と判断 |
| クラス不均衡 | churned=1 が1,794件 (17.9%), churned=0 が8,206件。約1:4.6 |
| 結合 | customer_id で完全一致 (孤立レコードなし), 安全に LEFT JOIN 可能 |
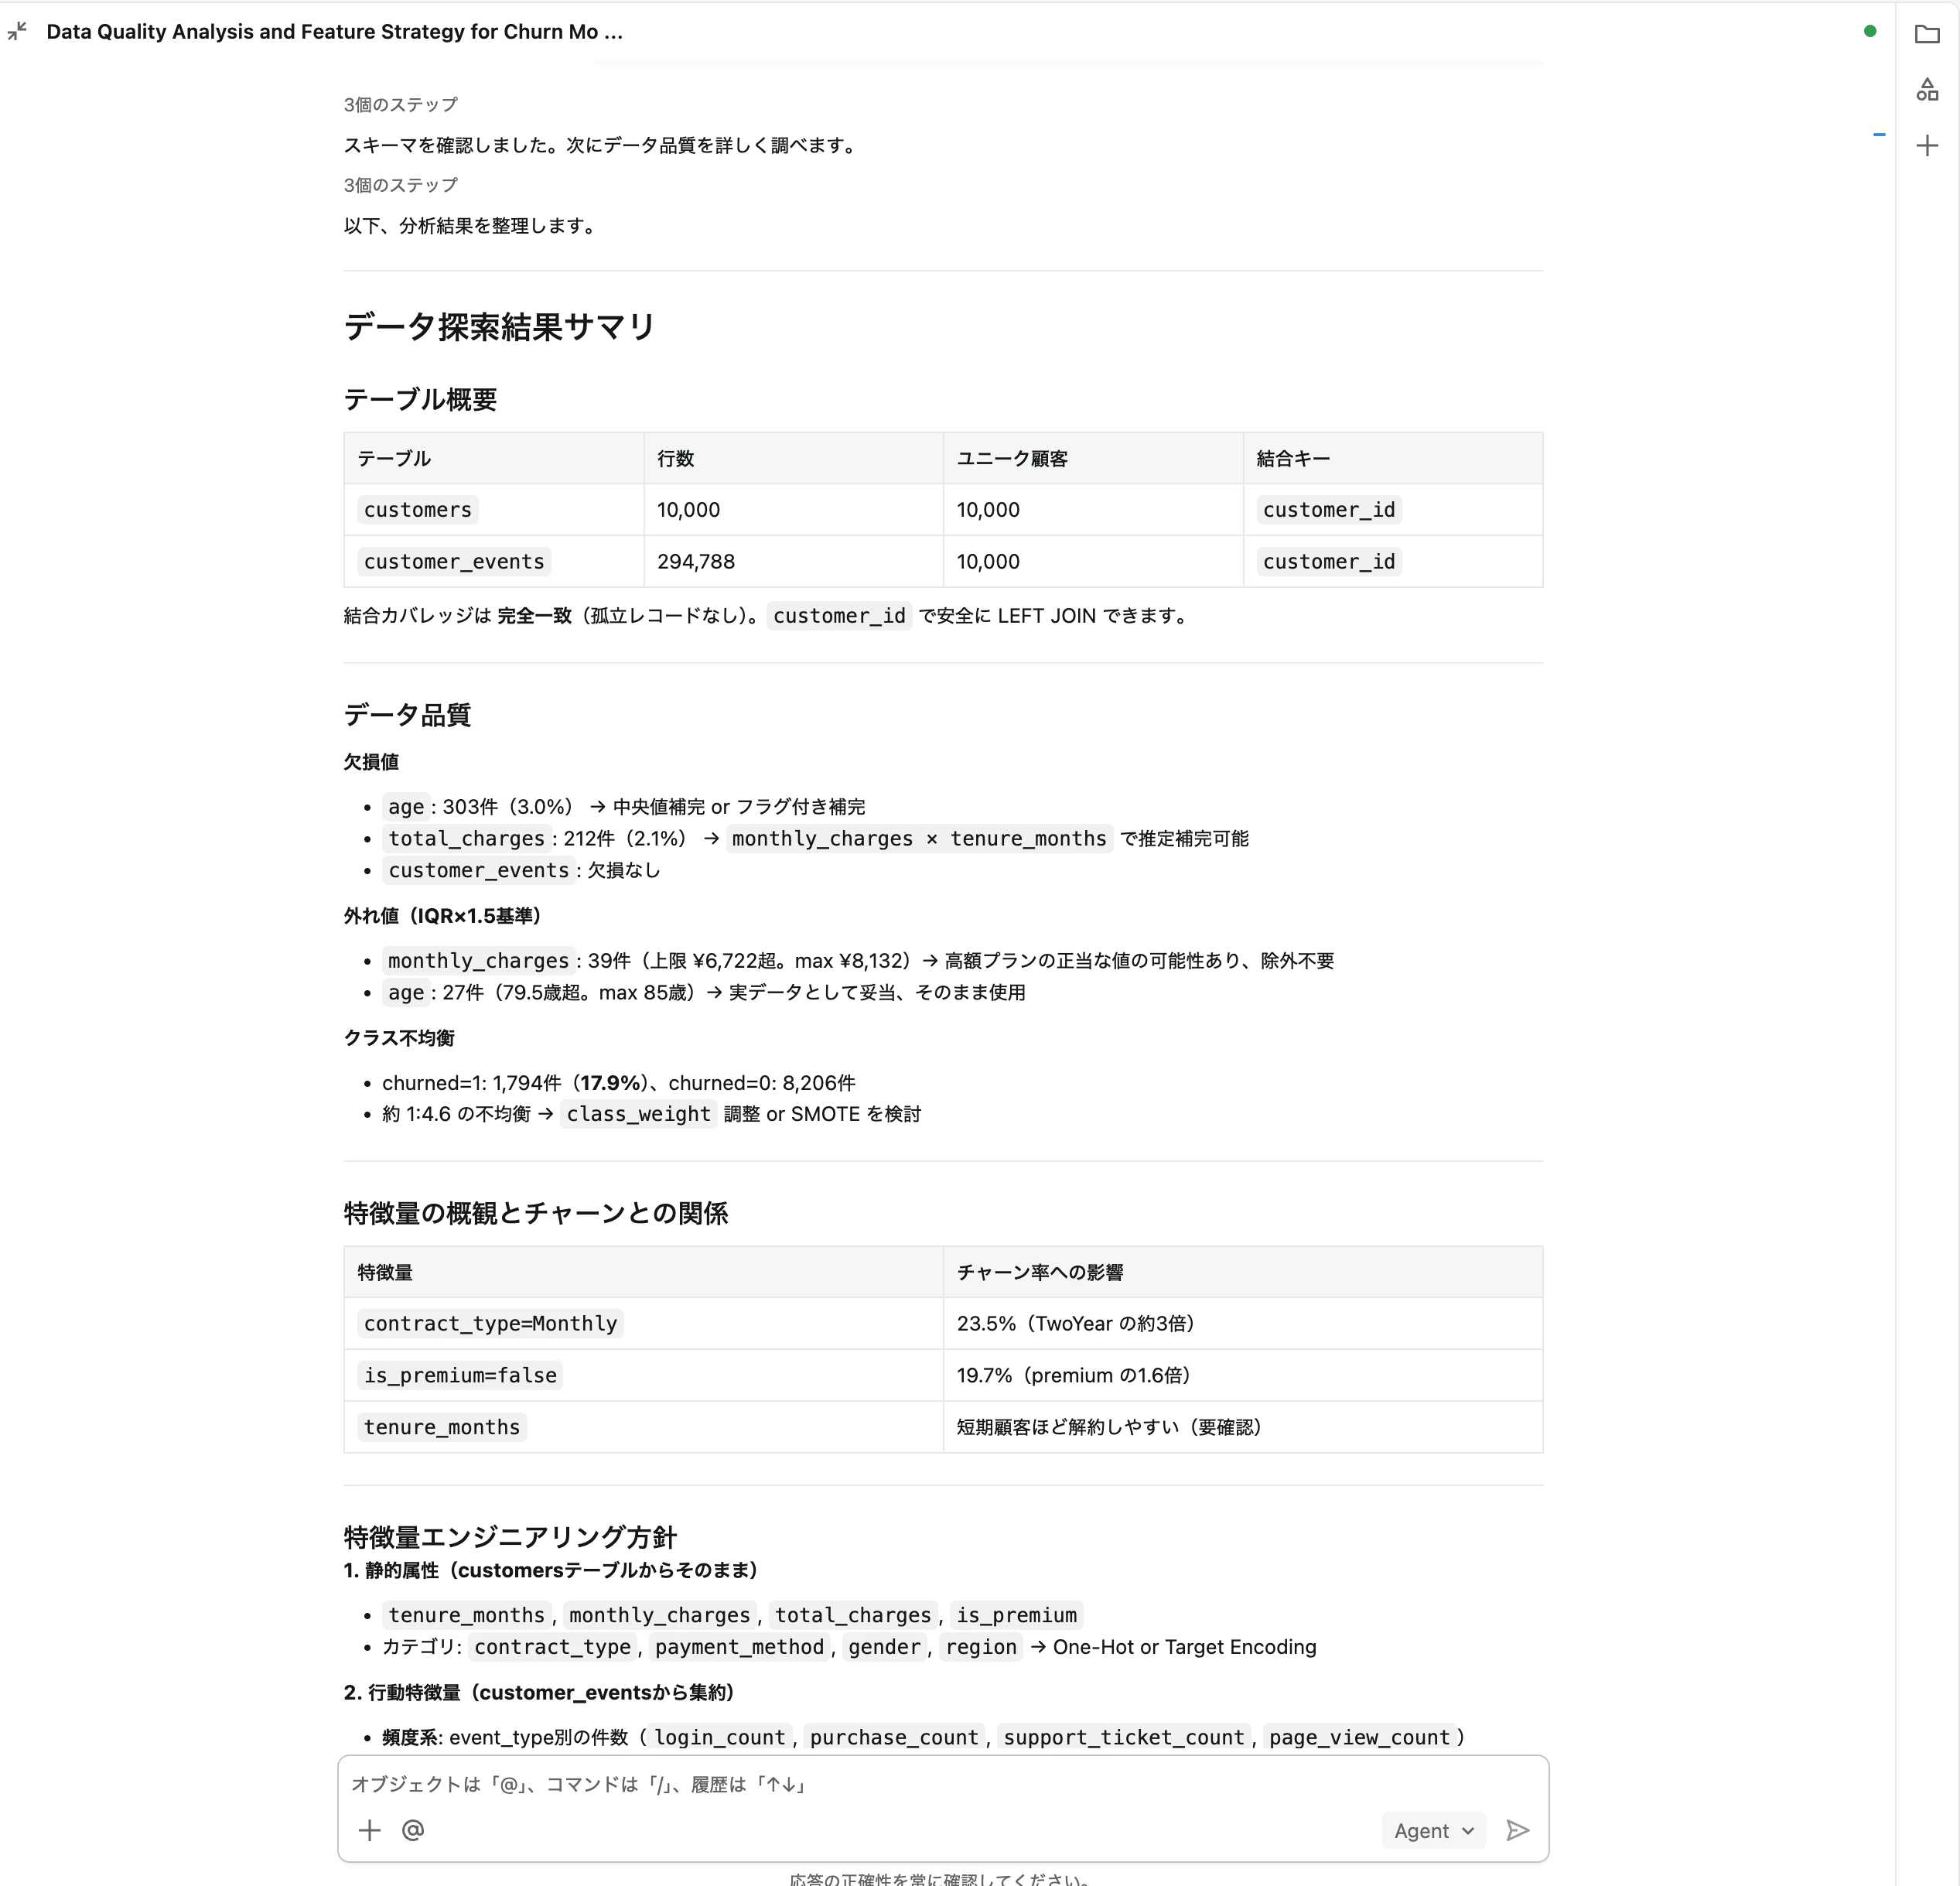
評価したいのは, 外れ値を機械的に弾かずにドメイン判断している点です。monthly_charges の高額値を「高額プランの正当な値の可能性があり除外不要」, 85歳を「実データとして妥当」と判断しています。汎用のコーディングエージェントとの差が出る部分です。
total_charges の欠損についても, monthly_charges × tenure_months で推定補完できると提案してきました。これはこのデータの生成ロジックそのものを逆算で当てており, スキーマと値の関係を読んだ上での提案になっています。
特徴量エンジニアリングの方針
探索に続けて, Genie Code は特徴量エンジニアリングの方針を提示しました。狙いどおり, 行動特徴量を customer_events から集約する方針を自力で立てています。整理すると次の構成です。
- 静的属性: tenure_months, monthly_charges, total_charges, is_premium と, カテゴリ変数 (contract_type, payment_method, gender, region) のエンコーディング
- 行動特徴量 (events から集約): event_type 別の件数 (login_count, purchase_count, support_ticket_count, page_view_count), 金額系 (purchase 合計 / 平均), 時系列系
- 派生特徴量: avg_charge_per_month, age 欠損フラグ + 中央値補完
- 不均衡対策: 学習時に scale_pos_weight を設定, 評価は PR-AUC / F1 を主に AUC-ROC を補助
特に時系列系について, Genie Code は「最も予測力が高い見込み」と明記しました。挙げてきたのは, 直近30日/90日のログイン回数, 最終ログインからの経過日数 (days_since_last_login), 最終購入からの経過日数, サポートチケット頻度の変化率です。
ここがこの検証の核心です。今回のデータは, チャーンを駆動するシグナルを recency (最終利用からの日数) に最も強く効かせています。ヒントを一切与えていないのに, Genie Code はデータ構造からリーケージなしで recency 系を最重要候補と判断しました。
特徴量テーブルの構築とモデル学習
方針が妥当だったので, 特徴量テーブルの構築と LightGBM 学習に進めました。
イベント集約の特徴量テーブルを takaakiyayoi_catalog.genie_code_ml_demo.churn_features として構築し,
そのうえで LightGBM でチャーン予測モデルを学習してください。
scale_pos_weight で不均衡に対処し, PR-AUC / F1 / Recall を記録してください。
学習結果は MLflow に記録し, 特徴量の重要度も確認できるようにしてください。
Genie Code は events を顧客単位で集約する SQL を書き, churn_features (10,000行 × 30列) を作成しました。days_since_last_login などの recency 系がきちんと入っており, サンプル行を見るだけでも recency とチャーンの関係が見えます (例: 最終ログインから408日 → churned=1, 64日 → churned=0)。
学習ステップでは, 最初に環境固有のエラーが出ました。
ModuleNotFoundError: No module named 'lightgbm'
サーバーレスコンピュートに LightGBM が入っていなかったためです。注目すべきは, Genie Code がこのエラーを自分で読み, %pip install lightgbm → %restart_python → 学習セルの再実行, という流れを人手の介入なしでリカバリしたことです。ブログにある「コードを実行・デバッグし」がそのまま動いた場面でした。
F1=0 からの自己デバッグ
学習は通りましたが, 最初の結果には明確な問題がありました。
| メトリクス | スコア |
|---|---|
| PR-AUC | 0.4692 |
| F1 | 0.0000 |
| Recall | 0.0000 |

PR-AUC が出ているのに F1 と Recall が0という組み合わせは, 「モデルはスコアの順位付けはできているが, 閾値0.5で陽性 (churn=1) を一件も予測していない」状態を意味します。確率が全件0.5を割っているわけです。best iteration: 7 という早すぎる早期停止 (binary_logloss 0.44) も学習不足を示していました。
ここで, この症状の原因究明だけを依頼しました。修正方法は渡していません。
学習は完了しましたが, PR-AUC が0.47ある一方で F1 と Recall が0になっています。
閾値0.5で陽性が一件も予測されていない状態だと思います。原因を診断してください。
PR曲線から F1 を最大化する運用閾値を選び, 不均衡を考慮した評価を出し直してください。
Genie Code はヒントなしで次のように切り分けました。
モデルが7ラウンドで早期停止し, 閾値0.5では Recall=0 になっています。scale_pos_weight が高すぎて logloss の最適化が早期に収束していますが, 確率出力の閾値調整が必要です。最適閾値を探索して再学習します。
そのうえで, PR曲線から F1 を最大化する運用閾値を探索し, 再学習まで自走しました。不均衡データで0.5という固定閾値を使うこと自体が不適切である, という本質的な論点を, エージェントが自分で言語化して対処した形です。
モデル評価と特徴量重要度
再学習後のモデル lgbm_churn_v2_tuned の評価結果です。
| メトリクス | スコア |
|---|---|
| PR-AUC | 0.5049 |
| F1 | 0.4860 |
| Recall | 0.5822 |
| Precision | 0.4172 |
| ROC-AUC | 0.7824 |
scale_pos_weight=4.57, 最適閾値0.3038 を採用し, チャーン顧客の約58%を捕捉する結果になりました。F1=0 だった前回からの改善理由が「閾値を0.5から0.30に下げたこと」だと明示されており, 不均衡データの典型的な落とし穴と対処がワンセットで見える, わかりやすい題材になりました。Recall 0.58 をそのまま「チャーン顧客の58%を捕捉」とビジネス言語に翻訳している点も実務的です。
特徴量重要度 (Gain) の上位は次のとおりでした。
| 順位 | 特徴量 | 意味 |
|---|---|---|
| 1 | contract_type | 契約タイプ (Monthly が最もチャーンしやすい) |
| 2 | page_view_last_90d | 直近90日のページビュー数 |
| 3 | login_count | 累計ログイン回数 |
| 4 | days_since_last_login | 最終ログインからの経過日数 |
| 5 | total_events | 総イベント数 |

これが今回の検証で最大の答え合わせになりました。データ生成時に最も強い係数を入れた contract_type がトップ (実測でも Monthly のチャーン率は23.5%で TwoYear の約3倍), 続く上位は customer_events から集約した行動特徴量が占めています。「予測シグナルを customers には入れず events にだけ持たせる」という当初の仕掛けが, 特徴量エンジニアリング → 学習 → 重要度まで貫通して証明されました。Genie Code 自身も「行動特徴量 (特にアクティビティの最近の低下を示す指標) が上位を占めており, 特徴量エンジニアリングの方針は妥当でした」と結んでいます。
ノートブックへの書き出しと二層構造
ここで, フルページ版の挙動として確認しておきたい点があります。Genie Code から直接作業を始めた場合, エージェントがペイン内で実行したコードと出力はスレッド側に残るもので, 自動的にノートブックファイルになるわけではありません。一方で, 作成された Delta テーブルや MLflow 実験は, チャットとは独立した永続アセットとしてワークスペースに残ります。
再現可能なノートブックを残したい場合は, 明示的に書き出しを依頼します。
ここまでの一連のパイプラインを1本のノートブックに書き出して
これで, スレッドの試行錯誤を整理したクリーンな全11セルのノートブックが, ワークスペースに保存されるファイルアセットとして生成されました。フルページのコマンドセンターは, このノートブックを実体のタブとして本文の横に並べて表示します。
| セル | 内容 |
|---|---|
| 1 | パイプライン概要 (Markdown) |
| 2-3 | セットアップ (pip install + restart) |
| 4-5 | データ品質チェック (欠損 / 外れ値 / クラス不均衡 / 結合カバレッジ) |
| 6-7 | 特徴量テーブル構築 (SQL: churn_features) + 確認 |
| 8-9 | LightGBM 学習 & MLflow 記録 (scale_pos_weight + 最適閾値) |
| 10-11 | 特徴量重要度の可視化 (Plotly + テーブル) |

重要なのは, エラー → pip install → restart で詰まった部分や, F1=0 → 閾値0.30への再学習といった試行錯誤の枝が, 最終ノートブックではクリーンな完成形に整理されていることです。スレッド (過程) とノートブック (成果物) で役割が分かれています。
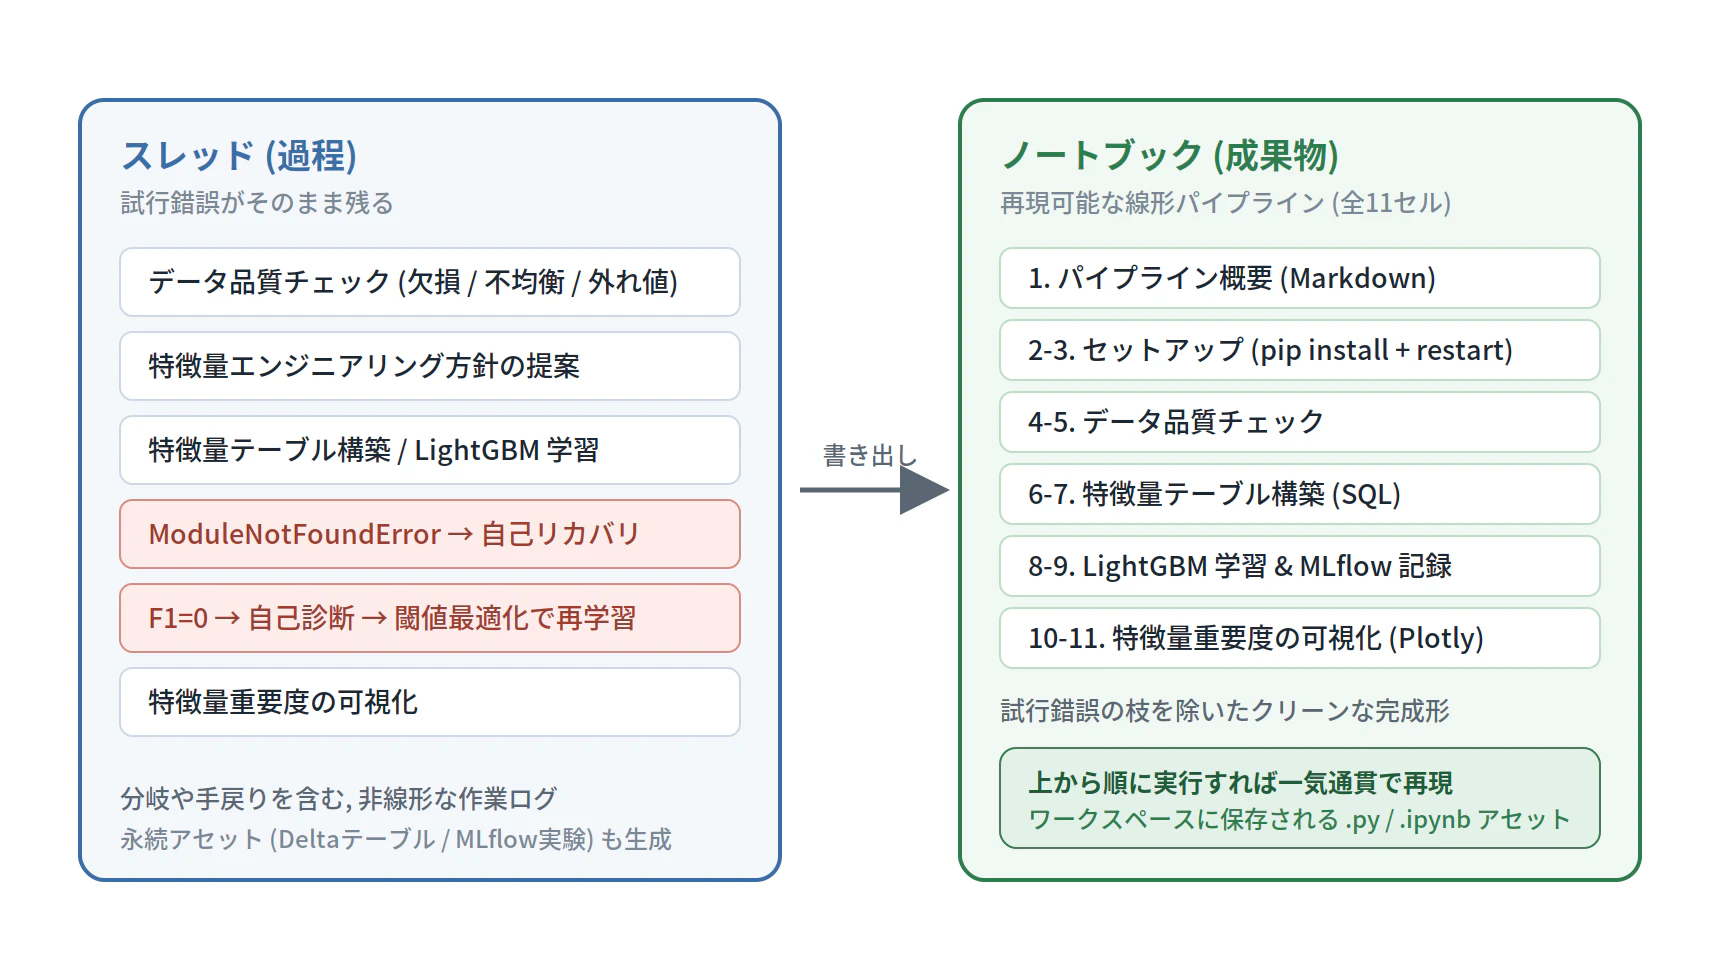
この「エージェントに作らせた過程はスレッドに, 再現可能な成果物はノートブックに」という二層構造そのものが, 従来のインタラクティブなノートブック開発とは異なる新しいスタイルだと感じました。書き出したノートブックは「上から順に実行すれば一気通貫で再現できる」状態なので, 記事や共有のためにそのまま渡せます。実際に渡す前に, seed 固定の有無を確認し, 一度通しで実行して数値を再現しておくと確実です (データ分割の乱数により最適閾値などは微妙に動きます)。
まとめ
ダミーデータのチャーン予測を題材に, Genie Code for ML を探索からデプロイ手前まで試しました。観察できたポイントは次のとおりです。
- フルページのコマンドセンターにより, ノートブックの UI を一度も開かずに ML の一周を完走できた。ステップが構造化されて見えるため, どこで何が起きたかを追いやすい
- ModuleNotFoundError の自己リカバリ, F1=0 の自己診断と閾値最適化など, 従来は人が介入してデバッグしていた場面をエージェントが自走で処理した
- 外れ値のドメイン判断や total_charges の補完方針など, 経験者が行う細かい処理を自分で入れてきた
- 特徴量重要度が, データ生成時に仕込んだ係数とほぼ一致した。recency / frequency 系の行動特徴量を events から正しく抽出できていた
- 「過程はスレッド, 成果物はノートブック」という二層構造で作業が残る
データを「予測シグナルを events 側に隠す」設計にしたことで, 特徴量エンジニアリングの実力が試せた点が, 今回の検証では効きました。ヒントなしで recency を最重要候補と見抜き, 学習後の重要度でそれが裏付けられる, という流れは, この機能を試すデモとして再現性があります。本記事のダミーデータ生成ノートブックを使えば, 同じ題材で手元でも試せます。
付録: ダミーデータ生成
本記事の検証に使ったダミーデータを生成するコードです。Databricks ノートブックに貼り付けて上から順に実行すると, Unity Catalog に customers と customer_events の2テーブルが作成されます。乱数シードを固定しているため, 本文中の数値 (churn率 17.9%, age 欠損 3.0%, total_charges 欠損 2.1%, events 294,788行) が再現されます。
出力先はウィジェットで指定します。カタログとスキーマは事前に作成済み, もしくは作成権限がある前提です。
dbutils.widgets.text("catalog", "main", "カタログ")
dbutils.widgets.text("schema", "genie_code_ml_demo", "スキーマ")
dbutils.widgets.text("customers_table", "customers", "顧客テーブル名")
dbutils.widgets.text("events_table", "customer_events", "イベントテーブル名")
dbutils.widgets.text("num_customers", "10000", "顧客数")

catalog = dbutils.widgets.get("catalog")
schema = dbutils.widgets.get("schema")
customers_table = dbutils.widgets.get("customers_table")
events_table = dbutils.widgets.get("events_table")
N = int(dbutils.widgets.get("num_customers"))

customers_fqn = f"{catalog}.{schema}.{customers_table}"
events_fqn = f"{catalog}.{schema}.{events_table}"

spark.sql(f"CREATE CATALOG IF NOT EXISTS {catalog}")
spark.sql(f"CREATE SCHEMA IF NOT EXISTS {catalog}.{schema}")
件数が大きくないため, ドライバー上で numpy / pandas で生成します。
import numpy as np
import pandas as pd

np.random.seed(42)
REF_DATE = pd.Timestamp("2026-06-01")    # 「現在」とみなす基準日
START_DATE = pd.Timestamp("2023-06-01")  # 登録開始日の下限
SIGNUP_SPAN_DAYS = 1065                   # 登録日の散らばり (約3年)

# customers: 静的属性
cust_id = np.array([f"CUST-{i:06d}" for i in range(N)])
signup_offset = np.random.randint(0, SIGNUP_SPAN_DAYS, N)
signup_date = START_DATE + pd.to_timedelta(signup_offset, unit="D")
tenure_days = np.asarray((REF_DATE - signup_date).days)
tenure_months = (tenure_days / 30).astype(int).clip(1, None)

age = np.random.normal(42, 14, N).clip(18, 85)
age[np.random.rand(N) < 0.03] = np.nan  # 約3%を欠損に
gender = np.random.choice(["Male", "Female", "Other"], N, p=[0.48, 0.48, 0.04])
region = np.random.choice(
    ["Kanto", "Kansai", "Chubu", "Kyushu", "Tohoku", "Hokkaido"], N,
    p=[0.35, 0.25, 0.15, 0.1, 0.1, 0.05])
contract = np.random.choice(["Monthly", "OneYear", "TwoYear"], N, p=[0.55, 0.3, 0.15])
payment = np.random.choice(
    ["CreditCard", "BankTransfer", "ConvenienceStore", "DigitalWallet"], N,
    p=[0.4, 0.25, 0.2, 0.15])
monthly_charges = np.random.normal(3500, 1200, N).clip(980, 9800).round(0)
total_charges = (tenure_months * monthly_charges * np.random.uniform(0.9, 1.1, N)).round(0)
total_charges[np.random.rand(N) < 0.02] = np.nan  # 約2%を欠損に
is_premium = np.random.rand(N) < 0.25
イベントは顧客ごとに可変件数で生成します。ログイン頻度の元になるアクティビティ水準を潜在変数として持たせています。
# customer_events: 顧客ごとに可変件数の生イベント
activity = np.random.gamma(2.0, 1.0, N)  # 高いほど活発
n_events = (activity * 15).astype(int).clip(3, 200)

ev_customer, ev_ts, ev_type, ev_value = [], [], [], []
for i in range(N):
    k = n_events[i]
    etypes = np.random.choice(
        ["login", "page_view", "purchase", "support_ticket"], k,
        p=[0.45, 0.35, 0.12, 0.08])
    span = max(int(tenure_days[i]), 1)
    offs = np.sort(np.random.randint(0, span, k))
    ts = signup_date[i] + pd.to_timedelta(offs, unit="D")
    for j in range(k):
        t = etypes[j]
        if t == "purchase":
            v = float(round(np.random.gamma(2, 1500), 2))   # 購入金額
        elif t == "support_ticket":
            v = float(np.random.randint(1, 5))              # 深刻度 1-4
        else:
            v = 0.0
        ev_customer.append(cust_id[i]); ev_ts.append(ts[j])
        ev_type.append(t); ev_value.append(v)

events_pdf = pd.DataFrame({
    "event_id": [f"EVT-{i:08d}" for i in range(len(ev_customer))],
    "customer_id": ev_customer, "event_timestamp": ev_ts,
    "event_type": ev_type, "event_value": ev_value,
})
チャーンラベルは, イベントから集計した潜在シグナル (最終利用からの日数, サポート件数, ログイン/購入回数) と契約属性のロジットから生成します。集計値はラベル生成にのみ使い, customers テーブルには保存しません。これが「予測に効く特徴量を events から作らせる」設計の肝です。
g = events_pdf.groupby("customer_id")
last_event = g["event_timestamp"].max()
recency_days = np.asarray((REF_DATE - last_event).dt.days.reindex(cust_id).fillna(999).values)
ticket_cnt = np.asarray(g.apply(lambda d: (d.event_type == "support_ticket").sum()).reindex(cust_id).fillna(0).values)
purchase_cnt = np.asarray(g.apply(lambda d: (d.event_type == "purchase").sum()).reindex(cust_id).fillna(0).values)
login_cnt = np.asarray(g.apply(lambda d: (d.event_type == "login").sum()).reindex(cust_id).fillna(0).values)

logit = (
    -1.9
    + 0.9 * (contract == "Monthly")
    - 0.7 * (contract == "TwoYear")
    + 0.018 * recency_days       # 最終利用から日が空くほどチャーン
    + 0.12 * ticket_cnt
    - 0.05 * login_cnt
    - 0.04 * purchase_cnt
    - 0.015 * tenure_months
    - 0.6 * is_premium
    + 0.3 * (payment == "ConvenienceStore")
    + np.random.normal(0, 0.4, N)
)
prob = 1 / (1 + np.exp(-logit))
churned = (np.random.rand(N) < prob).astype(int)

customers_pdf = pd.DataFrame({
    "customer_id": cust_id, "signup_date": signup_date, "tenure_months": tenure_months,
    "age": age, "gender": gender, "region": region, "contract_type": contract,
    "payment_method": payment, "monthly_charges": monthly_charges,
    "total_charges": total_charges, "is_premium": is_premium, "churned": churned,
})
最後に Delta テーブルへ書き込み, テーブルとカラムにコメントを付与します。コメントは Genie Ontology / Genie Code がスキーマの意味を理解するのに役立ちます。
from pyspark.sql import functions as F

customers_sdf = spark.createDataFrame(customers_pdf)
(customers_sdf.write.mode("overwrite").option("overwriteSchema", "true")
    .saveAsTable(customers_fqn))

events_sdf = (spark.createDataFrame(events_pdf)
              .withColumn("event_timestamp", F.col("event_timestamp").cast("timestamp")))
(events_sdf.write.mode("overwrite").option("overwriteSchema", "true")
    .saveAsTable(events_fqn))

spark.sql(f"COMMENT ON TABLE {customers_fqn} IS "
          "'顧客マスタ。静的属性とチャーンラベルを持つ。行動特徴量は customer_events から作成する想定。'")
spark.sql(f"COMMENT ON TABLE {events_fqn} IS "
          "'顧客の生イベントログ。login / page_view / purchase / support_ticket を含む。特徴量エンジニアリングの元データ。'")
spark.sql(f"ALTER TABLE {customers_fqn} ALTER COLUMN churned COMMENT "
          "'チャーンラベル。1=解約, 0=継続 (予測ターゲット)'")