

本記事は JEDAI もくもく会(2026年3月18日開催予定)向けのハンズオンガイドです。
内容は執筆時点(2026年3月)の情報に基づいています。最新情報は公式ドキュメントをご確認ください。
前半の説明資料はこちら。
2026年3月18日(水)、JEDAI(Japan Databricks User Group)もくもく会 にて「Databricksアシスタントが自分で考えて動く時代に!エージェントモード体験もくもく会」を開催します。本記事はそのイベント向けハンズオンガイドです。当日の参加者はもちろん、記事を見つけた方も自分のペースで試せます。
当日の録画はこちら。
はじめに:コパイロットから自律エージェントへ
従来のDatabricksアシスタント(チャットモード)は「1問1答」スタイルでした。コードの補完・提案には便利でしたが、毎ステップユーザーが指示を出す必要がありました。
エージェントモードはそれを大きく変えます。
| チャットモード | エージェントモード | |
|---|---|---|
| 動作スタイル | 1問1答 | 計画 → 実行 → 修正ループ |
| ユーザー操作 | 毎ステップ指示が必要 | ゴールを渡すだけ |
| コード実行 | 提案のみ(手動実行) | 自動実行・エラー自動修正 |
| 利用ツール | 限定的 | Unity Catalog・SQL・MCP・外部ツール |
| 適したタスク | 単発の質問・補完 | 複雑なマルチステップ作業 |
エージェントモードの仕組み
💬 指示 → 🧠 計画 → ⚙️ 実行 → 🔍 確認 → ✅ 完了
         ↑______________________↓(エラー・不足時に自動再ループ)
- 計画(Planning):タスクを分解し、実行ステップを自律的に立案
-
実行(Tool Use):PythonコードやSQLを生成・実行。Unity Catalog・MCP・Agent Skillsを活用
- 利用ツール:Unity Catalog / Notebookコード実行 / SQL・Genie / MCPサーバー / Agent Skills
- 確認・修正(Reflection):実行結果を評価し、不足があれば計画を修正して再実行
3つのエージェント+拡張機能
① データサイエンスエージェント
できること
- 探索的データ分析(EDA)の自動実行
- 統計サマリー・相関分析・可視化の自動生成
- 機械学習モデルの作成・評価
- 新規分析ノートブックのゼロから作成
- エラーの自動検出・修正
プロンプト例
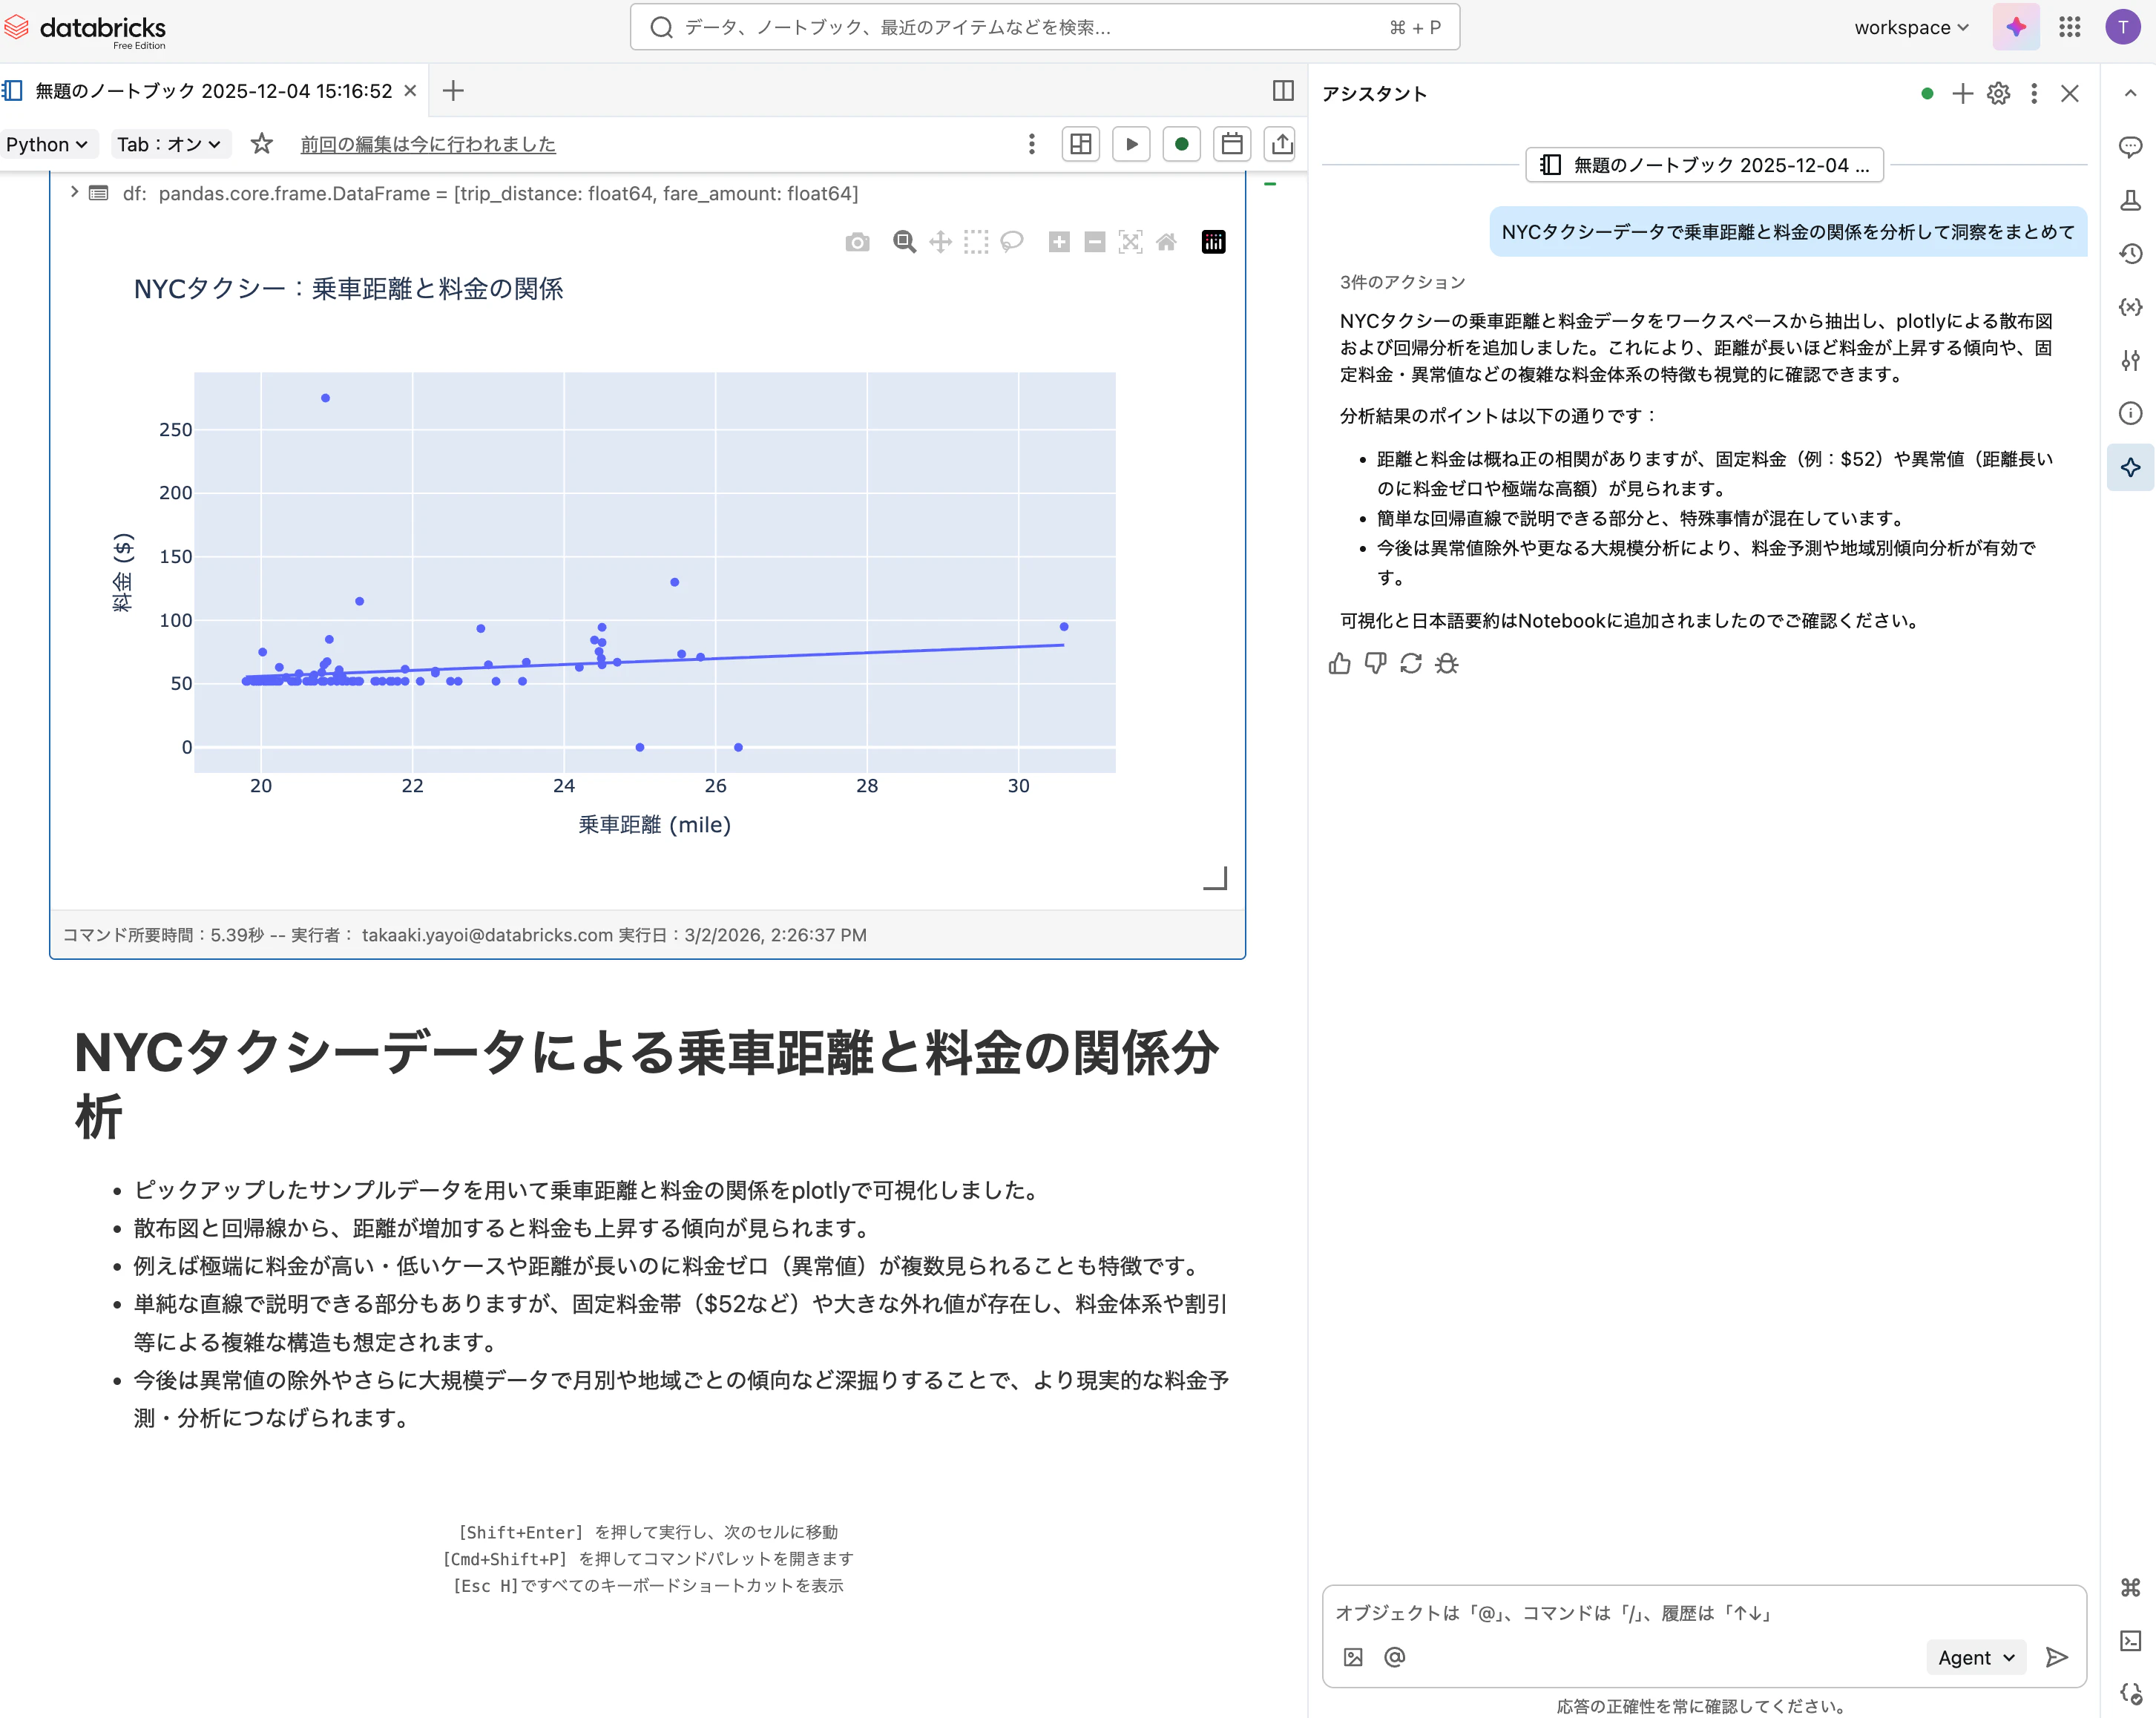
「NYCタクシーデータで乗車距離と料金の関係を分析して、主要なインサイトをまとめて」
ユースケース
- 定期EDAレポートの自動化
- データ品質チェック
- 顧客離脱・異常検知モデル作成
② データエンジニアリングエージェント

できること
- Spark宣言型パイプラインの自動生成
- データ変換・クレンジングの実装
- Bronze / Silver / Gold 変換ロジックの構築
- パイプラインのデバッグ・最適化
- Unity Catalogへの自動登録
プロンプト例
「S3のCSVデータを読み込んで、顧客マスタのシルバーテーブルにクレンジングして書き込むパイプラインを作って」
ユースケース
- ゴールドテーブルの集計処理
- 既存パイプラインのリファクタ
- 新規データソースの取り込み
③ ダッシュボードオーサリングエージェント

できること
- AI/BI Lakeviewダッシュボードの自動生成
- 自然言語でウィジェット追加・変更・修正
- データセット・クエリの自動作成
- フィルター・レイアウトの調整
- 作成後もチャットで追加修正可能
- ダッシュボードと共にGenie Spaceが自動生成
プロンプト例
「売上の月次推移と地域別トップ製品を見られるダッシュボードを作って」
ポイント:Business UserはそのままGenie Spaceでセルフサービス分析が可能
④ Agent Skills & MCP連携
Agent Skills(社内ドメイン知識の注入)
- KPIの定義・計算ロジック
- 特定の分析パターン
- 承認済みのデータモデル
- ビジネスルール・制約条件
MCP(Model Context Protocol)(外部ツール連携)
- Slackへの通知送信
- Jiraチケットの作成・更新
- 社内Wiki・ナレッジ参照
- 外部APIとの連携
Unity CatalogでMCPサーバーを登録・管理できます。
Genie Code
こちらの資料を作成後に、Genie Codeが発表されました。
Databricksアシスタントから Genie Code へ: 進化の全体像
2026年3月11日、Databricksは Genie Code を発表しました。従来のDatabricksアシスタントの「リネーム」ではなく、データチーム向けに特化した自律型AIエージェントへの根本的なアーキテクチャ進化です。
従来のアシスタントとGenie Codeの比較
| 観点 | 従来のアシスタント | Genie Code |
|---|---|---|
| 位置づけ | UIベースのペアプログラマー / サポートエージェント | データチーム向け自律型AIパートナー |
| 操作モード | チャット / 編集 / エージェント(プレビュー)の3モード | すべてを統合。プロダクトサーフェスに応じて自動適応 |
| 対話スタイル | 1問1答のQ&A中心。ステップごとにユーザーが指示 | ゴールを伝えるだけでマルチステップの計画→実行→検証→修正を自律実行 |
| モデル | 単一のLLMベース | マルチモデルルーティング。タスクごとに最適なモデルを自動選択 |
| データ理解 | Unity Catalogメタデータを参照 | Unity Catalogと深く統合。リネージ、利用パターン、ビジネスセマンティクスを自動キュレーション |
| データサイエンス | コード補完、エラー修正の提案 | フルMLワークフロー(特徴量選定→学習→評価→MLflowログ→サービング最適化)をエンドツーエンドで実行 |
| データエンジニアリング | コード生成の補助 | Lakeflow SDPパイプラインの自然言語生成、CDC構成、データ品質期待値の適用 |
| ダッシュボード | ダッシュボード作成の補助 | セマンティック定義付きのマルチページダッシュボードを自律生成 |
| 本番運用・保守 | なし | バックグラウンドでパイプライン・モデルを監視。障害トリアージ、異常検知、リソース最適化を自律実行 |
| オブザーバビリティ | なし | Model Serving + MLflow 3.0統合。エンドポイント健全性チェック、エージェントトレース分析、ハルシネーション検出 |
| 拡張性(MCP) | なし | Jira、Confluence、GitHub等と接続。ワークスペース外の自律ワークフロー |
| Agent Skills | なし | ドメイン固有のベストプラクティスをエージェントに注入 |
| 記憶・学習 | セッション内のコンテキストのみ | 永続メモリ。過去のインタラクションから自動学習 |
| 利用場所 | ノートブック、SQLエディタ | ノートブック、SQLエディタ、Lakeflowパイプラインエディタ、AI/BIダッシュボード |
| ベンチマーク | 公開データなし | 実タスクで77.1%の完了率(主要コーディングエージェント+MCP: 32.1%の2倍以上) |
最大の変化: 受動から能動へ
従来のアシスタントが「ユーザーの指示に対してコードを返す」受動的なツールだったのに対し、Genie Codeは「ゴールを受け取って自律的に計画・実行・検証・修正する」能動的なエージェントへ転換しました。
特に注目すべき新機能は以下の3つです。
- 本番運用のプロアクティブ保守: Lakeflowパイプラインやモデルをバックグラウンドで監視し、障害のトリアージや異常の調査を人間が気づく前に自律的に実行
- MCP経由の外部ツール連携: Jira、Confluence、GitHubなどと接続し、Databricksワークスペースを超えた自律的なワークフローを実現
- 永続メモリによる継続的学習: チームが使えば使うほど賢くなり、コーディング好みや頻用データセットを記憶
参考リンク
プロンプトのベストプラクティス
エージェントモードをうまく使うコツをまとめました。
1. ゴールを明確に伝える
❌ 「データを分析して」
✅ 「NYCタクシーデータ(trips テーブル)で2024年の乗車距離と料金の相関を分析し、外れ値の原因を特定してまとめて」
2. データの場所を指定する
❌ 「顧客データを使って」
✅ 「main.sales.customers テーブルを使って」
3. 出力形式を指定する
- 「グラフにして可視化して」
- 「Markdownの表でまとめて」
- 「ノートブックにまとめて保存して」
4. 段階的に指示を出す
複雑なタスクは複数のプロンプトに分ける:
- まず「データを探索して概要を教えて」
- 次に「欠損値の多い列をクレンジングして」
- その後「クレンジング済みデータで機械学習モデルを作って」
5. エラーは任せる
エージェントモードはエラーを自動検出・修正します。エラーが出ても慌てずに待ちましょう。
6. Unity Catalogのデータを活用する
エージェントはUnity Catalog内のテーブルを自動発見します。カタログ・スキーマ名を指定するとより正確になります。
ハンズオンの流れ(約50分)
事前準備
- Databricks Free Editionアカウント(無料)が必要です
- ブラウザ(Chrome推奨)
Step 0(5分):環境確認
- Databricksワークスペースにログイン
- 左サイドバーの 「Databricks Assistant」 アイコンをクリック(✨マーク)
- アシスタントパネルが右側に開くことを確認
- 上部の 「Agent」 または 「エージェント」 タブに切り替える
ポイント:エージェントモードは現在パブリックプレビューです。利用できない場合はワークスペース管理者に確認してください。
Step 1(15分):データサイエンスエージェントを試す
NYCタクシーデータを使ったEDA(探索的データ分析)を自動化します。
手順
- 新しいノートブックを作成(任意)
- アシスタントパネルをエージェントモードに切り替え
- 以下のプロンプトを入力:
NYCタクシーのトリップデータ(samples.nyctaxi.trips テーブル)を使って、
以下の分析を行い、このノートブックにまとめてください:
1. データの基本統計量(件数、主要カラムの平均・最大・最小)
2. 乗車距離と料金の相関分析(散布図付き)
3. 曜日・時間帯別の乗車傾向の可視化
4. 主要なインサイトを3つ箇条書きで
- エージェントが自動でコードを生成・実行するのを観察する
- エラーが出た場合、自動で修正されることを確認する
確認ポイント
- コードが自動生成・実行された
- グラフ・可視化が表示された
- インサイトがまとめられた
Step 2(15分):ダッシュボードオーサリングエージェントを試す
Step 1の分析結果からLakeviewダッシュボードを自動生成します。
手順
- アシスタントに以下を入力:
NYCタクシーの分析ダッシュボードを作成してください。
- samples.nyctaxi.trips テーブルを使用
- 月次乗車件数の推移(折れ線グラフ)
- 乗車距離分布(ヒストグラム)
- 平均料金のランキング(棒グラフ)
- 日付でフィルタリングできるようにして
- ダッシュボードが自動生成されるのを待つ
- 生成されたダッシュボードを開く
- チャットで追加修正を依頼する:
月次の乗車件数の棒グラフも追加して、
全体のレイアウトを整理してください
確認ポイント
- ダッシュボードが自動生成された
- ウィジェットが追加・修正できた
- Genie Spaceが自動生成された
Step 3(15分):もくもくタイム
自由に試してみましょう!以下のテーマから選んで挑戦してください:
テーマ例
- 自社業務に近いデータモデルをイメージしてEDAを試す
- データエンジニアリングエージェントでパイプライン草案を作る
- ダッシュボードをさらにカスタマイズする
気づいたこと・うまくいったこと・困ったことは Slackまたはチャット でシェアしてください!
まとめ(5分):振り返り & シェア
- 参加者同士で気づきをシェア
- 「こんなことができた!」「ここが難しかった」を話し合いましょう
- 次回のテーマについてアイデアを募集
時間が余った方向け:サンプルプロンプト集
エージェントモードをもっと試したい方向け。コピーして使ってください。
データサイエンス系
# 1. 異常検知
samples.nyctaxi.trips テーブルで、異常に高い料金(外れ値)を
統計的手法で検出し、その特徴を分析してください。
IQR法とZスコア法の両方で試して比較してください。
# 2. 時系列予測
samples.nyctaxi.trips の月次乗車件数を使って、
Prophet または ARIMA で将来3ヶ月の需要を予測し、
予測結果をグラフで可視化してください。
# 3. クラスタリング
NYCタクシーの乗客をK-Meansでクラスタリングしてください。
特徴量:乗車距離、料金、乗車時間帯、曜日
最適なクラスター数をエルボー法で決定してから実行してください。
# 4. 機械学習モデル
タクシー料金を予測する機械学習モデルを作ってください。
目的変数:fare_amount
説明変数:trip_distance, pickup_hour, day_of_week, passenger_count
XGBoostとランダムフォレストを比較して、精度の高い方を採用してください。
データエンジニアリング系
# 5. データクレンジングパイプライン
samples.nyctaxi.trips テーブルを対象に、
以下のクレンジングを行うDelta Live Tablesパイプラインを設計してください:
- 負の料金・距離の除外
- 乗車時間が0分または24時間超の除外
- 必要カラムのnull除外
Bronze→Silverの変換として実装してください。
# 6. ゴールドテーブル集計
以下の集計テーブルをSilver→Goldとして作成してください:
- 日次:乗車件数、平均料金、平均距離
- 週次:同上+前週比
- 月次:同上+前月比
パーティションはdate列で設定してください。
ダッシュボード系
# 7. エグゼクティブサマリーダッシュボード
NYCタクシーのKPIダッシュボードを作成してください:
- 当月の乗車件数・売上・平均料金(前月比付き)
- 週次トレンドの折れ線グラフ
- 時間帯ヒートマップ
- 上位乗車エリアのランキング
シンプルで経営陣が見やすいデザインにしてください。
# 8. オペレーション分析ダッシュボード
タクシー運行効率の分析ダッシュボードを作成してください:
- 乗車率の時間帯分布
- 平均待機時間の推移
- 距離別料金の分布
- 効率の悪い運行パターンのハイライト
フィルター:日付範囲、曜日
応用・チャレンジ系
# 9. レポート自動生成
2024年の NYCタクシー利用状況について、
ビジネスレポートを自動生成してください。
以下を含めてください:
- エグゼクティブサマリー(3行)
- 主要KPIの月次推移
- 注目すべきトレンド(3つ)
- 改善提案(2つ)
最後にMarkdown形式でノートブックに保存してください。
# 10. データ品質チェック
samples.nyctaxi.trips テーブルのデータ品質レポートを作成してください:
- 各カラムのnull率
- 外れ値の割合
- 重複レコードの有無
- 期待値範囲外のデータ件数
問題が見つかった場合は修正方法の提案も含めてください。
まとめ
Databricksアシスタントのエージェントモードは、データ作業の「自動化」を新しいレベルに引き上げます。
- 指示するだけでEDA・可視化・ML・ダッシュボード生成が完了
- エラーも自動修正でストレスなく開発が進む
- Unity Catalog連携で社内データをそのまま活用
- MCP・Agent Skillsで社内ツールとのシームレスな連携
ぜひ日常のデータ作業で試してみてください。感想やユースケースは JEDAI Discord でシェアしてもらえると嬉しいです!
参考リンク
公式ドキュメント(日本語)
- Genie Code のご紹介 | Databricks Blog
- Genie Code | Databricks on AWS
- Genie Codeを使用する | Databricks on AWS
- エージェントスキルで Genie Code を拡張する | Databricks on AWS
- Genie CodeをMCPサーバーに接続する | Databricks on AWS
- Lakeflow Spark宣言型パイプライン
- Unity Catalog
- Databricks Free Edition