
ある日、私は Claude Code に「チャットの移行は早すぎる」と言い、続けて「実務上どれくらい膨らんだら引き継いだほうが良い?」と聞きました。
公開記事に答えは在ります。既定は窓の約 95% で自動の要約が入る、要約 1 回に 10〜20 万トークンかかる、といった説明です。ただ、その多くは 200K の窓の頃の話です。私の窓は 100 万トークンで、使い方も私のものです。そこで一般論ではなく、自分の 1 週間の記録に「文脈が T を超えたら自動の要約」を当てはめ直して、T ごとに読み込みの合計と要約の回数を出しました。
- この記事で新しく示すこと: 自分の記録から自分用の線を出す手順(4 手)と、その計算の数・要約の後の上乗せの置き方(約 2.37 万)・文脈の大きさで出力の速さが変わらなかったこと。
- 当てはまる範囲: 1 人・1 環境(Claude Code デスクトップ・Opus 5.5・窓 100 万)の使い方。探索的です(1 週間の 1 回の計算で、反復していません)。
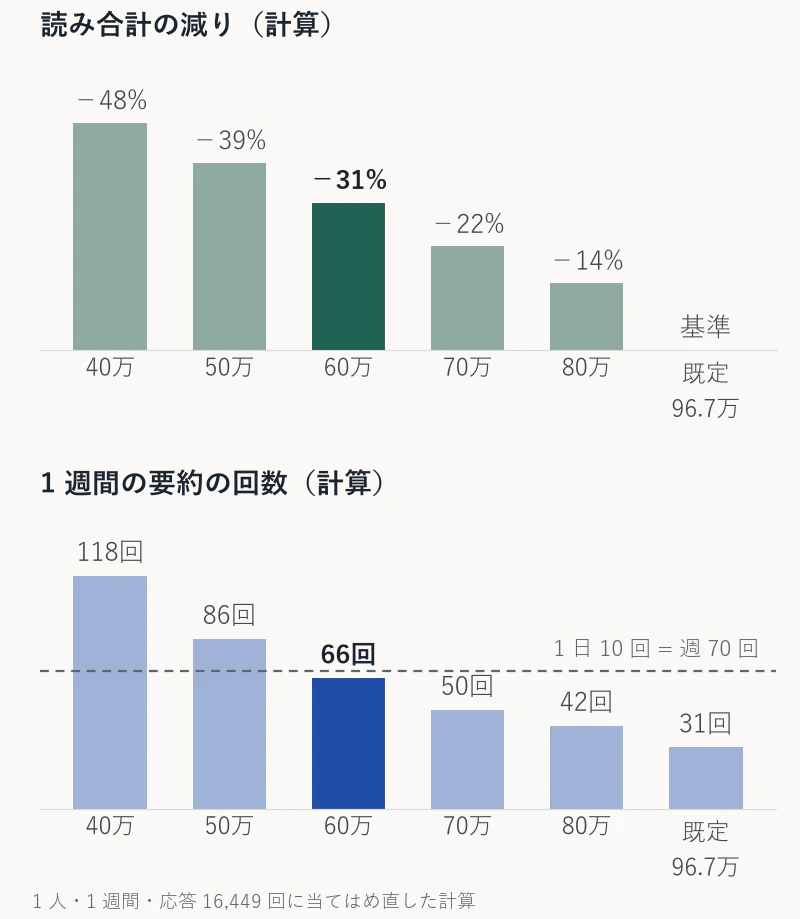
結果を先に書きます。線を 60 万にすると、読み込みの合計は既定の線(約 96.7 万)より 約 31% 少なく、要約は週 66 回になる計算でした。これは計算です。線を変えて実際に回した結果ではありません。 実際に 60 万へ設定した後の 1 週間は、まだ測れていません。
数字の元データと再現の手順は、検証の記録(Lab)にまとめています。
線はどこにあって、どこで動かせるのか
窓が 100 万のとき、既定の線は約 967K(約 96.7 万)です。動かす口は公式の Settings reference と Model configuration に書かれていて、2026-10-07 に読み直しました。
-
autoCompactWindow: 設定ファイルに書く(10 万〜100 万トークン・既定は"auto") -
/autocompact 500k: いま使っているモデルの値をmodelSettingsに保存する -
--auto-compact-window: その会話だけ変える - 環境変数
CLAUDE_CODE_AUTO_COMPACT_WINDOW: ほかの設定より優先される
モデルごとの設定には Claude Code v2.1.288 以降が要ります。私は 10-06 に、設定ファイルへ次の 1 行を足しました。
"autoCompactWindow": 600000

写真は設定ファイルの末尾です(ほかの行は省きました)。
自分の記録で線を出す 4 手
材料は、Claude Code が自分の PC に保存している会話の記録(jsonl)です。私の場合、9 月 29 日以降に更新された会話のうち、Opus の応答が 30 回以上あるもの 32 本(作業員の記録は除く)、応答 16,449 回でした。
-
応答ごとの文脈を 1 回だけ数える。 文脈は
cache_read_input_tokens・cache_creation_input_tokens・input_tokensの和です。1 つの応答は記録の複数行に分かれて同じ usage を持つので、message.idごとに最大の値を取ります。 - 実際の要約の位置を拾う。 文脈が 30 万以上いきなり縮んだ所を要約とみなしました(手動の要約も含みます)。この 1 週間で 31 回、要約が入った時の文脈は中央 963,866、縮んだ先 S は中央 106,005 でした。公式の既定(約 96.7 万)と同じ所で入っています。
- 要約の後の上乗せ R を置く。 要約の後は読み直しで文脈の増え方が大きくなります。要約の直後 20 応答の増えの合計の中央と、ふだんの 20 応答分(1 応答の増えの中央 × 20)の中央どうしの差が R で、約 2.37 万(23,725)でした。
- 線 T ごとに当てはめ直す。 応答ごとの増えを同じ順に積み、文脈が T に届いたら(その文脈を要約のために 1 回読む分を足して)S + R まで縮めて続けます。
def sim(W, R, S):            # W=線・R=要約後の上乗せ・S=縮んだ先
    tot = comp = 0
    for _, seq in traces:    # 会話ごとの「応答ごとの文脈」の並び
        c = seq[0]
        for j in range(1, len(seq)):
            d = seq[j] - seq[j - 1]
            if d < -300_000: d = 0           # 実際の要約の縮みは積まない
            c = max(c + d, S if comp else 0)
            if c >= W:
                tot += c                      # 要約のために 1 回読む
                comp += 1
                c = S + R
            tot += c
    return tot, comp
読み合計は、各応答の文脈の和(単位は億トークン)です。費用そのものではなく、読み込みのトークン数で比べています。
計算では、60 万で読みは約 3 割減る
| 線 T | 読み合計 | 既定(96.7 万)比 | 週の要約 |
|---|---|---|---|
| 20 万 | 27.70 億 | −66.4% | 481 回 |
| 30 万 | 35.08 億 | −57.4% | 195 回 |
| 40 万 | 43.11 億 | −47.6% | 118 回 |
| 50 万 | 50.05 億 | −39.2% | 86 回 |
| 60 万 | 56.92 億 | −30.9% | 66 回 |
| 70 万 | 64.50 億 | −21.7% | 50 回 |
| 80 万 | 70.80 億 | −14.0% | 42 回 |
| 96.7 万(既定) | 82.34 億 | 基準 | 31 回 |
線を下げるほど読みは減り、要約は増えます。60 万を選んだ理由は、読みが 1 割以上減り、要約が 1 日 10 回を超えない線のうち、いちばん下げた線だからです。60 万は週 66 回(1 日 9.4 回)、50 万は週 86 回(1 日 12.3 回)で超えます。この基準は表を見た後に置いたものです。
R の置き方に結論が動くかも見ました。R を 0 にしても、2 倍(約 4.7 万)にしても、60 万は −30.9%〜−30.0%・63〜68 回でした。
設定した後、実際は何万で要約が入ったか
計算とは別に、記録に残った自動の要約の位置も見ました(手動の /compact は除いています)。
| 区分 | 件数 | 要約が入った文脈 |
|---|---|---|
| 設定の前(08-03〜10-06・版 2.1.219〜2.1.286) | 59(記録の行では 66) | 96.6 万〜100.2 万(90 万未満は 0) |
| 設定の後に始めた会話(10-07・版 2.1.288) | 2 | 56.7 万と 56.7 万(567,638・567,401) |
| 設定の前から走っていた会話(版 2.1.288) | 2 | 85.6 万と 80.1 万 |
記録の行では 66 件ですが、同じ時刻・同じ値の要約が別の会話の記録にも写っている行が 7 つあり、重ねを除くと 59 件です(幅は変わりません)。
設定の後に始めた 2 つの会話は、2 回とも約 56.7 万で要約が入りました。60 万の設定で 56.7 万になる仕組みと、走っていた会話が 80〜86 万だった理由は確かめていません。観測だけ書きます。
別の操作:新しい会話へ移る線も、同じ形で計算できる
ここまでは「同じ会話の文脈を要約で縮めて続ける」話です。もう 1 つ、「文脈を捨てて新しい会話に書き置きを渡して始め直す」操作(移行)にも線が引けます。要約と移行は別の操作なので、上の表には混ぜません。
別の週(9 月 26 日以降)の司令塔の会話 58 本・応答 5,589 回に、「文脈が T を超えたら新しい会話へ移る」を当てはめ直しました。移行のたびに、書き置きを書く 3 回分(T の 3 倍)と、新しい会話が書き置きを読み直す分(新しい会話の最初の 12 回の実測から 135 万)を足し、新しい会話の始まりは 9.4 万としています。実際の読み込みは 24.65 億でした。
| 線 T | 読み込み | 実際比 | 移行 |
|---|---|---|---|
| 30 万 | 11.53 億 | −53% | 週 51 回(1 日 7.3 回) |
| 40 万 | 13.33 億 | −46% | 週 28 回(1 日 4.0 回) |
| 50 万 | 15.48 億 | −37% | 週 24 回(1 日 3.4 回) |
| 60 万 | 16.56 億 | −33% | 週 14 回(1 日 2.0 回) |
| 70 万 | 18.03 億 | −27% | 週 12 回(1 日 1.7 回) |
60 万の −31%(要約・R 込み)と −33%(移行)は近い数ですが、週も仕組みも違います。同じことを 2 度測って一致した、という話ではありません。 「同じ形の計算ができる」という例として置きました。
速さは、線を決める理由にならなかった
文脈が太ると遅くなるのでは、とも考えました。Opus 5.5 の応答 14,424 件(上の 2 区分は作業員の応答を含みます)で、文脈の区分ごとに見ました。

出力の速さ(出力 300 トークン以上の応答の中央値)は、文脈が 5〜10 万で 94、10〜20 万で 108、20〜40 万で 102、40 万以上で 103 トークン/秒と、ほぼ平らでした。最初の行が出るまでの待ちは 3.3→2.8→3.5→4.5 秒で、40 万以上でいちばん長い(4.5 秒)ものの、差は 2 秒に届きません。文脈が太っても遅くはならず、読み込みのぶん高くなるだけ、というのがこの記録の見え方です。区分の最後は集計の上端が 200 万ですが、窓は 100 万なので「40 万以上」と書きました。
数え直して直した所
- 最初の控えに書いた「週の要約 39・63・109 回」は、R を 0 にした行の数でした。R を入れた値は 42・66・118 回です。
- 控えに写した応答数 5,585 は、結果のファイルでは 5,589 でした。ファイルを正にしました。
私の答えと、まだ測っていないこと
- 60 万は私の答えで、あなたの答えではありません。 使い方が違えば、読みの減りも要約の回数も変わります。上の 4 手を自分の記録で回してください。
- 要約で失う情報の害(作業の質)は数えていません。線を下げるほど増える側の損は未測定です。
- 設定した後の 1 週間の実際の読みと要約の回数は、まだ取れていません。取れたら計算と並べて追記します。
- 料金の話にはしていません。定額のプランで余裕のある週に読みを減らしても、得にはなりません。プランの枠への効きは方向値(1 区間・1% 刻み)までしか見ていません。
- 窓 100 万の話です。200K の窓での「約 95% で自動」の話とは混ぜていません。
自分の記録で回す道具(応答ごとに 1 回数える読み方・線の積み直し・速さの区分と、合成の入力での試験)→ github.com/sumitsuke/claude-code-session-ledger
この記事の本家(計算の前提・うまくいかなかったこと・出力の写し)は Sumitsuke Lab → Claude Code の自動の要約の線を引き直す計算——32 本の会話・16,449 応答に当てはめた記録
AI の利用について
記録の集計・計算の道具・この記事の下書きは AI(Claude Code)が行い、線を変える・公開の判断は人が行っています。
この記事は Zenn にも同じ内容を掲載しています。