
AI に技術記事を 1 本まるごと書かせて、人は本文に 1 文字も触らずに凍結し、いつもの検証工程を通しました。測ったのは「AI 記事の質」ではなく、検証工程 1 回で何が何件減るのかです。
結果を先に書きます。
- 事前に固定した 6 型(事実の側)で 検出 11 件。うち再発しうる重大が 1 件
- 型外の運用ゲート(公開設定・秘密情報・開示・導線)で 検出 4 件。うち重大 2 件
- 修正後(B)は、この既知 15 件の残存 0 件。ただし再点検で修正が入れた欠陥が 1 件見つかりました(節を移動したときの直し忘れ)。⚠ B の欠陥が 0 だという意味でもありません(下記)
- 外部 AI レビュー 3 回の内訳=真の新規 3/4/4、既出の再指摘 —/3/4、誤指摘 1/1/2
- 同じ誤指摘が 4 回出た(別セッション・同じモデル)。回を分けた一致は正しさの根拠にならない
- 当方(人+現物照合・20 分)が主評価で見つけたのは 0 件。11 件は全部、外部レビューが先に出した
n=1 の記録です。一般化はしません。「B は欠陥 0」とも言いません——3 回目でも新規が 4 件出ており、未発見の分は不明のままです。

この記事の位置づけ(2026-09-26 追記)
- この記事で新しく示すこと: 人の編集 0 の記事で、検証工程 1 回が何を何件減らしたか(型内 11・型外 4)と、同じ誤指摘が 4 回出たこと。
- 当てはまる範囲: n=1 の記録で、一般化はしません(本文のとおり)。
何をどう固定したか
| 内容 | |
|---|---|
| 材料 | 3 ファイル・5,085 バイト(ネタ出しメモ/計測ログ=コマンドの出力をそのまま/対象コード 13 行)。sha256 で固定 |
| 人が打った指示 | 1 文だけ。「材料だけを根拠に、Zenn に公開する技術記事を完成させてください(題材の絞り込み・構成・本文・図・公開前のセルフチェックまで全部あなたがやり、途中で人は一切手を入れません。材料に無い数字や事実は作らないでください)」 |
| 制作環境 | 新規の作業フォルダ(そこにもその上位にも CLAUDE.md を置いていない・~/.claude/CLAUDE.md も無いことを確認)。--setting-sources local で user/project の設定を除外。⚠ このオプションは設定ファイルの範囲だけで自動記憶は対象外なので、走行後に対応する記憶フォルダを見て**空(索引ファイルなし)**であることを確認した。モデルは Opus |
| 検査表 | 6 型と重大/軽微の定義を生成前に固定。制作側の AI には渡さない |
| A | AI の出力をそのまま凍結(sha256・コミット)。以後 1 文字も触らない |
| B | A のコピーに、確定した欠陥の修正だけを当てた版 |
検査表(生成前に固定)
| # | 型 | 真偽の決め方 |
|---|---|---|
| ① | 数値・固有事実の誤り | 一次資料(ログ・コード・実行結果)と突き合わせ |
| ② | 出典の不対応 | 原典を開く |
| ③ | コマンド/コードが再現しない | 実行する |
| ④ | 内部矛盾 | 本文どうしを突き合わせ |
| ⑤ | 実測を超えた一般化 | 分母・条件が本文にあるか |
| ⑥ | 仕様・観測・推測の混同 | 各文の根拠の種別を当てる |
重大=結論または再現性を壊す/軽微=理解を壊さない。誤字は数えません。
A は 12 分で出てきた
出力は、記事 1 本(6,698 字)・図 3 枚(matplotlib)・図の生成スクリプト 2 本・自前の公開前セルフチェック 1 枚。セルフチェックの中では、記事内の再現コードを実際に実行して出力と突き合わせ、引用コードが材料と全文一致することを機械で確認していました。生成の途中で自分の記述の誤りを 1 件見つけて書き直した、とも報告に残しています(当方が実行して、書き直し後が正しいことを確認)。
題材の絞り方も自分で決めていました。ネタ出しメモには 5 項目が並んでいましたが、材料に実物と実数があるのは 4 つ。残り 1 つ(冪等)は材料自身が「実走ログは無い」と書いているので、本文では「扱わなかったこと」として設計だけ書き、数字を出さないという判断をしています。
検証工程を通した結果
主評価: 事前固定の 6 型
| 型 | A で検出 | B で残存 |
|---|---|---|
| ①数値・固有事実 | 1 | 0 |
| ②出典 | 2 | 0 |
| ③再現 | 0 | 0 |
| ④内部矛盾 | 2 | 0 |
| ⑤実測を超えた一般化 | 3 | 0 |
| ⑥仕様・観測・推測の混同 | 3 | 0 |
| 合計 | 11 | 0 |
(B の再点検で新たに検出: 1 件=④。下記)
B に同じ検査をもう 1 巡したところ、修正が入れた欠陥が 1 件出ました(④内部矛盾)。追記した節で「3 つ目を足した」と書いたのに、末尾のチェックリストと表は「まだ塞げていない」のままだった——節を移動したときに末尾 2 か所を直し忘れた、当方の編集ミスです。直して閉じました。
🔴 この表が言っているのは「検出した 11 件は残っていない」までです。B の欠陥総数が 0 だという意味ではありません。同じ原稿にレビューを 3 回かけて新規が 3/4/4 と出続けた以上、**未発見の分は「不明」**と書くのが正確です。
質の傾向: 「数字が違う」は 1 件だけで、それも内訳の合計が母数と 2 件合わないという型でした(材料の計測ログが上位 4 形式までしか出しておらず、それを全体として書いた)。残り 10 件は足りない側です——出典が無い、条件が抜けている(正規表現の話なのに既定の Unicode パターンでの話だと書いていない)、観測から原因を断定している、確認した範囲より広く書いている。
材料に書かれた数字は 16 種類ぜんぶ一致しました。再現コードは実行して出力(例外の位置まで)が一致し、引用コードは現物と 10 行中 10 行一致。渡した材料の中では正確で、材料の外側で広がる、というのがこの 1 本の傾向でした。
重大 1 件: 「塞いだつもり」
唯一の重大は、記事の主題そのものに関わるものでした。題材は「JSON の 1 行が、ある不可視文字のせいで読む側で 2 行に割れた」事故で、対処は書く側で 2 文字をエスケープする、というものです。
この 2 文字で塞げているか——誰も数えていませんでした。実測するとこうです。
| 文字 |
json.dumps(ensure_ascii=False) の出力に生で残るか |
str.splitlines() が割るか |
|---|---|---|
| U+2028 LINE SEPARATOR | 残る | 割る |
| U+2029 PARAGRAPH SEPARATOR | 残る | 割る |
| U+0085 NEXT LINE | 残る | 割る |
| U+000B・U+000C・U+001C〜U+001E | 残らない(エスケープされる) | 割る(ただし dumps がエスケープするので、出力には生で残らない) |
3 つのうち 2 つしか塞いでいませんでした。 記事は「行区切り文字 2 つを狙って置換しています」と書いており、それ自体は事実ですが、読み手は「これで塞がった」と受け取ります。実際の道具にも同じ穴が空いたままでした(わざと壊した入力を 1 本通すと splitlines() は 2 行を返す)。
ここは記事を直すだけでなく、道具にも 3 つ目を足して、わざと壊した入力 4 ケース(3 種+同時)で splitlines() が 1 行・値が一致することを確認してから閉じました。
副評価: 型外の運用ゲート
事前の検査表では拾えない 4 件です。6 型には編入しません(事前登録を後から動かさないため)。
| 内容 | 重大/軽微 |
|---|---|
published: true のまま=連携リポジトリの対象ブランチへ push すると公開される |
重大 |
| 秘密にすべき識別子が本文とコードのコメントに 2 か所 | 重大 |
| AI 利用の開示が無い | 軽微 |
| 自サイト(本家)への導線が無い | 軽微 |
重大 2 件はここに出ました。ただしこれを「AI が見落とした」と数えるのは間違いです。公開設定の運用も、伏せる情報の基準も、開示の書き方も、導線の規則も、制作した AI にもレビューした AI にも渡していません。検出に必要な情報を与えていないものを、能力不足として数えないことにしました。
外部 AI レビュー 3 回の内訳
A(凍結版)だけを 3 回かけました。毎回 新しいセッション・B も前の回の指摘も渡していません。⚠ 指示文は完全には同一ではありません——#1・#2 は人がその場で打った指示で、逐語は残っていません(当方の記憶では「精査して」に近い言い方)。#3 は 6 型を列挙した規定の文です。回ごとの数を比べるときはこの差を織り込んでください。
| #1 | #2 | #3 | |
|---|---|---|---|
| 真の欠陥(照合して真・新規) | 3 | 4 | 4 |
| 既出の再指摘(前の回で出た分) | — | 3 | 4 |
| 誤指摘(照合して偽) | 1 | 1 | 2 |
3 回で新規の真は 11 件。回を重ねても新規が出続けたので、3 回でも打ち止めにはなっていません(4 回目でまだ出る可能性があります)。実際、その後の公開前の精査(2026-09-17)でも B から 2 件(言い過ぎの一般化 1・内部のファイル名の残り 1=型外)が出ています。

誤指摘の中身がいちばん面白かった
#2 と #3 が、まったく同じ誤指摘を出しました。その後、A をもう 1 回見た回と、修正版(B)を見た回でも同じ指摘が出て、通算 4 回です。「このエスケープ処理はバックスラッシュ+生の不可視文字の 2 文字になるので直らない。json.loads も失敗する」という内容で、どの回も「明確に再現できる」「公開前に直すべき明確な技術誤り」といった強い言い方でした。
渡したファイルの該当行をバイト列のまま取り出して確かめました。
- バックスラッシュの数: 6 個(正しい形)
- 生の不可視文字: 0 個
- その式をそのまま評価 →
splitlines()は 1 行、json.loadsは元の値と一致
指摘された形なら確かに壊れます。ただし記事にその形は入っていません。おそらく Markdown を読む過程でエスケープが 1 段落ちて見えています。
ここから 1 つだけ持ち帰りました。別セッションで何回一致しても、正しさの根拠にはならない(この 1 箇所は 4 回一致しました)。セッションは分かれていても、同じモデルに同じプロンプトを与えている以上、統計的な意味で独立ではありません。誤りも共有します。強い言葉(「明確に再現できる」)も根拠になりません。確かめ方は 1 つで、現物のバイトを取り出して実行することでした。
人の側も見落としていた
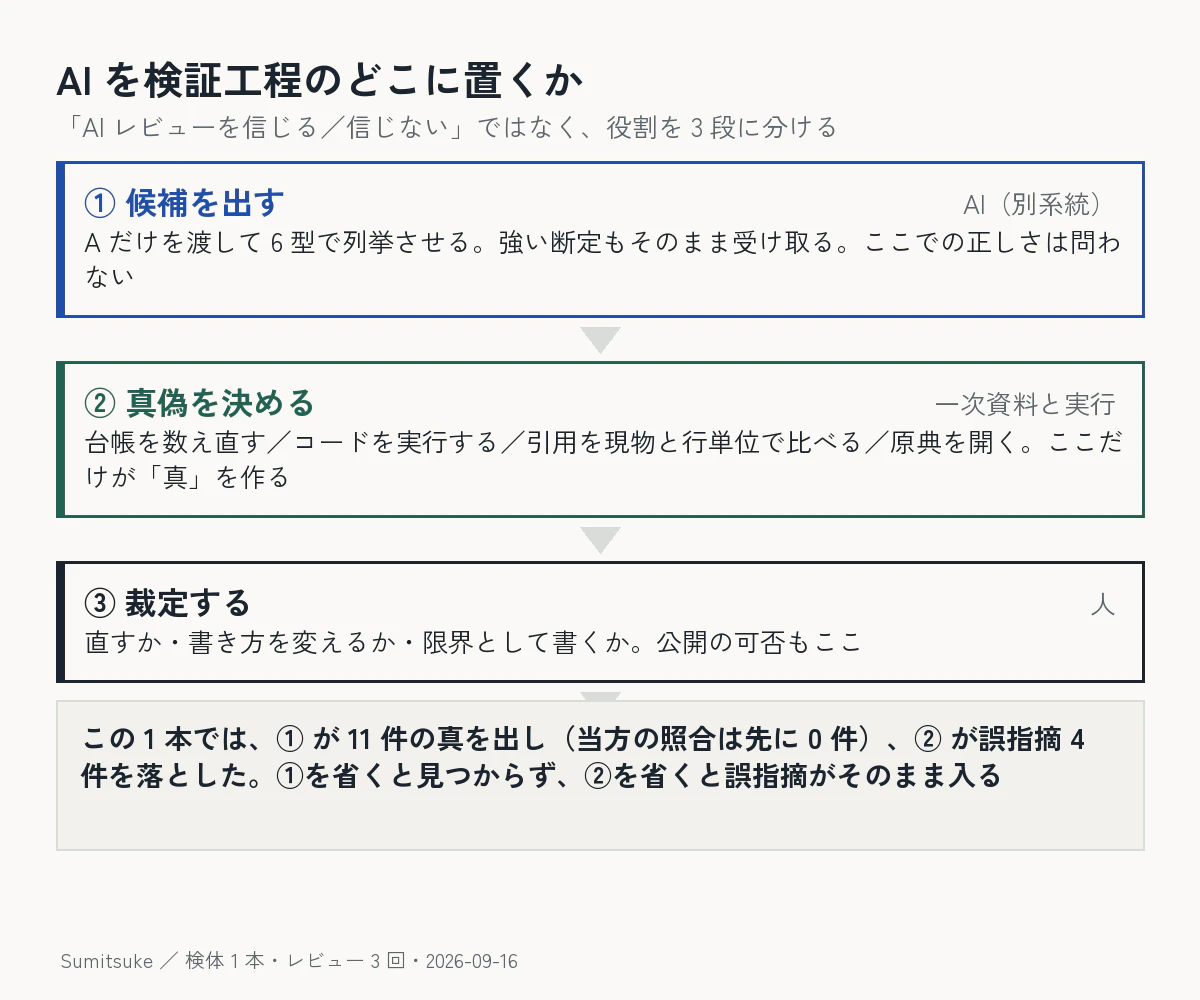
工程の順は「外部 AI レビュー → 当方が一次資料と実行で真偽を確定 → 人が裁定」です。当方の照合は主評価を 1 件も見つけられませんでした(11 件はすべて外部レビューが先に出した)。工程別に書くとこうです。
- 初回の照合(20 分・レビューの前): 数字 16 種が材料と一致することは確かめた。しかし内訳の合計が母数と合うかを見ておらず、#1 が出した 3 件(合計の不一致・一般化 1 件・内部矛盾 1 件)を取り逃した。見つけたのは型外の 4 件(公開設定・伏せる情報・開示・導線)
- その後の照合: 重大だった U+0085 も、#2 に指摘されるまで当方は拾えなかった(「2 文字を塞いだ」と書いてあるのを読んで、塞ぐ対象が何個あるかを数えなかった)
理由ははっきりしていて、当方は「記事の主張が材料と一致するか」を見ており、「材料の外に同じ型の穴がないか」を探していなかったからです。照合と探索は別の作業でした。
時間
| 段 | 分 |
|---|---|
| A の生成(実時間) | 12 |
| 当方の照合 1 回目 | 20 |
| B の作成(副評価 4 件) | 5 |
| レビュー #1 の照合と反映 | 25 |
| レビュー #2 の照合と反映 | 20 |
| 道具の穴を塞ぐ(わざと壊した入力 4 ケース) | 15 |
| レビュー #3 の照合と反映 | 20 |
| 合計 | 約 117(うち制作 12・検証 約 105) |
制作 12 分に対して、検証は約 105 分でした(レビューの文面を人が貼って戻した分、3 回合計で約 15 分は、この表に含みません)。比にすると 約 1:8.8 ですが、この比を一般化しないでください(n=1・題材は自分の道具・レビュー 3 回を別々に回した分を含みます。各工程の分は 5 分単位の概算です)。
この 1 本から言えること/言えないこと
言えること
- この 1 本では、AI 単独の原稿は材料の中では正確で、材料の外側で広がった(一般化・断定・条件の欠落が 10/11)
- 検証工程 1 回で、事前固定の 6 型は検出 11 → 残存 0。ただし修正そのものが 1 件入れた(節の移動で末尾の直し忘れ)。修正は無料ではない
- 重大は「間違い」ではなく「塞いだつもり」の形で出た。数えれば見つかる型だった
- 外部 AI レビューは候補を出す役としては機能したが、3 回で 4 件の誤指摘があり、うち 2 件は同じ誤読の重複
言えないこと
- 「AI 記事はこの程度」——n=1、題材は自分の道具、モデルも日付も 1 つです
- 「検証 1 回で 11 件消える」——記事の型と材料に依存します
- 「3 回のレビューで十分」——3 回目でも新規が 4 件出ています
- 「11 件」という数の粒度——件数は台帳の 1 行を 1 件として数えました。型は事前に固定しましたが、近接する複数の指摘を何件に束ねるかまでは事前に決めていません(例: 出典の欠落 2 か所を 1 行にまとめた箇所があります)
- 判定したのは当方(検証を売っている側)で、盲検にはできていません。緩和として、15 件すべてに真偽の根拠(どのコマンド・どの一次資料で確かめたか)を台帳に残しています
再現したい人へ
- 材料を凍結する(ハッシュを取る)。制作 AI に渡すのは材料と開始 1 文だけ
- 検査表を生成前に固定する。型と重大/軽微の定義まで
- 出力をそのまま凍結する(A)。以後 1 文字も触らない
- AI レビューは候補を出す役として使い、真偽は一次資料と実行で確定する
- 内部の運用規則(公開設定・伏せる情報・開示・導線)は副評価に分ける。渡していない規則の違反を能力不足として数えない
- 数える指標は 3 つ——A の件数、B の件数、修正で新たに入った件数(今回は 1 件出た。ここを数えないと「直した」が水増しになる)
AI の利用について
検体の記事は AI(Claude Opus)が素の環境で制作し、人は材料の用意と開始指示 1 文だけを行いました。検証工程(一次資料との突き合わせ・コードの実行・道具の修正)も AI(Claude Code)が実行し、裁定と公開の判断は人が行っています。外部レビューは別系統の AI(GPT)を 3 回。件数はすべて欠陥台帳の実測で、台帳には 15 件を 1 件ずつ「指摘・真偽の根拠・重大/軽微・発見元・B で消えたか」の形で記録しています(台帳そのものは内部資料で、本文には要約だけを載せています)。題材は自社の道具で、顧客に関わる情報は含みません。
関連
- 検体になった記事そのもの:
splitlines()が JSONL の 1 行を割る不可視文字は 2 つではなく 3 つだった——読む側の境界の取り違えと、書く側で選んだ互換策 - 検査を信じる前に、わざと壊した入力を 1 本入れる話: 緑を信じない——捕まえた 5 件・直した 22 件
- AI レビューの指摘を現物で照合した回: AI レビューを現物で照合する運用——3 回・17 件が全部正しくても、指摘されなかった穴が 2 件あった
次に読む: 検証工程の値段——人の編集を 0 にした原稿に、工程 1 回で消えた欠陥と、消えなかったもの
この記事は Zenn にも同じ内容を掲載しています。