
本記事の執筆には Anthropic の Claude Fable 5 とそのリサーチ機能を使用しています。会話で組み立てた論旨に対して、リサーチ機能で一次情報(arXiv論文・公式ブログ・特許・技術報道)の収集と全数値のファクトチェックを行い、判明した誤りを訂正しています。
はじめに
前二編は、それぞれこう締めていました。
前編:「次にシリコンに焼かれるのは、おそらく予測器です」
続編:「次に引っ越すのは重みです。行き先はインターポーザの上、隣にはKVキャッシュを抱えたHBMが座っています」
そして続編7章では、コンシューマ機への降下について具体的な観察ポイントを一つ置きました。
この種の階層をコンシューマ機へ最初に持ち込むのはAppleではないか、というのが筆者の観測です。観察ポイントは、M5 Maxの次の次あたりの世代でメモリ構成に手が入るかどうかです。
「M5 Max の次の次」は、素直に数えれば M7 Max です。そしてその M7 世代については、すでに無視できない報道が出ています。アップルが M6 Pro / M6 Max / M6 Ultra をキャンセルし、M7 世代へ直行するというものです。Apple Silicon 史上初めて Pro と Max を欠く世代が生まれることになります(Ultra は M4 世代でも欠番でしたが、Pro と Max まで欠くのは初です)。
理由として報じられたのは、AI でした。M7 世代向けに計画していたニューラルエンジンの大幅強化を、M6 のラインナップを完成させるより優先した、という説明です。世代を一つ飛ばすほどの何かが M7 に入る、と読める話です。
本編の問いは単純です。それは何か。前二編の枠組みで言えば、答えの候補は二つあります。重みがフラッシュから供給されるようになるのか(続編の予告)、予測器がシリコンに焼かれるのか(前編の予告)。結論を先に言えば、前者を分解していくと後者に行き着きます。ただし前二編よりも条件付きの結論になります。仮説を立てるだけでなく、その仮説が成立するための条件がどれだけ厳しいかも、公開データで数えられる範囲で数えます。
本記事は 2026 年 7 月 25 日時点の一次情報に基づきます。最初にはっきりさせておくと、M7 の内部構造について確定した情報は存在しません。以下で扱う M7 関連の数値と計画はすべて Bloomberg の Mark Gurman による報道であり、アップルの公式発表ではありません。断定・報道・筆者推定は本文中で区別します。
1. まず確定度を切り分ける
この種の記事は、確定度の異なる情報を混ぜた瞬間に価値を失います。先に整理しておきます。
| 情報 | 確定度 | 出典 |
|---|---|---|
| M5 Max = 128GB / 614GB/s、SSD 最大14.5GB/s、40コアGPU(各コアに Neural Accelerator)、16コア Neural Engine | 公式 | Apple Newsroom(2026年3月3日) |
| M5 Pro/Max が TSMC SoIC-X の face-to-face ハイブリッドボンディング、シリコンインターポーザ上に CPU/GPU チップレット | 第三者による物理解析 | TechInsights(M5 Pro APL1X15 パッケージ解析) |
| アップルの SSD コントローラが SoC 内蔵の ARM64 コプロセッサ(ANS2)で、標準の PCIe/NVMe デバイスとしては振る舞わない | リバースエンジニアリング | Asahi Linux 由来の解析 |
| WWDC 2026:オンデバイスは AFM 3 Core(3B 密)と AFM 3 Core Advanced(20B 疎、Instruction-Following Pruning で1〜4Bを活性化)の二層、クラウドは AFM 3 Cloud / AFM 3 Cloud Pro | 公式(発表)+報道。完全な技術報告は2026年後半公開見込み | Apple ML Research ブログ、CNBC ほか(2026年6月8日) |
| M6 Pro/Max/Ultra キャンセル、M7 前倒し、理由は Neural Engine 強化 | 報道 | Bloomberg / Gurman(2026年6月25日、7月12日) |
| M7 base = 240GB/s、2027年前半。M7 Pro/Max = 2027年後半。M7 Ultra = 2028年、最大1.5TB | 報道 | 同上 |
| M7 Ultra の AI 性能が NVIDIA Blackwell 級に近づく | 報道(社内表現の伝聞、ベンチマーク値なし) | 同上 |
| M7 base のプロセスノード | 報道が食い違い、未確定 | Intel 18A-P 説と TSMC 2nm 説が併存(8章) |
| オンパッケージフラッシュの帯域・エネルギー、M7 Max の帯域 | 筆者推定 | 本記事の外挿 |
Gurman の説明部分は逐語で引用しておきます。「Apple had been planning major neural-processing upgrades for the M7 family and ultimately decided those improvements were important enough to justify accelerating the next generation rather than completing the M6 lineup」。M7 Ultra については「I'm told the processor dramatically upgrades AI performance, bringing it closer to the class of dedicated AI accelerators such as Nvidia Corp.'s Blackwell」とあり、技術仕様やベンチマーク目標は示されていないと明記されています。
なお「Blackwell 級」という表現は相対的なもので、額面どおりには受け取れません。NVIDIA の B200 は公式データシートで 180GB HBM3e / 7.7TB/s です(帯域は集計値。TDP は 1GPU あたり最大1000W)。M7 Ultra が 1.5TB を積んだとしても、容量で 8 倍勝ち、帯域で数倍負ける構図になります。アップルの土俵は容量であって帯域ではない、という非対称は最初に押さえておくべきです(5章の図11で可視化します)。
2. M7 世代のロードマップ(報道ベース)
| 世代 | 時期 | 帯域 | 備考 |
|---|---|---|---|
| M5(現行) | 2025年10月 | 153GB/s(注) | 32GB |
| M5 Pro / M5 Max | 2026年3月 | 307 / 614GB/s | 64 / 128GB、Fusion Architecture |
| M5 Ultra(J246) | 2026年内 | 非公表 | 約36CPU / 80GPU コア、最大768GB |
| M6(Komodo) | 2026年後半 | 約200GB/s | 12コアGPU、Neural Engine 更新。Pro/Max/Ultra なし |
| M7 | 2027年前半 | 約240GB/s | Neural Engine 大幅強化 |
| M7 Pro / M7 Max | 2027年後半 | 非公表 | |
| M7 Ultra | 2028年 | 非公表 | 最大1.5TB |
| M8(Soko) / Cardinal | 2028年 | 非公表 | TSMC A14(1.4nm)報道 |
注:base M5 の帯域は二次媒体間で記載が割れており、153GB/s とするもの(Macworld、AppleInsider)と 123GB/s とするもの(KitGuru、TechPowerUp、9to5Mac)があります。本記事は M6 の 200GB/s と比較している報道に合わせて 153GB/s を採ります。
図にすると、M6 世代にぽっかり空いた穴が見えます。

図1. Apple Silicon の帯域ロードマップ。base SoC は 153 → 200 → 240GB/s と刻む一方、Max 系は M5 Max(614GB/s)から M7 Max まで一世代分の空白が生じます。M7 Max の値は本記事の外挿による筆者推定です。
注目すべきは、M7 のテープアウトが M6 の約6ヶ月後だったと報じられている点です。Gurman は原文でこの語を「チップの設計を確定させる段階」と注釈しており、設計データをファウンドリへ渡す時点を指しています。
ここは誤読しやすいので補足します。「6ヶ月」は一つのチップの開発期間が6ヶ月に縮んだという意味ではありません。M6 と M7 という二つのプロジェクトのテープアウト時期の間隔が、通常の約1年から6ヶ月に詰まった、という話です。アップルは複数の設計チームを並行で走らせているので、M7 が6ヶ月で設計されたわけではない。したがって M7 は「M6 の直後に始めた新規設計」ではなく「もともと別系統で走っていた設計を前に引っ張った」と読むのが自然です。
なお Gurman の表現には「started taping out(テープアウトを開始した)」というゆるさがあります。厳密にはテープアウトは点のイベントですが、大規模 SoC ではベース層と配線層で時期がずれ、A0 ステッピング後のリスピンも入るため、期間として語られること自体は実務感覚に反しません。ただし最終 GDSII の話なのか最初のマスクセット発注の話なのかは、原文からは判別できません。
ここから先が本題です。
3. 仮説A ― 重みはフラッシュから供給されるか
続編で予告した「重みの引っ越し」が M7 で起きるか、という問いです。HBF は高価なので、アップルは独自方式で同等のことをやるのではないか、という読みでした。
ただ「重みをフラッシュから供給する」と一口に言っても、その中身には強度のまったく違う水準が含まれています。一緒くたに検証すると、最も強い主張が崩れたときに、穏当な主張まで巻き添えで否定されてしまう。以下では三段に分けて扱います。
| 段 | 主張 | 成立すると何が変わるか |
|---|---|---|
| A1 | フラッシュがオンパッケージへ移る | PCIe というリンクの制約と、DRAM を経由する中間コピーが消える |
| A2 | SSD コントローラが重みプリフェッチエンジンへ役割を拡張する | 重みの供給がストレージ I/O ではなく、メモリ階層の仕事になる |
| A3 | NAND が単一コヒーレントアドレス空間に入る | フラッシュが LPDDR と同格のメモリになる。最も強い主張 |
A1 から A3 へ進むほど主張は強くなり、実現の難度も上がります。
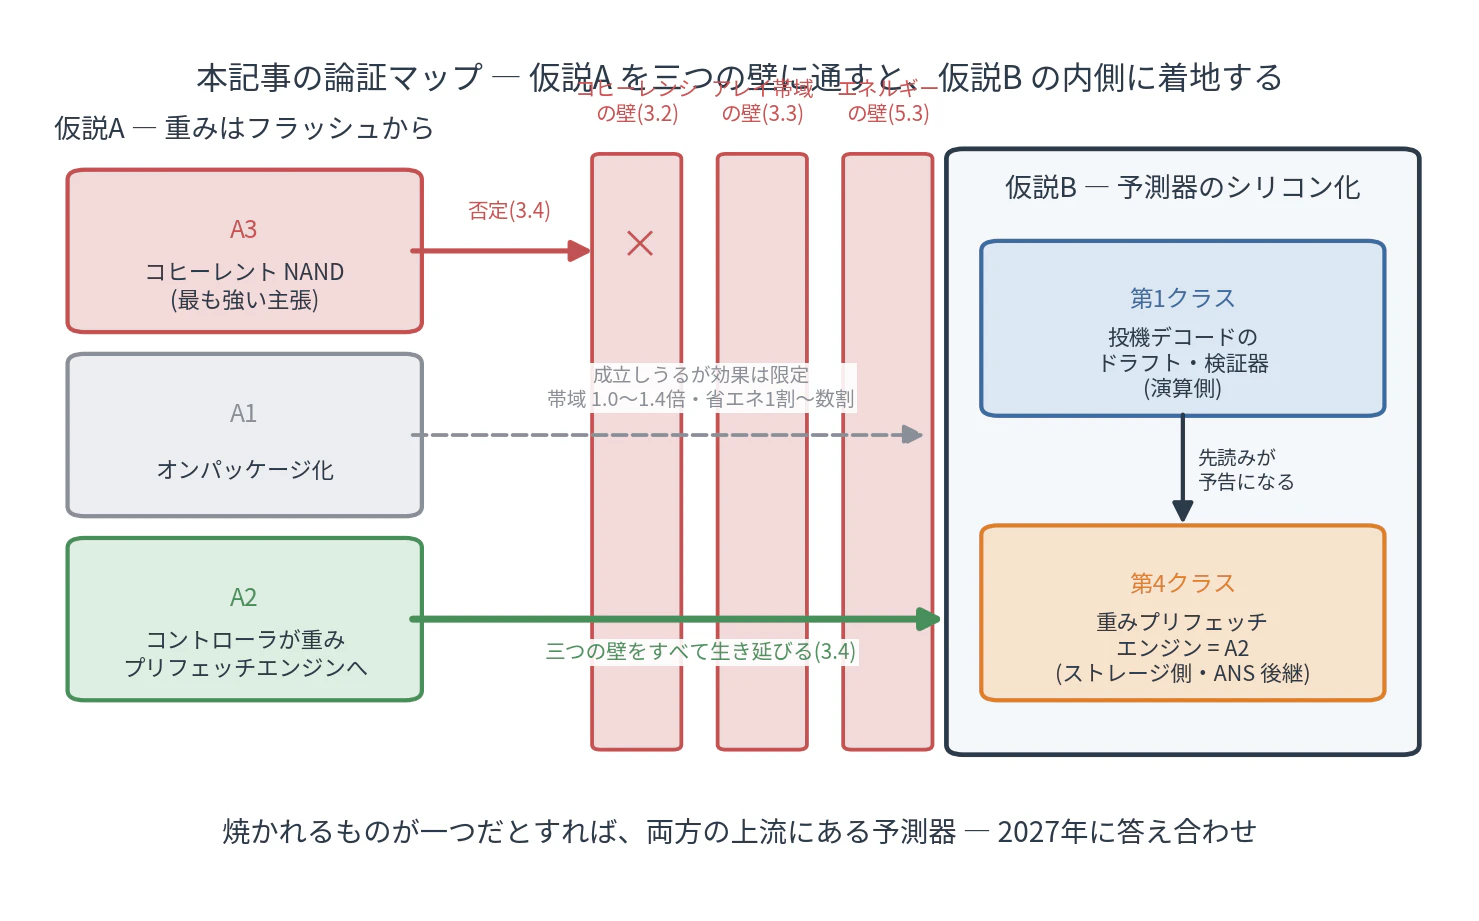
結論を先に置きます。本命は A2 です。A3 は否定され、A1 は成立しても効果が限定的で、残るのが A2 だけだからです。しかも A2 は、4章で扱う仮説B の一部でもあります。
二つ先回りしておきます。第一に、この三段はいずれも「フラッシュを賢く読む」方向の切り分けであり、これで選択肢が尽きるわけではありません。読まずに済ませる経路が別にあり、3.5 で扱います。第二に、本記事で A2 と呼ぶものの中身には弱い水準と強い水準があり、7章で二段に分けます。最有力と言うときは強いほうを指します。
以下は、まず A2 を推す理由を述べ(3.1)、次により素直に見える A3 と A1 がなぜ本命になれないかを見て(3.2、3.3)、三段の判定(3.4)と三段の外側(3.5)へ進みます。
3.1 なぜ A2 なのか ― アップルだけが持っている層
A2 を本命と見る根拠はここにあります。アップルが「独自方式でやる」ことを可能にしている構造は何か。
Asahi Linux によるリバースエンジニアリングで明らかになっている構造を、一般的な PC と並べて整理します。
| 層 | 一般的な PC | Apple Silicon |
|---|---|---|
| プロトコル | 標準 PCIe / NVMe | PCIe 電気層 + アップル独自実装(標準 NVMe デバイスではない) |
| SSD コントローラ | サードパーティ(Phison / SMI 等)の外付け IC | SoC 内蔵。M1 系では ANS2、RTKit 上で動く ARM64 コプロセッサ |
| コントローラ FW | 他社 | AppleStorageFirmware(自社) |
| 信号処理・ECC | 他社コントローラ内 | MSP(Memory Signal Processing)チップ。2011年の Anobit 買収由来 |
| NAND | 他社モジュール | 生 NAND ダイ。パッケージ設計は自社 |
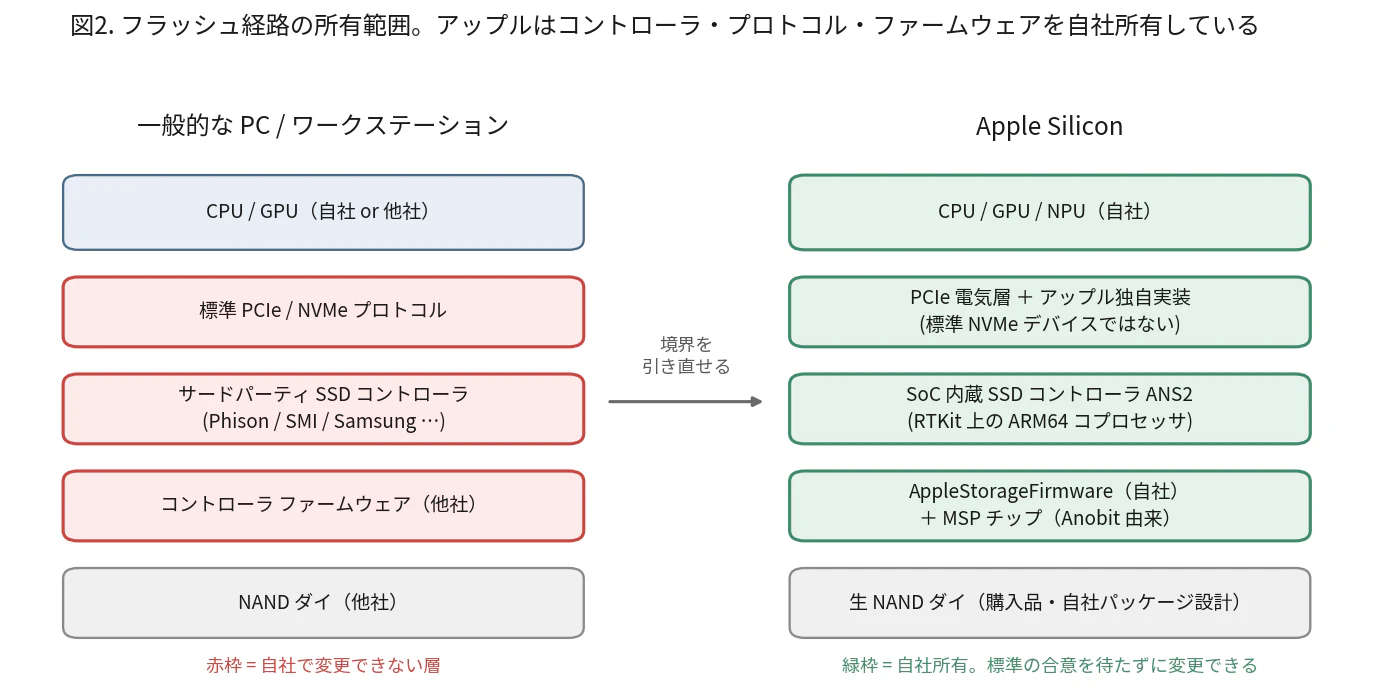
図2. 一般的な PC では赤枠の三層が他社の資産であり、勝手に変更できません。アップルは同じ三層をすべて自社所有しています。
一点だけ精密に言っておくと、「標準 NVMe デバイスではない」の意味は、SoC 内蔵の ANS2 が NVMe 風の MMIO インターフェースを OS に提供しつつ、標準の PCIe/NVMe デバイスとしては振る舞わない、というものです。Linux 側では専用ドライバ nvme-apple が書かれています。
MSP の系譜は 2011 年の Anobit 買収に遡ります。取得額は Bloomberg 報道で約 3.9 億ドル(当初 Calcalist は最大 5 億ドルと報じましたが、成立額はこちら)。NAND の信号処理と誤り訂正を自社で持つために買った会社です。
つまりアップルは、コントローラ IP、プロトコル、ファームウェア、NAND パッケージ設計のすべてを自社所有しています。これが何を意味するかというと、業界標準の合意を待たずにストレージとメモリの境界を引き直せる唯一の量産プレイヤーだ、ということです。
HBF は SanDisk と SK hynix が OCP 傘下で標準化を進めており、続編執筆時点で標準の公開時期すら決まっていません。規格の合意を待つプレイヤーと、待たなくてよいプレイヤーの間には、時間軸で数年の差が生まれます。続編で「コンシューマ機へ最初に持ち込むのはアップルではないか」と書いた直感は、この構造から裏づけられます。
ここで効いてくるのが、三段のうちどれにこの優位が直接効くか、という点です。インターポーザは TSMC の技術であり、アップル固有ではありません。NAND ダイも購入品です。アップルにしかないのは ANS2 というコントローラと AppleStorageFirmware、つまりフラッシュの読み出しを「いつ、何を、どの順で」決めている層そのものです。ここに予測を組み込めるのは、この階層を自社所有しているプレイヤーだけです。
他社の動きも同じ方向を指しています。キオクシアは2025年8月20日、5TB・64GB/s の高帯域フラッシュモジュールの試作を発表しました(NEDO の Post-5G 事業)。公式リリースによれば、シーケンシャルアクセス中にデータを先読みしてレイテンシを縮めるフラッシュプリフェッチ技術をコントローラに実装しています。まさに「コントローラ側が先読みする」方向です。ただし注意深く読むと、これは汎用のシーケンシャル先読みであって、テンソルや expert という単位を知っているわけではありません。
ここで用語を正確にしておきます。「プリフェッチ」そのものは、現行の Mac にもすでに層をまたいで存在します。NAND ダイには cache read(tR とデータ転送をパイプライン化する ONFI / Toggle 標準のコマンド)があり、macOS には UBC のクラスタリードによる自動先読みがあります。無いのはプリフェッチではなく、意味論です。どの層も「次に必要なのはどのテンソルか、どの expert か」を知らない。ブロック番号の世界で先読みしているだけです。
ただし急いで付け加えると、この意味論の不在は、現在のところ実害を生んでいません。現行の SSD 帯域では1層ぶんの重みを読むのに約12ms かかる一方、NAND の読み出しレイテンシは約75μs で、桁が二つ違うからです(数字の導出は 6.1 で行います)。いまは純粋に帯域律速であり、読むべき場所さえ分かっているなら、上位層が LBA の列を渡せば足ります。意味論が界面に要求されるのは、このレジームが切り替わってからです。その境目がどこにあり、そこへ届くのかは、6章で数えます。
そのうえで、意味論を持った読み出しがどれほど効くかを実証しているのが、当のアップルの研究です。LLM in a flash の実装は、mmap と OS の先読みに任せる作りになっていません。フラッシュの特性に合わせた独自のリーダーを書き、windowing と row-column bundling で読み方そのものを設計し直しています。読む量を選別する世界では、汎用の先読みでは足りなかった、ということです。OPT 6.7B / M1 Max の実測では、素朴なロードで1トークンあたり約2.2秒かかっていた I/O が、この設計で約87ミリ秒まで下がりました。約25分の1です(段階分解の集計は二次解説によります)。なおこの倍率には条件が付きます。同論文の評価対象は素の ReLU モデルである OPT-6.7B と、活性化関数を ReLU に置換してファインチューンした Falcon-7B であり、SwiGLU のままの近年のモデルではありません。この条件が後で効いてきます(6.4)。

図3. 先読みの実行手段は下の三層にあり、テンソルや expert という意味論は最上層にしかありません。ただし現在は帯域律速であり、この非対称は実害を生んでいません。1層の予算約12ms に対して tR は約75μs だからです。A2 が必要になるのは、選択的読み出しが成功して読み量が一桁以上減り、レイテンシとテールが律速に変わった後です(6章)。そのとき下層が要求するのは expert という名前ではなく、束・締切・投機性・誤り耐性という属性のほうです(7.2)。
したがって A2 の正確な言い方は、プリフェッチの新設ではなく、プリフェッチの意味論の引き上げです。ブロック番号の世界から、テンソル / expert 単位の世界へ。SK hynix の H³ が LHB でやろうとしているのも同じことで、同社のシミュレーションでは性能/電力で最大2.69倍、1000万トークンの長コンテキストで TPS 最大6.14倍と見積もられています(実測ではなくシミュレーション値です)。
以下 3.2 と 3.3 では、より素直に見える A3 と A1 がなぜ本命になれないのかを見ていきます。
3.2 A3 が落ちる理由 ― コヒーレンシの壁と、特許が示す方向
ここから A3 の検証です。NAND をメモリコントローラ経由でパッケージ内の単一アドレス空間に置き、ハードウェアコヒーレントに扱う。文章にすると一行ですが、要求としては相当にきつい。
| 要求 | NAND の現実 |
|---|---|
| ns 級レイテンシ | 読み出しレイテンシは数十μs級(HBF Gen1 でも約10μs、DRAM は 10〜100ns) |
| キャッシュライン粒度(64B) | ページ粒度(4KB〜数十KB) |
| 任意アドレス書き換え | ブロック単位消去、in-place 書き換え不可 |
| コヒーレンシプロトコル参加 | 無効化・スヌープにμs で応答できない |
| 無制限の書き換え | 数千〜10万回の摩耗上限 |
| 読み出しの非破壊性 | リードディスターブがあり、リフレッシュが要る |
参考になるのは、続編4章で扱った SK hynix の H³ です。HBM と HBF を同一インターポーザに混載して統一アドレス空間から見せる設計ですが、その中身は「真にコヒーレントな NAND」ではありません。HBM ベースダイ内のアドレスデコーダとルータで経路を分け、読み出し専用データ(重み、事前計算済み共有 KV)を HBF へ、動的に更新されるデータ(生成中の KV)を HBM へ振り分けます。そして NAND のμsレイテンシは、ベースダイ内のレイテンシ隠蔽バッファ(LHB)によるプリフェッチで隠します。LHB の規模は、H³ を評価した TileLens(arXiv:2607.04031)では 40MB の SRAM と記述されています。
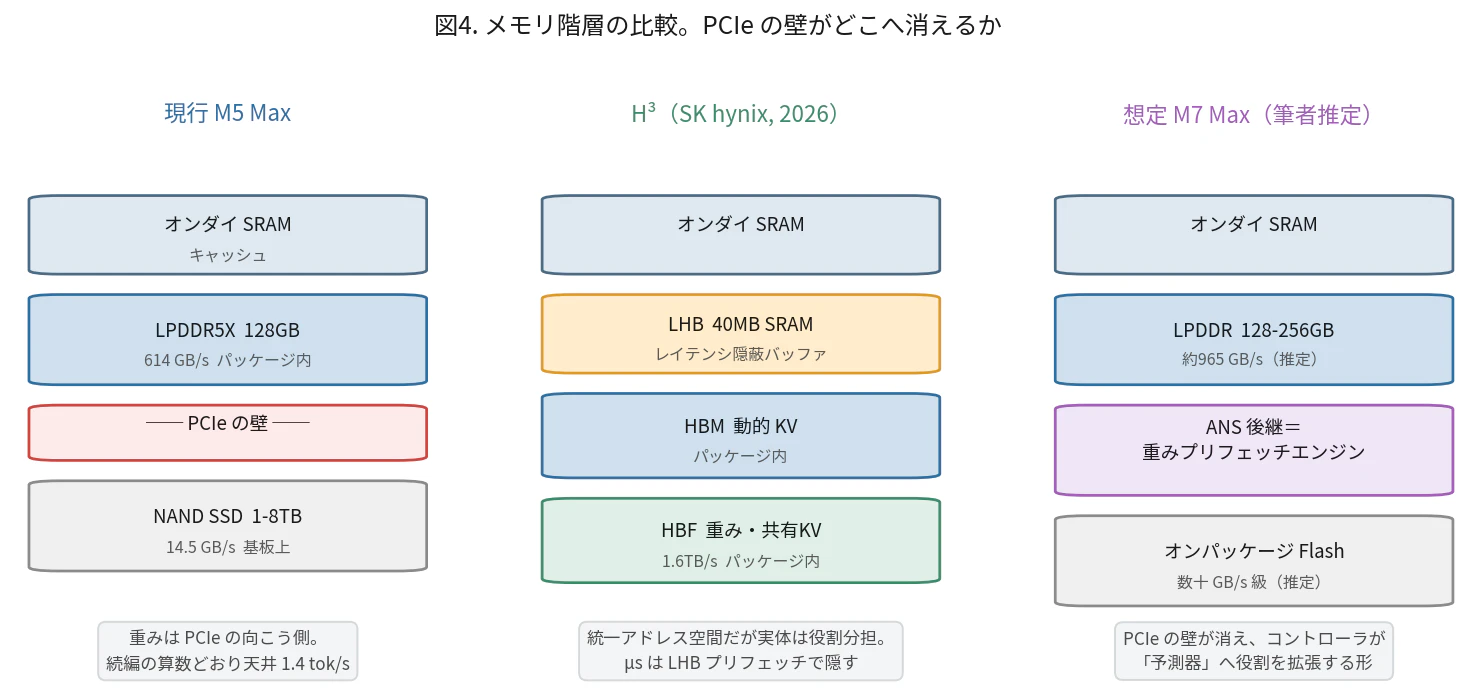
図4. 現行 M5 Max、H³、そして想定 M7 Max のメモリ階層。左では PCIe の壁が重みを隔てています。中央の H³ は統一アドレス空間を謳いますが、実体は役割分担と 40MB の SRAM バッファによる予測プリフェッチです。右の想定構成(A1 + A2)では、PCIe の壁が消える代わりに、SSD コントローラ(ANS の後継)が重みプリフェッチエンジンへ役割を拡張します。
つまり業界の現時点の最良解でも、「統一アドレス空間に見せる」のは表層です。「HW コヒーレント」という一言の裏には、40MB 級の SRAM バッファと予測器が要る。A3 はこの時点でほぼ落ちます。
同時に注目すべきは、H³ が妥協した先が予測プリフェッチだったことです。コヒーレンシを諦めた業界が着地したのは A2 の位置でした。
アップルがこの方向をどこまで仕込んでいるかを、特許で確かめようとしました。結果は次のとおりです。
見つかったもの:「Memory System Having Combined High Density, Low Bandwidth and Low Density, High Bandwidth Memories」(Apple Inc.、発明者 Sukalpa Biswas / Farid Nemati、優先日 2016年6月27日)。
| 特許番号 | 成立年 |
|---|---|
| US 10,573,368 B2(中核) | 2020年 |
| US 10,916,290 | 2021年 |
| US 11,468,935 | 2022年 |
| US 11,830,534 | 2023年 |
| US 12,243,575 | 2025年 |
高帯域・低容量のメモリと低帯域・高容量のメモリを組み合わせ、前者を後者のキャッシュとして使うという内容です。「二層の異種メモリを組み合わせ、片方をキャッシュとして運用する」というアーキテクチャを、アップルは10年近く継続的に出願し続けている。ただし対象は DRAM 二層(一部 TSV 積層を含む)であって、NAND ではありません。むしろ、10年にわたり一貫して DRAM を対象にしてきたこの事実そのものが、3.3 の判定を裏づける一次証拠になっています。アップルが公的記録に残している階層設計の志向は DRAM 二層であって、NAND をコヒーレント空間に入れる方向ではない、ということです。
見つからなかったもの:アップル帰属で「フラッシュから重みをストリーミングする」ことを直接クレームする成立特許(2026年7月時点。公開特許の網羅検索には限界があるため、不在の断定ではなく「見当たらない」にとどめます)。NN の重みを不揮発メモリに格納する特許自体は存在しますが(US 11,972,795 は SST/Microchip、US 11,397,886 は SanDisk/WD 帰属)、アップルのものではありません。
この分野におけるアップルの公開 IP は、現時点では特許ではなく論文です。すなわち LLM in a flash(arXiv:2312.11514)。windowing と row-column bundling によって、利用可能な DRAM の最大2倍のサイズのモデルを動かし、素朴なロードに対して CPU で4〜5倍、GPU で20〜25倍の高速化を主張した、あの論文です。その後の系譜として ActiveFlow(arXiv:2504.08378、active weight の DRAM・フラッシュ間スワッピング)などが続いていますが、いずれもソフトウェア技術です。
3.3 A1 が決定打にならない理由 ― インターポーザはあるが、アレイが縛る
まず前提条件から。M5 Pro / M5 Max の Fusion Architecture は、アップル初のチップレット構成です。TechInsights が M5 Pro(APL1X15)のパッケージを物理解析した結果、TSMC の SoIC-X による face-to-face(F2F)ハイブリッドボンディングで、CPU チップレットと GPU チップレットをモノリシックなシリコンインターポーザ上に載せていることが確認されました。コンシューマ製品での SoIC-X F2F の確認例としては初となります。
ここで効くのは、ハンダのマイクロバンプではなくバンプレスのハイブリッドボンディングだという点です。ダイ間の接続密度が桁で上がり、チップレット化に伴う寄生損失が減ります。続編で「HBF は重みを PCIe の向こう側からインターポーザのこちら側へ引っ越しさせる階層の再設計だ」と書きましたが、そのインターポーザは、すでにアップルのノート PC の中に入っているわけです。
なお報道段階では SoIC-mH とされていましたが、物理解析は SoIC-X F2F を示しています。本記事は物理解析を優先します。
補足として、ダイの機能分担については、第1ダイ(Pro/Max 共通)が 18コア CPU・16コア Neural Engine・SSD コントローラ・Thunderbolt、第2ダイが GPU コア・Media Engine・メモリコントローラという解析があります。ただしこれはジャーナリスティックな分析であり、アップルが公式に明示したものではありません。この分担が正しいとすると、SSD コントローラは CPU ダイ側にあることになります。フラッシュを GPU ダイに直結する構成は、コントローラとフラッシュがダイをまたぐことになり、A1 を考えるうえで地味に面倒な条件です。
では帯域はどこまで伸びるのか。ここは NAND の物理が効いてきます。結論だけ先に書くと、伸びません。
NAND の読み出し帯域は、Micron Technology の特許(US 12,455,704 B2、発明者 Wenjun Wu、日本出願 2022-202322(2022年12月19日)を優先権として2023年9月6日出願、2025年10月28日登録)の明細書が置いている式で決まります。読み出し帯域 = (1/tR) × ページサイズ × ダイ総数 × プレーン数。この式は明細書の詳細説明中の記述であり、請求項ではありません。明細書の例示はページ 16KiB、2 または 4 プレーン、8チャネル × 4ダイ × 4バンクの最大32ダイで、tR の具体値と結果としての GB/s は書かれていません。以下の数値は、この式に筆者が代入したものです。
tR はページ読み出し時間で、3D TLC では約75μs(Flash Memory Summit 2019 のコンポーネント評価による実測ベースの代表値)、楽観的に見ても 50μs 程度です。ページ 16KB・4プレーンで計算すると、1ダイあたり 0.87〜1.31GB/s にしかなりません。外部インターフェース(BiCS8 で約3.2GB/s)より先にアレイが詰まるので、リンクを太くしても1ダイの上限は上がらない。帯域はダイを並べて買うしかなく、ダイ枚数はそのまま容量になります。
この式を M5 Max に当てると、居心地の悪い符合が出ます。tR=75μs で 2TB 構成(16ダイ)は 14.0GB/s。公称値 14.5GB/s とほぼ一致します。なおこの16ダイは公称値に合うように筆者が置いた仮定であって、特許例示の32ダイとは別です。つまり現行の SSD はすでにアレイ側の限界で頭打ちの可能性が高く、その場合オンパッケージ化で帯域は1ミリも伸びません。tR=50μs なら16ダイで 21GB/s なので、そのときは 1.4 倍ほど伸びる。同じ 14.5GB/s という数字が、tR ひとつで「まだ余裕がある」とも「もう限界」とも読めるわけです。
必要量の目安も出しておきます。64GB/s には 6〜9TB 分、256GB/s には 25〜37TB 分の NAND が要ります。後者はノート PC には載りません。この試算の詳細、Mac の低容量 SSD が遅い理由、HBF のスタックが 512GB である理由については、別稿「NAND の帯域はどこで決まるのか」にまとめました。
ここで、この式が前提とする並列度がどこから来るのかを、読み出しの粒度と絡めて確かめておきます。フラッシュ階層の議論では「同時に読む複数の expert が同一ダイに載って直列化するのではないか」という心配が立ちますが、数字を入れると、この心配は粒度に強く依存します。
上の仮定(ページ16KB、4プレーン、16ダイ)では、1回の tR で全ダイが並列に読める量は約1MB です。この 1MB を 75μs で読むので 14.0GB/s、先ほどの符合と同じ計算です。特許例示どおり32ダイと置けば並列単位は 2MB、帯域は倍の 28GB/s になります。公称 14.5GB/s と合うのは16ダイのほうなので、以下は16ダイを主に使い、32ダイの場合を併記します。
一方、DeepSeek-V3 の公開 config から expert 1本のサイズを出すと、隠れ次元 7168、expert 中間次元 2048、gate / up / down の3行列で 44.04M パラメータ、Q4 で約22MB です。config の値(hidden_size 7168、moe_intermediate_size 2048、n_routed_experts 256、num_experts_per_tok 8、n_shared_experts 1、num_hidden_layers 61、first_k_dense_replace 3)は技術報告 arXiv:2412.19437 で確認しました。MoE 層は58層で、expert 総量は約656B、671B の97〜98%を占めます。
| 読み出し単位 | サイズの目安 | ダイ並列の充足(16ダイ / 32ダイ) | ページ単位のリード増幅 |
|---|---|---|---|
| expert 単位 | 約22MB | 自動的に満たされる(約20 / 約10ラウンド分) | ほぼ無し |
| 行列ブロック単位 | 数百KB | おおむね満たされる / やや不足 | 小さい |
| ニューロン行単位 | 約3.5KB | 単発では満たされない | 4倍以上 |
expert 1本だけで並列ラウンド20回分あり、それだけで全ダイを使い切ります。したがって expert 単位で読む限り、どの k 本を選んでも並列度は落ちません。256個から8個を選ぶ組み合わせは 10 の14乗のオーダーですから、特定の組を隣り合わせに置くという発想は成立しませんが、そもそもその必要がない、ということです。各 expert 自体を全ダイにストライプしておけば、任意の部分集合が均等に散るという性質は構造的に満たされます。しかも大きなファイルを逐次書けば FTL は通常チャネルとダイへ撒くので、特別なことをしなくてもおおむねそうなります。
ダイ並列が問題になるのは、読み出し単位が並列ラウンドを下回ったときです。そしてそれは、選択的読み出しを突き詰めるほど起きます。LLM in a flash(arXiv:2312.11514、ACL 2024)が「FFN の約2%しか読まない」と言うときの単位はニューロン行であり、DeepSeek-V3 級の隠れ次元 7168 なら Q4 で 3.5KB です。
ここで並列度と入れ替わりに出てくるのがリード増幅です。3.5KB を読むにもページ全体を読む必要があるため、ページ16KB なら約4.5倍の無駄が乗ります。30分の1に減らしたつもりが、アレイ側の仕事量では6分の1程度にしかならない。エネルギーは読み出したページ量で決まるので、5.3 の計算にそのまま効いてきます。
LLM in a flash の row-column bundling は、まさにこれへの対策でした。同じニューロンの上射影の列と下射影の行を連結して隣接配置し、1回のアクセスでまとめて読む手法です。論文の図7 に、OPT-6.7B ではこのバンドリングにより1回で2倍のチャンクを読むと明記されており、バンドル単位は 2d バイト(d は隠れ次元)になります。上の例では 7KB となり、ページに対する充填率が上がります。

図5. 横軸は1回の読み出し要求のサイズで対数です。右側では並列度が自動的に満たされ増幅も生じませんが、左側ではページ単位の無駄が効いてきます。並列度の曲線は16ダイ(実線)と32ダイ(破線)の二本です。expert 単位で読む限り右側にいるため直列化の心配は起きず、選択的読み出しを突き詰めて左へ移るほど、今度は増幅が問題になります。最適粒度はこの曲線の交わるあたりに存在するはずですが、その位置はモデル構造とページサイズに依存し、本記事では特定できていません。
言い換えると、読み出し粒度には下限があり、最適粒度がどこかに存在します。細かくするほど読む総量は減りますが、ページ単位の増幅は増える。アップルが2023年に論文の中でファイル内レイアウトとしてやったことを、FTL の配置ポリシーとしてやるのかどうか。A2 の具体的な中身のひとつはここだと考えます。ページサイズ 16KB は引用特許の例示に倣った仮定で、アップルが採用している NAND のページサイズは公開されていません。増幅の倍率はこの仮定に直接依存します。
念のため確認しておくと、配置をどれだけ作り込んでも、得られるのは上の式そのものです。配置とスケジューリングは、この天井に確実に届かせるための工夫であって、天井を上げるものではありません。帯域が欲しければダイを増やすしかなく、ダイ枚数はそのまま容量とコストになります。
エネルギーの側にも壁がありますが、そちらは 5.3 で扱います。
3.4 三段の判定
集めた証拠を三段に振り分けます。
| 論点 | A1 オンパッケージ化 | A2 プリフェッチエンジン | A3 コヒーレント NAND |
|---|---|---|---|
| インターポーザの存在(3.3) | 前提を満たす | 直接は無関係 | 前提を満たす |
| 全レイヤ自社所有(3.1) | 有利 | 決定的に有利 | 有利 |
| コヒーレンシの壁(3.2) | 影響なし | 影響なし | 致命的 |
| 特許の傾向(3.2) | 中立 | 中立 | 不利(DRAM 二層どまり) |
| アレイ帯域の壁(3.3) | 効果を大きく制限 | 影響なし | 影響なし |
| エネルギーの壁(5.3) | 削減幅は1割〜数割で不確か | 影響なし | 影響なし |
| 判定 | ありうるが決定打にならない | 最有力 | M7 世代では否定 |
A3 から片付けます。ハードウェアコヒーレントな NAND は、3.2 で見たとおり業界の最良解ですら達成していません。H³ が統一アドレス空間を謳いながら実体は役割分担と 40MB の SRAM バッファである以上、アップルだけが真のコヒーレンシを実現していると考える理由はない。同じ節で見た特許調査も後押ししません。アップルが10年にわたり継続出願してきたのは DRAM 二層のキャッシュ構成であって、NAND ではありませんでした。M7 世代での A3 は否定してよいと考えます。
次に A1。これは成立しうるのですが、効果を数えると拍子抜けします。しかも効果の大きさが tR の不確かさに丸ごと依存します。
3.3 で見たとおり、2TB 構成(16ダイ)は tR=50μs なら 21GB/s、tR=75μs なら 14.0GB/s。現行の公称が 14.5GB/s ですから、前者ならリンクが律速していて、オンパッケージ化で 1.4 倍ほど伸びる。後者ならすでにアレイが律速していて、リンクを太くしても帯域は 1 ミリも伸びません。同じ 14.5GB/s という数字が、tR の値ひとつで「まだ余裕がある」とも「もう限界」とも読める。
仮に楽観側を取っても、重み専用に 4TB 分の32ダイを積んで 41.9GB/s、デコードに直すと約4 tok/s にしかなりません。しかもそのとき消費電力は 34W です。エネルギー面の改善も 5.3 で見るとおり、1割から数割という幅のある話にとどまります。つまり A1 は「やってもよいが、それだけでは何も解決しない」という位置づけになります。逆に言えば、A1 単独では世代を一つ飛ばす理由になりません。
残るのが A2 です。そして三つの制約をすべて生き延びるのは、これだけです。コヒーレンシの壁はプリフェッチエンジンには関係がない。アレイ帯域の壁も、エネルギーの壁も、どちらも「たくさん読む」ことへの罰であって、読まずに済ませる仕組みは罰を受けません。むしろ制約が厳しいほど価値が上がる。
アップルの構造的優位が三段のうち A2 にだけ直接効くこと、業界(キオクシア)も同じ方向へ動いていること、そして現行の Mac に欠けているのがプリフェッチそのものではなく意味論であることは、3.1 で見たとおりです。
ただし、この判定には二つの限定を付けておきます。一つは水準です。A2 には、上位層が LBA の列を渡すだけの弱い形と、界面が束・締切・投機性・誤り耐性を運ぶ強い形があり(7章)、M6 のキャンセルを説明しうるのは強いほうです。最有力と言うときは、その A2-strong を指します。もう一つは射程です。6章で数えるとおり、読む量を減らす手段の大半はコントローラではなくモデル側にあります。したがって A2 が本当に効くのは、モデルとハードウェアを同じ主体が設計している場合、つまり垂直統合された自社モデルの範囲内です(6.10)。
したがって筆者の見立てはこうなります。M7 世代でアップルがやるのは、最も強い形(A3)ではなく、ANS の後継が「ストレージコントローラ」から「重みプリフェッチエンジン」へ役割を拡張すること(A2)であり、その器としてオンパッケージ化(A1)が付随するかもしれない、という順序です。主役は A2 です。
そして A2 は、前編8.2で挙げた予測器4クラスのうち第4クラス、重みプリフェッチエンジンそのものです。H³ の LHB が同じ場所に着地しているのは偶然ではありません。つまり仮説Aを突き詰めると、行き着く先は仮説B の内側です。二つは別の仮説ではなく、包含関係にある。4章でその全体像を見ます。
3.5 三段の外側 ― 読まずに済ませる経路
最後に、三段という切り方そのものの限界を確認しておきます。A1・A2・A3 はいずれも、フラッシュを読むことを前提に、読み方を賢くする方向の切り分けでした。しかしフラッシュ階層への経路は、それで尽きるわけではありません。並べ直すと三つあります。

図6. 経路1 が本章の A2、経路2 が6章で扱う読み量の削減、経路3 が本節の in-flash computing です。三つに共通する壁として、NAND アレイの読み出しエネルギーを下段に置いています。
経路3、すなわち in-flash computing あるいは 3D NAND PIM は、重みを読み出すのをやめて記憶素子の側で積和を実行してしまう方向です。5.3 で pJ/bit の出典として引く KVNAND(arXiv:2512.03608)は、本来この経路の研究です。ほかに NVLLM(arXiv:2604.25699)が 3D NAND を中心に据えたエッジ推論アーキテクチャを提案しています。
もっとも直接的なのは Jang らの 3D NAND Flash PIM(arXiv:2511.12860、2025年11月17日)です。単バッチのトークン生成を 3D NAND flash PIM にオフロードし、RTX4090 4枚と vLLM の構成に対して 2.4倍、A100 4枚に対してレイテンシ増 4.9% にとどまり、しかも追加面積なしで 4.98mm² のダイ面積に統合可能だと報告しています。本記事が想定する「単バッチのローカル推論」という条件に、そのまま重なる研究です。
これが 3.4 の判定に対して持つ意味は次のとおりです。A2 は「読む順序と配置を賢くする」提案ですが、経路3 が成立するなら、そもそも読む必要がなくなります。三つの壁をすべて生き延びるのは A2 だけだという論法は、経路3 がエネルギーの壁を別の方向から回避しうる点で、閉じた包囲ではありません。
ただし経路3 は研究段階で、量産品は存在しません。モデル更新への追従性、つまり重みが書き換わったときにどうするかという問題も見えていません。したがって M7 世代、すなわち2027年の話としては、経路3 は候補から外してよいと考えます。3.4 の判定は変えません。ただし、三段が選択肢を尽くしているかのようには扱わない、という留保は残しておきます。
4. 仮説B ― 予測器はシリコンに焼かれるか
前編の予告のほうです。こちらは、調査するほど根拠が積み上がりました。
4.1 アップルのローカル推論高速化の系譜
アップルがローカル推論の高速化、とりわけ投機デコードに投じてきた研究量は、他社と比べても際立っています。
| 年 | 成果 | 内容 |
|---|---|---|
| 2023年12月 | LLM in a flash(arXiv:2312.11514) | フラッシュからの重みストリーミングを定式化 |
| 2024 | ReDrafter / Recurrent Drafter | RNN ドラフトモデル + beam search + dynamic tree attention。MLX / Metal 上の Apple Silicon で最大2.3倍。NVIDIA TensorRT-LLM に統合され H100 で最大2.5倍 |
| 2024 | Speculative Streaming | ドラフトモデルを別に持たず、本体にマルチストリーム予測を融合 |
| 2025年10月 | Mirror Speculative Decoding(arXiv:2510.13161) | SpecBench の14B〜66Bで2.8〜5.8倍、EAGLE3比で平均30%改善 |

図7. 2023年の LLM in a flash から 2025年の Mirror-SD まで。ソフトウェアの技が、異種アクセラレータへの資源割り当て問題へ変換されつつあります。
特に注目すべきは Mirror-SD です。この手法は、target モデルと draft モデルを異なるアクセラレータに割り当てて並列実行します。論文では M2 Ultra 上で target を GPU に、draft を NPU に割り当てる構成が示されています。原文の表現は異種アクセラレータ(GPU と NPU)への計算の明示的マッピングで、単一 SoC 内の GPU と Neural Engine を並列に使うものです。
これが意味するところは大きい。アップルは投機デコードを、アルゴリズムの問題としてではなく、異種アクセラレータへのハードウェア資源割り当ての問題として扱い始めている、ということです。ソフトウェアの技がハードウェア境界の設計問題へ変換された瞬間は、シリコン化の直前によく観測される兆候です。
前編8.2で「最初に焼かれるのは投機デコードだと予想します」と書き、その根拠として(1)商用推論スタックが既にネイティブ実装済み、(2)MTP ヘッドの標準装備でインターフェースが安定、(3)予測→並列検証→棄却という検証可能で決定的な制御構造を持つ、の三つを挙げました。アップルの場合、これに(4)自社で研究系譜を持ち、自社ハードで実測している、が加わります。
4.2 障壁 ― 動的 tree attention と静的グラフ NPU
一方で、明確な技術的障壁もあります。
投機デコードの検証段階では、ドラフトされた複数候補をツリー状に並べて一括検証します(tree attention)。このときテンソルの形状が動的に変わる。ところが NPU は一般に静的グラフ実行を前提とした設計で、動的形状、top-k、scatter/gather と相性が悪い。
これは実測レベルで確認されています。Apple Silicon NPU 上での MoE 推論を扱った第三者研究(Efficient Mixture-of-Experts LLM Inference with Apple Silicon NPUs、arXiv:2604.18788)は、まさにこの動的テンソル形状と top-k / scatter-gather の NPU 非親和性を主要な課題として挙げ、静的ティア化・grouped expert 実行・load-aware 常駐という回避策で 1.32〜5.55倍の高速化、1.81〜7.37倍のエネルギー効率改善を得ています。mlx-lm への EAGLE-3 移植の議論(Discussion #890)でも、tree mask 用の position_ids が扱えないという同種の問題が報告されています。
前編8.3の観察ポイントに「NPU や推論 ASIC が、投機デコードの動的な tree attention をグラフ再コンパイルなしにネイティブ実行できるようになるか」と書きました。この項目は、いまもそのまま生きています。
4.3 ユニファイドメモリの逆説
もう一つ、Apple Silicon 固有の事情があります。これが面白い。
投機デコードの前提は「k個のトークンを一括検証するコストは1個を生成するコストとほぼ同じ」というものです(Leviathan et al., 2023)。ディスクリート GPU ではこれが成り立ちます。VRAM 帯域が 1.5〜2TB/s あるので、重みのストリーミング時間に対して追加トークンの計算コストが無視できるからです。
ところが Apple Silicon では成り立ちにくい。arXiv:2604.16368(ポーランド語モデル Bielik を対象とした Apple Silicon 上の cross-family 投機デコード研究)は、ユニファイドメモリの共有バスが VRAM の8〜10倍遅いためにここがボトルネックとなり、この前提が崩れると定式化しています。mlx-lm の実測報告でも、4bit の 8B モデルで検証トークン1個が約1ms の実時間コストを持ち、CUDA のようにバッチ並列で償却されない、とされています。
一見すると「Apple Silicon では投機デコードが効きにくい」というネガティブな話です。しかし裏返すと、検証を安くする専用経路の価値が Apple Silicon では他社より高い、ということでもあります。ソフトウェアで解けない非効率がハードウェアの動機になる、というのはマイクロアーキテクチャ史の定番の展開です。CPU がソフトウェア TLB ミスハンドラをハードウェアページウォーカーに置き換えたときと同じ構図で、アップルには投機デコードをシリコンに落とす固有の理由がある。
4.4 仮説Bの判定
前編8.2で挙げた予測器4クラスについて、M7 世代でのハード化圧力を評価すると次のようになります。

図8. バーは筆者の主観的評価です。投機デコードのドラフト・検証器が最も高く、次いで重みプリフェッチエンジン。KV eviction 予測器は「外れても正しさは壊れず速度が落ちるだけ」の近似最適化であり、シリコン化の圧力が相対的に弱いままです。
「Neural Engine の大幅強化」の中身として最もありそうなのは何か。筆者の見立ては、専用の「予測器 ASIC」が独立ブロックとして生えるのではなく、NPU そのものの再構成です。具体的には次の三つの合わせ技だと予想します。
| 予想する変更 | 根拠 |
|---|---|
| 動的形状・動的制御フローのネイティブ実行(tree attention、top-k ルーティング、scatter/gather) | arXiv:2604.18788 と mlx-lm #890 が示す現行 NPU の非親和性。Mirror-SD が NPU をドラフト実行に使っている |
| 低ビット行列積のネイティブ対応(int4 / int2、MXFP4 または自社形式) | M5 で GPU コアに Neural Accelerator を入れた延長。ただし業界は MXFP4 と NVFP4 に分岐しており、収束しているとは言いがたい(8章) |
| 帯域増 | M7 base で 240GB/s(報道)。Max はその上 |
ここで、3章で本命とした A2 との関係を整理しておきます。

図9. A2 は仮説B の第4クラスであり、B の一部です。同じ回路ではありません。第1クラスは GPU コアや Neural Engine という演算側に、第4クラスは ANS の後継というストレージ側に置かれます。ダイ上の別の場所にある別の回路です。
ただし両者は無関係でもありません。第1クラスのドラフトモデルは次の k トークンを予測します。トークンが決まれば、活性化する expert もほぼ決まる。つまり投機デコードのための先読みは、そのまま重みプリフェッチの予告として使えます。第1クラス、第2クラス、第4クラスは、予測を上流から下流へ流す一本のパイプラインを構成しうるわけです。
この関係には対称的な帰結があります。ドラフトが当たれば、演算が節約できるだけでなく、読むべき重みも先に分かる。外れれば、投機した計算と先読みした読み出しの両方が無駄になる。賭け金は小さくありません。メモリ制約下の MoE 実行では、重みの転送が推論レイテンシの85〜94%を占めるという報告があり(BuddyMoE、arXiv:2511.10054)、外れた転送はそのまま丸損です。予測が当たるかどうかという一つの賭けに、演算と記憶の両方が乗ることになります。エネルギーの制約が厳しいコンシューマ機ほど、この賭けの精度が効いてきます。
ただし、ここには逆向きの力も同時に働きます。k 個のトークンを一括で検証すること自体が実効的なバッチサイズを増やし、MoE のスパース性を削る方向に作用するからです。連続トークン間の活性の重なりによる償却という追い風と、実効バッチ増によるスパース性消失という逆風が、同じ k について逆向きに働く。この収支は 6.6 で扱います。
前編8.2で「シリコンの設計から量産までは3〜5年かかる一方、モデル構造は年単位で変わるため、完全な固定機能として焼くのはリスクが高い。CPU の perceptron 予測器が回路構造だけを固定し重みテーブルを SRAM に置いたように、LLM 側も回路は固定、係数は書き換え可能な準汎用ユニットに落ち着くはず」と書きました。M7 の Neural Engine 強化がこの形を取るなら、それは前編の予想の正当化になります。
逆に、単なる TOPS 増と対応精度の追加だけなら、世代を一つ飛ばす理由としては弱い。世代を飛ばしてまで前倒しした以上、構造的な変更が入っていると考えるほうが自然です。ここは 2027 年に検証できます。
5. 算数をもう一度やり直す
前二編の式に、M7 世代の想定値を代入します。前提は前二編と同じく DeepSeek-V3 級 Q4(毎トークン読み出し 10.2GB、routed expert 総量約 350GB)です。
5.1 帯域シナリオ
| シナリオ | 実効帯域 | デコード天井(キャッシュゼロ) | prefill(重み1周)TTFT | 必要 NAND 容量(3.3) |
|---|---|---|---|---|
| 現行 M5 Max の SSD | 14.5GB/s | 約1.4 tok/s | 約24秒 | 約2TB |
| オンパッケージフラッシュ(保守、筆者推定) | 64GB/s | 約6.3 tok/s | 約5.5秒 | 6〜9TB |
| オンパッケージフラッシュ(積極、筆者推定) | 256GB/s | 約25 tok/s | 約1.4秒 | 25〜37TB |
| M5 Max の LPDDR5X(モデルが収まる場合) | 614GB/s | 約60 tok/s | 約0.6秒 | ― |
| M7 Max の LPDDR(筆者推定) | 約965GB/s | 約95 tok/s | 約0.4秒 | ― |
| HBF Gen1(参考、目標値) | 1,638GB/s | 約160 tok/s | 約0.2秒 | ― |

図10. 横軸は対数です。オンパッケージフラッシュが 64GB/s どまりなら実用ライン(10 tok/s)に届かず、256GB/s まで行けば跨げます。この一桁の差が A1 の値打ちを決めます。
ただし右端の列が示すとおり、256GB/s はアレイ側で 25〜37TB 分のダイを要求します(算出根拠は 3.3 および別稿)。ノート PC の構成としては成立しません。上限を試すための参考値と考えてください。
M7 Max の帯域推定の根拠は素朴な外挿です。M5 → M6 が 153 → 200GB/s(約1.31倍)、M6 → M7 が 200 → 240GB/s(1.2倍)。同じ比率が Max にも掛かるとすれば、614 × 1.31 × 1.2 で約965GB/s。2世代分でおよそ1.57倍という計算です。もちろん Max の帯域が base と同率で伸びる保証はありません。
そして、帯域より重要なのが容量です。モデルの重み footprint と各 SKU の容量を突き合わせると、次のようになります。
| モデル(Q4想定) | footprint | M5 Max 128GB | M7 Max 256GB(推定) | M5 Ultra 768GB | M7 Ultra 1.5TB(報道) |
|---|---|---|---|---|---|
| 200B 級(100GBライン) | 約100GB | 収まる | 収まる | 収まる | 収まる |
| DeepSeek-V3 級 671B | 約350GB | 不可 | 不可 | 収まる | 収まる |
| GLM-5.2 級 753B | 約380GB | 不可 | 不可 | 収まる | 収まる |
| 2T 級 | 約1000GB | 不可 | 不可 | 不可 | 収まる |
| Kimi K3 級 2.8T | 約1400GB | 不可 | 不可 | 不可 | ぎりぎり |

図11. 縦横とも対数です。B200 は帯域で圧倒的に上にいますが容量は 180GB。M7 Ultra(報道値)は右下、つまり容量で殴る位置に置かれています。前編で置いた「100GBライン」との位置関係も示しました。
この表が、この記事で一番言いたいことを含んでいます。M7 Max は帯域が伸びても、容量の列は M5 Max とほとんど変わりません。つまりコンシューマ機にとって、前編の「100GBライン」は依然として主経路のままです。
5.2 反論 ― 1.5TB が来るならフラッシュ階層は要らないのでは
ここで正面から反論を検討します。M7 Ultra が最大 1.5TB のユニファイドメモリを積むなら、DeepSeek-V3 級 Q4(約 350GB)も、2T 級 Q4(約 1TB)も、そのまま DRAM に常駐できます。expert キャッシュもプリフェッチもフラッシュ階層も要らない。前二編で延々やってきた算数が、まるごと不要になります。
この反論は、M7 Ultra という SKU に関する限り正しい。素直に認めるべきです。
ただし二つの留保があります。
第一に、1.5TB が出荷される保証がありません。Gurman 自身が、メモリ市況次第で実際の上限は下がりうると明記しています。実際、供給側の状況は悪化しています。SK hynix の CEO 郭魯正氏は 2026 年 7 月 10 日、同社の米ナスダック ADR 上場デビュー当日にロイターへ「供給の観点から、来年(2027年)は業界史上最悪の年になると予測している」と述べ、さらに「顧客需要は 2030 年以降も当社の供給能力を上回り続ける」と付言しました。すでに Mac Studio では上位メモリ構成の削除と値上げが報じられています。設計上 1.5TB に対応していることと、1.5TB の製品が買えることは別の話です。
第二に、こちらのほうが本質的ですが、コンシューマ機には降りてこないという点です。M7 Max を積んだ MacBook Pro のメモリ上限が 1.5TB になることは、まずありません。M5 Max で 128GB、M7 Max でも 128〜256GB 級が現実的な想定です。

図12. 同じ「2T級モデルをローカルで動かす」という要求に対し、上位 SKU は容量で殴り、下位 SKU は階層で解く。同じ世代の中で両方が起きても矛盾しません。
続編7章で、この技術を一番切実に必要としているのは個人であり、しかし技術は必要な者の順ではなく払える者の順に届く、と書きました。M7 世代のロードマップは、その非対称をそのまま製品ラインの分岐として写し取っているように見えます。
5.3 エネルギーの壁は残る
容量と帯域を解いても、最後に残るのはエネルギーです。式は続編コラムと同じで、エネルギー/トークン = 読み出しバイト数 × 8 × pJ/bit。
| 条件 | 読み量/token | pJ/bit | エネルギー/token | 10 tok/s 時の電力 |
|---|---|---|---|---|
| 現状 NAND | 10.2GB | 約100 | 約8.2J | 約82W |
| 閾値達成 | 10.2GB | 10 | 約0.82J | 約8.2W |
| 閾値達成 + 活性率1/3化 | 約3.4GB | 10 | 約0.27J | 約2.7W |
| DRAM 級 | 10.2GB | 約2 | 約0.16J | 約1.6W |

図13. 縦軸がデバイス側の pJ/bit、横軸がモデル側の読み量です。現在地(約82W)からノート PC の熱設計内(数W)へ降りるには、縦と横の積で約2桁を詰める必要があります。続編のスマホ版コラムと同じ図を、ノート PC の熱設計で読み直したものです。
ノート PC の持続熱設計を考えると、オンパッケージフラッシュから毎秒数十 GB を読み続ける構成は、pJ/bit が下がらない限り成立しません。「問題は容量から帯域へ、そしてエネルギーへ」という続編の主張は、M7 世代でもそのまま生きています。
ここで当然の疑問が出ます。オンパッケージ化すれば PCIe SerDes と基板配線が消えるのだから、pJ/bit はむしろ下がるのではないか。もっともな指摘で、方向としては正しい。しかし桁は変わりません。内訳を見ると理由がはっきりします。
arXiv:2508.06978 は SSD 経路のエネルギーをこう分解しています。102.4pJ/b(フラッシュ読み出し)+ 4.2pJ/b(HBM への書き込み)+ 4.2pJ/b(HBM からの読み出し)= 110.8pJ/b。つまり総量の 92% が NAND アレイの読み出しそのもので、外部 I/O とステージングは 8.4pJ/b しかありません。同論文はこの内部フラッシュ読み出しエネルギーを「1回の読み出し動作のエネルギーをページサイズで割った値」と定義しており、出典は FlashPower(DATE 2010)です。配線の話ではなく、セルの話だということです。
なぜアレイ側が支配的なのかも、同論文が説明しています。フラッシュは比較的高い電圧を印加し、セルのしきい値電圧を検知する複雑な機構を必要とする。対して DRAM はキャパシタ電荷の低電圧差動センシングで済む。高電圧生成のチャージポンプとしきい値センシングは、ダイをインターポーザに載せ替えても消えません。
したがってオンパッケージ化で消せるのは、PCIe SerDes と、DRAM を経由する中間コピーです。後者は地味に効きます。現行の経路は「フラッシュから読む、LPDDR に書く、LPDDR から読む」の三段構えですが、オンパッケージなら中間の 8.4pJ/b を省ける可能性がある。ただし 110.8 が約 102 になるだけで、1割弱です。
ここで、この見立てへの反証も挙げておきます。KVNAND(arXiv:2512.03608)のモデルでは、フラッシュのインターフェースアクセスが 4.9pJ/bit、内部の読み出しが 3pJ/bit と見積もられており、I/O 側のほうが大きい。この配分が正しければ、オンパッケージ化による削減余地は1割どころではありません。実際、Kioxia と SanDisk の次世代インターフェース(Toggle DDR6.0)は PI-LTT という技術で入力電力を10%、出力電力を34%削減すると発表しています。
ではどちらが正しいのか。おそらく「どちらも正しい」というのが答えで、値の差は測定境界の引き方に由来します。arXiv:2508.06978 の 102.4pJ/b は FlashPower のモデルで「1回の読み出し動作のエネルギーをページサイズで割った値」であり、ダイ内部の周辺回路まで含む。KVNAND の 3pJ/bit はもっと狭くセルアレイだけを見ている可能性が高い。したがって安全な言い方はこうなります。オンパッケージ化による削減幅は 1 割から数割の範囲で不確かだが、高電圧生成としきい値センシングという NAND 固有のコストは残るため、10pJ/bit の閾値には届かない。
言い換えると、オンパッケージ化が確実に解くのはレイテンシと帯域の問題であって、エネルギーの問題は部分的にしか解けない。この区別が以下の計算の前提になります。
以上を踏まえて、同じ式を 5.1 の帯域シナリオに逆向きに当てると、この記事にとって厳しい結論が出ます。読み出しを続けている間の電力は、帯域 × 8 × pJ/bit で決まります。
| 帯域 | 100pJ/bit(現状 NAND) | 10pJ/bit(閾値達成) | 2pJ/bit(DRAM 級) |
|---|---|---|---|
| 14.5GB/s(現行 SSD) | 11.6W | 1.2W | 0.2W |
| 64GB/s(保守シナリオ) | 51W | 5.1W | 1.0W |
| 256GB/s(積極シナリオ) | 205W | 20.5W | 4.1W |
| 1,638GB/s(HBF Gen1 参考) | 1,310W | 131W | 26W |
ここから二つ言えます。
一つ目。5.1 では帯域だけを見て六つのシナリオを並べましたが、エネルギーで足切りすると、ノート PC で成立しうるものはごくわずかです。積極シナリオの 256GB/s は、現状の NAND なら 205W、閾値を達成しても 20.5W かかります。ノート PC 全体の持続電力が数十W であることを考えると、フラッシュの読み出しだけでその大半を食う計算になる。ここを成立させるには 2pJ/bit 級、つまり DRAM 並みの読み出しエネルギーが要ります。しかしそれはもはや「安価な大容量フラッシュ」ではなく「不揮発性 DRAM」であって、コストで HBF に勝つという A1 の前提そのものが崩れます。保守シナリオの 64GB/s ですら、10pJ/bit の閾値達成が前提条件です。ついでに言えば、HBF Gen1 が 131W(閾値達成時)という数字は、この技術が最初からデータセンター向けである理由をそのまま説明しています。
二つ目、こちらのほうが本質的です。5.2 の結論と正面から衝突します。
容量の観点では、フラッシュ階層を必要としているのは下位 SKU でした。1.5TB を積めないからです。ところがエネルギーの観点では、フラッシュ階層を許容できないのも下位 SKU です。電池で動き、受動冷却か小型ファンしか持たないからです。逆に Ultra やサーバなら 20W でも 82W でも呑めますが、そちらは DRAM を積めば済むので、そもそも要らない。
必要としている機械には電力がなく、電力のある機械には必要がない。この捻れが、A1 に対する制約になります。3.2 で見たコヒーレンシの障壁は A3 を否定するものでしたが、こちらは A1 が実現したとしても残る、物理側の制約です。フラッシュをパッケージに載せ替えても、熱力学は載せ替えられません。
ただし、公平を期すために反論も書いておきます。arXiv:2508.06978 の著者たち自身は、むしろモバイルこそ本命だと述べています。理由はバッチサイズです。データセンターは大バッチで動くため、多数のトークンが結局ほぼ全 expert を活性化してしまい、MoE のスパース性が消える。同論文が SSD 側に成立余地を認めるのは低バッチの領域に限られ、コンシューマのローカル推論はまさにバッチ1で動きます。スパース性が最大になる条件で動く。つまり「読む量を減らす」の余地が最も大きいのは、ほかならぬ下位 SKU なのです。
裏返すと、フラッシュ階層が成立する道は一つに絞られます。帯域を上げるのではなく、読み出す量を減らすことです。図13 で言えば、上へ動く(pJ/bit を下げる)のではなく左へ動く(GB/token を下げる)。
ここで言葉を二つに分けておきます。プリフェッチ(先読み)はレイテンシを隠す技術であって、読む量は減らしません。予測が外れればむしろ増えます。読む量を減らし、エネルギーを救うのは選択的読み出し、つまり要らない expert をそもそも読まないことのほうです。

図14. プリフェッチは読みと計算を重ねて実時間を縮めますが、読む量、すなわちエネルギーは変わりません。読みのバーそのものを短くするのが選択的読み出しです。
この区別は、同じ論文が定量で裏づけています。arXiv:2508.06978 は、SSD へのオフロードがトークンあたりエネルギーを Mixtral で 3.8〜12.5倍、DeepSeek-R1 で 4.7〜9.8倍に増やし、CPU メモリへの退避と比べても 2.1〜3.6倍悪いと測定したうえで、プリフェッチは遅延を隠せてもこのエネルギーペナルティを緩和できない、と明記しています。同時に、フラッシュ読み出しエネルギーが約1桁改善すれば MoE のスパース性ゆえに成立余地がある、とも述べており、上で置いた 10pJ/bit の閾値と整合します。
LLM in a flash の約25倍という数字も、その大半は「FFN の約2%しか読まない」という選択の寄与でした。ただし 3.1 で触れたとおり、この2%は ReLU 系モデルでの値です。したがって道筋を正確に言えば、活性の予測を当てて要るものだけを読み、外れによる無駄読みを抑える、となります。
これは 3.4 で最有力とした A2 そのものです。A1 が帯域とエネルギーの両方で頭打ちになる以上、フラッシュ階層の成否はフラッシュの物理性能ではなく、予測器の賢さに依存する。そして 4.4 の図9 で見たとおり、その予測器を駆動するのは投機デコードの先読みです。仮説A の成否が仮説B の出来に従属する、という関係になります。
では、読む量は実際にどこまで、誰の手で減らせるのか。そして減った先で何が起きるのか。次章で数えます。
6. 読む量を減らす ― どこで効き始め、誰がやるのか
5.3 の結論は、フラッシュ階層の成否を読む量の削減に賭けるものでした。本章はその賭けを二つの側から数えます。前半(6.1〜6.2)は、どこまで減れば何が変わるのかという境目を、後半(6.3〜6.10)は、その削減を誰がどの手段で担うのかを扱います。
6.1 現在地は帯域律速である
3.1 で「無いのはプリフェッチではなく意味論だ」と述べました。ここに素朴な反問が立ちます。読むべき場所さえ分かっているなら、上位層が LBA を並べて渡せば済むのではないか。それならコントローラに手を入れる必要はほとんどないのではないか、という疑問です。
この疑問は、現在地に関する限り正しいと考えます。5章の前提を、層あたりに割り直すと分かります。
| 項目 | 値 | 出典・根拠 |
|---|---|---|
| 毎トークンの読み出し量 | 10.2GB | 5章の前提(DeepSeek-V3 級 Q4) |
| 層数 | 61 | DeepSeek-V3 の公開 config |
| 1層あたりの読み出し量 | 約167MB | 上二つの商 |
| 現行 SSD(14.5GB/s)での所要時間 | 約12ms | 公称値による |
| tR(3D TLC) | 約75μs | Flash Memory Summit 2019 のコンポーネント評価資料 |
| 両者の比 | 約160倍 | ― |
なお 10.2GB/token を61層で割った 167MB と、config から expert 9本ぶんを直接積算した約198MB は一致しません。前者は5章が採った前提値、後者は素朴な積算で、attention 側の扱いや層ごとの構成差(先頭3層が dense)を吸収していないためと思われます。本章の結論はこの差に影響されませんが、以下の表の絶対値には効きます。
1層の予算が 12ms あるのに対し、NAND の読み出しレイテンシは 75μs です。リクエストの発行から完了割り込みまでのソフトウェア往復を加えても、桁が二つ違います。
つまり現状は純粋に帯域律速です。必要な先読み深度は1層先ぶんもあれば足り、それは上位層が LBA のリストを投げるだけで実現できます。コントローラが expert という単位を理解している必要はありません。3.1 の図3 で「意味論の不在は現在のところ実害を生んでいない」と付記したのは、この計算のことです。
6.2 レジームは選択的読み出しの成功によって切り替わる
ところが 5.3 は、フラッシュ階層が成立する道は帯域を上げることではなく読む量を減らすことだ、と結論しました。この結論が実現した世界を同じ式で見ると、景色が変わります。オンパッケージフラッシュの保守シナリオ(64GB/s)を仮定します。
| 読み量の削減 | 1層あたり | 64GB/s での所要時間 | tR=75μs との比 | 律速要因 |
|---|---|---|---|---|
| 削減なし | 約167MB | 約2.6ms | 約35倍 | 帯域 |
| 1/10 | 約17MB | 約260μs | 約3.5倍 | 遷移領域 |
| 1/30 | 約5.6MB | 約87μs | 約1.2倍 | レイテンシとテール |

図15. 縦横とも対数です。現在地(左上の点)では1層の予算が約12ms あり、tR の 75μs とは桁が二つ違います。読む量を減らすほど左から右へ動き、オンパッケージ 64GB/s のシナリオではおよそ 1/30 で tR の帯に到達します。帯域律速からレイテンシ律速へ切り替わる点が、A2 が必要になる境目にあたります。なお 1/30 という削減率が現実的かどうかは 6.4(図17)で検討します。そちらの結論は楽観的ではありません。
一番下の行では、1層ぶんの読み出し時間と tR がほぼ同じになります。この領域では、平均帯域ではなく最も遅い1本がいつ返るかが所要時間を決めます。
ここに往復関係があります。5.3 の結論は A2 の帰結であると同時に、A2 が必要になる前提条件でもあります。読む量を減らすことに成功した瞬間に、レイテンシとテールの管理が一次項へ昇格するわけです。
図16. 読む量を減らすことが、そのまま下層への要求を生みます。A2 は 5.3 の結論と独立の提案ではなく、その帰結として要求されるものです。
6.3 因子に分解する
では、読む量そのものはどう決まるのか。1トークンあたりにフラッシュのアレイが実際に読むバイト数は、おおむね四つの因子の積で書けます。
読み量 = モデルが構造的に必要とする分 × 常駐で賄えなかった割合 × (1 ÷ 予測の適合率) × ページ単位の増幅
前二つは減らす方向、後ろ二つは増やす方向に働きます。5.3 でプリフェッチと選択的読み出しを区別したのは、この式で言えば因子3 と因子1 の違いを言っていたことになります。以下、順に見ます。
6.4 因子1 ― 構造的に何割が必要か
3.3 で積算したとおり、DeepSeek-V3 では expert が 671B の97〜98%を占め、残る15B ほどが MLA と先頭3層の dense 層と埋め込みで、Q4 なら 7〜8GB です。参考までに、同一アーキテクチャの DeepSeek-R1 について arXiv:2508.06978 は expert がパラメータの 96.1%、毎トークンの活性が 3.5% としています。
つまり問題は「98%のうち、どの3.5%(257本中9本)を読むか」に還元されます。ここまでは MoE という構造が無条件でくれるスパース性で、5章の 10.2GB/token という前提値は、すでにこれを織り込んだ後の数字です。ここからさらに減らす手段は、次の三つに分かれます。
| 手段 | 追加の削減余地 | 成立の前提 | 交換するもの |
|---|---|---|---|
| ニューロン単位の選択 | 素の ReLU モデルで FFN の97% | 活性が厳密にゼロになること | 前提が崩れると効かない |
| relufication / 活性スパース化 | ReLU 化により67〜89%程度 | 学習側で手を入れられること | 精度と再学習コスト |
| 動的 k、gate 値による打ち切り | 未確認 | router の分布が尖っていること | 精度 |
一段目には、3.1 でも引いた LLM in a flash の「FFN の約2%しか読まない」があります。ただしここには重要な前提があります。論文が使ったのは OPT-6.7B(FFN スパース率97%)と、活性化を ReLU に置換してファインチューンした Falcon-7B(95%、Mirzadeh らによる)です。前者は素の ReLU モデル、後者は ReLU 化を経たモデルであり、いずれも SwiGLU のままではありません。
では ReLU 化でどこまで行くのか。ProSparse(arXiv:2402.13516、COLING 2025)が LLaMA2-7B で 89.32%、LLaMA2-13B で 88.80%、MiniCPM-1B で 87.89% を、元の Swish 版と同等性能で達成したと報告しています。比較対象の ReluLLaMA-7B は 66.98%、ReluLLaMA-13B は 71.56%。Mirzadeh らの ReLU Strikes Back は約60%の回復で9タスク平均の精度低下が約1%としています。
この数字を読み量に換算すると、本記事の想定に対してかなり厳しい結果になります。

図17. いずれも論文の報告値です。右側の換算は 1/(1 - スパース率) によるもので、読み量が何分の1になるかを示します。素の SwiGLU モデルはこの図に載りません。厳密なゼロが出ないため、スパース率という形で報告できるのは ReLU 系か ReLU 化を経たモデルだけだからです。
図15 で tR に到達する 1/30 という水準には、96.7% のスパース率が要ります。これを満たすのは素の ReLU である OPT-6.7B だけで、現行の relufication 技術の到達点である89%台では 1/9 にとどまります。しかも 1/9 のうち一部は 3.3 で見たリード増幅に食われます。3.1 と 5.3 の「約25倍」「約2%」に留保を付けたのは、この数字のことです。あの倍率は ReLU 系モデルでの実測であって、DeepSeek-V3 級にそのまま移せる保証はありません。
三段目の動的な打ち切りについては、定量的な報告を見つけられませんでした。関連するのは代用の系統で、BuddyMoE(Yun Wang ほか、arXiv:2511.10054、2025年11月13日)は、トークン間の co-activation パターンから機能の似た buddy expert の対を特定し、プリフェッチが外れて本来オンデマンドで読むべき expert を、キャッシュ済みの buddy で代用する機構です。根拠として MoE の機能冗長性、すなわち4ビットまでは最小限の劣化で刈れるという性質を挙げています。
6.5 因子2 ― 常駐でどれだけ賄えるか
地味ですが、実務上いちばん効くのはここだと考えます。要するにキャッシュヒット率の問題です。
- shared expert は毎トークン必ず使われるので、無条件で常駐させられます。設計がキャッシュに親切にできているとも言えます。
- routed expert の選ばれやすさには偏りがあります。MoEpic(arXiv:2509.08342)は expert 活性が long-tail 分布を示し、高頻度の hot expert が存在すること、そして時間局所性を持つことを報告しています。
- 連続するトークンの間で活性 expert は重なります。Mixtral of Experts(arXiv:2401.04088)が The Pile 上での位置的局所性を報告し、後続の分析(arXiv:2511.05814)は、次のトークンが前のトークンと同じ expert を選ぶ確率がランダム(8 expert なら12.5%)より高く、時に約30%に近いと定量化しています。層方向にも局所性があり、約44%が前ブロックと同じ expert ID だという報告(arXiv:2512.16473)もあります。ルータの微調整で expert の再利用を26%改善したという報告(ReMoE、arXiv:2605.27081)もあります。
- LLM in a flash の windowing は、これをニューロン単位でやったものです。
制約は容量です。128GB 機で 350GB のモデルなら、非 expert 分と OS と KV キャッシュを引いた残りが expert 用の常駐枠になるので、常駐率はよくて3割前後でしょう。しかも長いコンテキストを扱うほど KV キャッシュが枠を食うので、常駐率は文脈長とともに下がります。3.2 で H³ について見た「読み出し専用の重みと動的な KV の役割分担」は、コンシューマ機では同じ DRAM の取り合いとして現れることになります。
なお上の数値はいずれも Mixtral 系での測定であり、routed expert が256本ある DeepSeek-V3 級での重なり率は別に測る必要があります。expert 数が増えるほどランダム基準線は下がるので、相対的な局所性の強さは変わっても、絶対的なヒット率は下がる方向だと思われます。
6.6 因子3 ― 予測の適合率は、そのままエネルギーの倍率
因子3 は単純です。適合率50%なら倍読むことになります。5.3 で「賭け金は小さくない」と述べたのは、この式のことだと言い切ってよいと思います。予測器の精度は、性能の指標である前にエネルギーの倍率です。
ここで、4.4 の末尾で予告した投機デコードとの収支を数えます。楽観的な筋はこうです。k トークンをまとめて検証するとき必要になる expert は k 個ぶんの和集合であり、連続トークンは活性が重なるので和集合は k 回ぶんの合計より小さい。したがって読み量が償却される。6.5 の局所性の数値は、この筋を支持します。
ただし文献は、この楽観に真っ向から反する材料も出しています。まず arXiv:2508.06978 の著者たちは、投機デコードのような新しい技術がエッジデバイスにおいてすら実効的なバッチサイズを増やし、SSD オフロード方式の成立性をさらに脅かす、と明記しています。つまり著者たちは、投機デコードを償却の手段ではなく、脅威として位置づけています。MoESD(arXiv:2505.19645)も同じ方向を示しており、MoE における投機デコードでは中程度のバッチでほぼ全 expert が活性化してしまい、プリフェッチもキャッシュも効かなくなると報告しています。
整理すると、和集合による償却という効果と、実効バッチ増によるスパース性の消失という効果が、同じ k について逆向きに働きます。k に最適値があるという結論自体は残りますが、その最適値が1より大きいかどうかは自明ではありません。少なくとも「投機デコードは重みプリフェッチにとって追い風だ」と単純に言うことはできず、4.4 の対称的な帰結には、この逆風が併走します。なお、k を増やすと和集合が全 expert に近づくというトレードオフを、SSD 経路のエネルギーの文脈で定量化した研究は見つけられませんでした。ここは空白のままです。
6.7 因子4 ― ページ単位の増幅
これは 3.3 の後半で見たリード増幅です(図5)。因子1 を突き詰めて読み出し粒度が細かくなるほど、ページ単位の無駄が増えます。因子1 と因子4 は互いに逆を向いているので、単純に細かくすればよいわけではありません。最適粒度の議論と row-column bundling による対策は 3.3 のとおりです。
6.8 積み上げてみる
四つを掛け合わせると、どの程度になるのか。値はすべて例示ですが、掛け算の形を見るには足ります。
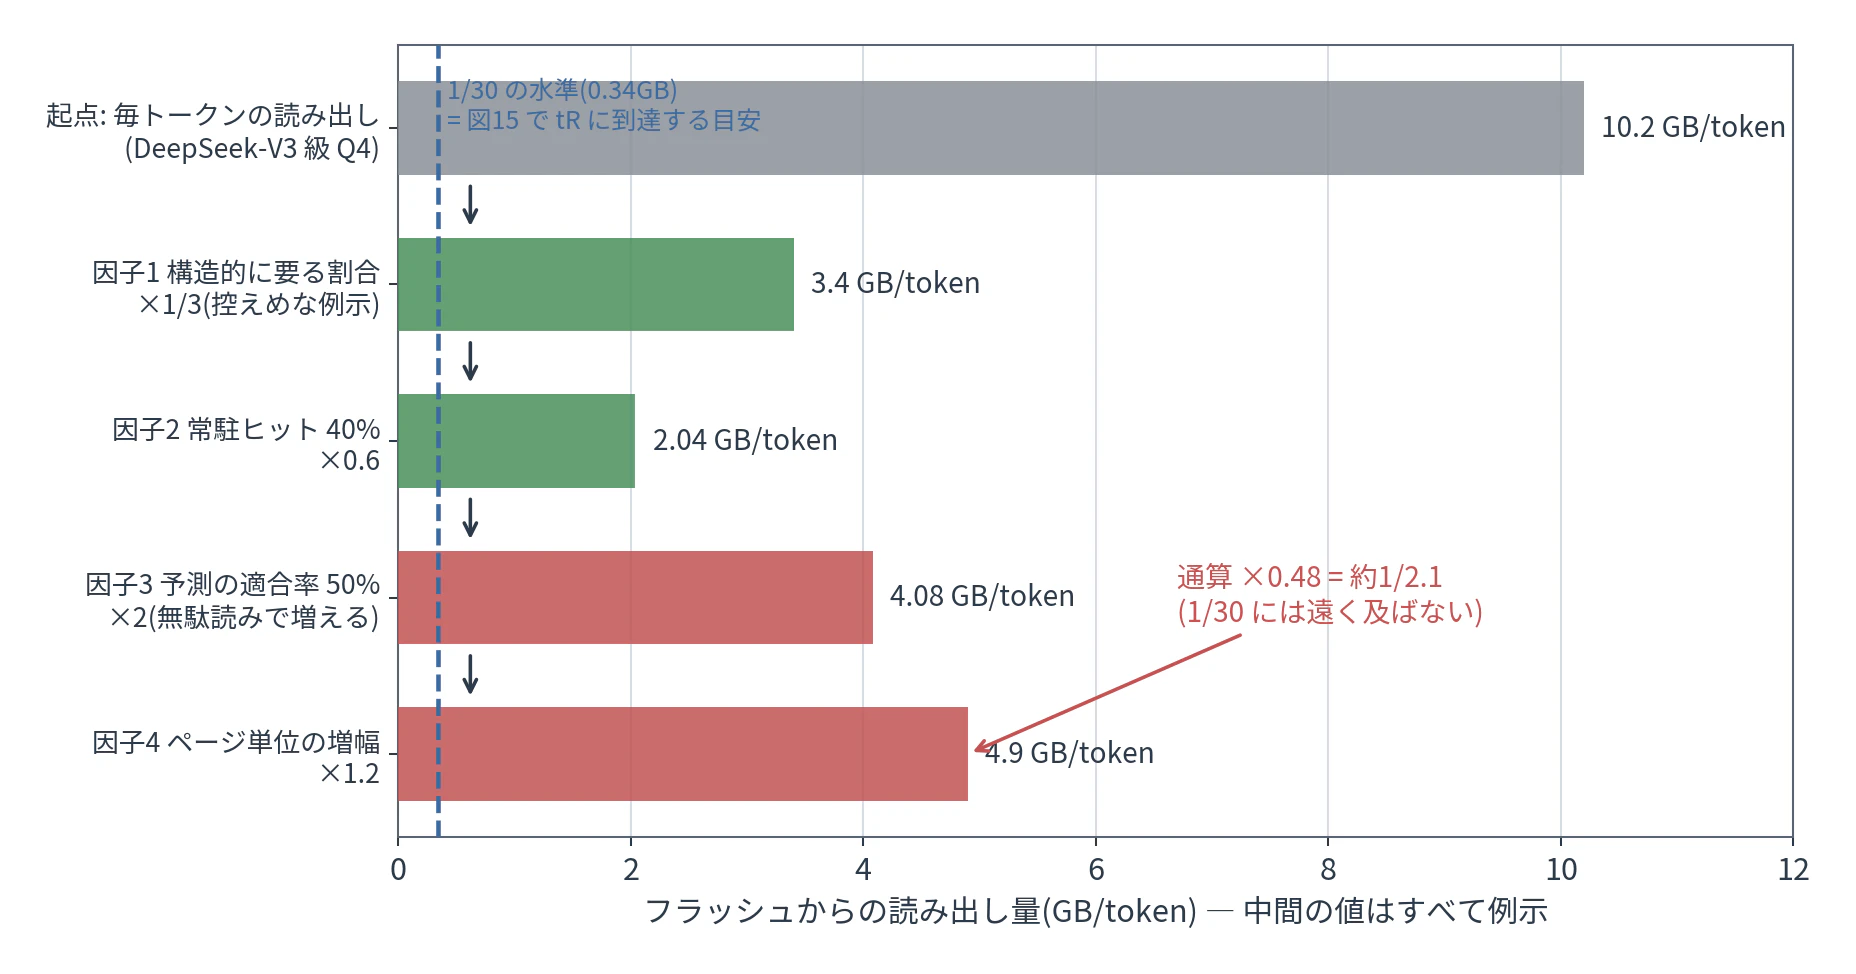
図18. 中間の四つの値に根拠はありません。因子1 と因子2 が減らし、因子3 と因子4 が増やすという構造を見るための図です。この例示値では通算で約2.1分の1にとどまり、図15 で tR に到達する水準(1/30)には遠く及びません。なお因子1 に置いた 1/3 は控えめな値で、relufication を施せば図17 のとおり 1/9 程度までは報告例があります。ただしそれには学習側の改造が要り、素の SwiGLU モデルでは成立しません。
この図がいちばん言いたいことは、減量が掛け算だという点です。四つのうち一つでも想定より悪ければ、全体が届かなくなります。逆に 1/30 を達成するには、四つのすべてが同時にうまくいく必要があります。5.1 の帯域シナリオが六つ並んでいたのと同じ意味で、これも楽観の重ね合わせであることは認めておくべきだと思います。
6.9 手段を並べ、主体を書き入れる
| 手段 | 効く因子 | 主体 | 交換するもの |
|---|---|---|---|
| 常駐セットの設計(人気 expert の固定) | 因子2 | ランタイム | DRAM 容量 |
| windowing(直近の活性を残し差分だけ読む) | 因子2 | ランタイム | DRAM 容量 |
| 活性ニューロンの予測器 | 因子1・因子3 | 学習側 + ランタイム | 外れたときの無駄読み |
| relufication / 活性スパース化 | 因子1 | 学習側 | 精度と再学習コスト |
| 動的 k、gate 値による打ち切り | 因子1 | ランタイム | 精度 |
| buddy expert による代用 | 因子3 | 学習側 + ランタイム | 精度 |
| 投機デコードによる和集合の償却 | 因子3 | NPU + ランタイム | 実効バッチ増によるスパース性の消失 |
| co-activation を意識した配置とバンドリング | 因子4 | コントローラ | 書き込み時のコスト |
主体の列を見ると、コントローラと書けるのは最下段だけです。これを図にすると、あまり都合のよくない形が出ます。

図19. 両軸とも筆者の主観的評価で、図8 と同じ性質の図です。削減への寄与が大きい手段ほどアップル単独では制御できず、自社で閉じる手段ほど寄与が小さい。右上、つまり効果が大きくかつ自社で完結する四分円が空いています。
6.10 モデル側支配という結論と、AFM 3 が示す別の読み
並べて分かるのは、効果の大きい手段のほとんどがモデル側の性質だということです。コントローラをどれだけ賢くしても、ダウンロードしてきたモデルが SwiGLU で密であれば、ニューロン単位の選択は効きません。expert 単位のキャッシュは効きますが、それは因子2 であって、コントローラではなくランタイムの仕事です。
裏返すと、A2 が本当に効くのは、モデルとハードウェアを同じ主体が設計している場合だということになります。アップルはそれができる数少ない会社ですが、できるのは自社の Foundation Models に対してであって、他社製のオープンウェイトを持ってきて動かす場合ではありません。3.4 の判定に付けた射程の限定は、この帳尻から来ています。
そのうえで、当のアップルのモデル側を見ておきます。公式ブログと報道によれば、WWDC 2026(2026年6月8日)で発表された第3世代 AFM 3 は、オンデバイス側に AFM 3 Core(3B の密モデル)と AFM 3 Core Advanced(20B の疎モデル、Instruction-Following Pruning により1〜4B を活性化)の二層を持ちます。サーバ側は AFM 3 Cloud、画像の ADM 3 Cloud、そして AFM 3 Cloud Pro です。オンデバイスに数十B級のティアが載るという条件は、すでに満たされていることになります。
さらに興味深いのは Instruction-Following Pruning の性質です。これは指示に応じて 20B のうち 1〜4B を活性化する仕組みで、活性化率は5〜20%。つまり因子1 をモデル側でやる機構そのものです。しかも選択の単位がトークンごとではなく指示ごと(per prompt)である点が重要で、Apple Machine Learning Research のブログも活性化パラメータをプロンプトごとに固定すると記述しています。そうであれば、毎トークンのランダム読み出しという問題が、指示ごとの一括ロードという問題に変わります。後者はフラッシュが得意とする形、すなわち大きな連続読み出しを多数のトークンで償却する形です。
もしそうなら、アップルがやろうとしていることは本記事が想像した A2 とは少し違うかもしれません。毎トークンの expert を先読みするのではなく、指示ごとにサブネットワークを選んで一括で載せる。必要なのはテンソル単位の細かなプリフェッチ意味論ではなく、数 GB を素早く読み出して DRAM に置く経路です。それは A1(オンパッケージ化)の価値を上げ、A2-strong(7章)の必要性を下げる方向に働きます。粒度が指示ごとであること自体は公式ブログの記述で裏づけられますが、トークン粒度との併用や実装の詳細までは公開されていないため、A1 有利という読み替えは筆者の推測にとどまります。9章の観察ポイントには、この粒度が実装にどう現れるかを確かめる項目を置きます。
なお、2025年の技術報告(arXiv:2507.13575)によれば、第2世代のオンデバイス側約3B モデルは KV キャッシュ共有と2ビットの量子化認識訓練で最適化された密モデルであり、MoE ではありません。サーバ側が PT-MoE(Parallel-Track Mixture-of-Experts)です。本記事が MoE を前提に組み立ててきた議論は、アップル自身のオンデバイスモデルには直接は当てはまらない、ということも押さえておくべきでしょう。
7. 減量後の世界 ― コントローラに残る仕事と、A2 の二つの水準
6章の帳尻は、A2 にとって厳しいものでした。削減の主導権はモデル側にあり、現行技術の到達は 1/9 程度で、レイテンシ律速への切り替え(図15)には届きません。それでも本章では、削減が進んだ世界を先取りして、コントローラの側に何が残るのかを数えておきます。A2 の中身を具体化しないと、9章で観測も反証もできないからです。
7.1 それでもコントローラ側に残る仕事
初期の配置に関しては、3.3 で見たとおりホスト側の書き方でおおむね達成できます。では何が残るのか。調査で裏の取れた根拠を添えて並べます。
| 項目 | 上位層のヒントで供給できるか | 根拠 |
|---|---|---|
| ストライプ配置の初期形成 | おおむね可能 | 逐次書き込みで FTL が自然に撒く |
| 書き込み配置のヒント | 部分的に可能。ただし保証されない | NVMe FDP はホストが Reclaim Unit 単位で配置ヒントを与える仕組みですが、SNIA SDC の WARP による評価では、敵対的な3ストリーム構成で FDP を有効にしても書き込み増幅が一方のドライブで 4.49倍、他方で 2.58倍に達し、その理由はホストから見えないベンダ固有のファームウェア方針にあると報告されています。best-effort であって保証ではありません |
| 読み出しの配置ヒント | 不可 | FDP も ZNS も書き込み配置の機構であり、読み出し側に相当するものがありません |
| 配置の維持 | 困難 | スタティックウェアレベリングは、書き換えられない冷たいデータを P/E 回数の平準化のために意図的に動かします |
| リードディスターブ対策 | 困難 | ASPLOS 2021 の Prolonging 3D NAND SSD lifetime via read latency relaxation は、読み出しのみの低負荷ワークロードであっても read disturbance 起因の再書き込みが背景で走り、保証期間内に摩耗しうると報告しています。書かれないのに読まれ続けるという、SSD にとって例外的なワークロードです |
| マルチプレーン整列 | 不可 | 多くの NAND がプレーン間のアドレス整列を要求します。US 12,455,704 B2 のプレーン並列読み出しの記述でも確認できます |
| GC / erase との調停 | 不可 | erase は tR の 75μs に対して桁違いに長く、細粒度化後の層予算を大きく超えます。read priority と program/erase suspend はコントローラと NAND 側の機能です |
| 投機読みの取り消し | 不可 | ドラフト棄却時に発行済みの読みを安く殺せないと、5.3 が数えたエネルギーが丸損になります |
| ECC 努力度の打ち切り | 不可 | read-retry がレイテンシを押し上げることは ASPLOS 2021 の Reducing SSD Read Latency by Optimizing Read-Retry で示されています。ソフト判定の追加パスはエネルギーも食います |
最後の行の前提、すなわち Q4 の重みがビットエラーにある程度耐えるという見立てには、支持する研究が複数あります。もっとも直接的なのは M. Hasan と B. Ray による IRPS 2019 の Tolerance of Deep Neural Network Against the Bit Error Rate of NAND Flash Memory で、ECC を無効にした MLC NAND において、5年未満のデータ保持、約100回の P/E サイクル、30k 回未満のリードストレスという条件下では DNN の予測精度が許容水準を保つと報告しています。関連して、竹内らの Computational Approximate Storage は 3D-TLC の誤り許容を積極的に利用する方向を、特許 US 10,691,537(Storing deep neural network weights in non-volatile storage systems using vertical error correction codes)は、DNN が重み誤りに頑健であることを前提に許容精度に応じた誤り量を許すという構成を示しています。近似メモリ系では、ビットエラー率 1e-3 で影響がなく 1e-2 で軽微という報告もあります。
ただし既存研究の対象は MLC NAND、小規模 DNN、二値化や量子化ネットワークが中心で、NAND 上の Q4 LLM 重みそのものを対象にした直接の実測は見当たりませんでした。そこは空白です。それでも、誤り耐性に応じて読み出し品質を落とす判断が Anobit 由来の MSP の直上にあることは、3.1 の「アップルだけが持っている層」という主張を補強します。
7.2 A2 の言い直しと、用語の整理
以上を踏まえると、A2 の内容は次のように言い直せます。
下層へ降ろすべきなのは「これは第12層の expert 37 である」という意味論そのものではなく、そこから導かれる属性です。すなわち、この k 本は一組であること、いつまでに揃えばよいか、投機的であって取り消してよいこと、そして誤りにどれだけ耐えるか。上位層は予測を続け、下層は予測を受け取って行動できる形になります。この分担は 4.4 の図9 とも整合します。図9 で第1クラスの予測器は GPU / Neural Engine 側、つまり最上層に置いており、意味論は最上層に残したまま、界面を通る情報の質だけが変わる、という描像です。

図20. 図3 を、界面を通る属性の側から描き直したものです。意味論はどちらでも最上層に残り、界面を通る情報の質だけが変わります。
用語について一点。図2 の表が示すとおり、アップルには独立したフラッシュコントローラが存在せず、SoC 内蔵の ANS2 がそれに当たります。したがって「ANS の後継に手を入れる」と「フラッシュコントローラに手を入れる」は同じ操作を指している、というのが本記事の前提です。ただしここには留保が要ります。ANS2 が FTL、ウェアレベリング、ECC のそれぞれをどこまで担い、MSP とどう分担しているかを明記した一次情報は、今回の調査では確認できませんでした。SSD コントローラが一般にこれらを担うことは確立していますが、アップル固有の内部構成は推定です。3.1 で「ANS2 は RTKit 上で動く ARM64 コプロセッサである」と書いた部分は Asahi Linux 由来の解析として妥当ですが、機能分担の詳細まではそこから出てきません。
7.3 A2-weak と A2-strong
最後に、反証可能性を上げるために A2 を二段に分けておきます。単に LBA の列を渡すだけの API なら、それはファームウェアとドライバの変更で済み、世代を一つ飛ばす理由にはなりません。
- A2-weak:上位層が LBA 列を渡し、ANS はそれを従来どおり実行する
- A2-strong:界面が束・締切・投機性・誤り耐性を運び、ANS 側の配置とスケジューリングと ECC がそれに応じて変わる
この区分が実務的に意味を持つことは、現行 API を見ると分かります。Darwin の fcntl.h には F_RDADVISE(44、オフセットと長さを指定する非同期の助言読み)、F_RDAHEAD(45)、F_NOCACHE(48)に加えて、F_SPECULATIVE_READ(101、通常ファイルおよび圧縮ファイル向けの同期的な助言読み)がすでに定義されています。つまり A2-weak が要求する程度のヒント経路は、macOS にはすでに存在します。逆に言えば、A2-weak の実現は M7 を待つ必要がありません。
3.4 で「A2 が最有力」と判定したのは、この区分で言えば A2-strong を指すものです。A2-weak であれば M6 のキャンセルを説明できず、その場合は4章の仮説B が単独で M7 の中身を説明することになります。どちらであるかを観測で見分ける条件は、9章の表に含めます。
8. 仮説C ― その他に何が入りうるか
二つの主要仮説以外に、M7 世代で構造的変化が起きうる領域を洗い出しておきます。
| 領域 | 起きうる変化 | 確度 |
|---|---|---|
| メモリ階層 | LPDDR6 化、バス幅拡大。M6 の「新しいメモリアーキテクチャ」の中身は未公表 | 高(何かは必ず起きる) |
| プロセス | M7 base が Intel 18A-P という報道と、TSMC 2nm という報道が併存 | 未確定 |
| パッケージ | SoIC-X の継続・拡張。M8(Soko)/ Cardinal は TSMC A14(1.4nm)報道 | 中 |
| サーバ | Baltra 遅延、M5 Ultra ベース(J246)でつなぎ、M7 Ultra ベースは2029年 | 報道 |
| 量子化 | MXFP4 または自社形式のネイティブ対応、int4 / int2 行列積 | 中〜高 |
| フラッシュ側 | プリフェッチ機構を内蔵した高帯域フラッシュモジュールの製品化 | 他社で試作段階 |
| セキュリティ | Secure Enclave 経由の重み暗号化とフラッシュ経路の整合 | 未知 |
| 製品戦略 | オンデバイスは AFM 3 Core(3B 密)と AFM 3 Core Advanced(20B 疎、IFP で1〜4B活性)の二層、クラウドは AFM 3 Cloud / AFM 3 Cloud Pro(NVIDIA GPU、Google Cloud 上)。この構成の継続または変更 | 公式(WWDC 2026)+報道 |
量子化フォーマットについては補足しておきます。4bit の候補には MXFP4 と NVFP4 がありますが、アップルが後者を焼くことはまずありません。MXFP4 は OCP(Open Compute Project)の Microscaling 仕様に基づく複数ベンダーの標準で、32要素ブロックと2のべき乗スケール(E8M0)を使います。対して NVFP4 は Blackwell 向けに NVIDIA が定めた独自形式で、16要素ブロックと FP8(E4M3)スケールを採り、OCP は標準として採用していません。要素の 4bit 表現(S1E2M1)は両者共通ですが、ブロック構造とスケールの持ち方が違うため、演算器の作りが変わります。アップルの選択肢は、MXFP4 に乗るか、MLX がすでに持っているような自社のグループ単位量子化を拡張するか、のどちらかでしょう。
ここに厄介なねじれがあります。2026年半ば時点で、DeepSeek-V4 のように FP4 ネイティブで学習された有力なオープンモデルが NVFP4 を採用しています。つまりアップルが MXFP4 を焼いたとしても、手元に降ってくる重みは NVFP4 かもしれない。形式間の変換自体は可能ですが、メモリ上のレイアウトが異なるため、変換のコストと精度劣化がローカル実行の体感に効いてきます。ハードウェアがどちらを選ぶかという問題は、モデル配布側がどちらを選ぶかという問題と切り離せません。
プロセスノードの食い違いは補足が要ります。M7 base が Intel 18A-P で製造されるという報道群(GF Securities の Jeff Pu、Ming-chi Kuo の分析が源流)がある一方、M6 を TSMC 2nm とする報道もあります。Kuo は「TSMC が 90% を製造し続け、Intel 分の 80% は iPhone 向け」とも述べており、両者は必ずしも矛盾しません。エントリ SoC の分散調達とハイエンドの TSMC 継続という二層構造で読むのが妥当ですが、いずれも報道ベースで未確定です。
サーバ側について。Broadcom と共同開発していた AI サーバ ASIC の Baltra は遅延が報じられ、当面は M5 Ultra ベース(J246)でつなぎ、M7 Ultra ベースのサーバチップは 2029 年とされています。アップルは Broadcom と 300 億ドル超の複数年供給契約(2031年まで)を結んだと報じられており、Baltra(TSMC N3P)にはその技術が組み込まれるとされています。Siri 刷新の際に Gemini を自社の M2 Ultra サーバで動かせず、NVIDIA / Google Cloud を使わざるを得なかったという報道は、アップルのシリコンがこれまでバッテリ駆動機器向けに最適化されてきたことの帰結です。M7 Ultra の「Blackwell 級」という社内表現は、この文脈での目標宣言と読むべきでしょう。
この文脈で押さえておくべきなのが WWDC 2026 の構図です。アップルはオンデバイス側に AFM 3 Core と AFM 3 Core Advanced の二層を置き、クラウド側に AFM 3 Cloud と最上位の AFM 3 Cloud Pro(NVIDIA GPU、Google Cloud 上)を置いて、システムが端末とクラウドを自動で振り分けます。つまりアップルの製品戦略は、2T級のローカル実行を前提にしてはいませんが、オンデバイスの上限を 3B に固定してもいません。この読みに立つと、M7 の Neural Engine 強化の照準は「20B 疎ティアを速く低電力で回し、加えてドラフト/投機の実行基盤にする」あたりに置かれている可能性が出てきます(6.10)。一方で M7 Ultra の 1.5TB とローカル AI 開発への言及(Gurman 報道)は、大規模ローカルも視野にあることを示します。端末は疎モデルと階層で、Ultra とサーバは容量で、という二正面と読むのが現時点の妥当な解釈でしょう。
セキュリティの項目は、逆向きの観察点として使えます。現行アーキテクチャでは NAND へ書かれるブロックはすべて AES-256 XTS で暗号化され、鍵は Secure Enclave 内で SoC に固定されます。重みをフラッシュから毎トークン読む構成では、この復号がクリティカルパスに入る。逆に言えば、アップルがこの経路に手を入れたことが観測できれば、それ自体が A1 の傍証になります。
9. 反証可能な観察ポイント
予想を書きっぱなしにしないために、判定条件を先に決めておきます。2027 年前半までに何が観測されるか。
表中の記号は、3章で三段に分けた仮説A(A2 は7章の二水準に分割)と、4章の仮説B を指します。
- A1:フラッシュがオンパッケージへ移る
- A2-weak:上位層が LBA 列を渡すヒント経路の拡張(既存機構の延長)
- A2-strong:界面が束・締切・投機性・誤り耐性を運び、ANS 側の配置・スケジューリング・ECC がそれに応じて変わる
- A3:NAND が単一コヒーレントアドレス空間に入る
- B:予測器がシリコンに焼かれる(投機デコードなど LLM の予測器のハードウェア化)
一つ注意しておくと、「Foundation Models にオンデバイスの大型ティア(数十B級)が載る」という条件は、WWDC 2026 の AFM 3 Core Advanced ですでに満たされています。ローカルで大きめのモデルを動かす方向への支持ではありますが、それが A1 と A2 のどちらを支持するかは Instruction-Following Pruning の粒度に依存します(6.10)。公式ブログの記述は指示ごと(per prompt)を示していますが、実装の詳細は未公開のため、表には粒度を実装レベルで確かめる項目を置きました。
| 観測 | 効く仮説 | 判定 |
|---|---|---|
| パッケージ解析でインターポーザ上に NAND スタックまたは新規メモリダイが確認される | A1 | 強く支持 |
| LBA 列を渡す先読みヒント API の拡張(F_RDADVISE / F_SPECULATIVE_READ の延長)にとどまる | A2-weak | ほぼ支持にならない(既存機構の延長のため) |
| Metal / Core ML に、束・締切・取り消しを表現できる API 語彙が現れる | A2-strong | 支持 |
| 誤り耐性クラスや読み出し品質の指定が API に現れる | A2-strong | 強く支持 |
| ANS 後継の求人・特許に配置ポリシーや read QoS への言及が出る | A2-strong | 支持 |
| アップル帰属でフラッシュ重みストリーミングの特許が公開される | A2 | 支持 |
| Secure Enclave の復号経路に構造変更が入る | A1 | 弱く支持 |
| NAND が単一アドレス空間に入ったことを示す記述・特許・API が現れる | A3 | 強く支持 |
| Neural Engine が動的形状・tree attention をネイティブ実行できるという記述・特許・求人 | B | 強く支持 |
| 低ビット(int4 / int2、MXFP4 または自社形式)行列積のネイティブ対応が公称される | B | 支持 |
| M7 Max の帯域が単純外挿(約965GB/s)を超えて非線形に飛躍する | A1・B 両方 | 支持 |
| Instruction-Following Pruning の指示ごとの一括ロードが実装レベルでも確認される | A1 | 支持(A2-strong の必要性は低下) |
| 同機構にトークン・層ごとの動的選択が併用されると判明する | A2-strong | 支持 |
| メモリ変更が LPDDR6 化とバス広帯域化のみで、フラッシュ経路は従来 SSD のまま | A1・A2 | 反証 |
| API が現れても LBA ヒント止まりで、下層(配置・スケジューリング・ECC)の記述が変わらない | A2-strong | 反証 |
| Neural Engine 強化が TOPS 増と対応精度の追加のみ | B | 反証 |
| M7 Ultra が 1.5TB の LPDDR で出荷され、フラッシュ階層への言及が皆無 | A1 | 反証 |
| 投機デコードが MLX 上のソフト実装に留まり、専用ハード経路が現れない | B | 反証 |
個人的には、最初に動くのは Core ML / Metal 側の API だと思っています。ハードウェアが先に出て API が後から生えることは稀で、逆に API の形が半年ほど先にハードウェアの輪郭を教えてくれることが多いためです。
10. 本記事の限界
数値と判定の前提を一箇所にまとめておきます。
- ページ16KB・2または4プレーンという仮定は US 12,455,704 B2 の例示に倣ったもので、アップルの実装は公開されていません。ダイ数は本文の16ダイ(公称 14.5GB/s に整合する筆者の仮定)と特許例示の32ダイを併記しましたが、どちらもアップルの構成を示すものではありません。
- 1層あたり 167MB は5章の前提値(10.2GB/token)を61層で割ったものです。config から直接積算すると expert 分だけで約198MB になり、一致しません(6.1)。3.3 の結論はこの差に影響されませんが、6.1 と 6.2 の表の絶対値には影響します。
- 6.2 の削減率 1/10、1/30 は、レジームがどこで切り替わるかを示すための例示です。実現可能性は 6.4(図17)のとおりで、現行技術の到達は 1/9 程度にとどまります。
- 図5 のリード増幅は、要求どうしがページを共有しない最悪ケースを描いています。同時に活性化しやすいニューロンを同じページへ寄せられれば増幅は下がるので、実際の曲線はこれより緩やかになるはずです。その寄せ方こそが配置設計の中身であり、曲線の位置そのものが設計変数です。
- 図18 の中間四値はすべて例示で、実測でも推定でもありません。図19 の両軸は主観的評価です(図8 と同じ性質)。
- 図17 のスパース率はいずれも論文の報告値ですが、モデルもタスクも評価条件もばらばらで、横並びの比較として厳密ではありません。また FFN の活性スパース率であって、そのまま読み量の削減率になるとは限りません(増幅が上乗せされます)。
- 6.5 の局所性の数値は Mixtral 系での測定です。routed expert が256本ある DeepSeek-V3 級での重なり率は測り直す必要があります(絶対的なヒット率は下がる方向)。
- 投機デコードにおける和集合の増加と、実効バッチによるスパース性消失のトレードオフを、SSD 経路のエネルギーで定量化した研究は見つかりませんでした。6.6 の結論は定性的なものです。
- ONFI / Toggle の仕様書、NVMe 仕様の abort 条項、LDPC のソフト判定については、二次文献での確認にとどまり、逐条の一次確認には至っていません。
- ANS2 の内部分担(FTL、ECC、ウェアレベリング、MSP との役割)は一次情報で確定できていません。7.2 の記述は推定を含みます。
- Q4 の重みが許容できるビットエラー率については支持研究が見つかりましたが、いずれも MLC NAND や小規模 DNN が対象で、NAND 上の Q4 LLM 重みの直接実測ではありません(7.1)。
- WWDC 2026 の AFM 3 に関する数値は公式ブログと報道によるもので、完全な技術報告は2026年後半に公開される見込みとされています。Instruction-Following Pruning の選択粒度については一次情報での確認が取れておらず、6.10 の推測はその上に立っています。
- 6.5 の常駐率3割前後という数字は、350GB のモデルと 128GB 機という組み合わせからの単純な引き算で、KV キャッシュの実サイズや OS の使用量を積んだものではありません。
- M7 関連の帯域・時期・容量はすべて報道です(1章)。オンパッケージフラッシュの帯域・エネルギー、M7 Max の帯域は筆者の外挿です。
11. まとめ
- M6 Pro / Max のキャンセルと M7 の前倒しは Bloomberg / Gurman の報道であり、アップルの公式発表ではありません。理由として報じられているのは Neural Engine の大幅強化です。
- 仮説A(重みをフラッシュから供給する)は、三段に分けると評価が分かれます。A3(NAND が単一コヒーレントアドレス空間に入る)は否定してよい。業界最良解の H³ ですら、統一アドレス空間の実体は役割分担と 40MB 級 SRAM バッファによる予測プリフェッチであり、アップルの特許も10年一貫して DRAM 二層どまりでした。A1(オンパッケージ化)は成立しうるものの、効果が小さい。帯域の伸びは tR 次第で 1.0〜1.4 倍、エネルギー削減も1割から数割という不確かな幅にとどまり、単独では世代を飛ばす理由になりません。残る A2(SSD コントローラが重みプリフェッチエンジンへ役割を拡張する)だけが、コヒーレンシ・帯域・エネルギーの三つの制約をすべて生き延びます。三段のうちアップルの構造的優位が直接効くのも A2 だけです。インターポーザは TSMC の技術であり、NAND ダイは購入品で、アップルにしかないのは ANS2 と AppleStorageFirmware、つまり「いつ、何を、どの順で読むか」を決めている層そのものでした。
- ただし本記事で最有力と呼ぶ A2 の中身は、LBA 列を渡すだけの弱い形(A2-weak)ではなく、束・締切・投機性・誤り耐性を界面が運ぶ強い形(A2-strong)です。前者は macOS の既存 API(F_RDADVISE、F_SPECULATIVE_READ)の延長で実現でき、M6 のキャンセルを説明できません。そして A2-strong が実際に要求されるのは、選択的読み出しが成功して読み量が一桁以上減り、帯域律速がレイテンシ律速へ切り替わった後です。現在地は帯域律速で、1層の予算 12ms に対して tR は 75μs、桁が二つ違います。
- その削減は四つの因子の掛け算で決まり、効果の大きい手段の多くはコントローラではなくモデル側にあります。現行の relufication 技術の到達点(89%台)では削減は 1/9 程度にとどまり、レジーム切り替えの目安である 1/30 には届きません。したがって A2 の射程には、垂直統合された自社モデルの範囲内で、という限定が付きます。
- その自社モデル側では、WWDC 2026 の AFM 3 Core Advanced(20B 疎、Instruction-Following Pruning で1〜4B 活性)が、まさに因子1 をモデル側でやる機構として現れました。選択の粒度が指示ごとの一括ロードなら、必要なのは細粒度のプリフェッチ意味論ではなく数 GB の高速一括ロード経路であり、A1 の価値が上がって A2-strong の必要性が下がります。この粒度は2027年の分水嶺の一つです。
- 仮説B(予測器のシリコン化)のほうが、根拠は厚い。ReDrafter から Speculative Streaming、そして Mirror-SD へ至る研究系譜、特に Mirror-SD が投機デコードを GPU / NPU への資源割り当て問題として扱っている点は、シリコン化の直前の兆候です。障壁は動的 tree attention と静的グラフ NPU の相性で、前編8.3の観察ポイントがそのまま生きています。ユニファイドメモリでは投機デコードの前提が崩れるという弱点は、裏返せばアップル固有のハードウェア化動機になります。ただし投機デコードは重み供給に対して、和集合の先読みという追い風と、実効バッチ増によるスパース性消失という逆風の両方を持ちます。
- 定量的には、M7 Max の帯域を約965GB/s(筆者推定)と置くと、モデルが収まる限りデコードは約95 tok/s、prefill は0.4秒級です。収まらない場合の下支えとしてオンパッケージフラッシュが 64〜256GB/s のレンジで入れば、天井は6〜25 tok/s。ただしその帯域レンジは二重に成立しません。アレイ側では 64GB/s に 6〜9TB 級、256GB/s に 25〜37TB 級の NAND が要り、エネルギー側では 256GB/s が現状の NAND で 205W、10pJ/bit の閾値を達成しても 20.5W かかります。容量の観点でフラッシュ階層を必要としているのは下位 SKU ですが、エネルギーの観点でそれを許容できないのも下位 SKU です。必要としている機械には電力がなく、電力のある機械には必要がない。
- 裏返すと、フラッシュ階層が成立する道は帯域を上げることではなく、読む量を減らすことに絞られます。プリフェッチはレイテンシを隠すだけで読む量は減らさず、エネルギーペナルティも緩和しません(arXiv:2508.06978 が明記)。鍵は選択的読み出し、つまり活性の予測を当てて要るものだけを読むことで、これは A2 そのもの、前編8.2の予測器4クラスの第4クラスにあたります。仮説A は仮説B に含まれ、投機デコードのドラフトが出す先読みが重みプリフェッチの予告になります。M7 世代で焼かれるものが一つだとすれば、それは両方の上流にある予測器のほうです。
- M7 Ultra の 1.5TB が実現すれば、その SKU に関してはフラッシュ階層は不要になります。この反論は正しい。ただし供給次第であり、かつコンシューマ機には降りてきません。上位は容量で解き、下位は階層と疎モデルで解くという分岐が、同じ世代の中で同時に起きる可能性があります。
- なお、読み方を賢くする三段(A1・A2・A3)で選択肢が尽きるわけではありません。読まずに済ませる第四の経路(3D NAND PIM / in-flash computing)が研究段階にあり、2027年の候補からは外しますが、エネルギーの壁を別方向から回避しうる経路として視界に置いておきます。
前編で、LLM 推論スタックの現在地を「1993年、初代 Pentium、アウトオブオーダ製品化前夜」と置きました。M7 世代について観測できることを CPU 史の語彙に翻訳すると、こうなります。分岐予測器を専用回路として持つべきかどうかを、各社がそれぞれの理由で決めようとしている段階です。データセンター側は先に固定機能を焼き始めました(TPU 8i の CAE、Rubin CPX)。コンシューマ側で最初に動くのはアップルだろう、というのが続編の予想でした。
M6 Pro / Max のキャンセルは、その予想に対する最初の返事だと考えています。世代を一つ飛ばすというのは、四半期ごとの積み上げをする会社がやることではありません。何かを間に合わせようとしている動きです。
何を間に合わせようとしているのか。2027 年に答え合わせをします。
参考文献(一次ソース)
報道
- Bloomberg / Mark Gurman "Power On"(2026年6月25日、7月12日):M6 Pro/Max/Ultra キャンセル、M7 前倒し、帯域、M7 Ultra 1.5TB・Blackwell 級・2029年サーバ。逐語引用は MacRumors(2026年7月12日)。数値の再掲は Macworld、Tom's Hardware、AppleInsider、VideoCardz。
- Bloomberg(2012年1月11日):Anobit 取得額 約3.9億ドル。
- Reuters(2026年7月10日、SK hynix 米ナスダック ADR 上場デビュー当日の CEO 郭魯正氏発言):2027年が業界史上最悪の供給不足になるとの見通し。
- The Information / Reuters / Engadget:Baltra の遅延、Broadcom との 300 億ドル超の複数年供給契約(2031年まで)、AI チップ企業買収検討、Siri で NVIDIA / Google Cloud を使用した件。
- プロセスノード関連:AppleInsider(Intel 18A-P テスト)、Tom's Hardware(M6 TSMC 2nm)、Ming-chi Kuo および GF Securities Jeff Pu の分析、AppleInsider(TSMC A14 1.4nm、2028年)。いずれも報道・アナリスト分析であり未確定。
- CNBC(2026年6月8日)ほか WWDC 2026 報道:最上位 AFM 3 Cloud Pro を NVIDIA GPU(Google Cloud)上で提供。オンデバイス側の二層構成(AFM 3 Core / AFM 3 Core Advanced)の内訳は下記の Apple Machine Learning Research ブログによる。
- OCP Microscaling Formats(MX)仕様、および NVIDIA Technical Blog "Introducing NVFP4 for Efficient and Accurate Low-Precision Inference":MXFP4(32要素ブロック / E8M0)と NVFP4(16要素ブロック / FP8 E4M3)の差
公式・第三者解析
- Apple Newsroom(2026年3月3日発表、3月11日発売):M5 Pro / M5 Max、Fusion Architecture、SSD 最大14.5GB/s、614GB/s。
- Apple Machine Learning Research ブログ(2026年6月、WWDC 2026):AFM 3 世代の構成。オンデバイス側は AFM 3 Core(3B 密)と AFM 3 Core Advanced(20B 疎、Instruction-Following Pruning により1〜4B を活性化、活性化率5〜20%、活性の固定はプロンプトごと)、クラウド側は AFM 3 Cloud / ADM 3 Cloud / AFM 3 Cloud Pro。6.10 と 8章の記述の根拠
- TechInsights:Apple M5 Pro(APL1X15)パッケージ解析。TSMC SoIC-X face-to-face ハイブリッドボンディング、シリコンインターポーザ。
- Asahi Linux 由来の解析(Notebookcheck、Jeff Geerling、LWN 経由):ANS2、NVMe 風独自実装(Linux は専用ドライバ nvme-apple)、生 NAND と MSP。
- Darwin / XNU の bsd/sys/fcntl.h:F_RDADVISE(44)、F_RDAHEAD(45)、F_NOCACHE(48)、F_SPECULATIVE_READ(101)の定義。7.3 の「A2-weak 相当のヒント経路は既存」の根拠
- NVIDIA Blackwell B200 データシート:180GB HBM3e / 7.7TB/s。
- SanDisk Newsroom(2025年8月6日、2026年2月25日):HBF、SK hynix との MOU、OCP 標準化キックオフ。HBF ファクトシートに Gen1 の 1.6TB/s・256Gb/ダイ・16ダイスタックで 512GB の記載
- Kioxia / SanDisk(2025年):Toggle DDR6.0、4.8Gb/s、PI-LTT による入力電力10%・出力電力34%削減
- キオクシア公式リリース(2025年8月20日):5TB・64GB/s 高帯域フラッシュモジュール試作。シーケンシャルアクセス中の先読みでレイテンシを縮めるフラッシュプリフェッチ技術をコントローラに実装、と記載。NEDO Post-5G 事業(JPNP20017)
- Micron TN-29-19:NAND の cache read(read page cache)によるパイプライン化。SLC/旧世代での効果値
- 9to5Mac / MacRumors(2022年7月14日):M2 MacBook Pro 256GB 構成の SSD 実測 読み込み 1,446MB/s、512GB 以上は複数 NAND チップで並列化され高速
- Tom's Hardware:アップルは base チップで SSD に4レーン、Pro/Max/Ultra で8レーンを割り当てる(PCIe 世代は非明示)。および HBF のロジックダイ構成に関する報道
特許
- US 12,455,704 B2(Micron Technology)「Memory system and method of controlling nonvolatile memory」。発明者 Wenjun Wu。日本出願 2022-202322(2022年12月19日)を優先権として2023年9月6日に米国出願、2025年10月28日登録。読み出し帯域 = (1/tR) × ページサイズ × ダイ総数 × プレーン数 という定式化と、16KiB ページ・最大32ダイの例示は、この明細書の詳細説明による(請求項ではない)
- US 10,573,368 B2 ほかファミリー(US 10,916,290 / 11,468,935 / 11,830,534 / 12,243,575)"Memory System Having Combined High Density, Low Bandwidth and Low Density, High Bandwidth Memories"、Apple Inc.、発明者 Sukalpa Biswas / Farid Nemati、優先日 2016年6月27日。対象は DRAM 二層。
- US 10,691,537 "Storing deep neural network weights in non-volatile storage systems using vertical error correction codes":DNN が重み誤りに頑健であることを前提に、許容精度に応じた誤り量を許す ECC 構成。7.1 の誤り耐性の議論で参照
論文
- Alizadeh et al.(Apple)"LLM in a flash: Efficient Large Language Model Inference with Limited Memory" arXiv:2312.11514(ACL 2024)
- "ActiveFlow" arXiv:2504.08378:active weight の DRAM・フラッシュ間スワッピングによるオンデバイス LLM のスケールアップ
- Apple ML Research "Mirror Speculative Decoding: Breaking the Serial Barrier in LLM Inference" arXiv:2510.13161(2025年10月投稿)
- Apple ML Research "Recurrent Drafter for Fast Speculative Decoding in Large Language Models"(ReDrafter)、および NVIDIA TensorRT-LLM 統合に関する Apple ML Research ブログ
- Apple "Apple Intelligence Foundation Language Models: Tech Report 2025" arXiv:2507.13575:第2世代 AFM。オンデバイス約3B は KV キャッシュ共有と2ビット QAT の密モデル、サーバ側は PT-MoE。6.10 の記述の根拠
- "Efficient Mixture-of-Experts LLM Inference with Apple Silicon NPUs" arXiv:2604.18788
- "Cross-Family Speculative Decoding for Polish Language Models on Apple Silicon" arXiv:2604.16368
- Kyung, Yun, Ahn(ソウル大学)"SSD Offloading for LLM Mixture-of-Experts Weights Considered Harmful in Energy Efficiency" arXiv:2508.06978、IEEE Computer Architecture Letters 2025(DOI:10.1109/LCA.2025.3592563)。フラッシュ 102.4pJ/b、DDR5-7200 9.2pJ/b、HBM3 4.2pJ/b の内訳と 10pJ/b 閾値の導出は Fig.2 および Fig.6、バッチサイズ別の DRAM 対 SSD エネルギー比(Mixtral-8x7B で 3.8〜12.5倍、DeepSeek-R1 で 4.7〜9.8倍、CPU 実行比 2.1〜3.6倍)、プリフェッチがエネルギーペナルティを緩和しないという明記、投機デコードを実効バッチ増として脅威と位置づける議論は本文による。5.3 と 6.6 の根拠
- V. Mohan, S. Gurumurthi, M. R. Stan "FlashPower: A detailed power model for NAND flash memory" DATE 2010。上記論文が内部フラッシュ読み出しエネルギーの根拠として参照しているモデル
- "KVNAND: Efficient On-Device Large Language Model Inference Using DRAM-Free In-Flash Computing" arXiv:2512.03608。フラッシュのインターフェースアクセス 4.9pJ/bit、内部読み出し 3pJ/bit という配分の出典。in-flash computing(3.5 の経路3)の研究でもある
- "NVLLM" arXiv:2604.25699:3D NAND を中心に据えたエッジ LLM 推論アーキテクチャの提案(3.5)
- Jang et al. "3D NAND Flash Based Processing-in-Memory for Single-Batch LLM Token Generation" arXiv:2511.12860(2025年11月17日):単バッチのトークン生成を 3D NAND flash PIM にオフロード。RTX4090 4枚 + vLLM 構成比 2.4倍、A100 4枚比レイテンシ増 4.9%、追加 4.98mm² のダイ面積で統合可能との報告(3.5)
- "MemExplorer: Navigating the Heterogeneous Memory Design Space for Agentic Inference NPUs" arXiv:2604.16007。HBF スタックを約384GB / 約1TB/s、e_read 約6pJ/bit と見積もる第三者評価
- "Proxima: Near-storage Acceleration for Graph-based Approximate Nearest Neighbor Search in 3D NAND" arXiv:2312.04257。96層 3D NAND の tR を 15〜90μs とする
- "TileLens" arXiv:2607.04031(H³ の LHB 規模の評価)
- "BuddyMoE"(Yun Wang ほか)arXiv:2511.10054(2025年11月13日):メモリ制約下の MoE 実行で重み転送が推論レイテンシの85〜94%を占めるとの報告。co-activation パターンによる buddy expert 代用機構(6.4)
- "ProSparse: Introducing and Enhancing Intrinsic Activation Sparsity within Large Language Models" arXiv:2402.13516(COLING 2025):relufication で LLaMA2-7B 89.32%、LLaMA2-13B 88.80%、MiniCPM-1B 87.89% のスパース率を同等性能で達成。ReluLLaMA の比較値も同論文(6.4)
- Mirzadeh et al.(Apple)"ReLU Strikes Back: Exploiting Activation Sparsity in Large Language Models" arXiv:2310.04564:ReLU 化 Falcon-7B(スパース率95%)と約60%回復時の精度低下約1%の報告(6.4)
- "Mixtral of Experts" arXiv:2401.04088:The Pile 上での expert 選択の位置的局所性(6.5)
- arXiv:2511.05814:連続トークン間の expert 重なり率の定量化(ランダム12.5%に対し時に約30%)(6.5)
- arXiv:2512.16473:層方向の局所性。約44%が前ブロックと同じ expert ID(6.5)
- "ReMoE" arXiv:2605.27081:ルータ微調整による expert 再利用の26%改善(6.5)
- "MoEpic" arXiv:2509.08342:expert 活性の long-tail 分布と時間局所性の報告(6.5)
- "MoESD" arXiv:2505.19645:MoE における投機デコードで中程度のバッチでもほぼ全 expert が活性化し、プリフェッチとキャッシュが効かなくなるとの報告(6.6)
- DeepSeek-AI "DeepSeek-V3 Technical Report" arXiv:2412.19437:671B、routed expert 256本、活性 37B など、5章と 6.4 の前提値
- M. Hasan, B. Ray "Tolerance of Deep Neural Network Against the Bit Error Rate of NAND Flash Memory" IRPS 2019:ECC 無効の MLC NAND で、5年未満の保持・約100 P/E・30k 回未満のリードストレス条件下なら DNN 精度が許容水準を保つとの報告(7.1)
- 竹内健らの Computational Approximate Storage(Flash Memory Summit 2019):3D-TLC の誤り許容を積極的に利用する近似ストレージの提案(7.1)
- "Prolonging 3D NAND SSD lifetime via read latency relaxation" ASPLOS 2021:読み出しのみの低負荷ワークロードでも read disturbance 起因の再書き込みが背景で走り、保証期間内に摩耗しうるとの報告(7.1)
- "Reducing Solid-State Drive Read Latency by Optimizing Read-Retry" ASPLOS 2021:read-retry がレイテンシを押し上げることの実測(7.1)
- SNIA SDC における WARP による NVMe FDP 評価:敵対的な3ストリーム構成で FDP 有効でも書き込み増幅が 4.49倍 / 2.58倍に達し、要因はベンダ固有のファームウェア方針にあるとの報告(7.1)
- LLM in a flash の I/O 段階分解(約2.2秒 → 約87ミリ秒)の数値集計は二次解説(TECH VEDA)による
- Ha, Kim, Kim(SK hynix)"H³: Hybrid Architecture Using High Bandwidth Memory and High Bandwidth Flash for Cost-Efficient LLM Inference" IEEE Computer Architecture Letters, 2026. DOI:10.1109/LCA.2026.3660969
- mlx-lm Discussion #890:Apple Silicon 上の EAGLE-3 実装に関する実測報告
関連記事
- NAND の帯域はどこで決まるのか ― ダイ枚数・プレーン数・tR と、Mac の SSD が容量で速くなる理由(本記事 3.3 の詳細)
シリーズ過去記事
- M5 Max はなぜ 2ダイ でも Unified Memory を保てるのか
- 2TパラメータのLLMはいつ100GBに収まるか ― LLM推論のメモリ階層管理はCPUマイクロアーキテクチャ史を再演している
- 続・2TパラメータのLLMは100GBに収まるか ― SSD退避の天井とHBF、問題は「容量」から「帯域とエネルギー」へ