
本記事の調査・検証の設計にはAnthropic Claude(リサーチ機能)を、環境構築と計測の実作業にはClaude Codeを利用しています。記載の数値は2026年8月2日時点・手元環境での単発測定であり、ブランチは活発に開発中のため、お試しの際は最新のREADMEとモデルカードをご確認ください。
はじめに
注文していたM5 Max 128GBのMacBook Proがやっと届きました。届いたその週末に、ちょうど良すぎるタイミングの出来事が重なりました。7月31日にDeepSeek V4 Flashの正式版である0731がリリースされ、翌8月1日にはantirez氏(Redisの作者、現在はDwarfStar推論エンジンを開発中)が「ロスレスMXFP4版のGGUF」をHugging Faceに公開し、それを動かすためのブランチをGitHubにpushしました。
145GiBのモデルは128GBのメモリに載りません。それをSSDストリーミングで、量子化劣化ゼロのまま動かすというのがこの構成の眼目です。本記事は、その環境構築と実測の記録です。結論だけ先に書くと、ウォーム状態の生成で18〜20 t/s、バルクプレフィルで約194 t/sが出ました。あわせて、自動キャッシュ計算の意外な仕様や、DSpark(投機デコード)との排他制約など、実際に動かして初めて分かったことをまとめます。
DwarfStar量子化版そのものの背景は、過去記事で扱っています。
- DeepSeek V4 Flash の Dwarf Star 量子化版について調べてみた
- MoEは1トークンをこう計算しています ― DeepSeek V4 Flash / Dwarf Star量子化版で追う計算フローとQ4層を増やす試算
なお、本記事の数値はすべて手元環境での単発測定です。統制されたベンチマークではない点にご留意ください。
結果サマリ
| 項目 | 結果 |
|---|---|
| モデル | DeepSeek V4 Flash 0731 / MXFP4Experts版GGUF(145.3 GiB) |
| エンジン | DwarfStar(ds4)ds4f-mxfp4ブランチ、コミット4893e0c |
| マシン | MacBook Pro M5 Max / 128 GiB / macOS 26.6 / Metal |
| 実行方式 | --ssd-streaming(自動キャッシュ: 動的71.43 GiB + プレフィル予約6.38 GiB) |
| 生成(ウォーム) | 18.02 t/s(平均)、区間最大20.55 t/s |
| バルクプレフィル | 194.19 t/s(19,319トークン、コールド) |
| ctx 512K運用時の計画メモリ | 87.17 GiB(128 GiBに収まる) |
| DSpark併用 | 不可(--ssd-streamingと--mtpがエンジン初期化で排他) |
ロスレスMXFP4とは何か
まず「ロスレスな量子化版」という一見矛盾した表現の種明かしです。
DeepSeek V4 FlashはFP4の量子化認識学習(QAT)で学習されており、公式チェックポイント自体が、ルーテッドMoEエキスパート(モデルの約9割強)をネイティブにMXFP4形式で保存しています。MXFP4はOCP Microscaling仕様の4bit浮動小数(E2M1)に、32要素ブロックごとのE8M0共有スケールを付けた形式で、実効4.25 bit/weightです。つまり公式重みが最初から4bitなので、MXFP4のままGGUFに詰め直せば、それはビット単位で公式チェックポイントと同一になります。後段量子化ではなく再パッケージです。
この点はUnslothのドキュメント(2026年8月1日参照)が明快で、公式チェックポイントはルーテッドエキスパートをネイティブMXFP4、それ以外をFP8/BF16で保存しており、全1,328テンソルが公式重みとビット同一のまま推論時もロスレス(KLダイバージェンス約0、top-token一致率100%)と報告されています。
今回使うantirez氏のds4向けGGUFは、ファイル名がそのまま仕様書になっています。
| テンソル群 | 精度 | 備考 |
|---|---|---|
| ルーテッドエキスパート(gate/up/down) | MXFP4 | 公式重みとビット完全 |
| HC / Compressor / Indexer | F16 | |
| Attention / Shared Expert / Output | Q8_0 |
ファイル名は DeepSeek-V4-Flash-MXFP4Experts-F16HC-F16Compressor-F16Indexer-Q8Attn-Q8Shared-Q8Out-chat-v2-mxfp4-0731.gguf、実測サイズは155,976,458,848バイト(145.3 GiB)でした。
一点だけ重要な注意があります。同じ「MXFP4」を名乗っていても、Unsloth等のllama.cpp形式GGUFとds4形式GGUFはテンソルレイアウトが別物で、相互に読めません。ds4で動かすのはantirez/deepseek-v4-ggufリポジトリのds4レイアウト版のみです。
ds4f-mxfp4ブランチ
MXFP4版GGUF自体は8月1日にHugging Faceへ追加されましたが、その時点のds4本体(main)はGGUF type 39(MXFP4)を読めず、ロード時にクラッシュしていました(issue #641)。これに対応するのがds4f-mxfp4ブランチで、日本時間8月1日午前に4本のコミットがpushされています。
| コミット | 内容 |
|---|---|
| 725b084 | ロスレスMXFP4 GGUF変換の追加 |
| 1f862bd | MXFP4 GGUFフォーマットとスカラー参照実装 |
| 7bec128 | Metal向けMXFP4エキスパート推論 |
| 4893e0c | プレフィル済み層からストリーミング用エキスパートキャッシュをシード |
2026年8月2日時点でmainには未マージです。またMXFP4推論カーネルはMetalのみの実装で、CUDA/ROCm側にはまだ入っていません。CPU側はテスト用のスカラー参照実装のみです。Linux + NVIDIA GPU環境で試したい方は、上流の対応を待つ必要があります。
セットアップ
worktreeで既存環境を壊さない
手元には動作実績のあるq2版(80.76 GiB、完全常駐)の環境がすでにあるので、これを壊さないようgit worktreeで別ディレクトリにブランチを展開しました。
cd dwarfstar
git remote add antirez https://github.com/antirez/ds4
git fetch antirez ds4f-mxfp4
git worktree add ../dwarfstar-mxfp4 antirez/ds4f-mxfp4
失敗してもディレクトリごと消せば元通り、という保険です。ビルドは make 一発(-j18、警告・エラー0件)で、付属のMXFP4テストも両方PASSしました。
$ make test-mxfp4-metal
ds4: Metal device Apple M5 Max, 128.00 GiB RAM
MXFP4 Metal fused MoE: PASS

$ make mxfp4-dot-test
4/4 tests passed
ダウンロード
download_model.shにはmxfp4ターゲットがまだ無いため、本体はcurl -C -(resume可)で直接取得しました。145.3 GiBで23分26秒、約106 MB/sでした。HTTPの申告サイズとローカルのバイト数が完全一致することを確認してから先に進みます。DSpark support GGUF(5.58 GiB)も後述の検証用に取得しました。
SSDストリーミングの仕組みと自動キャッシュ
145.3 GiBのモデルは128 GiBに載らないので、--ssd-streamingが必須です。ds4のストリーミングは、非ルーテッド重み(attention、shared expert、router等)を常駐させ、ルーテッドエキスパートだけをメモリ上のLRUキャッシュ経由でSSDから供給する設計です。
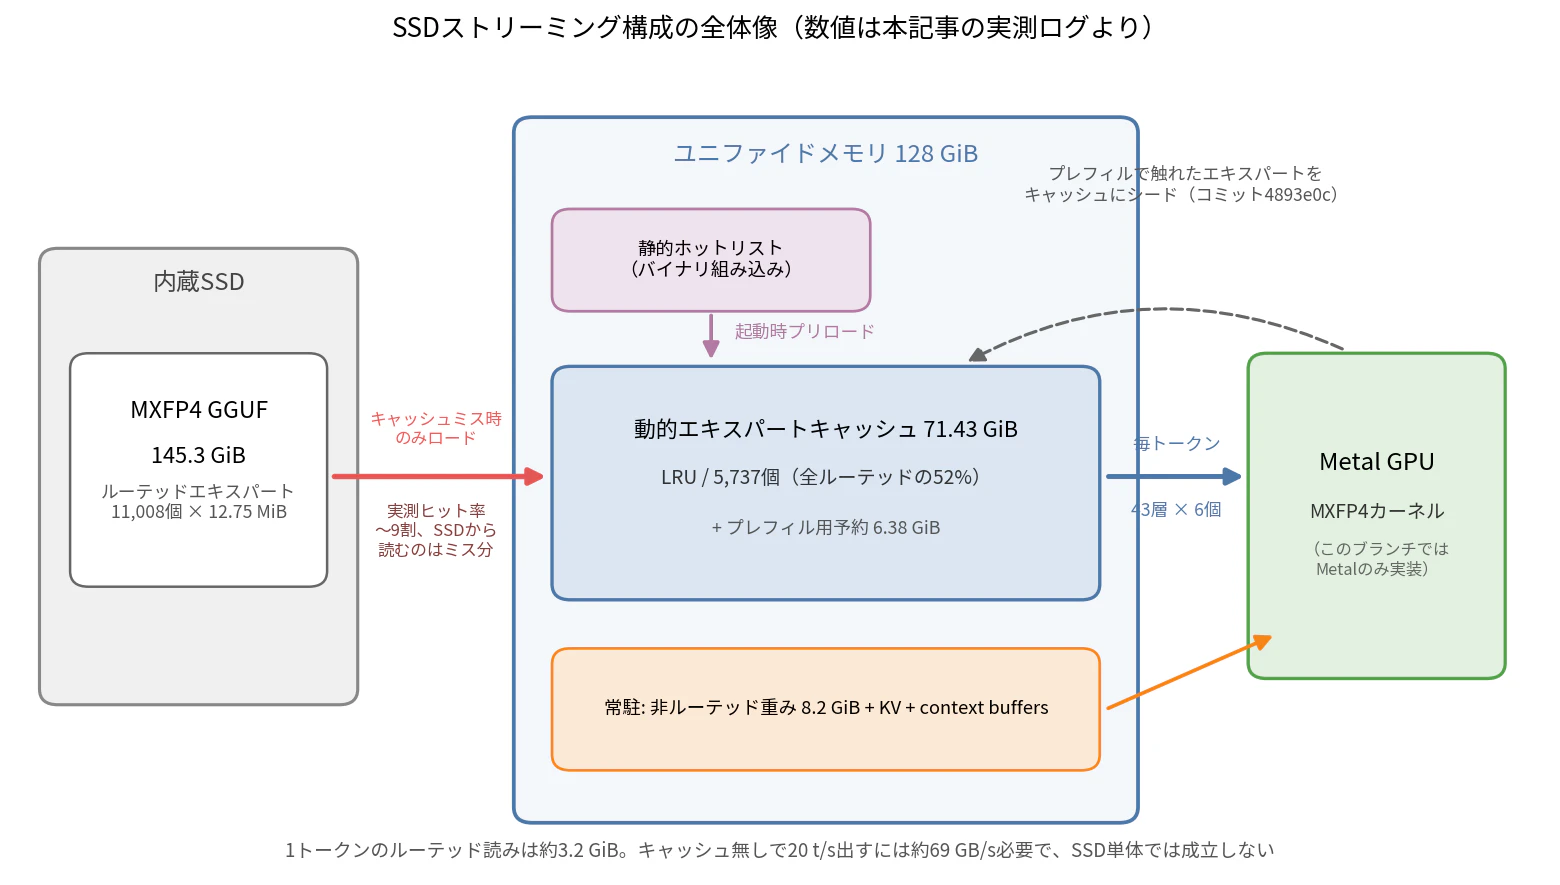
キャッシュサイズは無指定なら自動計算されます。起動ログにその内訳が出ます。
ds4: SSD streaming auto cache budget
ds4:   metal recommends 107.52 GiB working set
ds4:   using 80% total for model + cached experts: 86.02 GiB
ds4:   non-routed weights: 8.20 GiB
ds4:   routed expert size: 12.75 MiB
ds4: metal SSD streaming total expert budget 77.81 GiB
     = 6.38 GiB prefill headroom + 71.43 GiB dynamic cache (5737 experts)
式にすると、Metalの推奨ワーキングセット(このマシンで107.52 GiB)の80%から非ルーテッド重みを引き、残りを1エキスパート12.75 MiB単位のスロット数に換算、さらにオーバーラップ・プレフィル用に2層分を予約する、という流れです。80%という係数は環境変数 DS4_SSD_AUTO_CACHE_PCT(50〜95)で変更できます。
発見: 自動キャッシュはKVを考慮しない
ここで意外な仕様に気づきました。コンテキスト長を32Kから512Kまで上げても、自動キャッシュはまったく縮みません。
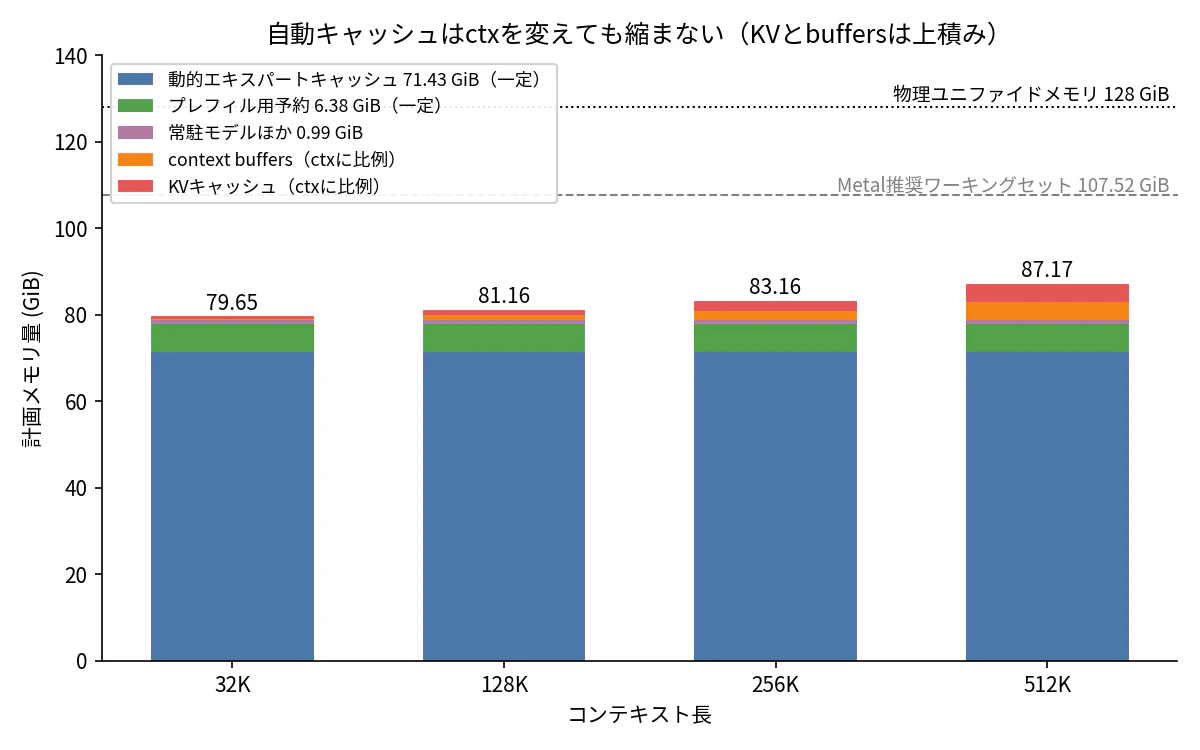
| ctx | KV | context buffers | エキスパートキャッシュ | 合計(計画値) |
|---|---|---|---|---|
| 32,768 | 0.61 GiB | 0.25 GiB | 71.43 GiB | 79.65 GiB |
| 131,072 | 1.36 GiB | 1.00 GiB | 71.43 GiB | 81.16 GiB |
| 262,144 | 2.36 GiB | 2.00 GiB | 71.43 GiB | 83.16 GiB |
| 524,288 | 4.37 GiB | 4.00 GiB | 71.43 GiB | 87.17 GiB |
自動計算は推奨ワーキングセットの80%から非ルーテッド重みを引くだけで、KVとcontext buffersはその上に積み増しになります。V4 FlashはKVが圧縮アテンションで極めて軽い(512Kでも4.37 GiB)ため今回は余裕で収まりましたが、DS4_SSD_AUTO_CACHE_PCTを攻める場合はKV分を自分で差し引いて見積もる必要があります。512K運用中のシステム状態はメモリ空き88%、swap使用55 MBで、実害はありませんでした。
実測結果
生成: キャッシュが温まるにつれ速くなる
サーバー経由(Claude Code互換の/v1/messagesエンドポイント)で239トークンを生成させたときの推移です。

序盤15.08 t/sから区間最大20.55 t/s、平均18.02 t/sでした。この右肩上がりのカーブこそがSSDストリーミングの挙動そのもので、生成が進むにつれてLRUキャッシュのヒット率が上がっていく様子が数字に出ています。
プレフィル: ストリーミングでも約194 t/s
Claude Codeのシステムプロンプト相当の19,319トークン(コールド、KVキャッシュなし)を投入した結果です。
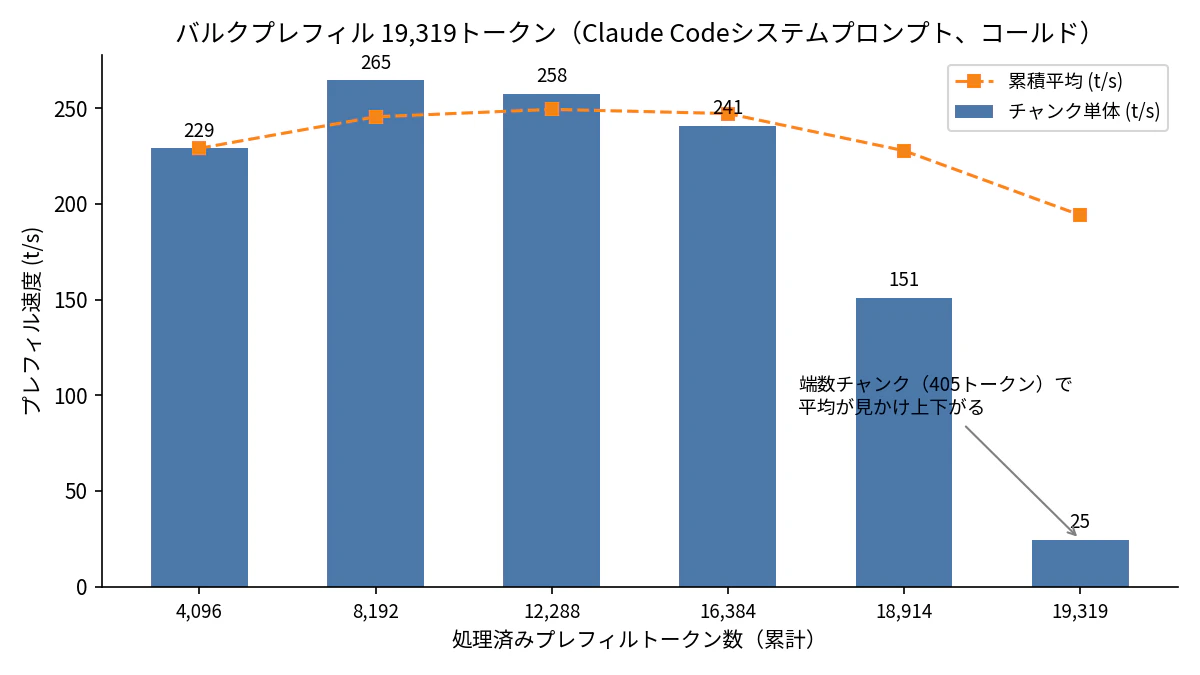
定常チャンクは229〜265 t/sで、平均194.19 t/sは最後の端数チャンク(405トークン)に引きずられた見かけの値です。プレフィルが生成よりストリーミングの影響を受けにくいのは、チャンク内の多数のトークンが同一のエキスパート読み込みを共有できることと、現在層の計算中に次層のロードを重ねて隠蔽する設計のためと考えられます。
なお、20トークン程度の短いプロンプトで測るとプレフィルは3.47 t/sと出ますが、これは固定オーバーヘッドが支配的なだけで実効値ではありません。q2でも同じ現象が起きます。
なぜSSDから読みながら20 t/s出るのか
正直に言うと、私は最初この数字を疑っていました。算数で検証してみます。
起動ログから、1エキスパートは12.75 MiBです。V4 Flashは256エキスパート×43 MoE層で計11,008個、総量は約137 GiBとなり、ファイルサイズ145.3 GiBから非ルーテッド8.2 GiBを引いた値とほぼ一致します。1トークンの推論では各層でtop-k 6個のルーテッドエキスパートを使うので、触る重みは43層×6個×12.75 MiB、約3.2 GiB/トークンです。
もし全部SSDから読むなら、20 t/sには約69 GB/sの帯域が必要で、内蔵SSD(6〜8 GB/s級とされます)では物理的に不可能です。逆算すると、実測値はキャッシュヒット率でこう説明できます。

序盤の15.08 t/sはヒット率約87%、温まり後の20.55 t/sは約91%に相当します(SSD実効6.5 GB/sの仮定値。実測はしていません)。キャッシュに載っているのは5737個、全体の52%に過ぎないのに9割前後のヒット率が出るのは、エキスパートのルーティング分布が強く偏っているためと考えられます。ds4はこれを3段構えで拾いにいきます。
- 静的ホットリスト: プロファイル実行から生成した層×エキスパートの頻度順リストがバイナリに組み込まれており、起動時にキャッシュ予算分だけ上位からプリロードされます
- LRU: 実行中のアクセスに応じて動的に入れ替わります(セッション内のみ。プロセスを落とすと消えます)
- プレフィルからのシード: ブランチ先頭コミット4893e0cの機能で、プレフィルで触れたエキスパートをそのまま生成用キャッシュの種にします
なおホットリストは自動では更新されませんが、エキスパート局所性プロファイラで自分のワークロードの使用統計をファイルに書き出し、環境変数 DS4_METAL_STREAMING_EXPERT_HOTLIST で読み戻す手動ループが実装されています。SystemVerilog/UVMのような特定ドメイン中心の使い方なら、コールドスタート直後のヒット率を底上げできる余地があり、これは別途試したいところです。
q2との比較
同じマシンで運用しているq2版(IQ2_XXS/Q2_K混成、完全常駐)との比較です。

| q2 | mxfp4 | 比 | |
|---|---|---|---|
| GGUFサイズ | 80.76 GiB | 145.3 GiB | 1.80倍 |
| 実行方式 | 完全常駐 | SSDストリーミング | |
| バルクプレフィル | 406.5 t/s | 194.19 t/s | 48% |
| 生成(ウォーム) | 29〜38 t/s | 18.02 t/s | 47〜62% |
| ctx 512K時の合計メモリ | 約89 GiB | 87.17 GiB | ほぼ同等 |
| ルーテッドエキスパートの量子化誤差 | あり | ゼロ(公式重みとビット同一) |
速度はおおむね半分、引き換えにルーテッドエキスパートの量子化誤差がゼロになる、という構図です。ただし出力品質の差は今回計測していません。MXFP4がロスレスというのは構成上の性質であって、実タスクでq2に対してどれだけ効くかは別の問題です。手元のSystemVerilog/UVMコード生成ベンチマークで、同一APIから切り替えられる利点を活かしたA/B比較を予定しています。
判明した制約: MXFP4とDSparkは併用できない
もう一つ、動かして初めて分かった制約です。0731にはDSpark(投機デコード)用のMTPヘッドが同梱されており、対応するsupport GGUFで生成を加速できるはずでした。ところが実行すると即座にエラーで落ちます。
ds4: --ssd-streaming is not compatible with --mtp yet
ソースを確認すると、エンジン初期化で--ssd-streamingと--mtpが無条件に排他されていました(dwarfstar-mxfp4/ds4.c:56156-56163)。MXFP4版は145.3 GiBあり、このマシンでは--ssd-streaming無しでは載らないため、現状このブランチではDSparkを使う手段がありません。上流の対応待ちです。
副産物として一つ確定的に言えることがあります。antirez氏が X で報告していたMXFP4 + SSDストリーミングでの20 t/s超という数字は、コード上DSparkを併用できない以上、投機デコード抜きの素の値だったことになります。ストリーミングとルーティング局所性だけであの数字が出る、というのは実測とも整合します。
感想: SSDストリーミングは実用になるのか
少し使い込んでから記載します。
まとめ
- DeepSeek V4 Flash 0731のネイティブMXFP4重みは、ds4f-mxfp4ブランチ + ds4レイアウトのGGUFで、量子化劣化ゼロのままM5 Max 128GBで動きました
- 実測はウォーム生成18〜20 t/s、バルクプレフィル約194 t/s。ctx 512Kでも計画メモリ87.17 GiBに収まります
- 20 t/sの正体は、1トークン約3.2 GiBのルーテッド読みをヒット率9割前後のエキスパートキャッシュで捌く構図でした。静的ホットリスト、LRU、プレフィルシードの3段構えが効いています
- 自動キャッシュはKVを考慮しない、DSparkはストリーミングと排他、MXFP4カーネルはMetalのみ、という3つの制約には注意が必要です
- 同一ドメインで使い込む個人用途なら、SSDストリーミングは既に実用域という手応えでした。コールド初回の重さはKVのディスク永続化で「一度だけ払う税」になります
- 公式リリースから48時間、ブランチのpushから丸1日で、ロスレスの284Bモデルがラップトップで動く時代になりました
フロンティア級モデルがネイティブFP4で学習・配布される流れ(gpt-ossのMXFP4、Kimi K3のMXFP4学習、そして本件)が続くなら、「量子化を選ぶ」のではなく「配布重みをそのまま動かす」ローカルLLM運用が一つの標準形になっていくのかもしれません。
参考リンク(参照日: 2026-08-02)
- antirez/ds4 ds4f-mxfp4ブランチ(先頭コミット4893e0c、2026-08-01 push)
- antirez/deepseek-v4-gguf(MXFP4版はコミット1cd7b56「Add DeepSeek V4 Flash 0731 MXFP4 GGUF」、2026-08-01)
- antirez/ds4 issue #641(MXFP4版が当時のランタイムで読めなかった経緯、2026-08-01)
- Unsloth: DeepSeek-V4 How to Run Locally(ネイティブMXFP4とビット同一性の検証報告)
- deepseek-ai/DeepSeek-V4-Flash-0731(2026-07-31リリース、MITライセンス)
- 過去記事: DwarfStar量子化版の調査 / MoEの1トークン計算フロー