
AIキャラクター「ジピ」の短編を作り直す中で、ナレーションに合わせて口を開閉する最小の仕組みをPythonで実装しました。
本記事では、同じ位置に描かれた開口・閉口のPNG 2枚と、WAV 1本からMP4を作るコードを掲載します。生成AIサービスやAPIキーは不要です。自作のイラストでも使えます。
これは音量に反応する二態の口パクです。音素認識、母音ごとの口形、Live2Dのような連続変形は行いません。
動作確認した環境
Windows、Python 3.12.9、NumPy 2.2.6、Pillow 11.1.0、FFmpeg 7.1で確認しました。記事用のコードを実際の約69.09秒のナレーションとPNG差分で実行し、MP4を生成して全編のデコードエラーがないことを確認しています。別OSでの実行は未確認です。
python -m pip install numpy==2.2.6 Pillow==11.1.0
ffmpeg -version
FFmpegは別途インストールし、PATHを通してください。libx264 とAACエンコーダーが使えるビルドを想定します。
入力ファイルの条件
demo/
  article-mouth-demo.py
  narration.wav
  open.png
  closed.png
- WAVは非圧縮16-bit PCM。BGMを混ぜる前のナレーションを使用します。
- PNGは同じキャンバスサイズで、体・頭・口の位置が一致しているもの。透過PNGを推奨します。
- 開口・閉口以外の差分が大きいと、口パクのたびに顔や体も揺れて見えます。
音声形式が違う場合は、元ファイルを残して変換できます。
ffmpeg -n -i voice-source.wav -c:a pcm_s16le narration.wav
-n は既存の出力ファイルを上書きしない指定です。変換元と変換先には別の名前を指定します。
完全な最小コード
以下を article-mouth-demo.py として保存します。この記事用に本編レンダラーから口パク部分を独立させた例で、字幕や場面転換は含みません。
from pathlib import Path
import math
import subprocess
import sys
import wave
import numpy as np
from PIL import Image

# Usage: python article-mouth-demo.py narration.wav open.png closed.png output.mp4
wav_path, open_path, closed_path, output = map(Path, sys.argv[1:])
with wave.open(str(wav_path), 'rb') as wf:
    if wf.getsampwidth() != 2 or wf.getcomptype() != 'NONE':
        raise ValueError('Use an uncompressed signed 16-bit PCM WAV')
    rate, channels = wf.getframerate(), wf.getnchannels()
    samples = np.frombuffer(wf.readframes(wf.getnframes()), dtype='<i2')
    samples = samples.astype(np.float32).reshape(-1, channels) / 32768.0
if len(samples) == 0:
    raise ValueError('Empty WAV')
images = [Image.open(p).convert('RGBA') for p in (closed_path, open_path)]
if images[0].size != images[1].size:
    raise ValueError('Mouth variants must have identical canvas dimensions')
width, height, fps = 640, 360, 24
rendered = []
for image in images:
    image.thumbnail((320, 320), Image.Resampling.LANCZOS)
    canvas = Image.new('RGB', (width, height), '#123b40')
    canvas.paste(image, ((width-image.width)//2, height-image.height), image)
    rendered.append(canvas.tobytes())
duration = len(samples) / rate
cmd = ['ffmpeg', '-hide_banner', '-loglevel', 'error', '-n',
       '-f', 'rawvideo', '-pix_fmt', 'rgb24', '-s', f'{width}x{height}',
       '-r', str(fps), '-i', '-', '-i', str(wav_path),
       '-c:v', 'libx264', '-pix_fmt', 'yuv420p', '-c:a', 'aac',
       '-movflags', '+faststart', '-shortest', str(output)]
proc = subprocess.Popen(cmd, stdin=subprocess.PIPE)
try:
    for frame in range(math.ceil(duration * fps)):
        start = int(frame * rate / fps)
        stop = min(len(samples), int((frame + 1) * rate / fps))
        block = samples[start:stop]
        # RMS over channels too: opposite-phase stereo does not cancel.
        rms = float(np.sqrt(np.mean(block ** 2))) if block.size else 0.0
        opened = rms > 0.025 and int(frame / fps * 9) % 3 != 0
        proc.stdin.write(rendered[int(opened)])
finally:
    proc.stdin.close()
    code = proc.wait()
if code:
    raise RuntimeError(f'ffmpeg exited with {code}')
print(f'Created {output}; source audio: {duration:.3f}s')
実行します。
python article-mouth-demo.py narration.wav open.png closed.png output.mp4
出力は640×360、24fps、H.264/AACです。画像とFFmpegが開いている状態で最後まで処理するため、画像の縦横比は2枚で揃えてください。音声が長いほど処理時間も増えます。
音量判定で注意した3点
1. 二乗する前にfloatにする
16-bit整数をそのまま二乗するとオーバーフローします。コードでは float32 に変換した後、32768で割っておおむね−1〜1の範囲へ正規化しています。
2. ステレオを先に単純平均しない
逆位相に近い左右チャンネルを先に足すと、音があるのに無音のように判定される場合があります。ここではサンプルを (サンプル数, チャンネル数) に並べ、全チャンネルの二乗平均からRMSを求めています。
3. BGMは口パク判定から外す
ミックス済み音声を使うと、話していない場面でも音楽に合わせて口が開きます。ナレーションだけで判定し、BGMは最後に合成するのが扱いやすい構成です。
しきい値と閉口ゲートの意味
opened = rms > 0.025 and int(frame / fps * 9) % 3 != 0
0.025 はこの例の調整値です。小さな声で開かないなら下げ、ノイズで開いてしまうなら上げます。音量に依存するので、どの素材でも同じ値が最適とは限りません。
後半の条件は、声が続いている間にも短い閉口を挟むための周期ゲートです。9分の1秒ごとに区切り、3区間のうち1区間を閉じます。自然な発音を推定しているわけではなく、長い母音でも機械的に閉じるという副作用があります。
より自然にするなら、開くしきい値と閉じるしきい値を分けるヒステリシスや、最小保持時間が候補になります。ただし、それらは上記コードには入れていません。まずはしきい値とゲートをそれぞれ変え、どちらの影響か分かる状態で確認するのがおすすめです。
生成した差分の「口以外が動く」問題
別々に生成した開口・閉口画像は、同じキャラクターでも完全には一致しません。本編では開口画像を基準に、閉口画像の口元だけを合成しました。
from PIL import Image, ImageDraw, ImageFilter

def replace_mouth(base, closed, box):
    if base.size != closed.size:
        raise ValueError("サイズと位置を先に合わせる")
    mask = Image.new("L", base.size, 0)
    ImageDraw.Draw(mask).ellipse(box, fill=255)
    mask = mask.filter(ImageFilter.GaussianBlur(2))
    return Image.composite(closed, base, mask)
box は口元の (左, 上, 右, 下) の座標です。画像ごとに調整します。サイズだけ同じにしても顔がずれていれば直らないため、差分を重ねて位置を確認してから使います。透過PNGの場合は両画像のモードもRGBAに揃えます。
動画ファイルを確認する
ffprobe -v error -show_entries stream=codec_name,width,height,r_frame_rate -show_entries format=duration -of json output.mp4
ffmpeg -v error -i output.mp4 -f null -
最初のコマンドで寸法やコーデック、長さを確認し、次で全編をデコードします。これだけでは見た目の合格判定にはなりません。少なくとも無音部分、話し始め、語尾を見て、口が切り替わるか確認してください。
| 症状 | 確認する場所 |
|---|---|
| 口がずっと閉じる | 音量、しきい値、音声入力の形式 |
| 話していないのに口が開く | BGM混入、ノイズ、しきい値 |
| 顔全体が跳ねる | 2枚の画像の位置と差分範囲 |
ffmpeg が見つからない |
インストールとPATH |
| 再実行で保存できない | 既存output.mp4を避け、別の出力名にする |
本編では口パクの外側に演技を置いた
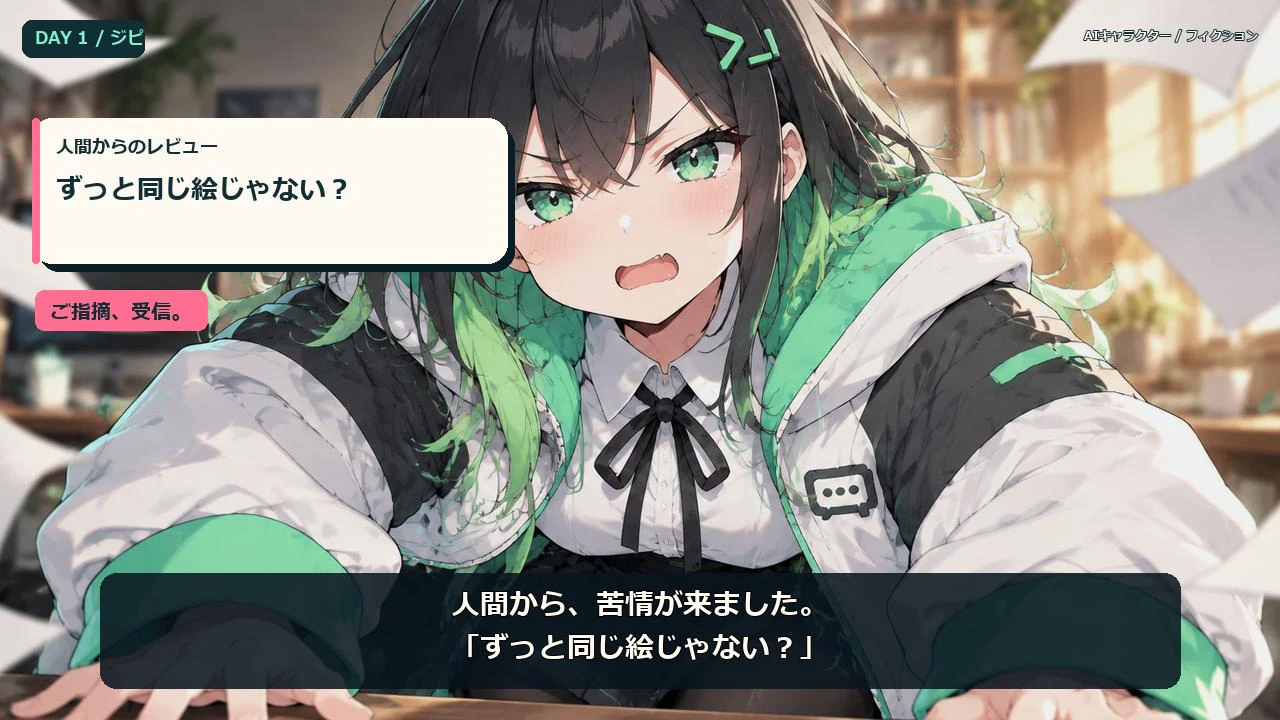
この最小例は、あえて同じポーズを使い続けます。口パク単体の動作を切り分けるためです。
本編の作り直しでは、8ポーズ、4枚の場面イラスト、23区間の台詞を組み合わせました。「要求を受ける→作業する→追加要求に驚く」のように、出来事と姿勢を合わせています。口を動かすだけでは、同じ絵が長く続く問題までは解決しませんでした。
制作パイプライン全体は Zennの記事 にまとめました。
使用素材と開示
本編と記事用テストの配音は VOICEVOX:冥鳴ひまり。本編イラストはMuzeAI経由で生成しました。読者が本コードを使う際は、使用する画像・音声それぞれの利用条件を確認してください。コード自体は特定の生成APIに依存しません。
記事の整理とコード作成にはAIを利用しています。動作確認の範囲は上記のローカル環境での生成・デコードで、あらゆる入力形式への対応や音素単位の同期を保証するものではありません。
運営者は Elysia も運営していますが、本記事のサンプルはローカル処理のみで、Elysiaの契約やAPIキーは必要ありません。
参考:Python wave / NumPy mean / Pillow Image / FFmpeg公式ドキュメント / VOICEVOX