
Open WebUIとOllamaを使うと、ローカルで動かすLLMをブラウザから対話形式で利用できます。
実際に使い続けると、モデルと会話できるだけでなく、次の機能も欲しくなりました。
- チャット履歴をPostgreSQLで永続化し、バックアップしたい
- PDFなどの文書を、段組みや図表の構造も考慮して検索したい
- 必要なときはWeb検索も使いたい
- Ollama、OpenAI、Anthropic、Geminiを同じ画面から切り替えたい
- 一時的な外部公開や、複数コンポーネントの死活監視も行いたい
そこで、Open WebUIとOllamaを中心に、PostgreSQL + pgvector、Docling、SearXNG、LiteLLMなどをDocker Composeでまとめた構成を作りました。
リポジトリはこちらです。
この記事では設定項目をすべて解説するのではなく、各コンポーネントをなぜ追加したのか、実際に使って何が便利になり、どんな制約があったのかを紹介します。
この構成は、すべてをローカルで完結させることだけを目的としていません。
ローカルのOllama、外部のLLM API、RAG、Web検索を、用途に応じて同じUIから選べることを重視しています。外部APIを選べば会話内容が各プロバイダーへ送信され、Web検索を使えば検索語が外部へ送信されます。
作った構成
構成の中心はOpen WebUIです。Open WebUIから、モデル呼び出しはLiteLLM、Web検索はSearXNG、文書抽出はDoclingへ接続します。
ブラウザ
  │
  ▼
Open WebUI ───── PostgreSQL + pgvector
  │
  ├─ LiteLLM ─┬─ Ollama
  │           ├─ OpenAI
  │           ├─ Anthropic
  │           └─ Gemini
  │
  ├─ SearXNG ─── Web検索
  └─ Docling ─── 文書抽出・OCR

任意で追加
  ├─ ngrok ───── 一時的な外部公開
  └─ Uptime Kuma ─ 死活監視
各コンポーネントの役割は次のとおりです。
| コンポーネント | この構成での役割 |
|---|---|
| Open WebUI | チャットUI、会話履歴、RAGやWeb検索の入口 |
| Ollama | ローカルLLMの実行とモデル管理 |
| PostgreSQL | ユーザー、会話履歴、設定などの永続化 |
| pgvector | Open WebUIから使うベクトルデータベース |
| Docling | PDFなどから文書構造を考慮して内容を抽出 |
| SearXNG | Web検索結果をOpen WebUIへ渡す |
| LiteLLM | ローカルモデルと外部LLM APIをOpenAI互換APIへ集約 |
| Uptime Kuma | 各コンポーネントの死活監視 |
| ngrok | 一時的な外部アクセス経路 |
| backupサービス | PostgreSQLとアプリケーションデータの定期バックアップ |
複数のモデルを同じ画面から選べる
Open WebUIは、Ollamaへ直接接続することも、外部のOpenAI互換APIへ接続することもできます。
この構成では、モデル接続をOpen WebUIへ直接集約せず、間にLiteLLMを置きました。Open WebUIはLiteLLMのOpenAI互換APIだけを参照し、LiteLLMが次の接続先へ振り分けます。
- Ollamaで動かすローカルモデル
- OpenAI API
- Anthropic API
- Gemini API
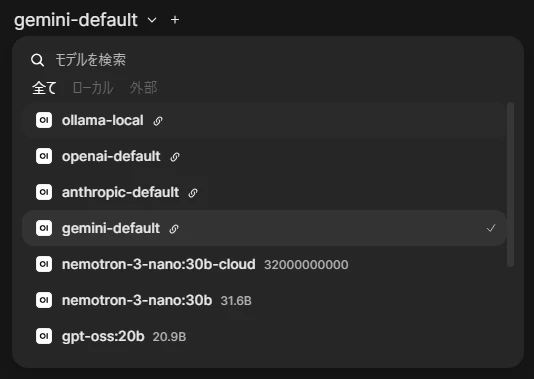
実際にOpenAI、Anthropic、Geminiへ接続し、同じモデル選択欄から切り替えられることを確認しました。
LiteLLMを境界にすると、次の利点があります。
- プロバイダーのAPIキーを扱うコンポーネントをLiteLLMへ限定できる
- Open WebUI側では、プロバイダーごとの接続差を意識しなくてよい
- UIに表示するモデル名を揃えられる
- 将来、ルーティングや利用量管理を追加しやすい
- Open WebUIを別のUIへ置き換える場合も、モデル接続部分を分離しやすい
LiteLLMを挟めば、APIキーの管理が不要になるわけではありません。
プロバイダーのAPIキーをOpen WebUIへ直接持たせず、扱う場所をLiteLLMへ限定する構成です。 .env やLiteLLMの接続キーは、引き続き秘密情報として管理する必要があります。
PostgreSQLで履歴を永続化する
Open WebUIは既定のSQLiteでも会話履歴を保存できます。個人が一台で試すだけなら、SQLiteのままでも十分です。
今回は、履歴を継続的に運用し、バックアップしやすくすることと、今後のスケーラビリティを考えてPostgreSQLを採用しました。RAG用のベクトルデータベースにはpgvectorを使います。
既存のSQLite環境で DATABASE_URL をPostgreSQLへ変更しても、既存の履歴は自動的に移行されません。
既存データを残す場合は、Open WebUIを停止し、SQLiteとアプリケーションデータをバックアップしたうえで、公式の移行手順に従う必要があります。新規環境として始める場合は、この移行作業は不要です。
Doclingで文書構造を考慮したRAGを使う
Open WebUI標準の文書抽出は速く、単純なテキスト中心の文書であれば扱いやすいと感じました。一方で、段組みや図表を含むPDFでは、テキストだけが抽出され、文書構造が抜けることがありました。
そこで、文書抽出にDoclingを追加しました。実際に使うと、標準の抽出より時間はかかるものの、段組みや図表を含む文書を構造化した状態で取り込めました。
次は、論文のPDFを取り込み、その内容について質問した例です。
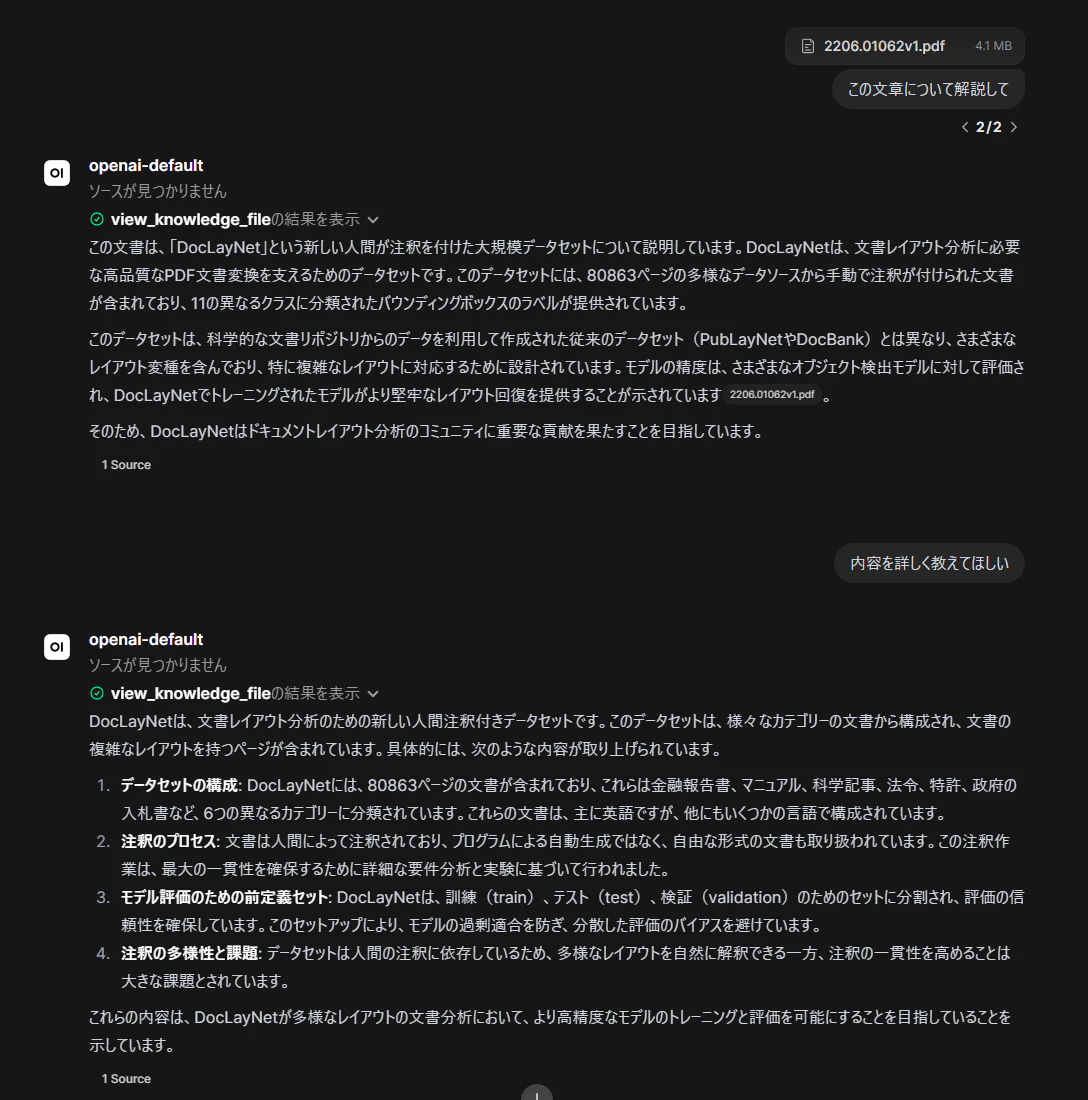
この例ではファイル名と 1 Source が表示される一方、画面上部には「ソースが見つかりません」とも表示されました。文書に基づく回答は生成できましたが、参照元の表示まで常に安定するとは限りません。
Doclingは常に使えばよいわけではなく、文書に応じた使い分けが必要です。
| 文書 | 抽出方法の目安 |
|---|---|
| 単純なテキスト中心の文書 | 処理が速い標準抽出 |
| 段組み、表、図を含むPDF | 構造を扱いやすいDocling |
| スキャンした日本語文書 | OCRを設定したDocling |
Doclingは標準抽出よりリソース消費が大きく、処理にも時間がかかりました。
このリポジトリでは、日本語と英語のTesseractデータを追加したDoclingイメージをビルドします。GPU構成でもTesseract自体はCPUで動作し、Doclingの対応する他のパイプラインモデルでGPUが使われます。
SearXNGでWeb検索を追加する
Open WebUIのWeb検索先としてSearXNGを追加しました。モデルだけでは答えられない新しい情報を検索し、参照元を付けた回答を生成できます。
次はAnthropicのモデルを選び、Web検索を有効にして回答させた例です。

日本語検索、引用元の表示、体感上の応答時間は実用的でした。ただし、検索結果の品質そのものは、専用の対話型生成AIサービスと同等とは感じませんでした。
また、Web検索では検索結果もモデルのコンテキストへ入ります。**コンテキストウィンドウが小さいモデルでは、必要な情報を十分に渡せず、回答品質が下がります。**UIにWeb検索機能があっても、選んだモデルによって実用性が変わる点には注意が必要です。
Compose構成を管理可能にする
機能を追加すると、compose.yml や設定ファイルの管理、各コンポーネントの死活管理が必要になります。
このリポジトリでは、CPU/GPUの差分と任意機能を次のように分けました。
-
compose.yml: CPUでも動かせる共通構成 -
compose.gpu.yml: NVIDIA GPU向けのoverride -
COMPOSE_FILE: 使用するComposeファイルを.envで選択 -
COMPOSE_PROFILES: ngrokとUptime Kumaの有効化を選択
CPU構成では次のようにします。
COMPOSE_FILE=compose.yml
COMPOSE_PROFILES=
NVIDIA GPUを使い、ngrokと監視も有効にする場合は次のようにします。
COMPOSE_FILE=compose.yml:compose.gpu.yml
COMPOSE_PROFILES=ngrok,monitoring
一度 .env へ設定すれば、起動時に毎回profileやComposeファイルを指定する必要はありません。
最短で起動する
必要な設定と詳細な前提条件は、リポジトリのREADMEを参照してください。基本的な流れは次のとおりです。
git clone https://github.com/skrtk98/open-webui-ollama.git
cd open-webui-ollama
cp .env.example .env
cp config/ngrok/ngrok-policy.example.yml ngrok-policy.yml
.env へPostgreSQL、Open WebUI、SearXNG、LiteLLMの秘密情報を設定します。外部LLMを使う場合だけ、対応するAPIキーも設定します。
OPENAI_API_KEY=
ANTHROPIC_API_KEY=
GEMINI_API_KEY=

SEARXNG_SECRET=長いランダム文字列
WEBUI_SECRET_KEY=長いランダム文字列
POSTGRES_PASSWORD=長いランダム文字列
DATABASE_URL=postgresql://open_webui:パスワード@postgres:5432/open_webui
LITELLM_MASTER_KEY=sk-長いランダム文字列
起動します。
docker compose up -d --build
ローカルモデルを取得します。最初の確認では、比較的小さいモデルから始める方が安全です。
docker compose exec ollama ollama pull llama3.2:3b
docker compose exec ollama ollama list
起動後、http://127.0.0.1:3000 を開きます。
モデルサイズによって必要なメモリと応答速度は大きく変わります。
今回の環境では llama3.2:3b 、qwen3:8b 、gpt-oss:20b 、nemotron-3-nano:30b 、llama3.3:70b などを確認しました。42 GBある llama3.3:70b は24 GBのGPUメモリへ収まらないため、同じモデル名でも手元のハードウェアによって使用感は大きく異なります。
Uptime Kumaで死活を確認する
コンポーネントが増えると、Open WebUIが開かないときに、UI、モデル、検索、文書抽出のどこで問題が起きているかを確認する必要があります。
monitoring profileではUptime Kumaを起動し、Dockerネットワーク内からOpen WebUI、Ollama、SearXNG、Doclingのヘルスチェックを登録できます。
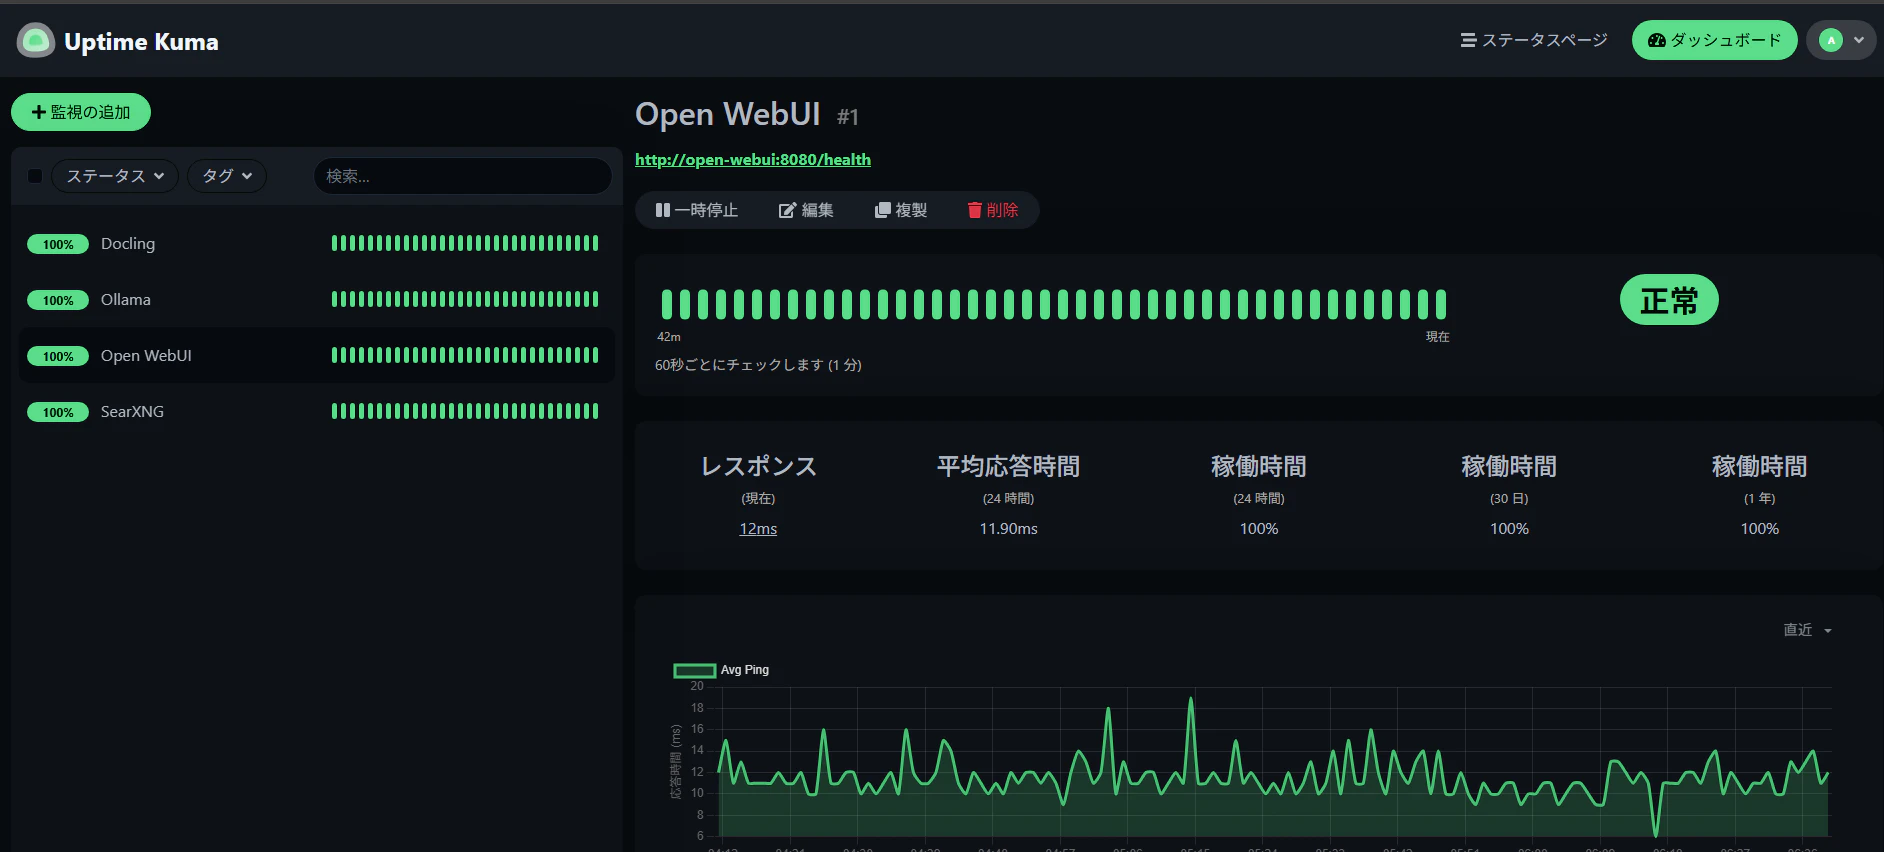
Uptime Kumaは障害の検知には役立ちますが、原因調査や復旧まで自動化するものではありません。また、同じDocker Compose内のUptime Kumaが停止した場合は検知できないため、本格運用では外部からの監視も必要です。
ngrokは一時的な確認に限定する
ngrok profileを有効にすると、Open WebUIを一時的にインターネット越しで確認できます。公開URLの前段ではGoogle OAuthを使い、許可するメールアドレスをTraffic Policyで限定します。
on_http_request:
  - actions:
      - type: oauth
        config:
          provider: google

  - expressions:
      - "!(actions.ngrok.oauth.identity.email in ['your-email@gmail.com'])"
    actions:
      - type: deny
これはOpen WebUIのログインを置き換えるものではありません。ngrokのOAuthを公開URLの境界防御、Open WebUIのログインをアプリケーションのユーザー管理として併用します。
この構成でのngrokは、一時的なテスト用途です。
継続的に外部公開する場合は、Cloudflare Tunnelなどを含め、認証、アクセス制御、TLS、監視、可用性をあらためて設計する必要があります。
バックアップの範囲を理解する
backupサービスは、既定で24時間ごとに次のデータをDocker Volumeへ保存します。
- PostgreSQLのカスタム形式dump
- Open WebUIのデータとアップロードファイル
- Doclingのデータ
Ollamaモデルは容量が大きく、再取得できるため対象外にしています。
ただし、バックアップ先も同じホスト上のDocker Volumeです。誤操作や一部データ破損への備えにはなりますが、ディスク故障やホスト自体の障害には耐えられません。別ディスクやS3互換ストレージへ定期的にコピーする必要があります。
また、現在の環境は運用を継続できていますが、復元手順は完全には実地検証できていません。**バックアップが作成されていることと、必要な時間内に復元できることは別です。**本格運用前には復元試験が必要です。
動作確認環境
今回の動作確認環境は次のとおりです。
| 項目 | 環境 |
|---|---|
| OS | Ubuntu 22.04.5 LTS |
| CPU | Intel Xeon E5-2698 v4 × 2、合計40コア80スレッド |
| メモリ | 約252 GiB |
| GPU | NVIDIA RTX A5000、約24 GiB VRAM |
| NVIDIAドライバー | 595.71.05 |
| CUDA Toolkit | 12.1 |
かなり余裕のあるワークステーションです。この環境で動いたことは、一般的なPCで同じモデルを快適に利用できることを意味しません。
nvidia-smi に表示される CUDA Version: 13.2 は、ドライバーが対応するCUDAの上限です。実際にインストールされているCUDA Toolkitは、nvcc --version で確認した12.1です。
この構成が向く場合・向かない場合
向いている場合
- ローカルモデルと外部LLMを同じUIから使い分けたい
- RAGとWeb検索をOpen WebUIへまとめたい
- 会話履歴をPostgreSQLで運用したい
- Docker Composeの設定や障害箇所を自分で管理できる
- 個人または小規模な検証環境として使いたい
向いていない場合
- とにかく最短でローカルモデルと会話したい
- SQLiteで十分で、RAGやWeb検索も不要
- 各コンポーネントの更新や死活管理をしたくない
- 大規模な同時アクセスを想定している
- 可用性や復旧時間が保証された本番サービスが必要
単純にローカルLLMを試すだけなら、Open WebUI + Ollamaの最小構成の方が扱いやすいです。この構成は、機能追加による複雑さを受け入れたうえで、Composeの差分管理、監視、バックアップによって管理可能にするものです。
大規模運用については検証していません。リバースプロキシ、複数インスタンス、コンテナオーケストレーションなどが必要になる可能性がありますが、Open WebUIを含めた構成全体の対応可否は、負荷試験と公式資料を基に別途判断する必要があります。
まとめ
Open WebUIとOllamaだけでも、ローカルLLMをチャットUIから使えます。そこへ次の役割を追加しました。
- PostgreSQL + pgvectorで履歴とベクトルデータを扱う
- Doclingで構造を含む文書の取り込みを補う
- SearXNGでWeb検索を追加する
- LiteLLMでOllama、OpenAI、Anthropic、Geminiをまとめる
- Uptime Kumaで増えたコンポーネントを監視する
- ngrokで一時的な外部確認を行う
- アプリケーションデータを定期的にバックアップする
得られたのは、ローカル完結だけに限定せず、用途に応じてモデルと情報源を選べる環境です。一方で、コンポーネントが増えれば、設定、監視、更新、バックアップ、セキュリティの責任も増えます。
まずOpen WebUI + Ollamaを試し、RAG、Web検索、複数プロバイダーなど、必要になった機能だけを追加する判断も重要です。