
この記事の要点(30秒版)
- 従来のRAGは「BM25やベクトル検索で上位を拾う → LLMが答える」。手前の検索器が賢いLLMの足を引っ張る(能力の非対称性)
- DecisionRAG は検索器を置かず、LLM級の「判定モデル」が文書の階層(カテゴリ → 文書 → 段落)を辿って探す。出力は文章ではなく Yes/No の確率だけなので速い
- 論文の数値: 同条件の検索(Dense+Qwen3-Reranker-8B)に対して MultiDoc2Dial の R@1 が +13.8pt、Natural Questions の Hit@1 が +17.4pt。LLMに文章を生成させて探す方式に対しては 34〜145倍速く、コストは1/21〜1/25
- ただし「ベクトルDBが完全に不要」「精度と速度のトレードオフを完全打破」までは言えない。階層(目次)の質に依存し、枝切りは不可逆(6章)
1. はじめに
従来のRAGは、まず BM25 や ベクトル検索(Embedding) で上位の文章を絞り、それをLLMに渡す構成が一般的です。
しかし、手前の検索エンジンが関係ない文章を取ってきたら、どんなに賢いLLMでも正しく答えられません。これが「検索のボトルネック問題(能力の非対称性)」です。
今回読んだのは次の論文です。
- 論文: Retriever-Free Retrieval: Navigating Documents with Decision Models(提案手法の名前が DecisionRAG)
- arXiv:2610.35868(HTML版)
この記事は、後で見返したときに「何が新しくて、どう動いて、どこまで本当か」をすぐ思い出せることを目的にしたメモです。
想定読者: RAG(BM25・ベクトル検索・リランカー)の基本を知っている人
2. 何が問題?:能力の非対称性
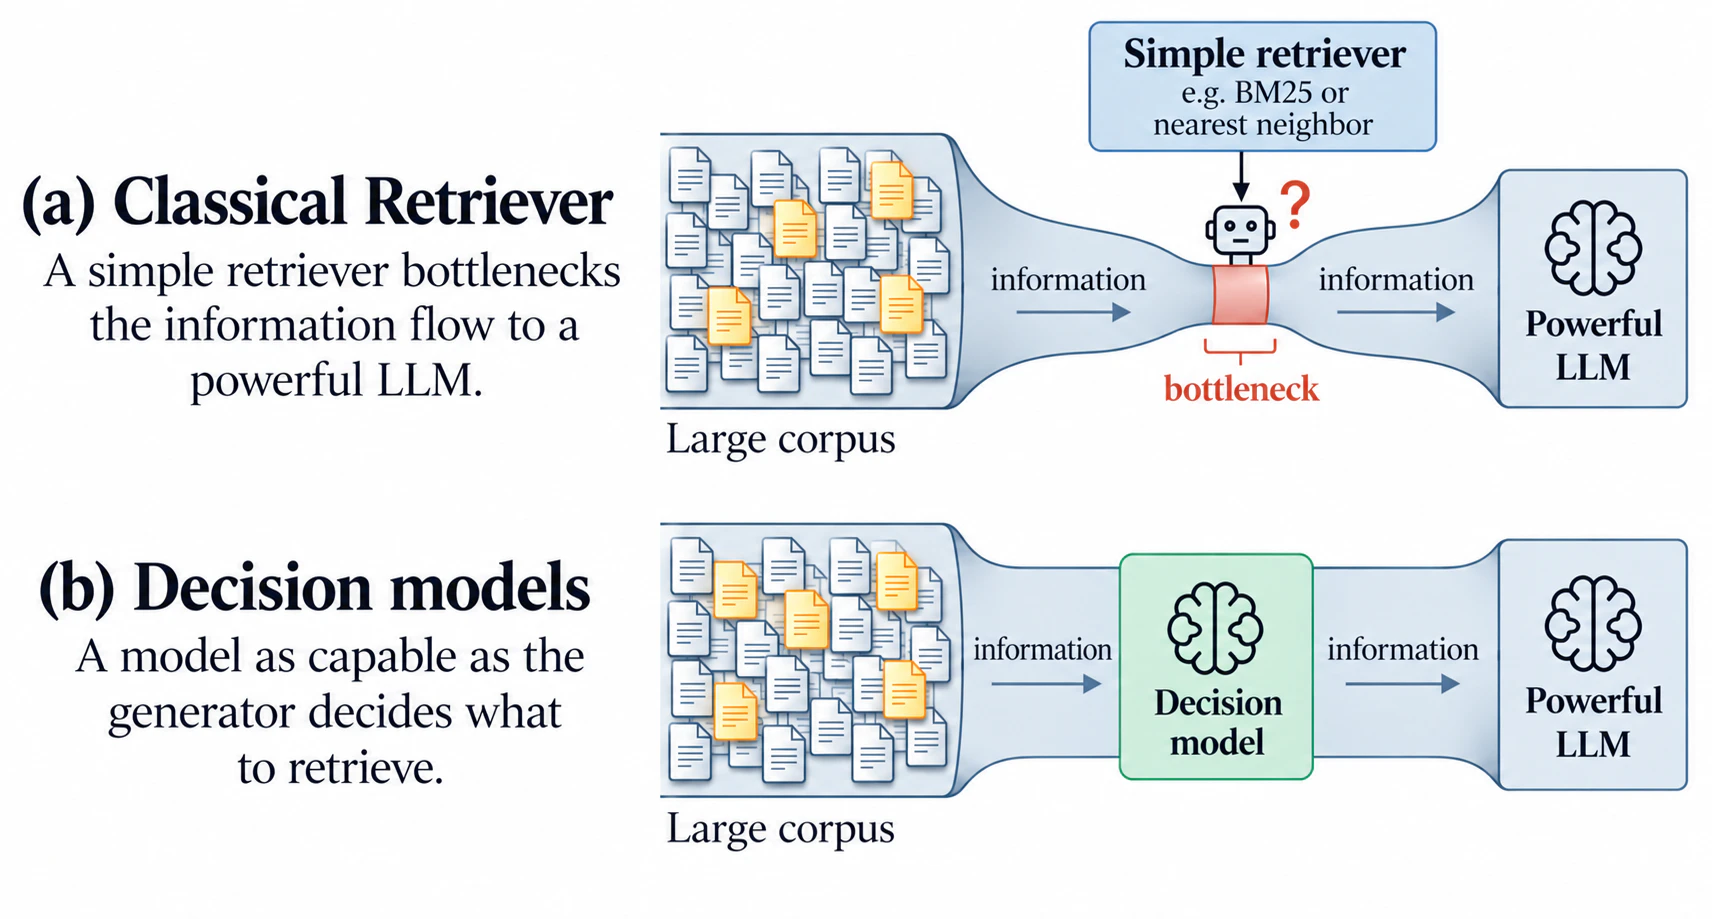
出典: 論文 Figure 1(arXiv:2610.35868)。(a) 単純な検索器が、強力なLLMへの情報の流れを絞ってしまう。(b) 生成側と同等に賢い「判定モデル」が、何を取ってくるかを決める。
- (a) 従来: コーパス全体 → 単純な検索器(BM25や最近傍) → 強力なLLM。ここが細い管になる
- (b) DecisionRAG: コーパス全体 → LLM級の判定モデル → 強力なLLM。管が詰まらない
3. DecisionRAGとは
一言で言うと
図書館で人間が目的の本を探すように、「カテゴリ → 文書 → 章見出し → 本文段落」 と階層(ツリー)を絞りながら探す手法です。
3つの探し方の違い(論文 Figure 2)

出典: 論文 Figure 2(arXiv:2610.35868)。質問は「クリストファー・ノーランの2000年の映画の主人公は?」。
| (a) BM25 | (b) Dense | (c) DecisionRAG | |
|---|---|---|---|
| 何をするか | 単語の一致を数える | ベクトルの近さを測る | 関連があるかを判断する |
| 図の例 |
Gladiator (2000 film) が「2000」「film」の一致で上位に来る(無関係な一致) |
関連する文書を取りこぼす(図の黄点線) |
Memento (film) の文書を選び、Gladiator の枝は評価せずに切り捨てる
|
| 弱点 | 意味を理解しない | 意味は近いが微妙にズレた文章を拾う | 階層が必要・枝切りは不可逆 |
探索の流れ
論文の言葉では、各階層で判定モデルを1回通す(1 stage = 1回のリクエスト)ので、階層が深くなっても stage 数は階層の深さ分だけです。
4. 仕組み
4-1. テキストを「生成」しない:判定モデルの2つのモード
LLMに文章を書かせる(Agent型)のではなく、Yes/No の確率だけを取り出します。1回のフォワードパスで済むので速い、というのが核心です。
| モード | 何をするか | 特徴 |
|---|---|---|
| 並列二値判定(binary) | 候補それぞれに「関連あるか?」を聞き、P(Yes) を得る |
候補同士は独立に正規化。数が多い層向き(再現率重視) |
| 多肢選択判定(multiple-choice) | 「どれが一番関連するか?」を選択肢として並べて聞く | 確率の合計が1で候補同士が競合。上位の最終順位づけ向き |
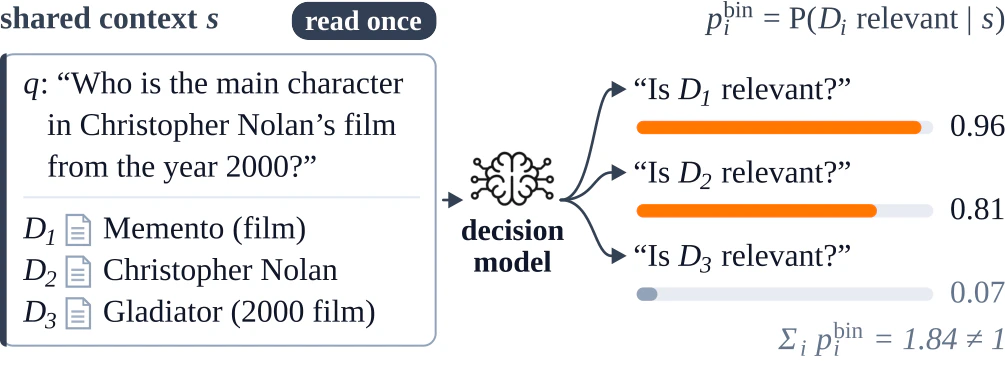
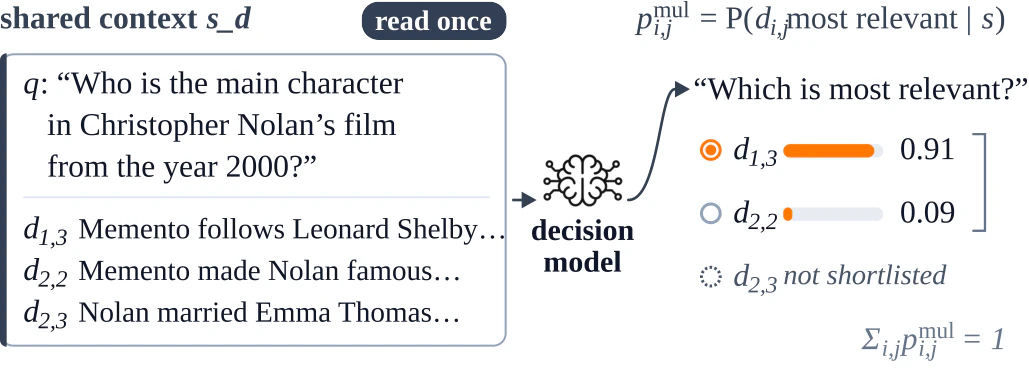
出典: 論文 Figure 3(arXiv:2610.35868)。(a) 共有文脈のもとで文書を並列に二値判定、(b) 上位パッセージを同じ共有文脈で多肢選択。
4-2. 共有コンテキスト(Shared Context)で「相対評価」する
候補(目次など)を同じ文脈にまとめて並べ、モデルが一度読んで判定します。
- 単体で見ると関係なさそうでも、他の候補と比べて一番マシという判断ができる
- 論文の分析では、MultiDoc2Dialで「ページごとに採点」から「選択した全ページのパッセージをまとめて採点」にすると R@1 が 36.7% → 44.4%(+7.7pt)
- NQでは、1回のリクエストあたり約50候補で頭打ちになると報告されている
4-3. 対数オーダーでスケールする
大枠から順に絞り、関係ない枝は切り捨てます(プルーニング)。論文の解析モデルでは、分岐数を b、パッセージ数を N として次のように近似しています。
遅延 T(N) ≈ t_req × ⌈log_b N⌉ (t_req ≈ 0.2秒)
- 例: b=100 なら、10億パッセージでも判定は5回、約1秒(論文の解析的な見積もり。10億件で実測したわけではない)
- 実測では、約268万パラグラフ(約10.9万ページ)の Natural Questions コーパスで中央値 約1.7秒
4-4. アルゴリズム(Algorithm 1 の要約)
- 根の子ノードを候補にする
- 各階層で並列二値判定し、上位
k個だけ残して、その子を次の候補にする(残らなかった枝の子孫は評価しない) - 最下層で二値判定し、上位
r個のパッセージを選ぶ - (任意)上位
m個を多肢選択判定で並べ替える
階層がない場合は、埋め込みをk-meansなどでクラスタリングしてオフラインで階層を作ります(NQで採用)。
5. 成果(数値)
5-1. 検索精度(論文 Table 2 から抜粋、%)
| 手法 | MD2D R@1 | CQA Hit@1 | MTRAG R@5 | NQ Hit@1 |
|---|---|---|---|---|
| BM25 | 20.6 | 24.7 | 18.8 | 16.4 |
| Dense | 27.9 | 47.2 | 26.0 | 46.2 |
| Dense top-100 + Qwen3-Reranker-8B | 33.6 | 64.6 | 32.5 | 48.0 |
| Dense top-20 + GPT-5(リランク) | 47.5 | 73.4 | 31.8 | 60.8 |
| DecisionRAG(Jev) | 47.4 | 69.7 | 34.2 | 65.4 |
| DecisionRAG + dense候補 | 48.5 | 73.4 | 36.6 | 66.4 |
- MD2D: Qwen3-Reranker-8B(33.6)に対して R@1 +13.8pt(47.4)
- NQ: 同(48.0)に対して Hit@1 +17.4pt(65.4)
MD2D = MultiDoc2Dial、CQA = ConditionalQA、MTRAG = IBM Cloud のマルチターン、NQ = Natural Questions(DAPR)です。
5-2. 速度とコスト(論文 Table 5 / 6)
中央値の遅延(秒)
| 手法 | MD2D | CQA | MTRAG | NQ |
|---|---|---|---|---|
| Dense top-100 + Qwen3-Reranker | 7.5 | 3.3 | 14.3 | 5.8 |
| Dense top-20 + GPT-5 | 11.8 | 14.4 | 12.2 | 15.0 |
| DecisionRAG(Jev) | 0.68 | 0.82 | 1.76 | 1.73 |
1クエリのAPIコスト(セント)
| 手法 | MD2D | CQA | MTRAG | NQ |
|---|---|---|---|---|
| Dense top-20 + GPT-5 | 1.40 | 1.20 | 1.90 | 1.40 |
| DecisionRAG(Jev) | 0.22 | 0.29 | 1.73 | 2.33 |
GPT-5に文章を生成させて探索する方式(Agent型)との比較(Table 6)
| データ | 手法 | Hit@1 | 遅延(秒) | コスト(¢) |
|---|---|---|---|---|
| CQA | GPT-5(生成) | 73.8 | 28.2 | 6.1 |
| CQA | DecisionRAG | 69.7 | 0.82 | 0.29 |
| NQ | GPT-5(生成) | 59.0 | 250.8 | 57.2 |
| NQ | DecisionRAG | 65.0 | 1.73 | 2.33 |
ここから 34〜145倍高速、コスト1/21〜1/25 という数字が出ています(CQA: 28.2÷0.82 ≒ 34倍、NQ: 250.8÷1.73 ≒ 145倍)。
6. 正確に読むための注意(ここが大事)
数字の見え方に引っ張られないよう、何と比べた数字かを整理しておきます。
| よくある読み方 | 実際は |
|---|---|
| 「従来より +13.8pt / +17.4pt」 | 比較相手は Dense+Qwen3-Reranker-8B。より強い GPT-5リランクと比べると、MD2Dはほぼ同じ(47.4 vs 47.5)、CQAは下(69.7 vs 73.4)、NQは上(65.4 vs 60.8) |
| 「Agent型と同等以上の精度で34〜145倍速い」 | 「同等以上」はデータ次第。CQAでは 69.7 vs 73.8 で下、NQでは 65.0 vs 59.0 で上。速度・コスト比はCQAとNQの2データのみ |
| 「爆速で低コスト」 | NQのコストは 2.33¢ で、GPT-5リランク(1.40¢)より高い。MD2D・CQAでは大きく安い |
| 「Vector DBが不要になる」 | 論文が不要と言うのは第一段階の検索器と事前構築インデックス。ただし階層がないNQでは埋め込みでクラスタリングして階層を作っており、最良の構成はdense候補を併用している |
| 「精度と速度のトレードオフを完全打破」 | dense候補の併用でCQAは 73.4 とGPT-5生成型(73.8)にほぼ並ぶが、「完全」とは言えない |
その他、押さえておきたい点:
- タスク固有の学習なし(training-free)の数値。学習済み8B判定器では MD2D R@1 が 60.7(DPR 49.0、SFRe2g 55.0)と、さらに上がる
- RAG全体の回答品質(Table 3)でも最良は DecisionRAG+dense候補(CQA EM 47.6、MTRAG 47.3、NQ EM 54.8)。ただし、正解パッセージを直接与えた場合(CQA 49.4、MTRAG 60.1、NQ 65.3)とはまだ差がある
- 探索を絞りすぎない: NQでクラスタの約15%を残せば R@10 が 86.2%(全ページ直接採点 84.5%)でコストは 2.3¢ 対 12.1¢。1%まで絞ると 63.7% まで落ちる
7. 実業務で使えるのか?
すぐ活かせそうなユースケース
| 向く | 理由 |
|---|---|
| 社内Wiki(Notionなど) | 「カテゴリ > ページ > 見出し > 本文」が既にある |
| IT製品のマニュアル / FAQ | 構造が最初から綺麗(MTRAGも製品ドキュメント) |
| 行政の申請規約・就業規則 | 章・条の階層がある |
構造が整っている領域なら、まずPoCで従来のベクトル検索と比較する価値があります。
運用のカギと課題感
-
ツリー(目次・分類)の精度が生命線
- 論文のLimitationsにも「階層とノードの説明文に依存」「剪定は不可逆」と明記されている
- 緩和策は、探索予算を増やす・dense検索を併用する(論文で効果を確認)
- 構造のないデータ(雑多な社内ドライブ)は、事前クラスタリングやLLMによる目次・要約生成の質が限界を決める
-
PowerPoint・Excel などはそのまま使えない
- 木構造のテキストが前提
- 対応案: 前処理でVision LLMがスライドをテキストツリー化する、Excelの表をMarkdown/JSON構造にして「目次ノード」を作る
-
判定モデルの用意(※自分の理解。要確認)
- Yes/No の確率を取り出せる判定モデルが必要。通常のChat APIを単純に差し替えるだけでは難しそう
8. まとめ
- DecisionRAGは、検索器の代わりにLLM級の判定モデルが階層を辿るRAG。出力は文章ではなくYes/Noの確率
- 構造が整った文書群では、精度・速度・コストのバランスが良い。ただし比較相手と条件(データ、dense併用の有無)を確認して読むこと
- 成否を分けるのは、綺麗で漏れのない階層(目次)を前処理で作れるか
- 次にやりたいこと: 構造が綺麗な製品マニュアルやFAQでプロトタイプを作り、従来のベクトル検索と比較する
見返し用チェック(自分用)
- 判定モデルの2モード(並列二値 / 多肢選択)の使い分けを言える
- 「+13.8pt / +17.4pt」の比較相手が Dense+Qwen3-Reranker-8B だと覚えている
- 「34〜145倍」の比較相手は GPT-5の生成型探索で、2データのみだと覚えている
- 弱点は 階層の質への依存 と 剪定の不可逆性 だと言える
参考
- Retriever-Free Retrieval: Navigating Documents with Decision Models(arXiv:2610.35868)
- 図は論文 Figure 1〜3 を出典明記のうえ掲載しています