
はじめに
完全初学者の私が、画像認識AI(CNN)を完成させるまでに学んだ軌跡をまとめた連載の第3回(最終回)です。
-
第1回
-
第2回
第1回ではNumPyやMatplotlibを使いながら、画像データがどのような構造を持っているのかを確認し、
第2回ではTensorFlow/Kerasの基本的な使い方と簡単なAIの構築までを実践しました。
今回はTensorFlow/Kerasを利用して、実際にCNN(Convolutional Neural Network:畳み込みニューラルネットワーク)を構築し、画像分類モデルの学習を行います。
最終的には、CIFAR-10データセットに含まれる画像を学習させ、未知の画像に対して分類予測を行います。
CNNとは
CNN(Convolutional Neural Network)は、ニューラルネットワークの一種であり、画像や動画などの視覚データの処理に特化したモデルです。
画像の中から線や模様、形状といった特徴を自動的に抽出し、それらを組み合わせながら対象物を認識します。
初学者向けに簡単に説明すると、人間の視覚処理の仕組みを参考に設計された画像認識モデルと考えると理解しやすいと思います。
今回はTensorFlow公式チュートリアルを参考に、以下の10種類の画像を分類するモデルを作成します。
- 飛行機
- 自動車
- 鳥
- 猫
- 鹿
- 犬
- カエル
- 馬
- 船
- トラック
使用するライブラリ
まずは必要なライブラリをインストールします。
pip install matplotlib tensorflow
続いてライブラリを読み込みます。
import matplotlib.pyplot as plt
import numpy as np
import tensorflow as tf
from tensorflow.keras import datasets, layers, models
Step1. データの準備と前処理
今回はTensorFlowに用意されているCIFAR-10データセットを利用します。
(train_images, train_labels), (test_images, test_labels) = (
    datasets.cifar10.load_data()
)
データセットには以下が含まれています。
- 訓練用画像:50,000枚
- テスト用画像:10,000枚
- 画像サイズ:32×32ピクセル
- カラー画像(RGB)
次に画像データを正規化します。
train_images, test_images = train_images / 255.0, test_images / 255.0
元の画素値は0〜255の整数ですが、ニューラルネットワークでは0.0〜1.0の範囲に変換して学習させることが一般的です。
これにより学習が安定しやすくなります。
print("訓練データの形:", train_images.shape)
出力例
(50000, 32, 32, 3)
これは
- 50,000枚の画像
- 縦32ピクセル
- 横32ピクセル
- RGBの3チャンネル
を意味しています。
Step2. 学習データを確認する
実際に学習に使用する画像を確認してみます。
# 訓練データの0番目の画像を画面に映してみる
plt.figure(figsize=(2, 2))
plt.imshow(train_images[0])
plt.grid(False)
plt.show()

print(train_labels[0])
- 出力

出力された画像を見ると、小さく粗い画像ではありますが、CIFAR-10に含まれるカエルの画像であることが確認できます。
Step3. CNNモデルを構築する
続いてCNNモデルを構築します。
# 1. モデルの土台となるSequentialモデルを作成
model = models.Sequential()

model.add(
    layers.Conv2D(
        32,
        (3, 3),
        activation="relu",
        input_shape=(32, 32, 3),
    )
)
model.add(layers.MaxPooling2D((2, 2)))

# 2. 2回目の畳み込み(Conv)と縮小(Pool)
# 層を重ねることで、より複雑な特徴(目や耳、タイヤの形など)を抽出できるようになる
model.add(layers.Conv2D(64, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))

# 3. 3回目の畳み込み(Conv)
model.add(layers.Conv2D(64, (3, 3), activation="relu"))

# 4. 3次元の特徴マップを1次元ベクトルに変換(Flatten)
model.add(layers.Flatten())

# 5. 全結合層(Dense)で特徴をもとに判定を行う
model.add(layers.Dense(64, activation="relu"))

# 6. 出力層:今回は10種類に分類するため、出力ユニット数は10
model.add(layers.Dense(10))
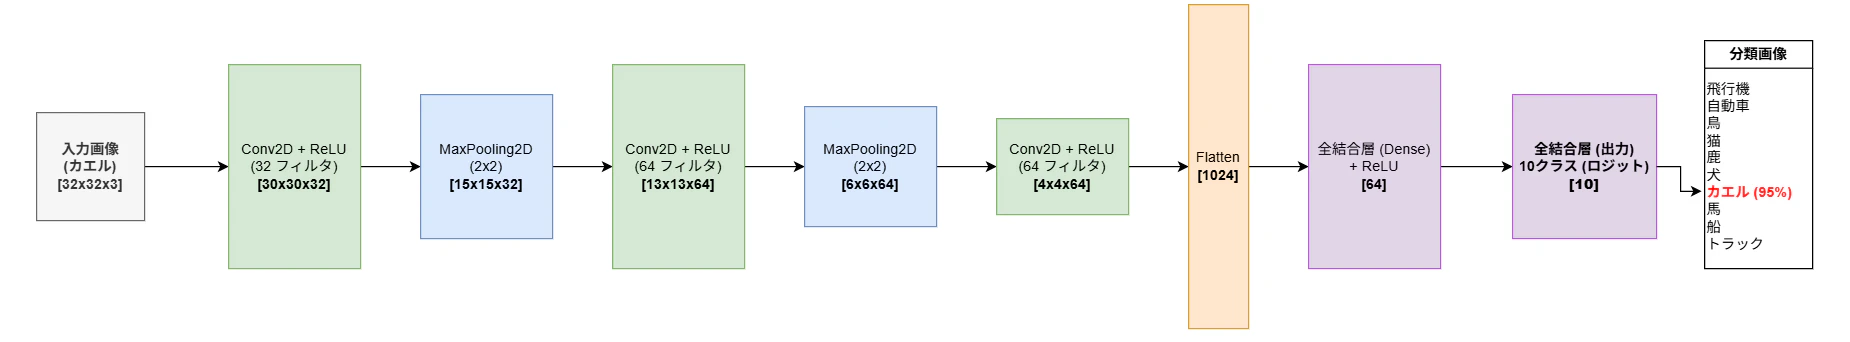
Conv2D
畳み込み層です。
画像を小さなフィルタで走査しながら特徴を抽出します。
初期層では線や輪郭を検出し、深い層ではより複雑な形状を認識できるようになります。
MaxPooling2D
特徴マップを圧縮する層です。
画像サイズを小さくしながら重要な特徴を残すことで、計算量を削減します。
Flatten
3次元の特徴マップを1次元ベクトルへ変換します。
後続の全結合層へ入力するために必要な処理です。
Dense
全結合層です。
抽出された特徴をもとに最終的な分類を行います。
モデル構造は以下で確認できます。
model.summary()
- 出力
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d (Conv2D)                 │ (None, 30, 30, 32)     │           896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d (MaxPooling2D)    │ (None, 15, 15, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_1 (Conv2D)               │ (None, 13, 13, 64)     │        18,496 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d_1 (MaxPooling2D)  │ (None, 6, 6, 64)       │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_2 (Conv2D)               │ (None, 4, 4, 64)       │        36,928 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten)               │ (None, 1024)           │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense)                   │ (None, 64)             │        65,600 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 10)             │           650 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 122,570 (478.79 KB)
 Trainable params: 122,570 (478.79 KB)
 Non-trainable params: 0 (0.00 B)
モデルアーキテクチャのイメージ
Step4. モデルを学習する
モデルの構築が完了したら学習設定を行います。
# 1. 勉強のルールを設定(優秀な家庭教師「adam」と、仕分け用のLossを設定)
model.compile(
    optimizer="adam",
    loss=tf.keras.losses.SparseCategoricalCrossentropy(
        from_logits=True
    ),
    metrics=["accuracy"],
)
各パラメータの意味は以下の通りです。
- optimizer:重み更新アルゴリズム
- loss:誤差の計算方法
- metrics:評価指標
続いて学習を実行します。
history = model.fit(
    train_images,
    train_labels,
    epochs=10,
    validation_data=(test_images, test_labels),
)
なお、ここでは validation_data にテスト用データ(test_images, test_labels)をそのまま指定していますが、これはTensorFlow公式チュートリアルに準じた書き方です。学習中の過学習チェックに使ったデータでそのまま最終的な性能評価まで行うと、テスト性能をやや楽観的に見積もってしまう場合があるため、厳密に行う場合は訓練データの一部を検証用(Validation)として切り出し、テストデータは最後の評価にのみ使うのが望ましいとされています。今回は学習の流れを掴むことを目的としているため、シンプルにテストデータを検証用としても使っています。
学習が進むにつれて、
- Accuracy(正解率)は上昇
- Loss(誤差)は減少
していくことが確認できます。
最終的には以下の結果となりました。
accuracy: 0.8029
val_accuracy: 0.7009
訓練データでは約80%、テストデータでは約70%の正解率となりました。
Step5. 学習結果を可視化する
学習過程をグラフで確認します。
# Accuracy と Loss をまとめて可視化する
plt.figure(figsize=(10, 4))

# 正解率のプロット
plt.subplot(1, 2, 1)
plt.plot(history.history["accuracy"], label="Training Accuracy")
plt.plot(history.history["val_accuracy"], label="Validation Accuracy")
plt.xlabel("Epoch")
plt.ylabel("Accuracy")
plt.legend(loc="lower right")
plt.title("Accuracy")
plt.grid(True)

# 誤差(Loss)のプロット
plt.subplot(1, 2, 2)
plt.plot(history.history["loss"], label="Training Loss")
plt.plot(history.history["val_loss"], label="Validation Loss")
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.legend(loc="upper right")
plt.title("Loss")
plt.grid(True)

plt.tight_layout()
plt.show()
- 結果出力

グラフを見ることで、
- 学習が順調に進んでいるか
- 過学習が発生していないか
を確認できます。
Step6. 学習済みモデルで予測する
最後に、学習済みモデルへ未知の画像を入力して予測を行います。
# 1. テスト用のデータ(本番用)から、例えば「1番目」の画像を取り出す
test_index = 1  # ここを変えれば別の画像も試せます
img = test_images[test_index]

# 2. AIが読める形(1枚の画像を包む箱の形)に変形する
# (32, 32, 3) -> (1, 32, 32, 3)
img_for_ai = np.expand_dims(img, axis=0)

# 3. ここが「AIを使う」コード!
# AIに画像を渡して、10種類の確率を予想させる
predictions = model.predict(img_for_ai)

# 生の数値を「確率(合計100%)」に変換する(ソフトマックス関数)
probabilities = tf.nn.softmax(predictions[0]).numpy()

# 4. 一番確率が高かった正解の「番号」を取り出す
predicted_label_num = np.argmax(predictions[0])

# 5. 番号だと分かりにくいので、名前に変換するリスト
class_names = [
    "飛行機",
    "自動車",
    "鳥",
    "猫",
    "鹿",
    "犬",
    "カエル",
    "馬",
    "船",
    "トラック",
]

# 6. 結果を画面に出して答え合わせ
print(
    f"AIの予想: {class_names[predicted_label_num]} ({probabilities[predicted_label_num]*100:.1f}%)"
)
print(f"本当の正解: {class_names[test_labels[test_index][0]]}")

print("\n--- すべての選択肢の確率内訳 ---")
for i, name in enumerate(class_names):
    print(f"{name}: {probabilities[i]*100:.2f}%")

# 画像も一緒に表示して目で確認
plt.figure(figsize=(4, 4))
plt.imshow(img, interpolation="bicubic")
plt.imshow(img)
plt.grid(False)
plt.axis("off")
plt.show()
- 結果出力
1/1 ━━━━━━━━━━━━━━━━━━━━ 1s 549ms/step
AIの予想: 船 (90.5%)
本当の正解: 船

--- すべての選択肢の確率内訳 ---
飛行機: 4.14%
自動車: 5.34%
鳥: 0.00%
猫: 0.00%
鹿: 0.00%
犬: 0.00%
カエル: 0.00%
馬: 0.00%
船: 90.48%
トラック: 0.04%
モデルは約90%の確率で「船」と予測しており、正解ラベルとも一致しています。
ニューラルネットワークは単に答えを返しているわけではなく、各クラスに対する確率を出力しています。
その中で最も確率が高いクラスを np.argmax() で取得し、最終的な分類結果として利用しています。
まとめ
今回はTensorFlow/Kerasを利用してCNNによる画像分類モデルを構築しました。
実際に手を動かしてみることで、
- 画像データの前処理
- CNNの構築
- モデルの学習
- 性能評価
- 推論
という機械学習プロジェクトの基本的な流れを一通り体験することができました。
今回作成したモデルは比較的シンプルなCNNですが、それでもテストデータに対して約70%の精度を達成できました。
今後は、
- 層を増やしてモデルを深くする
- Dropoutを導入する
- Data Augmentationを試す
- 自分で用意した画像を分類する
といった発展的な内容にも挑戦していきたいと思います。
参考資料