


売上データは Database、ログは Object Storage に、契約書や仕様書は SharePoint に、分析用データは異なるクラウドに——。
「データがあちこちに散らばっていて、AI に使いたくても使えない」

データ活用の世界では、長い間、Data Warehouse と Big Data が別々の文脈で発展してきました。
Data Warehouse は、構造化された業務データを高品質に管理し、BI やレポーティングに使うための基盤です。
一方で Big Data は、ログ、センサーデータ、Webアクセス、JSON、画像、ドキュメントなど、大量・多様・高速に発生するデータを扱うための文脈で広がりました。
その Big Data の受け皿として、データをまず生の形で蓄積する Data Lake が登場しました。
そして現在は、Data Lake の柔軟性と Data Warehouse の管理性・性能を組み合わせる Lakehouse が注目されています。
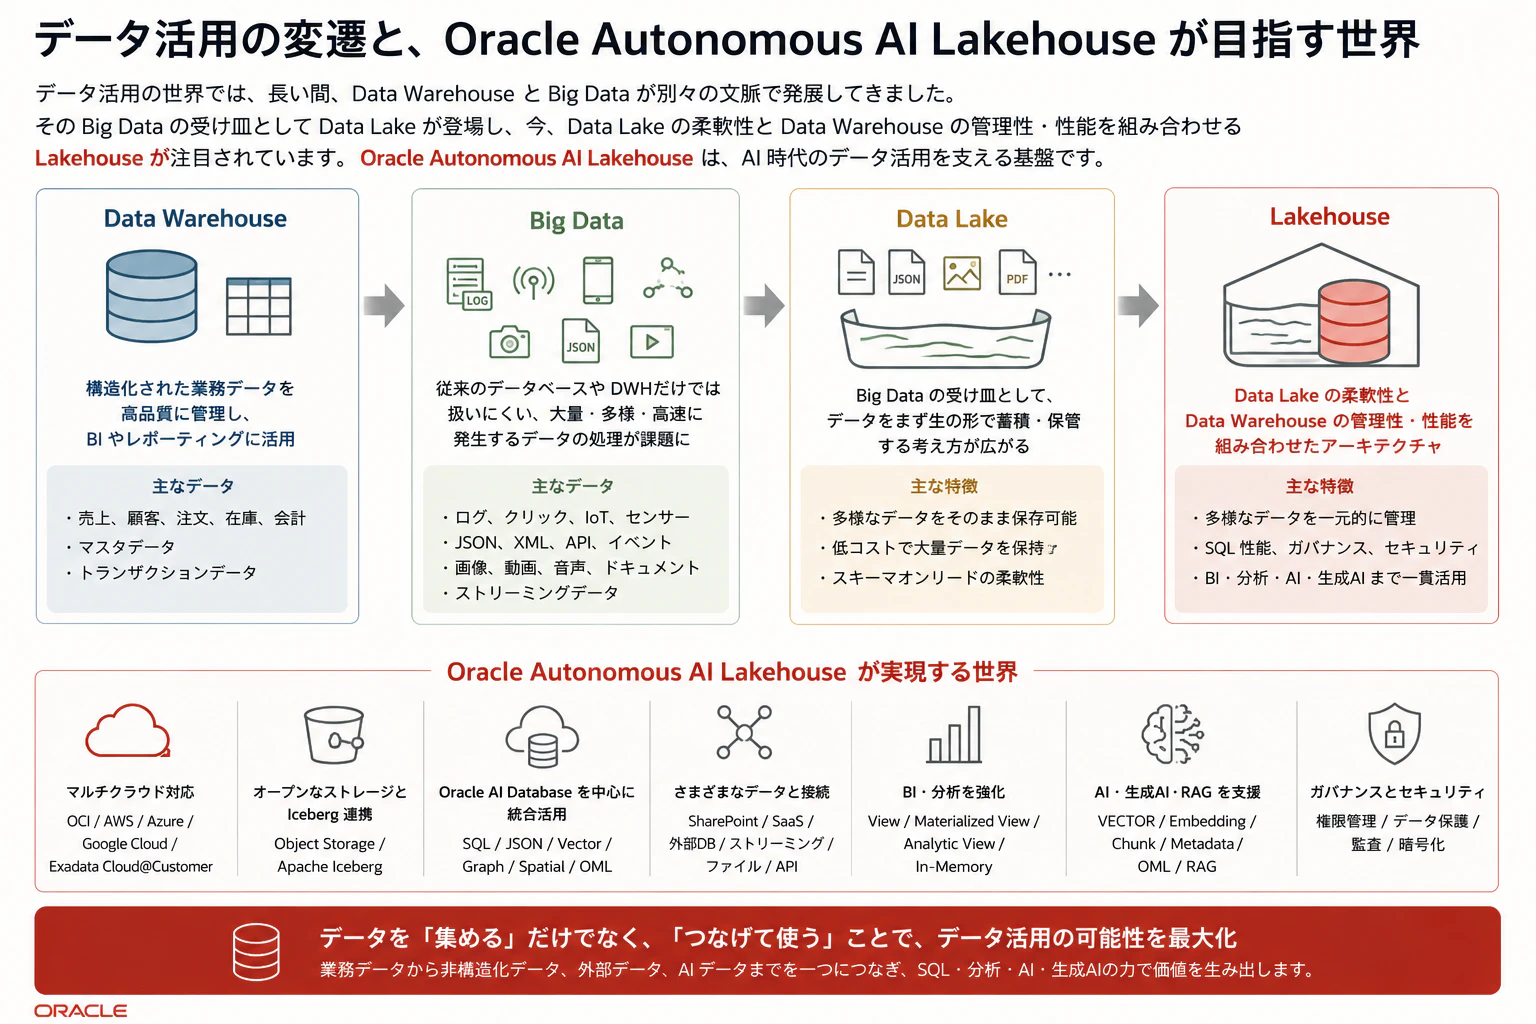
特に Oracle Autonomous AI Lakehouse の文脈では、単に「Object Storage にデータを置く」だけではありません。Oracle AI Database を中心に、Iceberg、Object Storage、外部表、Database Link、SharePoint、SaaS、Vector Search、BI、AI を つなげて使う ところに大きな意味があります。
たとえば、こんなことが SQL の世界からできるようになります。
- SharePoint 上の Word / PDF から、PL/SQL 一発で RAG 向けの Vector Index を作る
- Databricks Unity Catalog や Snowflake Polaris の Iceberg テーブルに直接つないで問い合わせる
- BigQuery や Snowflake 上のデータを、Database Link 経由で Oracle 側のデータと JOIN する
- Oracle AI Database の Table / View を、Delta Sharing や Cloud Links で他の Database やツールへ共有する
- Oracle AI Data Catalog を使って、Oracle 側から Iceberg Table を作成・書き込みする
「え、それ Database からできるの?」と思った方は、ぜひ最後まで読んでみてください。
読み終える頃には、Oracle Autonomous AI Lakehouse が単なる Lakehouse 製品ではなく、OCI・Azure・GCP・AWS をまたいでデータをつなぐ All-Platform な基盤 に見えてくるはずです。
ということで、本稿では、Oracle Autonomous AI Lakehouse を軸に、Lakehouse で扱うデータ、Oracle AI Database から見た Lakehouse、そして実際に「どこに何を置くべきか」を整理します。
Agenda
-
 1. Lakehouse で扱うデータ
-
2. Oracle AI Database から見る Lakehouse
-
3. Oracle Autonomous AI Lakehouse とは何か
- 3-1. Direct metadata.json / 3-2. Iceberg REST Catalog / 3-3. Mounted Catalog / 3-4. 使い分け
- 3-5. Delta Lake・UniForm・Icebergの関係 / 3-6. Oracle AI Data Catalog / 3-7. Time Travel
-
4. Autonomous AI Database で広がるデータ接続
- Object Storage / Load・Link・Feed・Pipeline / SharePoint / SaaS・業務アプリケーション
- 他社製クラウドデータベース / Data Share・Delta Sharing・Cloud Links
-
5. どこに何を置くべきか
-
6. まとめ:Lakehouse は「集める基盤」から「つなげて使う基盤」へ
-
最後に:Oracle Autonomous AI Lakehouse は “全てをつなぐ” データ基盤へ
-
参考資料
本稿のコードは、公式ドキュメントをもとにした構成イメージです。実行には環境ごとのCredential、ネットワークACL、権限設定などが必要です。実機での手順は、別記事の「してみてみた」シリーズで扱う予定です。
■ 1. Lakehouse で扱うデータ
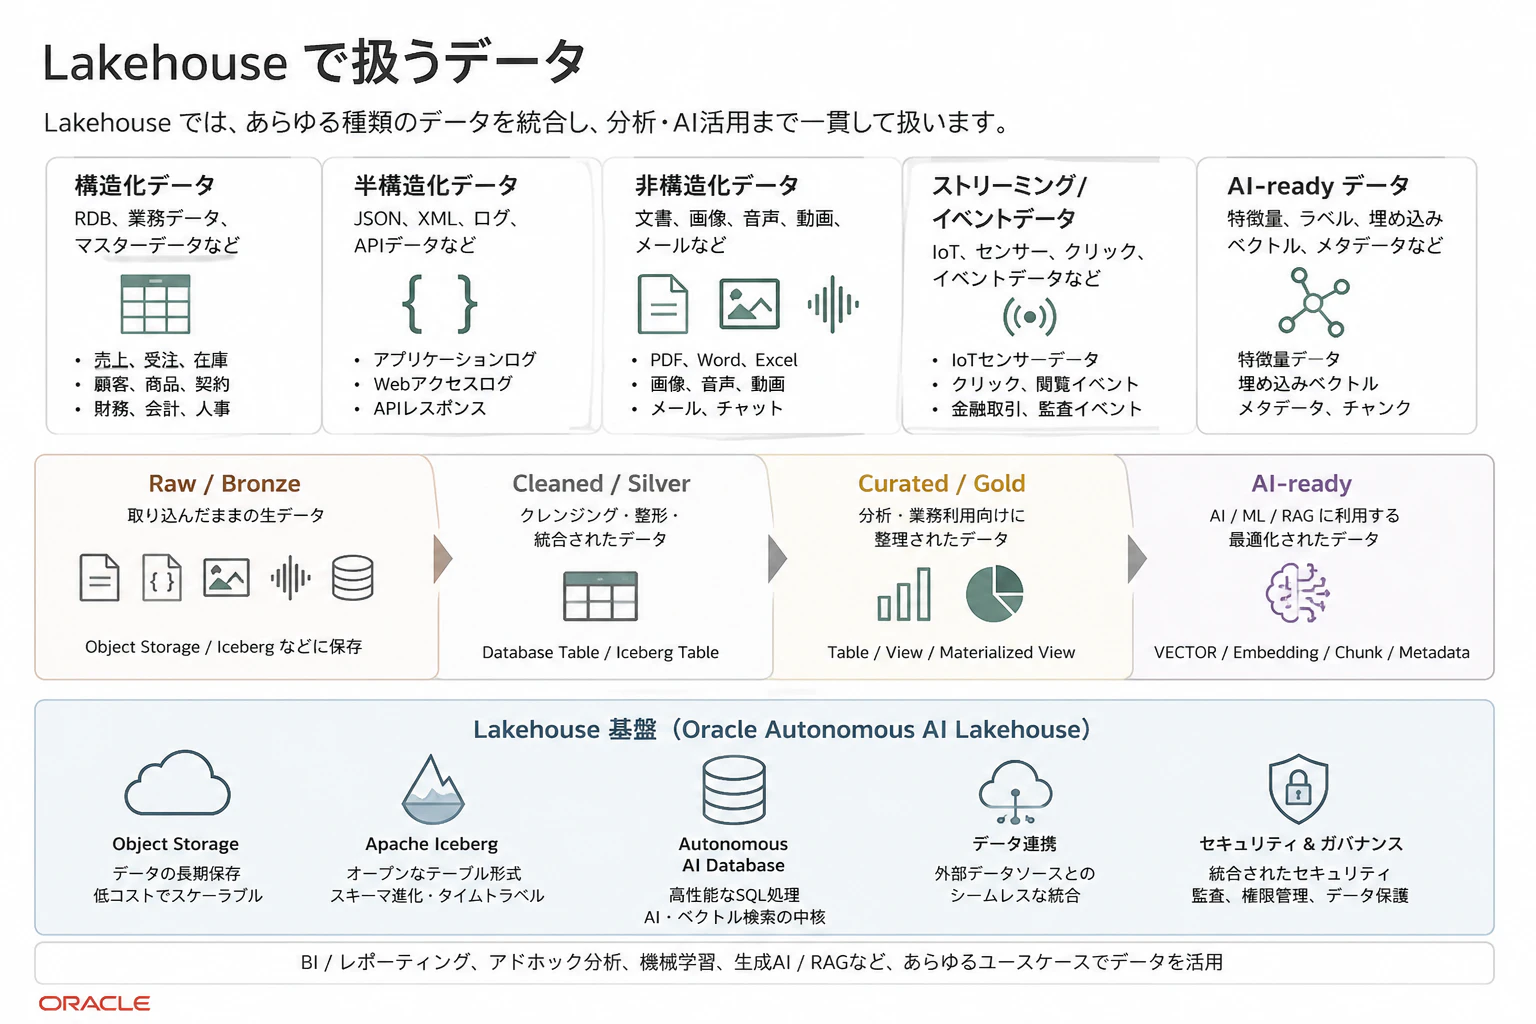
Lakehouse で扱うデータは、一言でいうと かなり幅広いです。
従来の Data Warehouse では、売上、顧客、注文、在庫、会計などの構造化データが中心でした。一方で Lakehouse では、構造化データに加えて、JSON、ログ、PDF、画像、音声、動画、IoT、イベント、Embedding なども扱います。
Oracle のドキュメントでも、Lakehouse は CSV や Parquet、Iceberg などのオープンなファイル・テーブル形式を利用し、構造化、半構造化、非構造化データを格納・処理するものとして説明されています。また、PDF、Word、画像などの非構造化データも Lakehouse の対象として挙げられています。
参考: Autonomous AI Lakehouse - Oracle Documentation
ここではまず「データの形」として、構造化・半構造化・非構造化の3つに分けます。
そのうえで、実務でよく登場するデータを用途別に整理すると、次のようになります。
データの形        → 構造化 / 半構造化 / 非構造化
実務上の分類      → 業務データ / ログ / IoT / 外部データ / 文書 / AIデータ
データの成熟度    → Bronze / Silver / Gold / AI-ready
- データ種別
| データ種別 | 具体例 | 主な用途 |
|---|---|---|
|
構造化データ 表形式で管理しやすいデータ |
売上、顧客、注文、在庫、会計、人事 | BI、KPI、レポート、業務分析 |
|
半構造化データ ある程度構造はあるが表に固定されないデータ |
JSON、XML、API レスポンス、アプリログ | イベント分析、アプリ分析、データ統合 |
|
非構造化データ 表形式にしにくいデータ |
PDF、Word、画像、音声、動画、メール | 検索、要約、RAG、AI 分析 |
Lakehouse の特徴は、この3種類をまとめて扱える点です。従来の DWH は構造化データが中心でしたが、Lakehouse ではログ、ファイル、画像、AI向けデータなども対象になります。
- 実務でよく使われるデータの種類
実務目線では、たとえば業務データ、ログ、IoT、ドキュメント、AI・機械学習用データなどが代表的です。
| 種類 | 具体例 | 主な用途 | Databaseに入れる場合 |
|---|---|---|---|
| 業務データ | 受注、売上、請求、顧客、契約、在庫 | BI、レポート、経営分析 | Table(契約書の本文はVector) |
| マスタデータ | 商品マスタ、顧客マスタ、組織マスタ、拠点マスタ | データ統合、名寄せ、分析の基準 | Table |
| トランザクションデータ | 注文履歴、決済履歴、出荷履歴、予約履歴 | 需要分析、不正検知、顧客分析 | Table |
| ログデータ | アプリログ、Webアクセスログ、監査ログ、システムログ | 障害分析、セキュリティ分析、利用状況分析 | Table(error signature等の代表メッセージはVector) |
| イベントデータ | クリック、閲覧、検索、カート投入、アプリ操作 | 行動分析、レコメンド、マーケティング | Table |
| IoT・センサーデータ | 温度、圧力、振動、位置情報、稼働状況 | 予兆保全、設備監視、リアルタイム分析 | Table |
| ストリーミングデータ | Kafkaイベント、CDC、リアルタイム取引 | リアルタイムダッシュボード、即時検知 | Table |
| 外部データ | 天気、市場データ、人口統計、SNS、パートナーデータ | 需要予測、リスク分析、補助データ | Table(SNS投稿等のテキストはVector) |
| ドキュメントデータ | PDF、契約書、仕様書、問い合わせ文面 | 検索、要約、生成AI、ナレッジ活用 | Vector(ファイル名・日付等の属性はTable) |
| 画像・音声・動画 | 製品画像、監視カメラ、通話録音、検査画像 | AI分析、品質検査、音声認識 | Vector(実体はObject Storage、属性はTable) |
| 地理空間データ | GPS、住所、配送ルート、店舗位置 | 商圏分析、物流最適化、移動分析 | Table(SDO_GEOMETRY等のSpatial型) |
| AI・機械学習用データ | 特徴量、ラベル、学習データ、推論結果、埋め込みベクトル | モデル学習、MLOps、生成AI/RAG | Table + Vector(特徴量・ラベルはTable、EmbeddingはVector) |
仕分けの考え方はシンプルで、SQLで集計・結合・フィルタしたいデータはTable、「意味が近いものを探したい」テキスト・画像・音声はEmbedding化してVector、両方の性質を持つものは属性をTable + 本文をVectorに分けます。
なお、Oracleでは VECTOR はTableの列型のひとつなので、正確には「Table か Vector か」ではなく「行・列として集計する使い方か、Embeddingとして意味検索する使い方か」の仕分けです。ドキュメントデータであれば、1つの表にファイル名や更新日時などの属性列と、チャンク本文の VECTOR 列を同居させる形が実際の設計になります。
非構造化データは「属性 + 本文」に分解するイメージ
上の表で「属性はTable」と括弧書きした部分を、もう少し具体的にすると次のようになります。非構造化データをファイルのまま使うのではなく、メタデータ・属性を抽出してTable化し、意味検索したい本文をEmbedding化してVectorに入れる、という分解です。
| 非構造化データ | Tableに入れる属性・メタデータ | Vectorに入れる対象 |
|---|---|---|
| PDF契約書 | 契約番号、契約先、締結日、金額、更新期限 | 契約条文のチャンク |
| 通話録音 | 通話ID、日時、通話時間、担当者、顧客ID | 文字起こしテキスト |
| 製品画像 | 商品コード、撮影日、解像度、ファイルサイズ | 画像Embedding、キャプション |
| 動画 | タイトル、再生時間、コーデック、撮影日時 | 文字起こし・シーン説明のチャンク |
この「属性を抽出してTable化する」工程が、後述のレイヤーで言う Bronze → Silver に相当し、「本文をEmbedding化する」工程が Feature / AI-ready に相当します。ファイルの実体はObject Storageに置いたまま、Databaseには「集計・フィルタに使う属性」と「意味検索に使うEmbedding」だけを持つのがポイントです。
コラム: なぜVectorだけでなくTableのメタ列が要るのか
「ファイルは全部Vectorに入れればいい」と言われることがありますが、Embeddingが得意なのは「意味が近いものを探す」ことだけです。次のような操作は、日付や種類、取引先IDが構造化された列として存在してはじめて可能になります。
- 日付で絞る(2025年4月以降の契約書を新しい順に)
- 種類で一覧する(契約書だけ、通話録音だけ)
- 数える・集計する(取引先ごとの契約件数)
- 他のデータとJOINする(契約書 × 売上テーブル × 顧客マスタ)
Vectorの類似度スコアには、こうした軸がそもそも入っていません。実務の問い合わせは「Vectorであいまいに探し、属性カラムで正確に絞る・つなぐ・数える」の両輪ではじめて成立します。そして、この2つを同じDatabase内で組み合わせられること(意味検索で絞った結果をそのまま業務データとJOINできること)が、Vector専用DBを別に立てる構成に対するOracle AI Databaseの大きなアドバンテージです。
ここで重要なのは、データの種類だけでなく、データの成熟度も分けて考えることです。
Lakehouse の世界では、Bronze / Silver / Gold というレイヤーでデータを整理する考え方がよく使われます。Databricks の Medallion Architecture では、Bronze は Raw、Silver は validated、Gold は enriched というように、データ品質の段階として説明されています。
参考: Databricks Medallion Architecture
Oracle Autonomous AI Lakehouse で考える場合も、この整理は非常に使いやすいです。
Bronze / Silver / Gold + AI-ready のレイヤー
Bronze / Silver / Gold という3層に、AI活用では Feature / AI-ready を加えて考えます。
| レイヤー | 内容 | Oracle でのイメージ |
|---|---|---|
| Raw / Bronze | 取り込んだままの生データ | Object Storage、Iceberg、Parquet、CSV、JSON、PDF、ログ |
| Cleaned / Silver | クレンジング、型変換、重複排除、結合済みデータ | Database Table、External Table、Iceberg Table |
| Curated / Gold | BI や業務利用向けに整理されたデータ | Table、View、Materialized View、Analytic View |
| Feature / AI-ready | AI / ML / RAG で使いやすい形にしたデータ | VECTOR 列、Embedding Table、Chunk Table、Metadata Table |
つまり Lakehouse では、単に「いろいろなデータを置ける」だけでは不十分です。
生データ → 整形済みデータ → 分析用データ → AI活用データ
のように段階的に管理することが多いです。
大切なのは、
生データを保持すること、
分析しやすい形に整えること、
業務で使える意味のあるデータにすること、
そして AI が使える形に変換することです。
Lakehouse で利用されるデータは、細かく見ると無数にあります。
ただし、実務上は次の一文にまとめると十分です。
Lakehouse は、DWH 的な業務データと、Data Lake 的な多様な生データをまとめて扱う基盤です。
■ 2. Oracle AI Database から見る Lakehouse
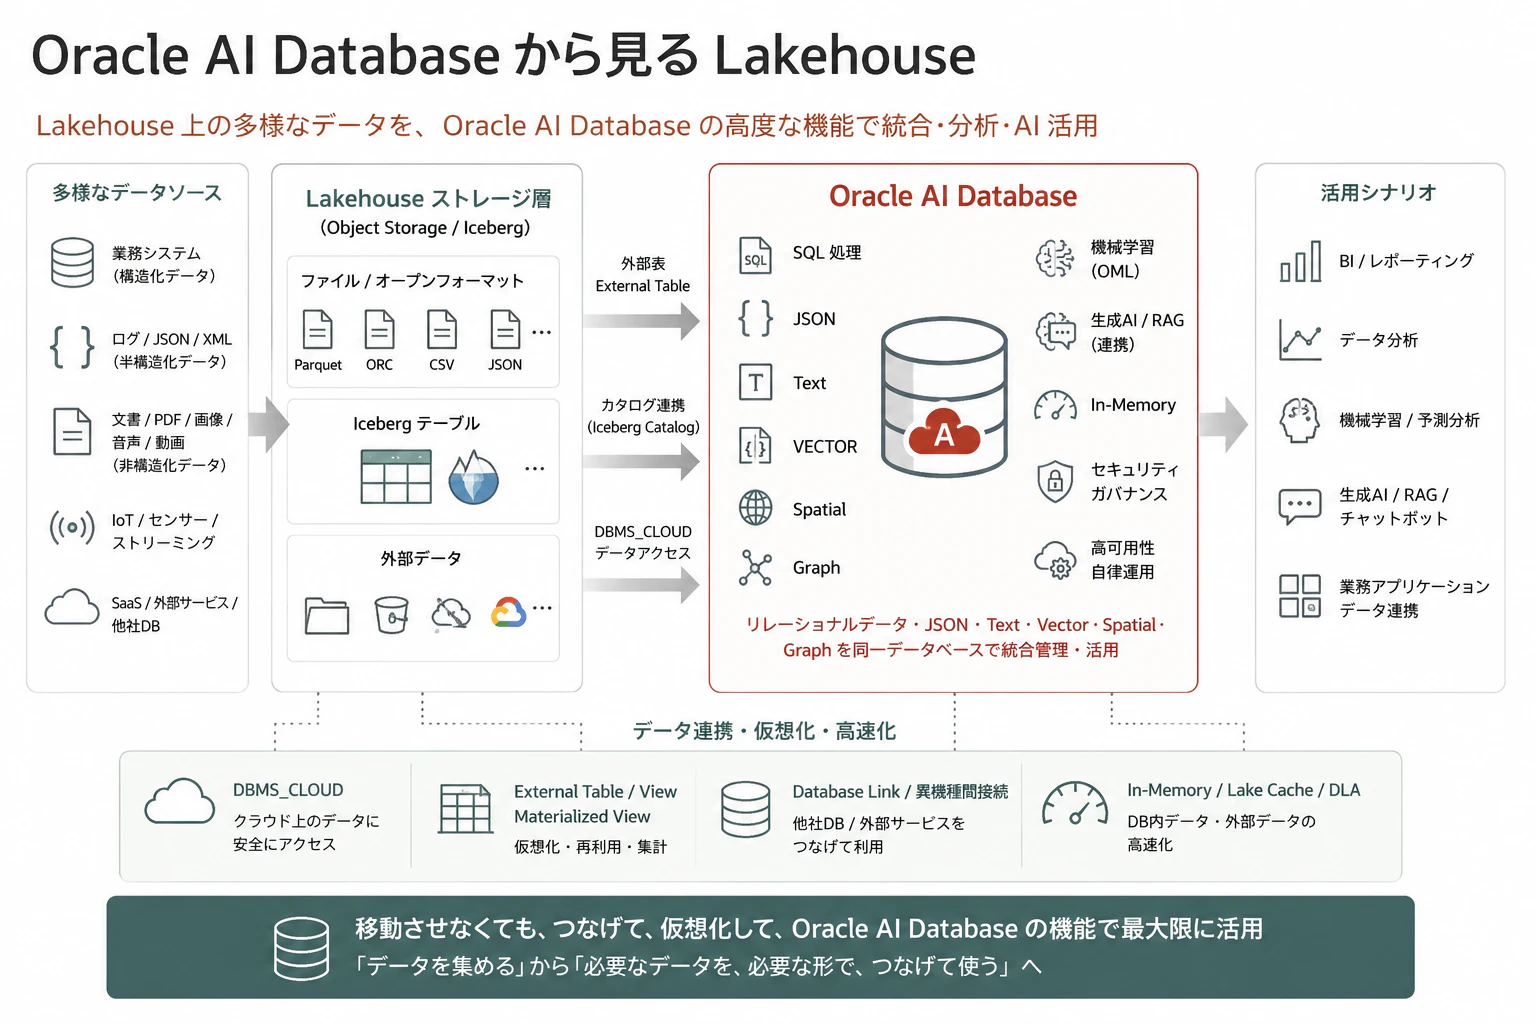
Oracle AI Database から Lakehouse を見ると、少し面白い見方ができます。
一般的な説明では、Lakehouse は Object Storage や Iceberg のようなストレージ層を中心に語られることが多いです。しかし Oracle の場合、Database 側が非常に強力です。Oracle Autonomous AI Database は、JSON、Graph、Vector、Oracle Machine Learning、Spatial などを扱える統合的なデータ基盤として位置づけられています。
参考: Autonomous AI Lakehouse - Oracle Documentation
つまり、Oracle AI Database は単なる「構造化データを入れる箱」ではありません。
Oracle AI Database では、リレーショナルデータだけでなく、JSON、Text、Vector、Spatial、Graph などを同じ Database の中で扱えます。特に JSON については、トランザクション、索引、宣言的な SQL クエリ、View などのリレーショナルデータベース機能と組み合わせてネイティブに扱えます。さらに、JSON データをリレーショナルデータと JOIN したり、外部表上の JSON を Database 内から問い合わせたりできます。
参考: JSON in Oracle AI Database
AI の観点では、Oracle AI Vector Search が重要です。Oracle AI Database 26ai では VECTOR データ型により、Embedding を業務データと同じ Database 内に格納できます。非構造化データを Embedding に変換し、セマンティック検索や RAG に利用できます。
参考: Oracle AI Vector Search Overview
この点が、Oracle らしい Lakehouse の特徴です。
一般的な Lakehouse では、
- Lake にデータを置く
- 別のエンジンで分析する
- 別の Vector DB に Embedding を置く
というように、複数のコンポーネントを組み合わせることが多くなります。
一方で Oracle AI Database を使う場合は、次のように考えられます。
Object Storage / Iceberg / 外部データ
        ↓
External Table / DBMS_CLOUD / Catalog / Database Link
        ↓
Oracle AI Database
        ↓
SQL / JSON / Text / Vector / Spatial / Graph / ML / BI / RAG
もちろん、すべてのデータを Database 内にコピーする必要はありません。Object Storage 上のファイルは外部表として問い合わせられます。Autonomous AI Database では、DBMS_CLOUD.CREATE_EXTERNAL_TABLE を使って Cloud 上のファイルに対する外部表を作成でき、OCI Object Storage、Azure Blob / ADLS、Amazon S3、Google Cloud Storage 互換ストレージなどが対象に含まれます。
参考: Query External Data with Autonomous Database
そのため、Oracle AI Database から見る Lakehouse は、次のように捉えると分かりやすいです。
Lakehouse ストレージ上のデータを、Oracle AI Database の SQL、ガバナンス、View、Materialized View、JSON、Vector、Text、Graph、Spatial、AI 機能で活用するアーキテクチャ
性能面では In-Memory も重要です。Oracle AI Database の Database In-Memory は、リアルタイム分析や混在ワークロードの性能改善を目的とした機能で、テーブル、パーティション、サブパーティション、Materialized View、さらに外部表も In-Memory 化の対象として説明されています。
参考: Use Database In-Memory with Autonomous Database
そのため、In-Memory は「保存先」ではなく、高速化レイヤーとして考えることができます。
また、Oracle Autonomous AI Database では、Lakehouse を高速化する機能 Lake Cache / Data Lake Accelerator (DLA) があります。
Lake Cache と Data Lake Accelerator は、Object Storage 上の外部データを高速にスキャン・クエリするための機能です。両者は「データレイクハウス環境のクエリ高速化」という目的は同じですが、アプローチが異なります。なお、Data Lake Accelerator は現時点で OCI、Azure、GCP 上の AI Lakehouse で利用できます。
・高速化レイヤー
| 機能 | 主な役割 | 仕組み | 適したユースケース |
|---|---|---|---|
| In-Memory | Database 内データの分析高速化 | Table、Partition、Materialized View、外部表などを In-Memory Column Store に列形式で保持する | Database 内のホットデータ、繰り返し実行される分析クエリ、集計、JOIN |
| Lake Cache | 外部データの繰り返しアクセス高速化 | 外部表や Mounted Catalog Table の頻繁に使われるデータを Autonomous AI Database 内にローカルキャッシュする | 定期ダッシュボード、定型レポート、同じ外部データを繰り返し参照する分析 |
| Data Lake Accelerator | 大規模な外部データスキャンの高速化 | Oracle-managed VM cluster 上の追加コンピュートにより、外部データの scan / filtering / projection / decompression をオフロードする | 大規模履歴データ、アドホック分析、広範囲スキャン |
参考: Use Lake Cache to Improve Performance for External Tables and Mounted Catalog Tables / Data Lake Accelerator

■ 3. Oracle Autonomous AI Lakehouse とは何か
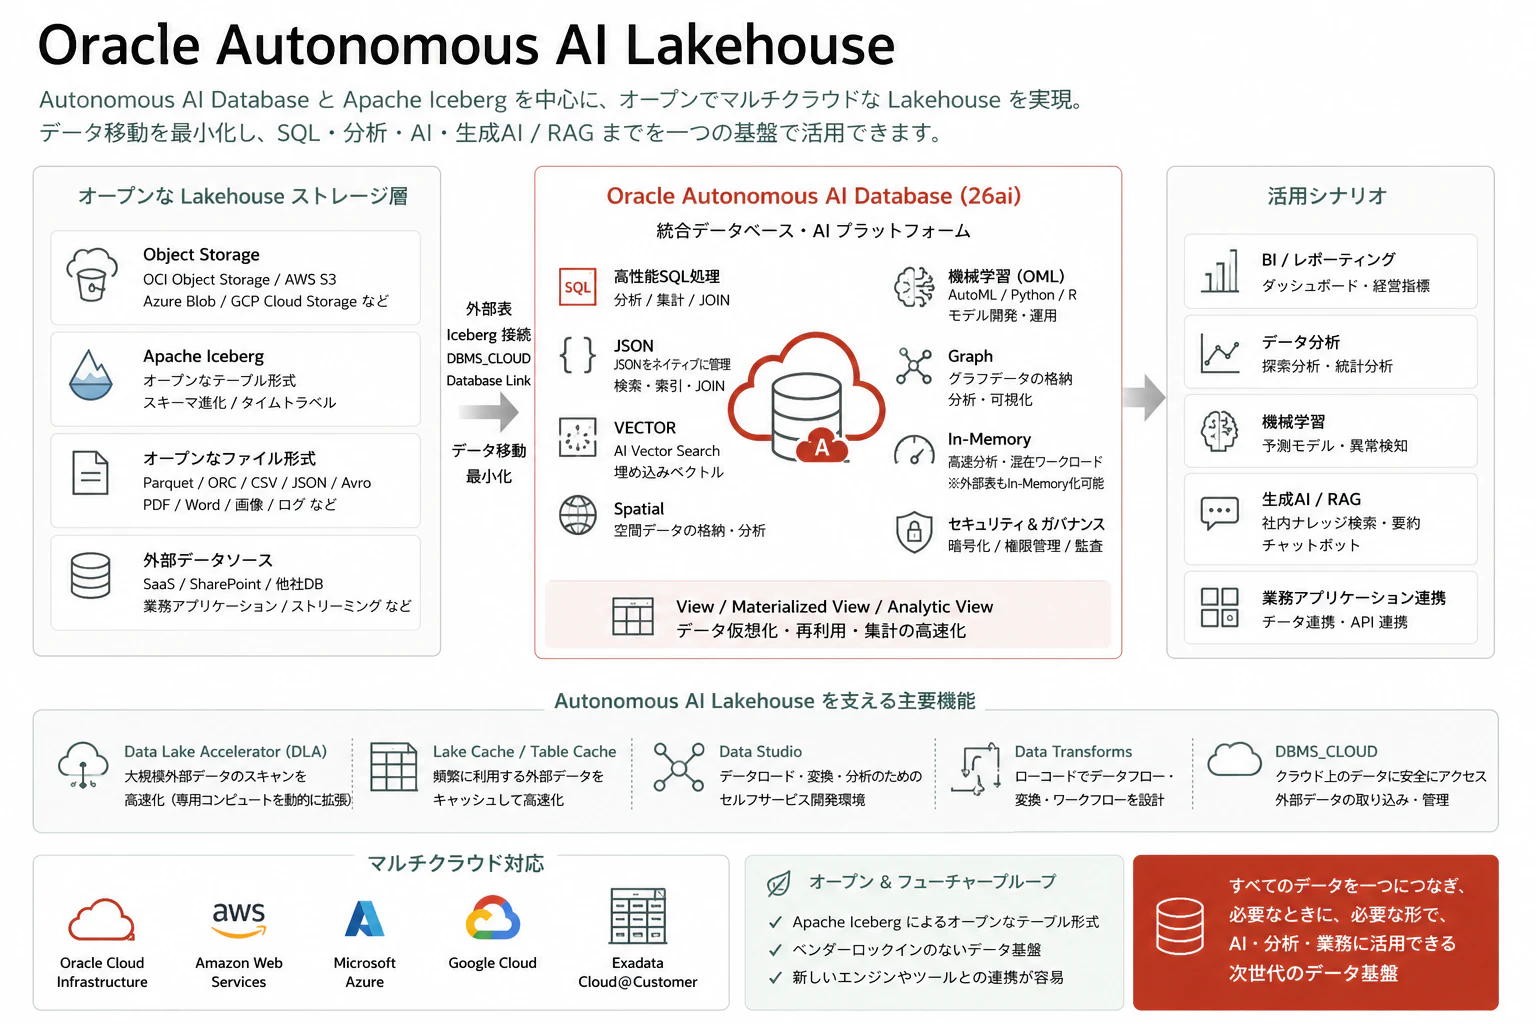
Oracle Autonomous AI Lakehouse は、Oracle Autonomous AI Database と Apache Iceberg を組み合わせた、オープンでマルチクラウド対応の Lakehouse プラットフォームとして位置づけられています。
この説明で重要なのは、Apache Iceberg です。
Iceberg は、オープンなテーブル形式です。データを特定ベンダーの閉じた形式に閉じ込めるのではなく、複数のエンジンから読み書きしやすい形で管理できるのが大きな特徴です。
そして、Oracle Autonomous AI Database から Iceberg を使う場合、接続方法は実務上、次の 3パターン に整理して考えると分かりやすいです。
-
Direct metadata.json
S3 や Object Storage 上の Iceberg テーブルのmetadata.jsonを直接指定して読む方法 -
Iceberg REST Catalog
Databricks Unity Catalog などの REST Catalog を経由してテーブルを参照する方法 -
Mounted Catalog
Snowflake Open Catalog(Polaris)などの Catalog 全体を Oracle 側にマウントして使う方法

この3つを理解しておくと、Iceberg 接続で技術的に迷いにくくなります。
- 単一テーブルを手軽に読みたい → Direct metadata.json
- Catalog 管理された最新テーブルを標準的に使いたい → Iceberg REST Catalog
- Catalog 全体を Oracle から一覧・参照したい → Mounted Catalog
以下、それぞれを順番に見ていきます。
3-1. Direct metadata.json:まず試すのに一番シンプルな方法
もっともシンプルなのは、Iceberg テーブルの root metadata、つまり metadata.json を直接指定する方法です。
たとえば、AWS S3 上の Iceberg テーブルであれば、metadata.json の URL を DBMS_CLOUD.CREATE_EXTERNAL_TABLE に渡すだけで、Oracle Autonomous AI Database から外部表として問い合わせできます。
-- S3 上の Iceberg テーブルを外部表として定義(metadata.json を直接指定)
BEGIN
  DBMS_CLOUD.CREATE_EXTERNAL_TABLE(
    table_name      => 'CUSTOMERS_ICEBERG_EXT',
    credential_name => 'S3_CRED',
    file_uri_list   => 'https://<bucket>.s3.<region>.amazonaws.com/<path>/metadata/<xxxx>.metadata.json',
    format          => '{"access_protocol":{"protocol_type":"iceberg"}}'
  );
END;
/

-- あとは普通の表と同じように SELECT できる
SELECT COUNT(*) FROM CUSTOMERS_ICEBERG_EXT;
この方法の良いところは、とにかく手軽 なことです。
- Catalog を用意しなくてよい
- 単一テーブルをすぐ読める
- 検証や PoC に向いている
一方で、この方式は 指定した時点のスナップショットを読む 形になります。
つまり、Iceberg テーブルの最新状態に自動追従したい場合には少し不向きです。
そのため、この方式は次のような場面に向いています。
- まず 1 テーブルを読んでみたい
- PoC や動作確認をしたい
- スナップショット固定でも問題ない
3-2. Iceberg REST Catalog:標準的に Catalog 管理された Iceberg を使う方法
次に重要なのが、Iceberg REST Catalog を経由する方法です。
Lakehouse の世界では、単に Object Storage にファイルが置いてあるだけでは不十分です。
どのテーブルがどこにあり、どのスキーマで、どの権限で、どのエンジンから利用できるのか——そうした情報を管理する Catalog が重要になります。
Oracle Autonomous AI Database では、Databricks Unity Catalog などの Iceberg REST 互換 Catalog に接続し、その管理下のテーブルを問い合わせることができます。
この方式の特徴は、次の通りです。
- Catalog 管理されたテーブルを使える
- 最新スナップショットに追従しやすい
- Lakehouse の標準的な運用に乗せやすい
つまり、PoC の次の段階、あるいは実運用で「Iceberg をちゃんと Catalog 管理して使いたい」場合は、この方式が本命になります。
Databricks Unity Catalog の対応状況について
2026年8月21日時点のOracle公式ドキュメントでは、Unity CatalogのNative Iceberg対応について、互換性表とRestrictionsの記載が一致していません。本稿では、Delta Lake + UniFormを基本経路として扱います。Native Icebergの対応状況やREST endpointは、利用時点の最新ドキュメントを確認してください。
コードのイメージも見てみます。Databricks Unity Catalog を例にすると、format パラメータに REST Catalog の接続情報を指定して外部表を作成します。
-- Databricks の Service Principal(OAuth2)を資格証明として登録
BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'UNITY_OAUTH',
    username        => '<client_id>',
    password        => '<client_secret>');
END;
/

-- Unity Catalog の Iceberg REST エンドポイント経由で外部表を作成
BEGIN
  DBMS_CLOUD.CREATE_EXTERNAL_TABLE(
    table_name      => 'CUSTOMERS_ICEBERG',
    credential_name => '<オブジェクトストレージの資格証明>',
    format          => '{
      "access_protocol": {
        "protocol_type": "iceberg-rest",
        "protocol_config": {
          "iceberg_catalog_type": "unity",
          "rest_catalog_endpoint": "https://<workspace-host>/api/2.1/unity-catalog/iceberg",
          "rest_authentication": {
            "rest_auth_cred": "UNITY_OAUTH",
            "rest_auth_endpoint": "https://<workspace-host>/oidc/v1/token"
          },
          "table_path": ["<catalog>","<schema>","customers_iceberg"]
        }
      }
    }'
  );
END;
/

SELECT COUNT(*) FROM CUSTOMERS_ICEBERG;
Databricks 側で管理されているテーブルに、Oracle 側から普通の SQL で届く——これが「つなげて使う」の実感です。
なお、REST Catalog 接続では、Catalog への認証用と、Object Storage 上のデータファイル読み取り用の 2 種類の Credential が必要です。片方だけ設定して認証エラーになるのが典型的なハマりポイントなので、最初に両方を用意しておくとスムーズです。
3-3. Mounted Catalog:Catalog 全体を Oracle から扱う方法
さらに面白いのが、Catalog 自体を Oracle 側にマウントして使う方法 です。
Snowflake Open Catalog(Polaris)では、単一テーブルをその都度定義するのではなく、Catalog 全体を Oracle Autonomous AI Database にマウントできます。
-- Polaris の OAuth2 資格証明を登録(トークン自動リフレッシュ付き)
BEGIN
  DBMS_SHARE.CREATE_BEARER_TOKEN_CREDENTIAL(
    credential_name    => 'POLARIS_OAUTH',
    bearer_token       => '<初回取得したアクセストークン>',
    token_endpoint     => 'https://<org>-<account>.snowflakecomputing.com/polaris/api/catalog/v1/oauth/tokens',
    client_id          => '<client_id>',
    client_secret      => '<client_secret>',
    token_refresh_rate => 3600,
    token_scope        => 'PRINCIPAL_ROLE:ALL',
    grant_type         => 'client_credentials');
END;
/

-- Polaris カタログをマウント
BEGIN
  DBMS_CATALOG.MOUNT_ICEBERG(
    catalog_name            => 'MY_POLARIS',
    endpoint                => 'https://<org>-<account>.snowflakecomputing.com/polaris/api/catalog/v1/<カタログ名>',
    catalog_credential      => 'POLARIS_OAUTH',
    data_storage_credential => '<S3 の資格証明>',
    catalog_type            => 'ICEBERG_POLARIS');
END;
/

-- マウントしたカタログの中身を、ディクショナリビューのように覗ける
SELECT owner, table_name FROM all_tables@MY_POLARIS;

-- Snowflake が S3 に書いた Iceberg テーブルを、そのまま SELECT
SELECT * FROM "SALES_NS"."CRSK_SALES"@MY_POLARIS;
この方式の特徴は、次の通りです。
- 複数テーブルをまとめて扱いやすい
- Catalog 内のテーブル一覧を Oracle から参照できる
- 単一テーブル接続よりも、Catalog 全体との連携感が強い
たとえば、all_tables@MY_POLARIS のように、Database Link に近い感覚で Catalog 内のテーブル一覧を確認できます。
さらに、Snowflake が S3 上に保持している最新の Iceberg テーブルを、データ移動なしで Oracle 側から参照できます。
この方式は、次のような場面に向いています。
- 1テーブル単位ではなく、Catalog 単位で使いたい
- 複数のテーブルを一覧・探索しながら利用したい
- Snowflake Open Catalog / Polaris との連携を強くしたい
参考: Manage Catalogs with DBMS_CATALOG / Connecting Oracle Database to Snowflake Iceberg Tables Through Polaris Catalog
3-4. Iceberg 接続パターンの使い分け
ここまでの 3 パターンを、使い分けの観点でまとめると次のようになります。
| 接続方式 | 向いている用途 | 特徴 |
|---|---|---|
| Direct metadata.json | 単一テーブルをすぐ読みたい、PoC、手軽な検証 | シンプル、軽量、ただし特定スナップショット寄り |
| Iceberg REST Catalog | 実運用、Catalog 管理、最新追従 | 標準的、運用しやすい、Lakehouse らしい構成 |
| Mounted Catalog | 複数テーブル、Catalog 全体の活用、一覧参照 | 可視性が高い、Catalog ごと使える、連携感が強い |
この 3 パターンを理解しておくと、Iceberg 接続を「単なるファイル参照」としてではなく、
どのレベルで Lakehouse とつながるのか
という観点で整理できるようになります。
個人的には、Oracle Autonomous AI Database から見る Iceberg 接続は、
「ファイルを読む」 → 「Catalog を使う」 → 「Catalog を丸ごと使う」
という段階で理解すると、とても分かりやすいです。
3-5. Delta Lake / UniForm / Iceberg の関係を整理する
ここまで Iceberg を中心に見てきましたが、Databricks を利用している場合は、Delta Lake のデータを Oracle Autonomous AI Database からどのように読むのかも気になります。
ということで、ここで Delta Lake、UniForm、Iceberg、Delta Sharing の違いを整理してみてみます。
まず重要なのは、Delta Lake と Delta Sharing は別のものという点です。
| 名称 | 役割 | Oracle Autonomous AI Database から見た位置づけ |
|---|---|---|
| Delta Lake | Parquetなどのデータファイルと、トランザクション・Schema・Versionを管理するTable Format | UniFormが生成したIceberg Metadataを経由して問い合わせる |
| Apache Iceberg | Snapshot、Schema、Partitionなどを管理するOpen Table Format | External TableまたはMounted Catalogとして問い合わせる |
| UniForm | Delta Lake TableにIceberg互換Metadataを生成する相互運用レイヤー | Delta LakeのデータをIcebergクライアントから読めるようにする |
| Delta Sharing | Databaseやツール間でデータを共有するためのRESTベースの共有プロトコル | Data ShareのVersioned Shareで利用する |
Delta LakeとIcebergは、どちらもデータファイルとメタデータレイヤーを組み合わせてTableを管理します。
ただし、両者のメタデータ形式は異なります。
UniFormを有効にすると、Delta Lakeのデータファイルを書き換えることなく、Delta Lake Metadataとは別にIceberg Metadataが生成されます。
Delta Lake Table
  ├─ Parquet Data Files
  ├─ Delta Metadata
  │    └─ _delta_log
  │
  └─ UniForm
       └─ Iceberg Metadata
            ├─ metadata.json
            ├─ Manifest List
            └─ Manifest Files
                    ↓
          Unity Catalog / metadata.json
                    ↓
       Oracle Autonomous AI Database
つまり、Oracle Autonomous AI DatabaseがDelta Lakeの_delta_logを直接解釈するのではありません。
UniFormが生成したIceberg Metadataを、Unity CatalogのIceberg REST endpointまたはmetadata.json経由で読み、Iceberg Tableとして問い合わせます。
Databricks側で、Unity Catalogに登録したDelta TableへIceberg reads(UniForm)を有効にするイメージは、次のようになります。新規作成時は、Databricksが互換性の観点から推奨するid方式のColumn Mappingを使用します。
CREATE TABLE customers_delta (
  id   INT,
  name STRING
)
USING DELTA
TBLPROPERTIES (
  'delta.columnMapping.mode' = 'id',
  'delta.enableIcebergCompatV2' = 'true',
  'delta.universalFormat.enabledFormats' = 'iceberg'
);
これにより、1つのParquetデータをDelta LakeクライアントとIcebergクライアントの両方から利用できます。
Databricks / Spark
       ↓ Delta Lake
同じ Parquet Data Files
       ↑ Iceberg Metadata
Oracle Autonomous AI Database
ただし、Iceberg MetadataはDelta Lakeへの書き込み後に非同期で生成されるため、Delta Lake側の最新Commitが外部Icebergクライアントから即座に見えるとは限りません。
また、Iceberg読み取りを有効にしたDelta TableではDeletion Vectorsなどの機能に制約があります。Delta Sharing経由で受け取る場合も、Autonomous AI DatabaseはDeletion Vectorsが有効なDelta Tableを読み取れない点に注意が必要です。
この関係を一文でまとめると、次のようになります。
Delta LakeのデータをOracle Autonomous AI Databaseから利用する場合は、UniFormが生成したIceberg Metadataを経由してIceberg Tableとして問い合わせる。
参考: Query Apache Iceberg Tables / Read Delta Lake tables with Iceberg clients / Share and Consume Data with Data Share in Autonomous AI Database
3-6. Oracle AI Data Catalog:Oracle 側で Iceberg Catalog を持つ
これまで、Databricks Unity CatalogやSnowflake Open Catalog / Polarisなど、外部のIceberg CatalogへOracle Autonomous AI Databaseから接続する方法を見てきました。
一方で、Oracle側にもOracle-managedなIceberg REST Catalogがあります。
それが Oracle AI Data Catalog です。
Oracle AI Data Catalogは、Iceberg TableのMetadata、Namespace、Schema、Snapshot、Transactionなどを管理するIceberg REST Catalog Serviceです。
テナンシ内の1つのAutonomous AI DatabaseをCatalog Repositoryとして利用し、同じテナンシ内の他のAutonomous AI Databaseから、権限に応じて共通のCatalogへ接続できます。
Spark / Data Transforms / Oracle AI Database
                    ↓
             Iceberg REST API
                    ↓
          Oracle AI Data Catalog
                    ↓
     Table Metadata / Snapshot / Schema
                    ↓
      Object Storage / ADLS / ZFS
                    ↓
             Parquet Data Files
重要なのは、Oracle AI Data Catalogが実データそのものをDatabase内へ取り込む仕組みではない点です。
CatalogはIceberg TableのMetadata Locationを返し、Query Engineはその情報を使ってObject Storage上のデータファイルを直接読みます。
既存のIceberg TableをOracle AI Data Catalogへ登録することもできます。
さらに面白いのは、Oracle AI Data CatalogなどのIceberg REST CatalogをDBMS_CATALOG.MOUNT_ICEBERGでマウントすると、Oracle AI DatabaseからCatalog内にIceberg Tableを作成し、SQLでデータを書き込めることです。
以下はS3互換ストレージを利用する例です。実行前にCatalogのマウント、CatalogとObject StorageのCredential、ネットワークACL、および実行環境に応じたADPUSER / DWROLEなどの権限を設定します。
CREATE ICEBERG TABLE "SILVER"."CUSTOMER_PROFILE"
(
  customer_id   STRING,
  customer_name STRING
)
WITHIN CATALOG "ORACLE_ICEBERG"
STORAGE LOCATION
  "s3://<warehouse>/SILVER/CUSTOMER_PROFILE/";
作成直後にTableが見えない場合は、DBMS_CATALOG.FLUSH_CATALOG_CACHE('<catalog_name>')でCatalog Cacheをフラッシュします。また、Schema名 + Table名 + Catalog名の合計は113文字以内、列名は128文字以内、Table名に$や#は使用不可、DatabaseキャラクタセットはAL32UTF8が前提、Iceberg TableのPartitionは未サポート、といった制約もあります。
作成したIceberg Tableには、通常のOracle Tableからデータを投入できます。
INSERT INTO "SILVER"."CUSTOMER_PROFILE"@ORACLE_ICEBERG
SELECT TO_CHAR(customer_id),
       customer_name
FROM   customers;

COMMIT;
問い合わせる場合も、Mounted Catalogと同じ感覚で@catalog_nameを使います。
SELECT *
FROM "SILVER"."CUSTOMER_PROFILE"@ORACLE_ICEBERG;
ここまで来ると、Oracle Autonomous AI Databaseは単に外部Iceberg Tableを読むだけではありません。
外部 Iceberg を読む
        ↓
Iceberg Catalog をマウントする
        ↓
Oracle 側で Iceberg Catalog を持つ
        ↓
Oracle SQL から Iceberg Table を作成・書き込みする
というところまで広がります。
ここで、名前が似ているCatalog関連の機能を整理すると、次のようになります。
| 名称 | 主な役割 |
|---|---|
| Oracle AI Data Catalog | Oracle-managedなIceberg REST Catalog Service |
| Data Studio Catalog | Database内外のデータ、Catalog、Share、DB Linkなどを横断検索・発見する画面 |
| DBMS_CATALOG | CatalogをMountし、schema.table@catalogとして参照・管理するPL/SQL Package |
| DBMS_DCAT | 外部CatalogのMetadataを同期し、保護SchemaやExternal TableとしてOracle側へ展開するPL/SQL Package |
| Unity Catalog / Polaris / AWS Glue | Databricks、Snowflake、AWS側でIceberg Metadataなどを管理する外部Catalog |
Data Studio Catalogは、ローカルのTableやViewだけでなく、Database Link、Cloud Storage、OCI Data Catalog、AWS Glue、Delta Sharing、Iceberg Catalogなどを横断して検索できます。
見つけたデータは、そのままPreview、Load、Link、Query、Shareなどの次の操作へつなげられます。
つまり、
Oracle AI Data Catalog
  → Iceberg Metadataを管理する

Data Studio Catalog
  → データを探す・理解する・次の操作へ進む

DBMS_CATALOG
  → CatalogをMountしてSQLから使う

DBMS_DCAT
  → Catalog MetadataをOracle側へ同期する
という違いです。
Oracle Autonomous AI Lakehouseは、外部Catalogを利用するConsumerであるだけでなく、Oracle側からIceberg Catalogを提供するProviderにもなれる、ということになります。
参考: Oracle AI Data Catalog / Discover and Manage Data with Catalog in Autonomous AI Database / DBMS_CATALOG Package / Manage Catalogs with DBMS_CATALOG / DBMS_DCAT Package / CREATE ICEBERG TABLE
3-7. Iceberg の Snapshot を Oracle SQL で Time Travel する
Icebergの大きな特徴の1つがSnapshotです。
Iceberg Tableでは、データの変更ごとにSnapshotとMetadataが管理されるため、過去の時点のTableを問い合わせるTime Travelができます。
対応構成では、Iceberg External Tableに対してOracle SQLのAS OF TIMESTAMPを利用できます。2026年8月時点の公式ドキュメントでは、Databricks、AWS Glue、OCI Object Storage上のHadoop Catalogが対象として案内されています。一方で、Snowflake PolarisとDirect metadata.jsonはTime Travelの対象外です。
まず、利用可能なSnapshotを確認します。
SELECT snapshot_id,
       committed_at
FROM   TABLE(
         DBMS_CLOUD.ICEBERG_TABLE_HISTORY(
           'CUSTOMERS_ICEBERG'
         )
       )
ORDER BY committed_at;
続いて、過去の時点を指定して問い合わせます。
SELECT *
FROM   customers_iceberg
       AS OF TIMESTAMP
       TO_TIMESTAMP(
         '2026-08-01 00:00:00',
         'YYYY-MM-DD HH24:MI:SS'
       );
これにより、Object Storage上のデータをOracle AI Databaseへコピーしなくても、月末時点の再現、変更前後の比較、Pipeline実行前後の検証などができます。
現在の Snapshot
      │
      ├─ 2026-08-01 の Snapshot
      ├─ 2026-07-01 の Snapshot
      └─ 2026-06-01 の Snapshot
                  ↓
          AS OF TIMESTAMP
                  ↓
          Oracle SQLで問い合わせ
ただし、IcebergのSnapshotを利用する際には、いくつか注意点があります。
| 項目 | 注意点 |
|---|---|
| Direct metadata.json | 指定したMetadataに固定され、新しいSnapshotへ自動追従しない |
| Schema Evolution | Oracle側のExternal Tableは作成時のSchemaを持つため、Schema変更時に再作成が必要になる場合がある |
| Merge-on-Read | Delete Fileを使用するTableは問い合わせに失敗する場合がある |
| Copy-on-Write | 更新後の状態を新しいData Fileとして保持する方式は利用できる |
| Iceberg TableのPartition | 読み取り・作成とも未サポート(非Partition Tableのみ)。なお、Object StorageのHive形式フォルダ構造を利用するImplicit Partitioning(5章)とは別の機能 |
| Credential | Catalog用CredentialとObject Storage用Credentialを分けて用意する |
| Snapshot Retention | 過去Snapshotの保持期間はOracle Flashbackではなく、Iceberg側のMetadataとStorage Lifecycleに依存する |
Direct metadata.jsonは、再現性のある固定Snapshotを読む用途には向いています。ただしこれは、AS OF TIMESTAMPで自由に時点を選べるという意味ではなく、「指定した1時点に固定される」という意味です。
一方で、継続的に更新されるTableの最新Snapshotへ追従する場合は、Catalog Managedな接続の方が適しています。
再現性・監査・PoC
  → Direct metadata.json

最新Snapshotへの追従・実運用
  → REST Catalog / Mounted Catalog
参考: Query Apache Iceberg Tables
■ 4. Autonomous AI Database で広がるデータ接続
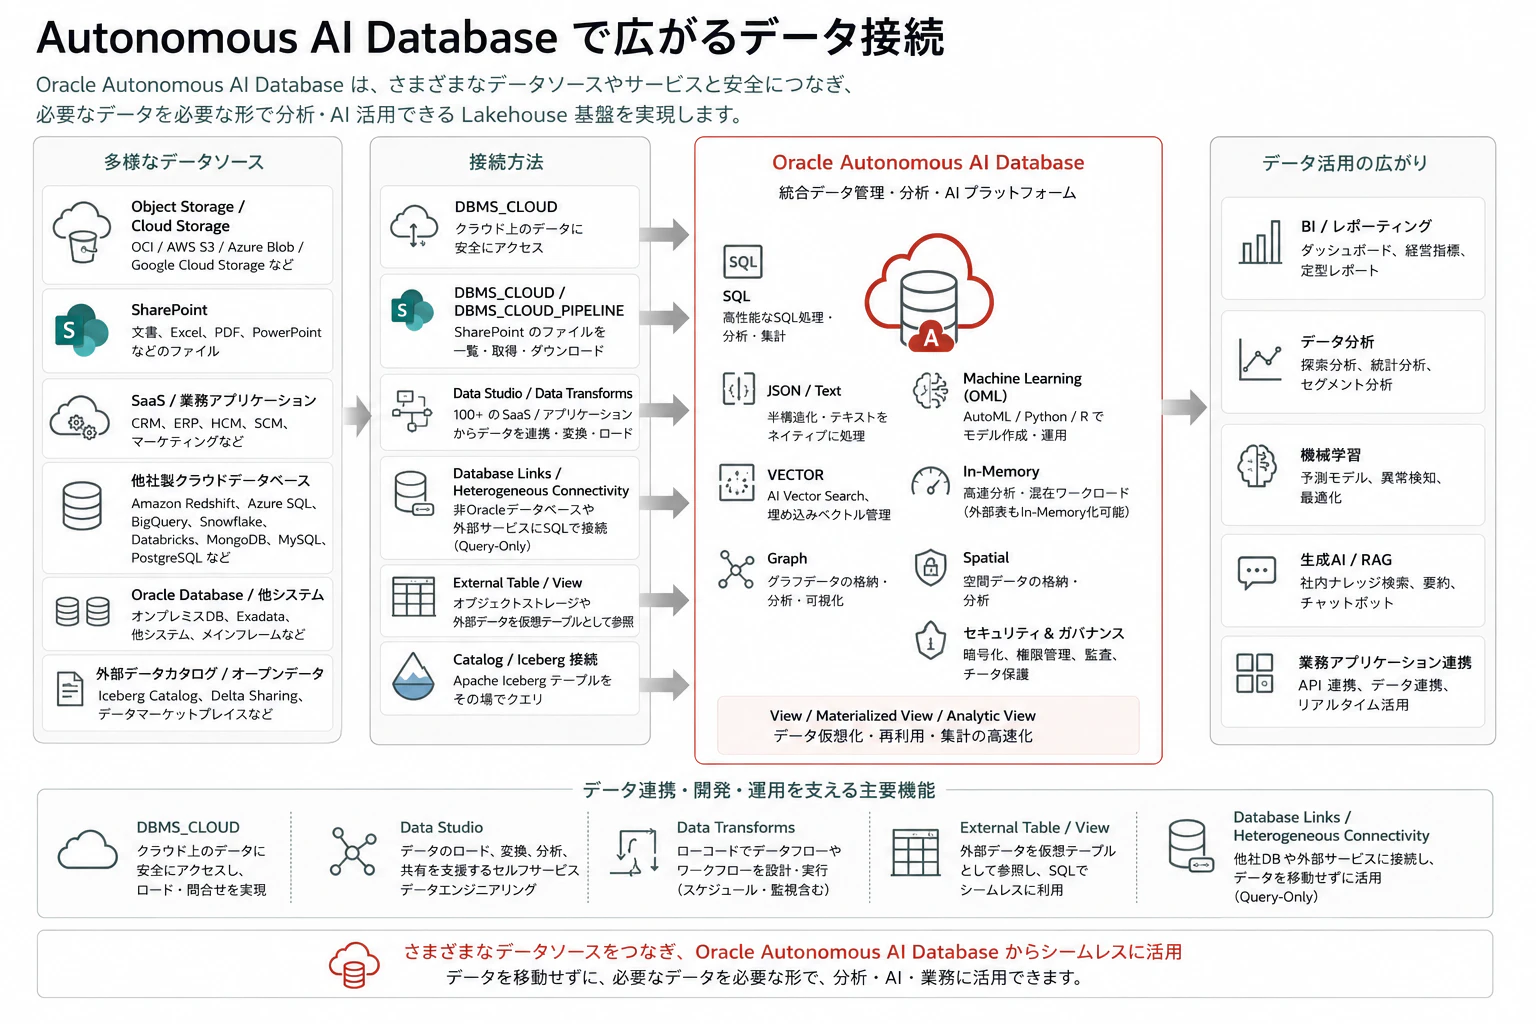
Oracle Autonomous AI Lakehouse の面白さは、Object Storage や Iceberg だけではありません。
Autonomous AI Database を中心に見ると、接続できるデータの範囲がかなり広がります。
対象は、クラウドストレージ、SharePoint、SaaS、業務アプリケーション、他社製クラウドデータベース、Oracle Database、外部データカタログなど、多岐にわたります。
さらに、Autonomous AI Database では Oracle-managed heterogeneous connectivity により、
非Oracleデータベースや一部の外部サービスに対して Database Link 経由で問い合わせる構成を取ることができます。
Oracle の製品ページでも、Autonomous AI Lakehouse はオープンテーブル形式や多数のデータベース・アプリケーションソースに接続し、構造化、半構造化、非構造化データをネイティブにサポートする統合分析プラットフォームとして説明されています。
参考: Oracle Autonomous AI Lakehouse
Object Storage / Cloud Storage
まず基本となるのは Object Storage です。
Raw / Bronze のデータ、つまり生ログ、CSV、JSON、Parquet、ORC、Avro、PDF、画像などは、Object Storage に置くのが自然です。Autonomous AI Database からは、外部表や DBMS_CLOUD を通じてこれらのデータを参照できます。
すべてのデータを最初から Database にロードする必要はありません。
必要に応じて、外部表として問い合わせる、ロードして Database Table にする、Materialized View で集計する、といった選択ができます。
たとえば AWS S3 上の Parquet ログを外部表にして、Database 内の顧客表とそのまま JOIN できます。
-- AWS のアクセスキーを資格証明として登録
BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'S3_CRED',
    username        => '<AWS Access Key ID>',
    password        => '<AWS Secret Access Key>');
END;
/

-- S3 上の Parquet ファイル群を外部表として定義(列定義は Parquet から自動導出)
BEGIN
  DBMS_CLOUD.CREATE_EXTERNAL_TABLE(
    table_name      => 'SALES_LOG_EXT',
    credential_name => 'S3_CRED',
    file_uri_list   => 'https://<bucket>.s3.<region>.amazonaws.com/sales_logs/*.parquet',
    format          => '{"type":"parquet","schema":"first"}');
END;
/

-- S3 上のログを、Database 内の顧客表と普通に JOIN
SELECT c.customer_name, SUM(s.amount) AS total_amount
FROM   sales_log_ext s
JOIN   customers     c ON c.customer_id = s.customer_id
GROUP  BY c.customer_name;
「S3 のファイル」と「Oracle の表」が、同じ SELECT 文の中に並ぶ。ETL を組む前に、まずこの形で試せるのが Lakehouse らしいところです。
Load / Link / Feed / Pipeline:読むだけでなく継続的に取り込む
Object Storage上のデータは、External Tableとして問い合わせるだけではありません。
データの利用頻度や更新方法に応じて、Load、Link、Live Table Feed、Data Pipelineを使い分けられます。
| 方式 | データ移動 | 主な用途 |
|---|---|---|
| Link / External Table | 移動しない | Object Storage上のデータをその場で問い合わせる |
| Data Load | Databaseへコピーする | 単発または手動でTableへロードする |
| Live Table Feed | 新規ファイルを継続的にコピーする | Object Storageへ追加されるファイルを自動取り込みする |
| DBMS_CLOUD_PIPELINE | 増分Loadまたは増分Export | PL/SQLで継続的なData Pipelineを管理する |
Live Table Feedは、Object Storageへファイルが追加されるたびに、そのファイルをDatabase Tableへ取り込む機能です。
実行方法は次のように選択できます。
- On Demand
- Schedule
- Object Storage Notification
Live Table Feedは、取り込み済みファイルを追跡し、同じファイルが重複してロードされないように管理します。
Object Storage
   ├─ sales_20260801.parquet
   ├─ sales_20260802.parquet
   └─ sales_20260803.parquet
                ↓
        Live Table Feed
                ↓
       Oracle AI Database
          SALES Table
GUIで設定したい場合はLive Table Feedが分かりやすく、PL/SQLで継続的な処理として管理したい場合はDBMS_CLOUD_PIPELINEが向いています。
DBMS_CLOUD_PIPELINEには、主に次のLifecycleがあります。
CREATE_PIPELINE
      ↓
SET_ATTRIBUTE
      ↓
RUN_PIPELINE_ONCE
      ↓
START_PIPELINE
      ↓
STOP_PIPELINE
      ↓
必要に応じて RESET_PIPELINE
RUN_PIPELINE_ONCEを使えば、継続実行を開始する前にForeground SessionでPipelineをテストできます。
START_PIPELINEを実行すると、設定したIntervalに従ってScheduled Jobとして継続実行されます。
また、DBMS_CLOUD_PIPELINEはObject StorageからDatabaseへの増分Loadだけでなく、Database TableやQuery結果をObject Storageへ継続的にExportすることもできます。
Object Storage
       ↓ LOAD Pipeline
Oracle AI Database
       ↓ EXPORT Pipeline
Object Storage
そのため、Object Storageとの関係は次のように段階的に考えられます。
まず読む
  → External Table / Link

一度取り込む
  → Data Load

追加ファイルを自動で取り込む
  → Live Table Feed

継続処理として管理する
  → DBMS_CLOUD_PIPELINE
参考: Load Data with Data Studio Tools / Feeding Data / DBMS_CLOUD_PIPELINE Package
SharePoint
業務データ活用で非常に面白いのが SharePoint 連携です。
多くの企業では、重要な情報がデータベースではなく、SharePoint 上の Word、Excel、PDF、PowerPoint に存在しています。従来、これらは分析基盤から見ると扱いにくいデータでした。
Autonomous AI Database では、DBMS_CLOUD と DBMS_CLOUD_PIPELINE を使って Microsoft SharePoint 上のファイルにアクセスできます。Oracle のドキュメントでは、SharePoint 上のファイルを list / retrieve し、外部コンテンツをダウンロードして後続の分析や索引作成に利用できると説明されています。さらに、DBMS_CLOUD_AI.CREATE_VECTOR_INDEX を使って SharePoint ファイルから直接 Vector Index を作成する例も示されています。なお、SharePointでDBMS_CLOUD_PIPELINEを利用する場合は、DOWNLOAD Pipelineのみがサポートされます。
参考: SharePoint Support in Autonomous AI Database Using DBMS_CLOUD
これは Lakehouse の文脈ではかなり重要です。
なぜなら、SharePoint 上の文書を単なるファイルとして放置するのではなく、抽出テキスト、チャンク、Embedding、Metadata として Oracle AI Database 側に取り込み、RAG やセマンティック検索につなげられるからです。
イメージとしては、次のような PL/SQL で SharePoint 上の文書から Vector Index を作成できます。
なお、location には SharePoint サイトのブラウザ用 URL(https://...sharepoint.com/sites/...)ではなく、SharePoint:// スキームの専用 URI を指定する点に注意してください。ここが一番ハマりやすいポイントです。
BEGIN
  DBMS_CLOUD_AI.CREATE_VECTOR_INDEX(
    index_name  => 'SHAREPOINT_DOCS_IDX',
    attributes  => '{"vector_db_provider": "oracle",
                     "location": "SharePoint://tenant_id=<tenant_id>/site_id=<site_id>/",
                     "object_storage_credential_name": "<SharePoint の資格証明名>",
                     "profile_name": "<AI プロファイル名>",
                     "vector_table_name": "SHAREPOINT_DOCS_VEC",
                     "vector_distance_metric": "cosine",
                     "vector_dimension": 1024,
                     "chunk_size": 1024,
                     "chunk_overlap": 128}'
  );
END;
/
SharePoint の文書群が、SQL の世界からそのままセマンティック検索の対象になる——これは実際に動かしてみると、なかなか感動があります。
セマンティック検索は、キーワードが完全一致する文書を探すのではなく、質問の意味に近い内容を持つ文書を探す仕組みです。RAG は、その検索で見つかった関連チャンクを LLM に渡し、文書の内容を根拠にして自然言語で回答を生成する仕組みです。
つまり、SharePoint 上の文書を抽出テキスト、チャンク、Embedding、Metadata として Oracle AI Database 側に取り込むことで、「文書検索」から一歩進んで、「文書を根拠にした自然言語回答」につなげられます。
このあたりのハンズオンは、また別の記事で「してみてみた」としてまとめたいと思います。
参考: Autonomous AI DatabaseからSharepoint上のファイルにアクセスしてみた
SaaS / 業務アプリケーション
SaaS や業務アプリケーションとの接続も重要です。
Oracle Autonomous AI Lakehouse の Data Studio は、データのロード、変換、分析、共有を支援するセルフサービスのデータエンジニアリング機能として位置づけられています。Oracle の製品ページでは、Data Studio により、100 以上のアプリケーション、クラウドサービス、データベースソースと統合できると説明されています。
参考: Oracle Autonomous AI Lakehouse
また Data Transforms は、Autonomous AI Database 向けにデータロード、データフロー、ワークフローをローコードで設計するための機能です。データロード、結合、フィルタ、集計、マッピング、スケジュール、監視などを GUI ベースで扱えるため、SaaS データや業務アプリケーションデータを Lakehouse に取り込む際の実装手段になります。
参考: About Data Transforms
他社製クラウドデータベース / 異機種間接続
さらに、Autonomous AI Database では Oracle-managed heterogeneous connectivity により、非 Oracle Database への Database Link を作成できます。
Oracle のドキュメントでは、Amazon Redshift、Microsoft SQL Server、Azure SQL、Azure Synapse Analytics、Databricks、Google BigQuery、MongoDB、MySQL、PostgreSQL、Salesforce、ServiceNow、Snowflake、SharePoint などが db_type の例として挙げられています。ただし、この Oracle-managed heterogeneous connectivity は remote database に対して query-only で、更新はサポートされない点に注意が必要です。
参考: Create Database Links to Non-Oracle Databases with Oracle-Managed Heterogeneous Connectivity
この機能により、すべてのデータを物理的に移動しなくても、Oracle AI Database から他社製データベース上のデータを参照し、Oracle 側のデータと組み合わせて分析できます。
たとえば Snowflake への Database Link は、次のように作成できます。
-- 接続先 Snowflake のユーザー資格証明を登録
BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'SNOWFLAKE_LINK_CRED',
    username        => '<Snowflake ユーザー>',
    password        => '<パスワード>');
END;
/

-- Oracle-managed heterogeneous connectivity で Database Link を作成
BEGIN
  DBMS_CLOUD_ADMIN.CREATE_DATABASE_LINK(
    db_link_name       => 'SNOWFLAKE_LINK',
    hostname           => '<Snowflakeアカウント識別子>',  -- snowflakecomputing.com は不要(ドライバが付与)
    port               => '443',
    service_name       => '<Snowflake のデータベース名>',
    credential_name    => 'SNOWFLAKE_LINK_CRED',
    gateway_params     => JSON_OBJECT('db_type' value 'snowflake'),
    ssl_server_cert_dn => NULL);
END;
/

-- あとは通常の Database Link と同じ感覚で問い合わせできる(参照のみ)
SELECT * FROM orders@SNOWFLAKE_LINK;
ODBC ゲートウェイのセットアップや証明書の管理は Oracle 側がマネージドで面倒を見てくれるため、利用者から見ると「資格証明を登録して、Link を作るだけ」です。Snowflake が、昔ながらの @db_link 構文の向こう側にいるのは、Oracle 経験者ほどグッとくるところだと思います。
Google BigQuery も同じ枠組みで接続できます。BigQuery の場合は OAuth2 タイプの資格証明を使い、gateway_params に project を指定します。
-- BigQuery は OAuth2 タイプの資格証明を使う
BEGIN
  DBMS_CLOUD.CREATE_CREDENTIAL(
    credential_name => 'BIGQUERY_LINK_CRED',
    params => JSON_OBJECT(
      'gcp_oauth2' value JSON_OBJECT(
        'client_id'     value '<client_id>',
        'client_secret' value '<client_secret>',
        'refresh_token' value '<refresh_token>')));
END;
/

-- Database Link を作成(project の指定が必須)
BEGIN
  DBMS_CLOUD_ADMIN.CREATE_DATABASE_LINK(
    db_link_name       => 'GOOGLE_BIGQUERY_LINK',
    hostname           => 'example.com',   -- BigQuery では hostname は使用されない
    port               => '443',
    service_name       => '<BigQuery のデータセット名>',
    credential_name    => 'BIGQUERY_LINK_CRED',
    gateway_params     => JSON_OBJECT(
                            'db_type' value 'google_bigquery',
                            'project' value '<GCP プロジェクト名>'),
    ssl_server_cert_dn => NULL);
END;
/

-- BigQuery / MySQL / PostgreSQL では表名を二重引用符で囲む
SELECT count(*) FROM "sales"@GOOGLE_BIGQUERY_LINK;
対応データベースは Snowflake、BigQuery のほか、Amazon Redshift、Azure SQL / Synapse、PostgreSQL、MySQL、MongoDB、Databricks など多数あります。ちょっとした Tips ですが、接続タイプごとのサンプルコードは Database 内のビューからも確認できます。
-- 各 db_type のサンプル PL/SQL が SAMPLE_USAGE 列に入っている
SELECT * FROM HETEROGENEOUS_CONNECTIVITY_INFO
WHERE  DATABASE_TYPE = 'google_bigquery';
なお、Oracle-managed heterogeneous connectivity は 参照専用(query-only) で、リモート側への更新はできない点には注意してください。
これは Lakehouse の考え方を広げます。
従来は、
データを集めてから分析する
という考え方が中心でした。
しかし Autonomous AI Lakehouse では、
必要なデータを、必要な形で、Oracle AI Database からつなげて使う
という発想ができます。

ただし、Database Link で外部 DB を参照できるからといって、すべての処理を毎回リモート参照にする必要はありません。
性能、コスト、再利用性、安定性を考えると、よく使うデータは Oracle AI Database 側に取り込む設計も有効です。
たとえば、Snowflake、BigQuery、Redshift、PostgreSQL などの外部 DB 上のデータを、まず Database Link 経由で参照し、必要な範囲だけ INSERT INTO ... SELECT や CREATE TABLE AS SELECT で Oracle 側に取り込むことができます。
外部DB上のデータを Oracle AI Database 側に取り込むイメージ
CREATE TABLE sales_from_snowflake
AS
SELECT * FROM   sales@SNOWFLAKE_LINK
WHERE  sales_date >= DATE '2026-01-01';
このようにして Oracle AI Database 側に取り込めば、Oracle の SQL、索引、View、Materialized View、In-Memory、Vector Search、AI 機能と組み合わせやすくなります。
さらに、Lakehouse workloadではHybrid Columnar CompressionがTableのデフォルトとして有効です。参照中心の分析データを、容量を抑えながら保持できます。
参考: Lakehouse Workload with Autonomous AI Database
つまり、外部 DB 接続は次のように段階的に考えると分かりやすいです。
まず試す
  → Database Link で外部 DB を直接 SELECT

よく使う
  → INSERT INTO ... SELECT / CTAS で Oracle 側に取り込む

分析で繰り返し使う
  → View / Materialized View / In-Memory / HCC などで最適化

AI / RAG で使う
  → Chunk / Embedding / VECTOR Table / Metadata Table として AI-ready 化
Database Link は「外部 DB をそのまま使う入口」であり、Oracle AI Database 側に取り込むことで、さらに高速化・再利用・AI活用へ広げることができます。
Data Share / Delta Sharing / Cloud Links:つなぐだけでなく共有する
ここまで、Object Storage、SharePoint、SaaS、Snowflake、BigQueryなど、外部にあるデータをOracle AI Databaseから利用する方法を見てきました。
しかし、Autonomous AI Lakehouseのデータ接続は一方向ではありません。
Oracle AI Database内のTableやViewを、他のDatabaseやツールへ共有することもできます。
中心になるのが Data Share です。
Data Shareには、大きくVersioned ShareとLive Shareがあります。加えて、Data Shareとは別の軽量な共有手段としてTable Hyperlinksがあります。
| 共有方式 | 仕組み | データの見え方 | 主な共有先 |
|---|---|---|---|
| Versioned Share | Delta Sharing + Object Storage | ProviderがPublishしたVersionを参照する | Delta Sharing対応ツール、API、Autonomous AI Database |
| Live Share | Cloud Links | 最新のCommit済みデータをQuery時に参照する | 対応するAutonomous AI Database |
| Table Hyperlink | URL / REST | URLが有効な間、Table・View・SQL結果を参照する | Browser、REST Client、Excel、Google Sheetsなど |
構成イメージは次のようになります。
Oracle Autonomous AI Database
  ├─ Table
  ├─ View
  └─ Query Result
        │
        ├─ Versioned Share
        │      ↓
        │  Delta Sharing
        │      ↓
        │  外部Tool / API / Database
        │
        ├─ Live Share
        │      ↓
        │  Cloud Links
        │      ↓
        │  Autonomous AI Database
        │
        └─ Table Hyperlink
               ↓
           URL / REST
               ↓
        Browser / Excel / Sheets
Versioned Share / Delta Sharing
Versioned Shareでは、Providerが共有対象のTableやViewを選び、特定時点のVersionとしてPublishします。
ConsumerはDelta Sharing Profileを登録し、共有されたデータをExternal Tableなどとして利用します。
変更内容は即座にConsumerへ反映されるのではなく、Providerが新しいVersionをPublishしたタイミングで見えるようになります。
ここで重要なのは、Delta Sharingを使うからといって、元データをDelta Lake Tableとして保持しておく必要はない点です。
Oracle AI Database内の通常のTableやViewを、OracleのData ShareがDelta Sharing Protocolを使って共有します。
つまり、
Delta Lake
  → Table Format

Delta Sharing
  → Data Sharing Protocol
であり、名前は似ていますが役割が異なります。
Live Share / Cloud Links
Live Shareでは、Cloud Linksを使ってAutonomous AI Database間でデータを共有します。
Provider側のTableやViewを登録し、Region、Tenancy、Compartment、特定DatabaseなどのScopeを指定して、Read Onlyで公開できます。
Consumer側は複雑なDatabase Linkを構築せず、共有されたデータをSQLから利用できます。
Versioned Shareが「PublishされたSnapshotを共有する」のに対し、Live Shareは「Query時点の現在データを参照する」イメージです。
Versioned Share
  → 公開した版を共有する

Live Share
  → 現在のデータを参照する
Table Hyperlinks
もっと軽量にデータを渡したい場合はTable Hyperlinksがあります。
Table、View、またはSELECT文の結果に対してURLを発行し、BrowserやREST Clientからデータへアクセスできます。
Table Hyperlinkには、次のような制御を設定できます。
- 有効期限
- 利用回数
- ACL Check
- Endpoint情報の非表示
- 複数Tableや複数SQLをまとめるHyperlink Group
たとえば、障害調査のために特定のデータだけを一時的に共有する、取引先へ期間限定で集計結果を渡す、といった用途に向いています。
Data Shareの操作はData Studioの画面から実行できますが、DBMS_SHAREを使ってPL/SQLから自動化することもできます。
DBMS_SHAREでは、Shareの作成、TableやViewの追加、Recipientの登録、Publish、権限のGrant / Revoke、Share Lifecycleの管理などを行えます。
これにより、Autonomous AI Lakehouseは、
外部データをOracleから読む
             +
Oracleのデータを外部へ共有する
という双方向のデータ基盤になります。
参考: Share and Consume Data with Data Share in Autonomous AI Database / Use Cloud Links for Read Only Data Access on Autonomous AI Database / Use Table Hyperlinks for Read Only Data Access on Autonomous AI Database / Delta Sharing
■ 5. どこに何を置くべきか
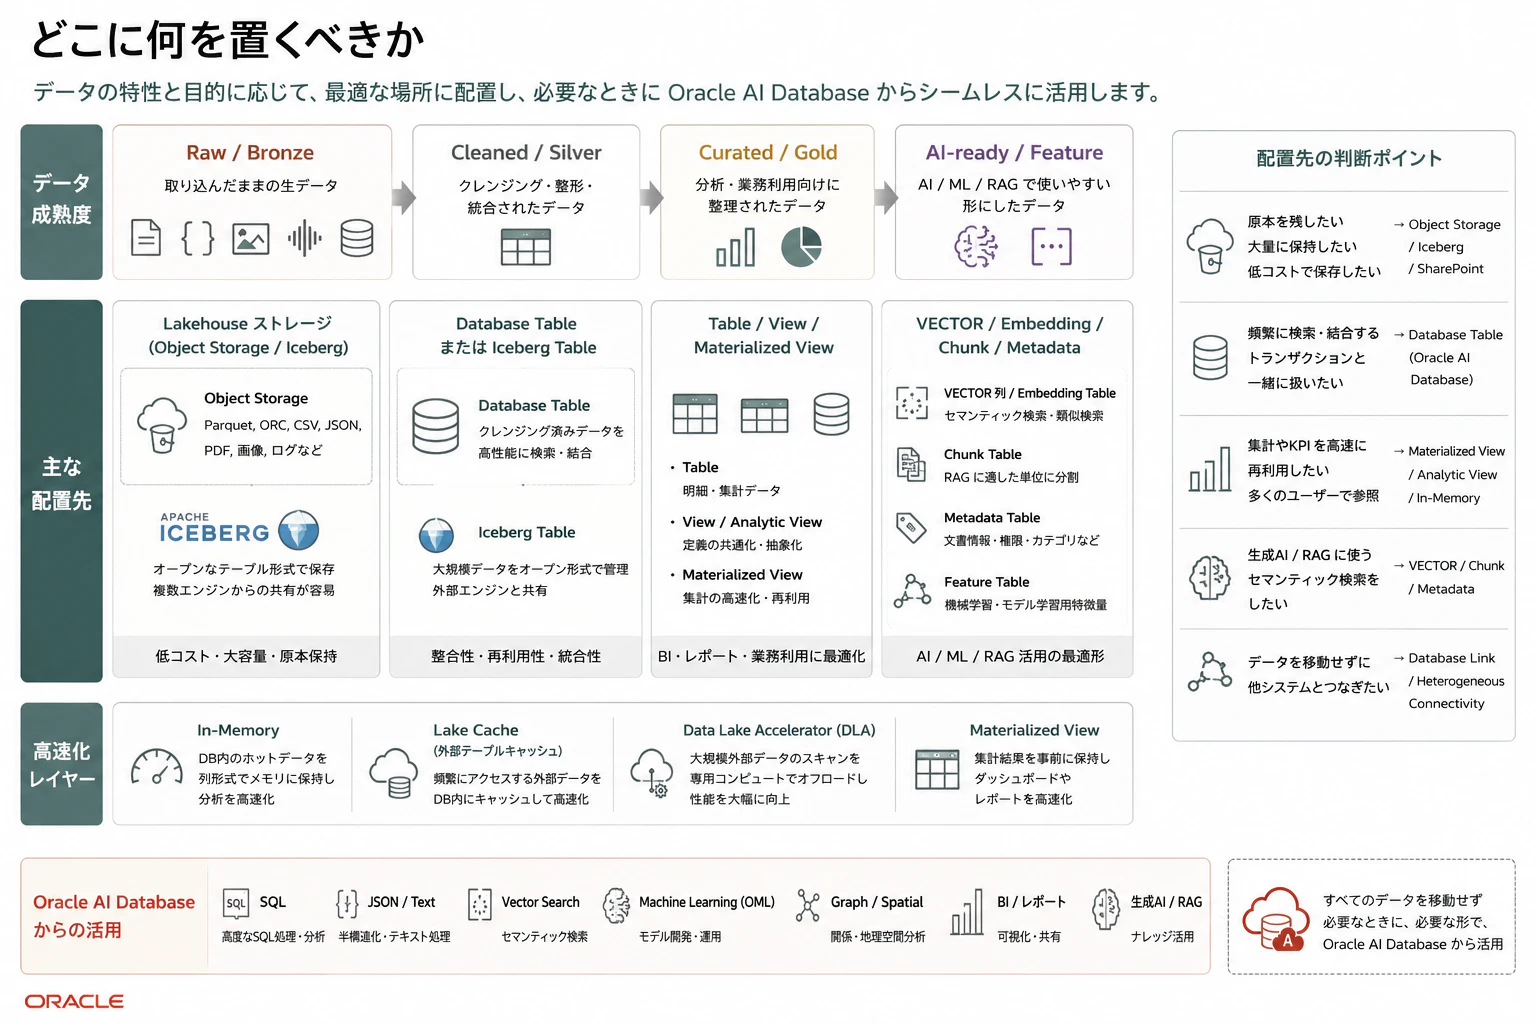
ここまで見てくると、扱えるデータと接続先がかなり広いことが分かります。
では実際に、どこに何を置くべきでしょうか。
私の整理では、Oracle Autonomous AI Lakehouse におけるデータ配置は、次の考え方が分かりやすいです。
| データ / レイヤー | 推奨配置 | 理由 |
|---|---|---|
| Raw / Bronze | Object Storage、Iceberg、Parquet、CSV、JSON、PDF | 原本性、低コスト、大量保存、再処理に向く |
| 生ログ / イベント / 履歴データ | Object Storage、Iceberg | 増え続けるデータをそのまま保持しやすい |
| 半構造化 JSON の原本 | Object Storage または External Table | まず原本を残し、必要に応じて構造化する |
| 頻繁に JOIN / 検索する JSON | Oracle AI Database の JSON 列 / Table | SQL、索引、View、トランザクションと組み合わせやすい |
| Cleaned / Silver | Database Table または Iceberg Table | 品質保証済みデータとして再利用しやすい |
| Curated / Gold | Table、View、Materialized View、Analytic View | BI、KPI、業務レポートに使いやすい |
| 高頻度分析データ | In-Memory、Materialized View、Lake Cache | レスポンス改善、ダッシュボード高速化 |
| PDF / Word / 画像などの原本 | SharePoint、Object Storage | 原本管理、監査、再処理に向く |
| 抽出テキスト | Database Table / CLOB | 検索、要約、チャンク化の元データ |
| チャンク | Database Table | RAG の検索単位として管理 |
| Embedding | VECTOR 列を持つ Database Table | 業務データと一緒にセマンティック検索できる |
| Metadata | Database Table | ファイル名、URL、権限、作成日、部門などを管理 |
| Feature / AI-ready | Feature Table、VECTOR Table、View、Materialized View | ML、AI、RAG、推論で再利用しやすい |
| 他社 DB の参照データ | Database Link / Heterogeneous Connectivity | 移動せずに参照・結合できる |
| SaaS データ | Data Studio / Data Transforms でロードまたは連携 | 定期連携、変換、業務データ化に向く |
| Delta Lake Table | UniForm + Iceberg Metadata + Unity Catalog | データファイルを複製せず、Icebergクライアントから問い合わせられる |
| Iceberg Metadata / Catalog | Oracle AI Data Catalogまたは外部Iceberg REST Catalog | Snapshot、Schema、Namespaceを一元管理できる |
| 継続的に追加されるファイル | Live Table Feed / DBMS_CLOUD_PIPELINE | 新しいファイルを増分で取り込める |
| 外部へ共有する分析データ | Data Share / Delta Sharing | Open ProtocolでDatabaseやツールへ共有できる |
| Autonomous AI Database間で共有する最新データ | Live Share / Cloud Links | データをコピーせず、最新データをRead Onlyで参照できる |
| 一時的に共有するデータ | Table Hyperlinks | 有効期限や利用回数を持つURLで共有できる |
| Hot / Coldに分ける履歴データ | Hybrid Partitioned Table | DatabaseとObject Storageを1つの論理Tableとして扱える |
この表をさらにシンプルにまとめると、次のようになります。
Raw / Bronze
  → Object Storage / Iceberg / SharePoint / 外部ストレージ

Cleaned / Silver
  → Database Table または Iceberg Table

Curated / Gold
  → Table / View / Materialized View / Analytic View

Performance Layer
  → In-Memory / Lake Cache / Materialized View

AI-ready
  → VECTOR / Embedding / Chunk / Metadata / Feature Table
ここでのポイントは、構造化データだから必ず Database、非構造化データだから必ず Object Storage と固定しないことです。
より実践的には、次の基準で考えるとよいです。
原本・大量・低頻度アクセスのデータは Lakehouse ストレージへ
ログ、履歴ファイル、PDF 原本、画像、JSON 原本、Parquet ファイルなどは、Object Storage や Iceberg に置くのが自然です。
これらは、あとで再処理したり、監査用に残したり、別のエンジンからも使う可能性があるため、オープンな形式で保持しておく価値があります。
Database と Object Storage の境界を 1 つの表として扱う
大量の履歴データをObject Storageへ配置する場合は、保存場所だけでなく、どの範囲のファイルを読むかも重要です。
たとえば、Object Storage上のデータが次のようなフォルダ構造で保存されているとします。
sales/
  country=JP/
    year=2026/
      month=08/
        sales.parquet
  country=US/
    year=2026/
      month=08/
        sales.parquet
Autonomous AI DatabaseのImplicit Partitioningでは、このフォルダ構造からcountry、year、monthをPartition Columnとして自動的に認識できます。
SELECT COUNT(*)
FROM   sales_ext
WHERE  country = 'JP'
AND    year    = 2026
AND    month   = '08';
この場合、条件に関係しない国や年月のファイルを読み飛ばし、必要な範囲だけを問い合わせられます。
Object Storageへ新しいフォルダやファイルが追加された場合も、Query実行時に構造を検出できるため、毎回Partition Metadataを手動同期する必要を減らせます。
さらに、Database内のTable PartitionとObject Storage上のExternal Partitionを、1つの論理Tableとして扱う Hybrid Partitioned Table もあります。
SALES
  ├─ P2026  Database内
  ├─ P2025  Database内
  ├─ P2024  Object Storage
  └─ P2023  Object Storage
最近のデータはDatabase内に保持し、古い履歴データはObject Storageへ配置します。
利用者から見ると、同じSALES Tableへ問い合わせるだけです。
SELECT customer_id,
       SUM(amount)
FROM   sales
WHERE  sales_date >= DATE '2024-01-01'
GROUP BY customer_id;
Oracle AI DatabaseはPartition条件に応じて、Database内のPartitionとObject Storage上の必要なファイルへアクセスします。
| 方式 | 配置 | 向いている用途 |
|---|---|---|
| Implicit Partitioning | すべてObject Storage | Hive形式などのフォルダ構造を利用して、読むファイルを絞り込む |
| External Partitioned Table | すべてObject Storage | Partition定義を明示的に管理する |
| Hybrid Partitioned Table | Database + Object Storage | 最近のHot Dataと古いCold Dataを1つのTableとして扱う |
これは、先ほどの
最近のデータ
  → Database

古い履歴データ
  → Object Storage
という配置方針を、実際に1つのTableとして実装する方法です。
参考: Query External Tables with Implicit Partitioning / Query Hybrid Partitioned Data
品質保証済み・再利用されるデータは Database Table または Iceberg Table へ
クレンジング済み、型変換済み、重複排除済み、業務キーで結合済みのデータは、Silver レイヤーとして扱います。
Oracle AI Database で高速に JOIN、検索、AI 処理したい場合は Database Table にするのが自然です。一方で、複数エンジンから共有したい大規模分析データであれば Iceberg Table として管理する選択もあります。
BI・KPI・ダッシュボード用データは Gold として整理する
経営指標、部門別売上、顧客セグメント、在庫回転率、SLA、利用状況など、業務利用されるデータは Gold レイヤーとして整理します。
ここでは、Table、View、Materialized View、Analytic View が候補になります。高頻度に使われる集計は Materialized View、低頻度だが定義を共通化したいものは View、性能要件が高いものは In-Memory などを検討します。
AI-ready データは Database 側に寄せると扱いやすい
生成 AI / RAG で使う場合、原本ファイルそのものよりも、次のような派生データが重要になります。
| AI-ready データ | 内容 |
|---|---|
| Extracted Text | PDF や Word から抽出したテキスト |
| Chunk | RAG で検索しやすい単位に分割したテキスト |
| Embedding | Chunk や文書をベクトル化したもの |
| Metadata | 文書名、URL、権限、カテゴリ、作成日、部門 |
| VECTOR Index | セマンティック検索用の索引 |
| Text Index | キーワード検索・全文検索用の索引 |
| Access Control Metadata | 部門、所有者、閲覧権限、SharePoint URL、公開範囲 |
Oracle AI Database では、Embedding を VECTOR データ型として業務データと同じ Database に格納できます。これにより、セマンティック検索だけでなく、顧客、契約、製品、問い合わせ、権限情報などの構造化データと組み合わせた RAG を設計しやすくなります。
参考: Oracle AI Vector Search Overview
たとえば、SharePoint 上の技術文書を RAG 化する場合は、次のような配置が考えられます。
SharePoint
  - Word
  - PDF
  - Excel
  - PowerPoint

        ↓ DBMS_CLOUD / DBMS_CLOUD_PIPELINE

Oracle AI Database
  - Document Metadata Table
  - Extracted Text Table
  - Chunk Table
  - Embedding Table with VECTOR column
  - Vector Index
  - Text Index

        ↓

Select AI / RAG Application / Chatbot / BI / Search
この構成では、SharePoint は文書原本の置き場であり、Oracle AI Database は検索・分析・AI 活用のための実行基盤になります。
■ 6. まとめ:Lakehouse は「集める基盤」から「つなげて使う基盤」へ
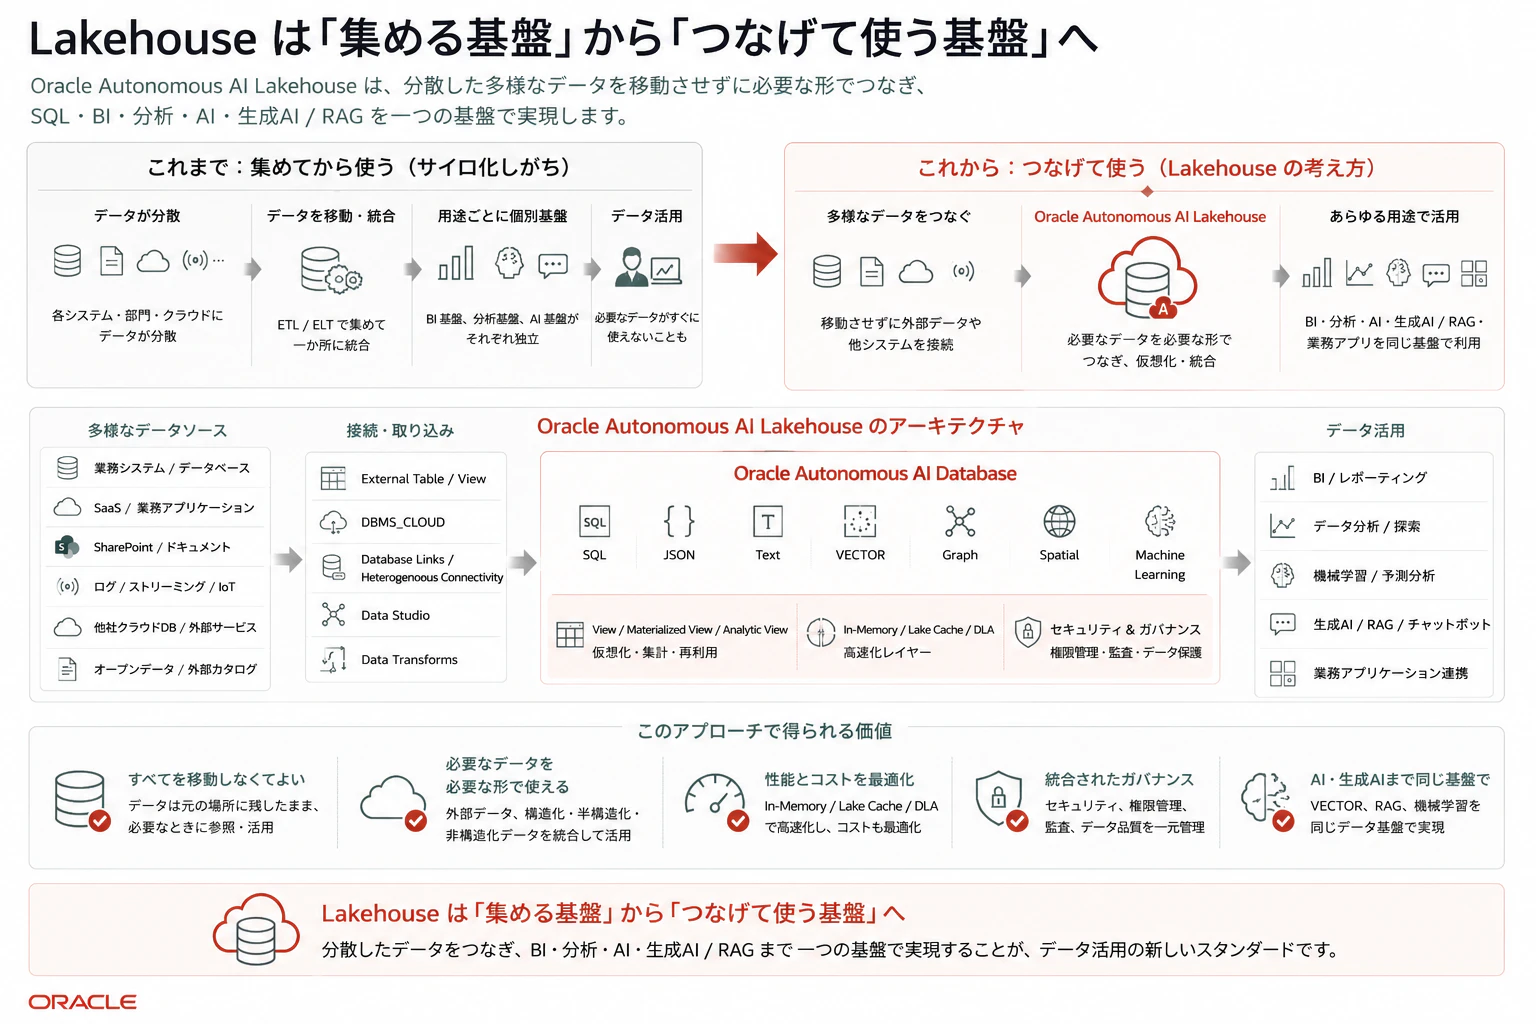
Lakehouse というと、最初は「Data Lake と Data Warehouse を組み合わせたもの」と説明されることが多いです。
しかし、Oracle Autonomous AI Lakehouse の文脈で見ると、それだけでは少し物足りません。
Oracle Autonomous AI Lakehouse の面白さは、Object Storage や Iceberg にデータを置けることだけではありません。Oracle AI Database を中心に、構造化データ、半構造化データ、非構造化データ、SharePoint、SaaS、他社製クラウドデータベース、外部表、Database Link、Vector Search、BI、AI、RAG をつなげて使えるところにあります。
従来の発想では、分析するためにはまずデータを 1 か所に集める必要がありました。
もちろん、今でもデータを集めて整えることは重要です。特に Curated / Gold や AI-ready のように、品質と再利用性が求められるデータは、Oracle AI Database 側に整理しておく価値があります。
しかし、すべてのデータを無理に移動する必要はありません。
原本は Object Storage や SharePoint に置く。
大規模なオープン分析データは Iceberg に置く。
業務で頻繁に使うデータは Database Table に置く。
BI 用のデータは View や Materialized View にする。
高速化したいデータは In-Memory や Cache を使う。
生成 AI で使うデータは Chunk、Embedding、Metadata として AI-ready にする。
このように考えると、Lakehouse は単なる「データを集める基盤」ではなくなります。データをどこに置き、どの形にし、どのタイミングで Database に寄せるか——その 判断軸 が Lakehouse 設計の中心になります。
Oracle Autonomous AI Lakehouse は、その判断軸を Oracle AI Database の強みと組み合わせて実現しようとしているアーキテクチャです。
特に Oracle ユーザーにとっては、既存の Oracle Database 資産、SQL、View、Materialized View、セキュリティ、ガバナンス、In-Memory、JSON、Spatial、Graph、Vector Search を活かしながら、Object Storage、Iceberg、SharePoint、SaaS、他社製データベースへ広げていける点が大きな魅力です。
前章の配置パターンと合わせて見ると、Lakehouse設計では「どこに置くか」だけでなく、「どうつなぎ、どう管理し、どう継続運用するか」までを一体で考えることが重要です。
■ 最後に:Oracle Autonomous AI Lakehouse は “全てをつなぐ” データ基盤へ
最後に、この記事の要点を一枚でまとめると次のようになります。
| 判断軸 | 配置先 |
|---|---|
| 原本を残したい | Object Storage / SharePoint / Iceberg |
| 大量データを低コストで保持したい | Object Storage / Iceberg |
| 複数エンジンで共有したい | Iceberg / Open Table Format |
| SQL で頻繁に JOIN したい | Oracle AI Database Table |
| JSON を業務データと一緒に扱いたい | Oracle AI Database JSON |
| BI / KPI に使いたい | View / Materialized View / Analytic View |
| 高速化したい | In-Memory / Lake Cache |
| RAG に使いたい | Chunk Table / VECTOR Table / Metadata Table |
| 他社 DB を参照したい | Database Link / Heterogeneous Connectivity |
| SaaS データを取り込みたい | Data Studio / Data Transforms |
| SharePoint 文書を検索したい | DBMS_CLOUD / DBMS_CLOUD_AI / Vector Index |
| Delta Lake を Oracle から読みたい | UniForm / Iceberg Metadata / Unity Catalog |
| Iceberg Catalog を Oracle 側で持ちたい | Oracle AI Data Catalog |
| Iceberg の過去 Snapshot を読みたい |
AS OF TIMESTAMP / DBMS_CLOUD.ICEBERG_TABLE_HISTORY
|
| 新しいファイルを継続的に取り込みたい | Live Table Feed / DBMS_CLOUD_PIPELINE |
| Snapshot として外部へ共有したい | Data Share / Delta Sharing |
| Autonomous AI Database 間で最新データを共有したい | Live Share / Cloud Links |
| 一時的に URL で共有したい | Table Hyperlinks |
| 最近のデータと履歴データを 1 つの表にしたい | Hybrid Partitioned Table |
Oracle Autonomous AI Lakehouse を考えるときのキーワードは、
「集める」だけでなく「つなげて使う」 です。
そして Oracle らしいポイントは、
つなげた先で Oracle AI Database の SQL、AI、Vector、JSON、Graph、Spatial、ガバナンスを使えること
にあります。
今回さらに調べて分かったのは、Oracle Autonomous AI Lakehouseの「つなぐ」は、外部データをOracle AI Databaseから読むだけではないということです。
Oracle AI Databaseから外部Iceberg Catalogを参照する。
Oracle AI Data Catalogを使って、Oracle側でIceberg Tableを作成・書き込みする。
Object Storageへ追加されたファイルをPipelineで継続的に取り込む。
Oracle AI Database内のTableやViewを、Delta SharingやCloud Linksで外部へ共有する。
外部からOracleへつなぐ
          +
Oracleから外部へつなぐ
          +
Catalogで発見・管理する
          +
Pipelineで継続運用する
ここまで含めて考えると、Oracle Autonomous AI Lakehouseは、単なるData LakeとData Warehouseの統合ではありません。
データを読む、取り込む、整える、管理する、共有する、そしてAIで使うところまでを、Oracle AI Databaseを中心につなぐ基盤なのだと思います。
ここからは、今回いろいろ調べて実際にコードを書いてみた、個人的な感想です。
個人的に今回一番強く感じたのは、Oracle Autonomous AI Lakehouse は、単なる Lakehouse 機能ではなく、All-Platform なデータ基盤 として、これからの AI 時代にあるべき姿に近づいているということです。
これまでデータ活用では、どのクラウドに置くか、どのストレージに置くか、どの分析エンジンで処理するか、どの AI 基盤に渡すかを、それぞれ個別に考える必要がありました。
しかし、Oracle Autonomous AI Lakehouse では、OCI だけでなく、Azure、Google Cloud、AWS まで含めて、分散したデータを Oracle AI Database からつなげて使うという考え方ができます。
Object Storage、Iceberg、SharePoint、SaaS、Databricks、Snowflake、BigQuery、他社 DB、そして Oracle Database。
これらを別々の世界として扱うのではなく、Oracle AI Database の SQL、View、Database Link、外部表、Vector Search、Select AI、RAG、ガバナンスの世界に引き寄せて使える。
ここが本当に面白いところです。
もちろん、何でも Oracle に寄せればよいという話ではありません。Spark での大規模な変換処理は Databricks 側で実行した方が素直ですし、Oracle からの外部参照は query-only であり、Iceberg の Partition や Merge-on-Read に未対応といった制約もあります。現実的には、Oracle 側は「読み側・統合側」に寄せて、SQL・業務データ・Vector が同居することに意味がある処理を Oracle に置く、という使い分けになると思います。
そのうえで、Oracle Autonomous AI Lakehouse は、データを一か所に無理やり集めるためのものではなく、全てをつなぐもの だと思います。
そして、つないだ先で SQL も BI も AI も RAG も使える。
Oracle Database を長く触ってきた人ほど、この進化にはグッとくるものがあるはずです。
Oracle Autonomous AI Lakehouse は、AI 時代の “全てをつなぐ” Oracle データ基盤 なのだと思います。

さて、ここまでで「バラバラなデータをつなげて使えるようにする」ところまで整理できました。
次に気になるのは、つないだデータを使って、実際に何ができるのか です。
Select AI で自然言語から SQL を生成したり、Private Agent Factory でエージェントを組んだり、APEX でアプリケーションを作ったり——
このあたりは、また別の記事で「してみてみた」としてまとめたいと思います。
■ 技術解説
■ 参考資料
本記事で参照した資料を、目的・機能・製品/サービスの違いから探しやすいように整理しています。Oracle公式ドキュメントを中心に、Databricks、Delta Sharing、Microsoft SharePoint、Snowflake / Polaris、Qiitaの実践記事を分けて掲載します。
● 1. Lakehouse全体像・データレイヤー
- Autonomous AI Lakehouse - Oracle Documentation
- Oracle Autonomous AI Lakehouse
- Databricks Medallion Architecture
● 2. Oracle AI Databaseのデータ型・AI機能
● 3. 外部データ参照・Lakehouse性能
- Query External Data with Autonomous Database
- Use Database In-Memory with Autonomous Database
- Use Lake Cache to Improve Performance for External Tables and Mounted Catalog Tables
- Data Lake Accelerator
- Lakehouse Workload with Autonomous AI Database
- Query External Tables with Implicit Partitioning
- Query Hybrid Partitioned Data
● 4. Apache Iceberg・Delta Lake・Open Table Format
・Oracle Autonomous AI Database / Apache Iceberg
・Databricks / Delta Lake
● 5. Catalog・Metadata管理・Iceberg Table操作
- Oracle AI Data Catalog
- Discover and Manage Data with Catalog in Autonomous AI Database
- DBMS_CATALOG Package
- Manage Catalogs with DBMS_CATALOG
- DBMS_DCAT Package
- CREATE ICEBERG TABLE
● 6. Data Load・Feed・Pipeline・Data Transforms
● 7. Microsoft SharePoint・文書データ連携
- SharePoint Support in Autonomous AI Database Using DBMS_CLOUD
- Autonomous AI DatabaseからSharepoint上のファイルにアクセスしてみた
● 8. Data Share・Delta Sharing・Cloud Links
・Oracle Autonomous AI Databaseの共有機能
- Share and Consume Data with Data Share in Autonomous AI Database
- Use Cloud Links for Read Only Data Access on Autonomous AI Database
- Use Table Hyperlinks for Read Only Data Access on Autonomous AI Database
・オープンな共有プロトコル
● 9. 他社Database・マルチクラウド連携
・Oracle-managed Heterogeneous Connectivity
- Create Database Links to Non-Oracle Databases with Oracle-Managed Heterogeneous Connectivity
- DBMS_CLOUD_ADMIN Package (CREATE_DATABASE_LINK Procedure)
・Databricks連携
・Snowflake / Polaris連携
- Connecting Oracle Database to Snowflake Iceberg Tables Through Polaris Catalog
- Bridging Oracle Autonomous AI Database and Snowflake: Reading Iceberg Tables with Open Catalog (Polaris) Integration
- Step-by-Step Guide to Querying Data in Snowflake Using Autonomous Database
■ おまけ

