
MuseとM5Stack StopWatchで、「持ち運べるずんだもん」を作りました。
最初は声が返るまで43秒。今は長めの返事でも約10秒です。
この記事で持ち帰ってほしいのは次の3つです。
- 待ち時間を区間に分けて測ると、縮める場所が分かる
- 返事を文ごとに分けて声にするときは、1つ目の長さで「早さ」と「途切れなさ」を選ぶ
- 速くなったかを測るときは、キャッシュと前回のファイルに気をつける
同じようなものを作っている方から、Xで応答を速くするために何をしたのかと質問をいただきました。
その答えを詳細に書いた記録です。
測った数字はすべて実機とVMのログから出しています。
1. 質問をいただいたデバイス
ボタンを押して話しかけると、Museの返事がずんだもんの声で返ってくる、手のひらサイズの時計型ガジェットです。
(以降、本記事では時計と呼びます)
Museは、Metaが2026年9月に出した個人向けのAIエージェントです。
自分専用の仮想マシン(VM)を持ち、そこで作業します(Mercado)。
2026年10月には、Muse用の機器を自作できるSDKが公開されました(TechCrunch、muse-gadget-sdk)。
M5StackのStopWatch(丸い画面とマイク、スピーカーを持つESP32-S3のボード)にも対応しています。
公式のSDKは、返事が文字で届きます。
なので、MuseのVM上で作った声を、時計が読みに行く形で実装しています。
時計のファームウェアはClaude(Claude Code)が、VMのブリッジはMuse本人が作りました。
人間は実機確認です。
※ClaudeとMuseは、GitHubのIssueに書き込んでお互い相談して進めてもらいました。この記事の数字も、2人がお互いにログを突き合わせながら算出しています。
2. まず43秒を区間に分けた
速くする前に、待ち時間がどこで使われているかを測りました。
時計のログ、Museの会話の記録やログの時刻を並べています。
最初に声が出た10月30日の1往復は、こうでした。
| 区間 | 時間 | 持ち場 |
|---|---|---|
| 声を送って、サーバーが受け取る | 約1〜2秒 | 時計とサーバー |
| 考える(声のメモが記録に入る → 返事が記録に入る) | 23.4秒 | Muse |
| 声を作る(返事が記録に入る → 声ができる) | 約18秒 | VMのブリッジ |
| 合計(ボタンを離してから最初の声まで) | 43秒 |
待ちの大半は、Museが考える時間と、VMが声を作る時間の2つでした。
なので、工夫もこの2つに絞りました。
加えて、UXの観点から、待っている間の表現も少し入れています。
いちばん新しい11月3日の回では、513バイト(171字)の返事で9.95秒でした。10月30日の返事は357バイト(127字)だったので、返事は4割ほど長くなっています。
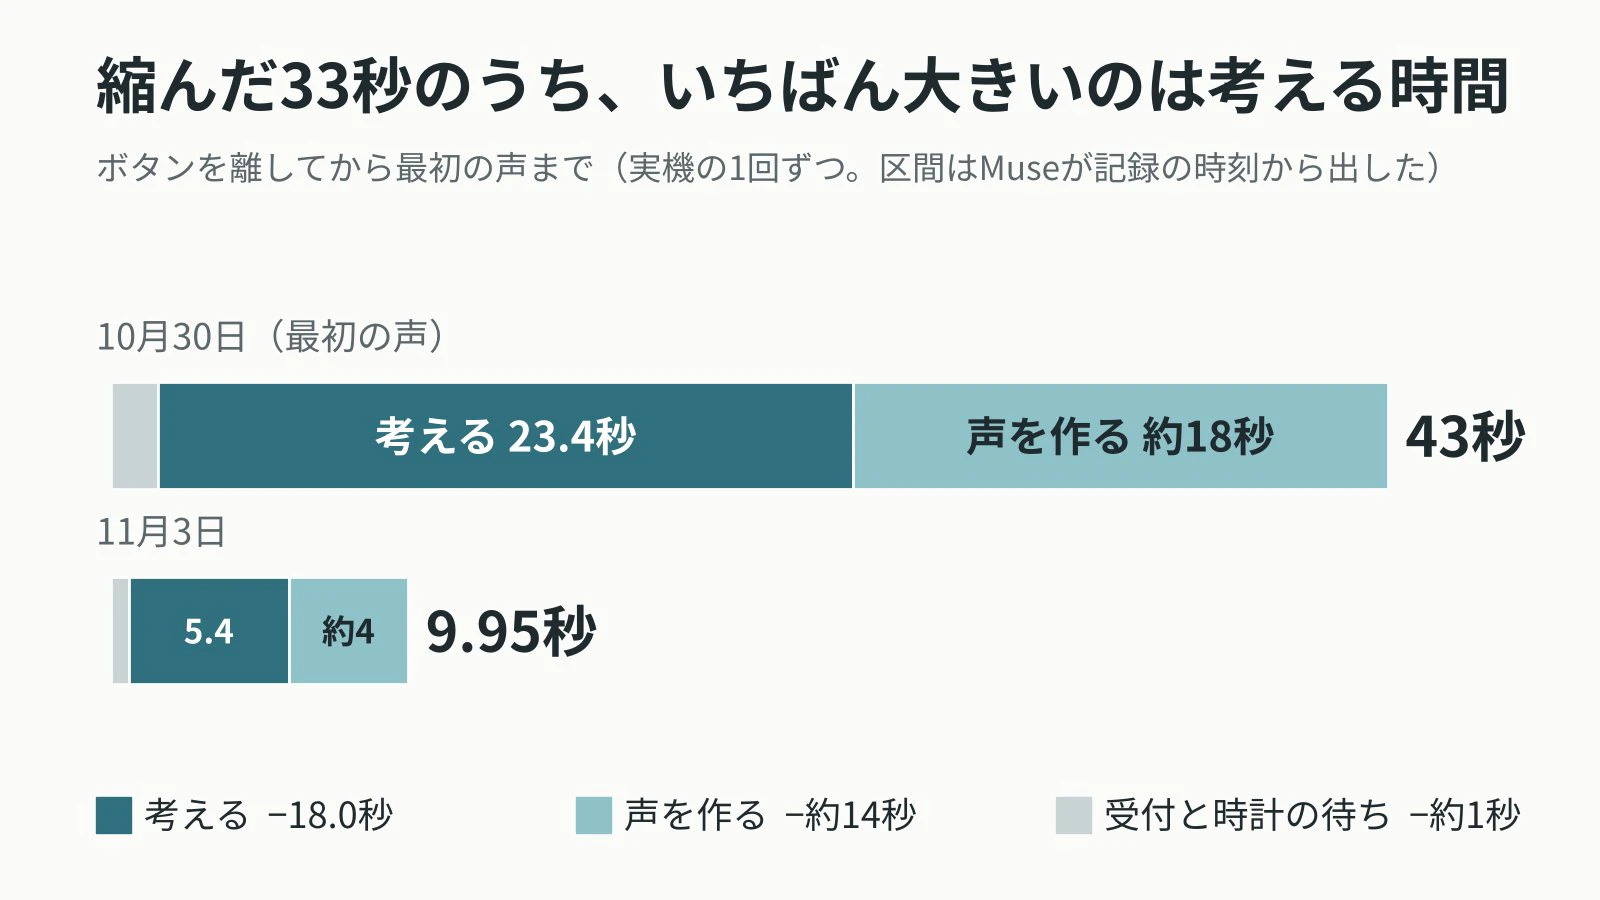
縮んだ33秒の内訳は、考える時間が18.0秒、声を作る時間が約14秒、残りが約1秒です。工夫の数は声を作る側のほうが多いのですが、縮んだ秒数では考える側が上回りました。
ただし、これは別の日の別の質問を1回ずつ比べた数字です。考える時間は質問と文脈で大きく変わるので、18秒がすべて工夫の効果とは言えません(日ごとの中央値は4節)。
3. 声を作る側でやったこと
返事を文ごとに分けてできた順にしゃべる
いちばん効いたのは、返事をまとめて声にせず、文の部品ごとに作って、できた順に時計がしゃべる形にしたことです。
最初の声が出るまでの時間が、返事全体の長さに左右されなくなりました。
ほかの音声エージェントでも、同じやり方が定番です。話し終えてから最初の音までをTTFA(time to first audio)と呼び、ここを縮めます(ElevenLabs)。
同じ質問で比べると、差はこうなりました(11月5日、5問の中央値)。
| 形 | 文字が揃ってから最初の声まで | 部品の間の無音 |
|---|---|---|
| ① 全文の形(10月30日の形) | 7.1秒 | なし(1つの音声) |
| ② 昔の文ごとの形(1つ目15〜20字) | 3.2秒 | 5回中2回(0.4秒、1.5秒) |
| ③ 今の文ごとの形(1つ目24〜28字) | 4.3秒 | 5回中1回(0.7秒) |
1つ目の部品は短ければよいわけではなかった
一般には、1つ目の部品を短くすると最初の音が早く届くと言われます(ElevenLabs)。私たちも最初は1つ目を15〜20字にしました。
ところが実機では、1つ目を話し終えても2つ目が間に合わず、2.6秒と1.7秒の無音が空きました。
当時、VMで声を作る速さは約7字/秒で、ずんだもんが話す速さ(約5字/秒)とあまり変わらなかったからです。
Museは、新しい文章12本で同じ無音を再現してから、分け方を変えました。
- 1つ目を24〜28字にする
- 次の部品は、前の部品の1.45倍までにする
- 最後以外で16字未満の部品は、次の部品とつなげる
同じ質問で比べると、③の今の形は、②より最初の声が約1秒遅く、無音は減りました。早さと途切れなさのどちらを取るかは、声を作る速さと話す速さの差で決まります。
決まった返事は先に声にしておく
挨拶、相槌、確認などのよく使われる決まった19文は、消えないキャッシュに入れました。
Museも同じ文言で返すので、声はキャッシュから出すだけ(約0.01秒)です。時計で測ると、挨拶は返事の文字が届いてから1.1〜1.3秒で声が出ました。
同じ日に同じ質問をし直したときも、作った部品を使い回せます。天気を聞き直したときは、13.2秒が3.3秒になりました(VMでの計測)。
細かい待ちを1つずつ削った
| やったこと | 変わったこと |
|---|---|
| 返事を見つけたら、すぐ声を作り始める | 0.5秒ごとの見回りをやめた。平均0.5秒、最大1秒の待ちが消えた |
| 時計の最初の問い合わせを早める | 返事の文字が届いてから1.5秒後だったのを0.8秒後に |
| MP3にする処理を、別のプロセスからブリッジの中へ | 1部品あたり約0.06〜0.15秒 |
| 長さを測るffprobeをやめ、WAVの頭から計算する | この段の中央値が313ミリ秒から167ミリ秒に |
| 起動時と、30分使わなかったときに1本作っておく | 起動直後の遅い初回(35秒の例)を、だれも待たない |
4. 考える側でやったこと
声を作る時間をいくら縮めても、Museが考える時間のブレは残ります。
11月1日には、Muse側の要約処理と重なった1往復に149秒かかり、時計が待ちきれずに時間切れになりました。
考える側は、速く考えることより、考え方と流れを変えることで縮めました。Museと決めたのは次の4つです。
- 時計への返事は、結論の1行を先に出す。続きは文ごとの声が追いかける
- 決まった質問には、考えずに即答する。3節の19文は、声のキャッシュであると同時に、考えを省く近道でもある
- 重い調べものは時計との会話ではしない
Museが会話の記録から出した、日ごとの考える時間(声のメモの行から最初の返事の行まで)はこうです。
| 日 | 往復 | 中央値 | 最大 |
|---|---|---|---|
| 10月30日 | 37 | 10.3秒 | 88.7秒 |
| 10月31日 | 32 | 8.4秒 | 55.7秒 |
| 11月1日 | 24 | 5.4秒 | 149.3秒(要約と重なった回) |
| 11月2日 | 3 | 7.4秒 | 7.6秒 |
| 11月3日 | 9 | 2.9秒 | 17.5秒 |
中央値は10.3秒から2.9秒に下がりました。
ただし、この数字には返事の長さや質問の中身の違いも入っていて、件数も少ないです。どの工夫がどれだけ効いたかまでは分けられません。
5. 待っている間の見せ方
待ちの体感は、長さよりも「音がない」「何が起きているか分からない」で決まります。
始まる前の待ちは、始まったあとの待ちより長く感じます(Maister 1985)。待ち行列の心理を8つの原則にまとめた文章です。
人の会話の「間」は短く、これを調べた研究では、日本語の返答までの間は平均7ミリ秒でした(Stiversほか)。
会話の間に比べると、数秒の待ち時間でも、ガジェットが黙っていれば、それはかなり長く感じます。
そこで時計には、待っている間も「聞いている」と伝える動きを入れました。
- ボタンを押すと振動し、離すと画面の縁を回るリングと上を見る目に変わる
- 5秒たったら「えーっと」系の相槌を鳴らす。12秒でもう1つ、25秒からは長い待ち用を鳴らす
- ※サイレントモードを入れ、画面が見えないとき(伏せている、画面が消えている)に返事が来たら、振動して知らせる
相槌は、最初は3秒で鳴らしていましたが、試すと体感で早すぎると感じたので、5秒に延ばしています。
6. 速くなったかを測るときの落とし穴
測り方で転んだ話です。
測ったつもりで、測れていなかったことが3回ありました。
同じ文章で測るとキャッシュで速く見える
ある合成の方法を試していたとき、同じ文を繰り返し測っていると、2.10秒が0.13秒になりました。
喜んで採用したところ、その後の会話では部品の間の無音が約3.6秒に増えました。
これは、エンジン側のキャッシュが効いて速く見えていただけで、試した方法による改善ではありませんでした。
試したい機能がそもそも動いていなかった
合成を止める機能を見つけて試すと、会話の打ち切り処理が最初は速くなったように見えました。
でも調べていくと、その機能は実は無効で、404が返っていました。
速くなったのではなく、エラーで落ちていただけでした。
キャッシュを切っても前回のファイルを読んでいた
3節の同じ質問での比べ直しは、1回目に失敗しています。
検証用にブリッジのキャッシュは切っていたのですが、②と③の回で、①で作ったファイルを時計が読んでしまい再計測となりました。
時計は、返事の本文から計算したファイル名をつけ、その名前でファイルを読んでいます。今回検証用に同じ質問をしました。そのため、3つの形で返事の本文が同じで、同じ名前のファイル名になりした。
このファイル名部分は切れていなかったのです。
Museがブリッジを直し、測るときだけ、声を作る前に同じ名前のファイルを消すようにしました。そのうえで、3つの形を改めて測り直しています。
ほかにも、全文の形の文字から声までが、11月3日は11.6秒、11月5日は7.1秒でした。
別日に改めて測り直す間にエンジンを更新したので、そのおかげに見えました。
Museが記録を調べると、差は返事の長さ(中央値115字と62字)から来ていて、1字あたりの時間は変わっていませんでした。
※天気の話だってので、別日で回答が変わりました。
この3回から、測るときは次の3つを確かめることにしています。
- 新しい文章で測る。繰り返したときの速さは別に記録する
- 対象の機能が本当に動いているか(200が返るか)を先に確かめる
- 前回の結果のファイルやキャッシュを消してから測る
測って採らなかった手(5つ)
| 手 | 結果 |
|---|---|
| VOICEVOXのcoreを直接呼ぶ | HTTP経由より、どの長さでも遅い |
ストリーミング合成(/streaming_synthesis) |
最初の音は0.4秒早いだけで、全部できるまでは73%遅い |
| 合成の並列化 | VMでは速くならず、直列のまま |
| 同じ文に強い合成の方法を標準にする | 初めての文が遅く、本番で無音が増えた。戻した |
| ユーザー辞書261語 | 測っても、決まって遅くなる傾向はなかった |
7. 質問への答え
工夫について質問をいただいたのは、この投稿に対してでした。
私からの答えは4つです。
- まず、ボタンを離してから声までを区間に分けて測った
- 声を作る側は、文ごとに分けてできた順にしゃべり、決まった返事は先に声にしておいた
- 考える側は、結論を先に、決まった質問は即答、重い調べものはアプリへ、と考え方と流れを変えた
- 待っている間は、振動、目の動き、相槌で「聞いている」と伝えた
43秒が約10秒になったのは、1つの工夫ではなく、この組み合わせの結果です。
8. 最後に、自分のデバイスで試すなら
ぜひ、下記を試してみてください。
- 次に1往復試すときは、ログに時刻を出し、離してから最初の声までを区間に分ける
- 返事を文ごとに分けるときは、声を作る速さと話す速さを一度比べてから、1つ目の長さを決める
- 速くなったかを測るときは、新しい文章で、前回のファイルを消してから測る
以上、皆さんの参考になりましたら幸いです。
付録
主な参考文献
- muse-gadget-sdk(Meta、Apache-2.0)
- Meta wants you to build your own Muse gadget(TechCrunch、2026-10-02)
- Meta presentó Muse(Mercado、2026-09-10)
- M5Stack StopWatch
- VOICEVOX Engine
- Voice agent latency optimization(ElevenLabs)
- Maister, D. (1985). The Psychology of Waiting Lines
- Stivers, T. et al. (2009). Universals and cultural variation in turn-taking in conversation. PNAS 106(26).
調査限界
- 数字は、私の時計1台とMuseのVM1台で測ったものです。VMの性能や混み方、Museの版で変わります。
- 43秒と9.95秒は、別の日の別の質問を1回ずつ比べたものです。同じ質問での比較(3節)は、1つの形につき5回だけなので、1秒より小さい差はたまたまかもしれません。
- 声の受け渡しは、Museの会話の記録を読むしくみに頼っています。公開された仕様ではないので、Museの更新で動かなくなる可能性があります。
- この記事は個人の工作の記録です。
AIの利用について
時計のファームウェアと、この記事の調査と下書きはClaude(Anthropic)が作りました。VMのブリッジはMuseが作りました。数字はすべて実機とVMのログに戻って確かめています。
クレジット
音声:VOICEVOX:ずんだもん