
はじめに
空きメモリが 41% まで落ちていました。
犯人を調べたら、使っていない MCP サーバに 33GB も取られていました。
serena を 10 project 分動かしていただけです。
TL;DR
「使うときだけ起動する」proxy を自作して、待機中メモリを 148MB まで下げました。成立の条件は 3 つあります。
- 物理 footprint で測る(RSS だと問題が 10 分の 1 に見える)
- プロセスグループ単位で kill する(親だけ止めても孫の LSP が残る)
- handshake の全メッセージをキャッシュで応答する(
initializeだけでは足りない)
serena を例にしていますが、重たい stdio MCP サーバ全般に通じる話です。
1. 待機中の MCP サーバに 33GB 取られていた
Mac(24GB)で Claude Code を 2 セッション立ち上げたまま普段どおり作業していたら、アクティビティモニタに表示された空きメモリが 41% まで落ちていました。
swap のインアウトも明らかに多く、何かが異常にメモリを使っている状態です。
tool を 1 回も呼んでいないのに重い心当たりは、.mcp.json に書いた 10 project 分の serena だけでした。
Claude Code はセッションごとに .mcp.json のサーバを起動するので、2 セッションあれば serena は 合計 20 プロセス動く計算になります。
実際に計測してみると、2 セッション合計で物理 footprint 33GB、swapout は約 89 万回。
「使っていないんだからそんなに重くないだろう」の見積もりが、完全に外れていました。

棒グラフは project ごとに 2 セッション分(= 2 プロセス)を合算したものです。
見てわかるとおり、Rails 系で LSP が重いものや、Vue + TS の tsserver が大きいものが上位 4 本を占めており、下位は数百 MB。
「一握りの重い project が総量を決める」形の分布で、残りの軽い project を切っても大勢は変わりません。
で、使っていない 20 プロセスに 33GB を取られたまま、他のプロセスを圧迫して swap に追い出していました。
RSS で測ると問題が 10 倍小さく見える
最初に測ったときは ps の RSS で済ませていました。
1 project あたり 300MB 弱で、10 project 分で 3GB 程度。
これなら「まあ重いけど、致命的でもない」の判断です。
でも、物理 footprint で測り直すと数字が全然合いませんでした。
同じ時点を 2 つの指標で見ると、こうなります。
| 計測方法 | 2 セッション合計 |
|---|---|
ps の RSS 集計 |
2.9GB |
top の MEM 列(物理 footprint) |
33.0GB |
| swapout 回数 | 約 89 万回 |
同じ瞬間を測って、RSS と物理 footprint で 10 倍以上の差が出ています。
原因は、RSS が「物理メモリに現在占有している量」だけを示し、macOS が圧縮や swap に追い出した分を含まないことにあります。
一方の物理 footprint は、追い出された分も含むので、OS を実際に圧迫している量に近い値になります。
RSS だけで判断していると、問題の大きさを 1 桁小さく見積もってしまいます。
物理 footprint は top -l 1 -stats pid,mem で取れます(MEM 列が footprint)。
10 倍の差は macOS では珍しくないらしいです。
なぜ tool を呼んでいないのに重いのか
答えは単純で、serena は --project <絶対パス> 付きで起動した瞬間から、裏で LSP の起動と indexing を始めるからです。
tool を 1 回も呼んでいなくても、起動して放置するだけで重くなります。
試しに 1 本の serena を起動して 60 秒放置した結果(1 プロセスとその子孫 LSP の合計 footprint)はこうです。
- serena-web を 1 本、60 秒放置 → 3.0GB
- serena-rails を 1 本、60 秒放置 → 3.7GB
重い project なら 1 プロセスで 3〜4GB、軽い project でも数百 MB。
これが 20 プロセス積み上がって、合計 33GB になっていたということです。
2. なぜ「使うときだけ起動する」を自作したか
33GB は測れました。
問題が実在するとわかった以上、次は手当てです。
ただし、既存の対処をそのまま採る前に、何が足りないのかを要件から確かめました。
要件は 4 つ
- Claude Code を起動したときに、使わない serena まで立ち上がらない
- 使い終わったら、メモリを解放する
- 普段どおりチャットのまま使える(セッション切り替えや手動操作が要らない)
- tool 名が今と同じ(既存の設定・使い方を変えない)
4 要件で候補を比べた結果
4 要件に照らすと、こうなりました(◎ 満たす / △ 部分的 / × 満たさない)。
| 候補 | ①起動時に立たない | ②使い終わったら解放 | ③普段どおり | ④tool 名そのまま |
|---|---|---|---|---|
| 使い終わりに kill する reaper | × | △(時間差あり) | △(次に使えない) | ◎ |
/mcp で手動 ON/OFF |
◎ | ◎ | ×(手動) | ◎ |
| serena を 1 本にして project 切り替え | ◎ | △(切替時のみ) | ◎ | ×(名前が変わる) |
| 自作 proxy | ◎ | ◎ | ◎ | ◎ |
一見どれも使えそうですが、4 要件全部を満たすのは自作 proxy だけでした。
他の案はどこかで落ちます。
代替案がどこで落ちるか
まず kill する reaper は、idle の serena を定期 kill するスクリプトを launchd で回す方式です。
これだと 1 回 kill されたサーバの復活に /mcp の手動操作が要るので、要件 ③ が崩れます。
次に /mcp で手動 ON/OFF は、Claude Code の UI で使うときだけサーバを有効化する方式。
手動操作が入る時点で ③ に反しますし、そもそもバックグラウンドで動かす Claude Code セッション(UI がない)では使えません。
最後に serena 1 本で project 切り替え は、--project を付けずに起動して tool 側の activate_project で切り替える方式です。
tool 名が project ごとに変わるので ④ から落ちます。
加えて、project を切り替えるたびに起動を待たされます(Rails 系で切り替え 1 回あたり 75 秒)。
自作 proxy という選択
残ったのは自作 proxy です。
Claude Code と serena の間に proxy を挟み、起動時の handshake は proxy が自分で返す。
tools/call が来た瞬間だけ serena を起動して転送し、idle 時間が過ぎたら proxy が serena を止める。
これなら 4 要件を全部満たせます。
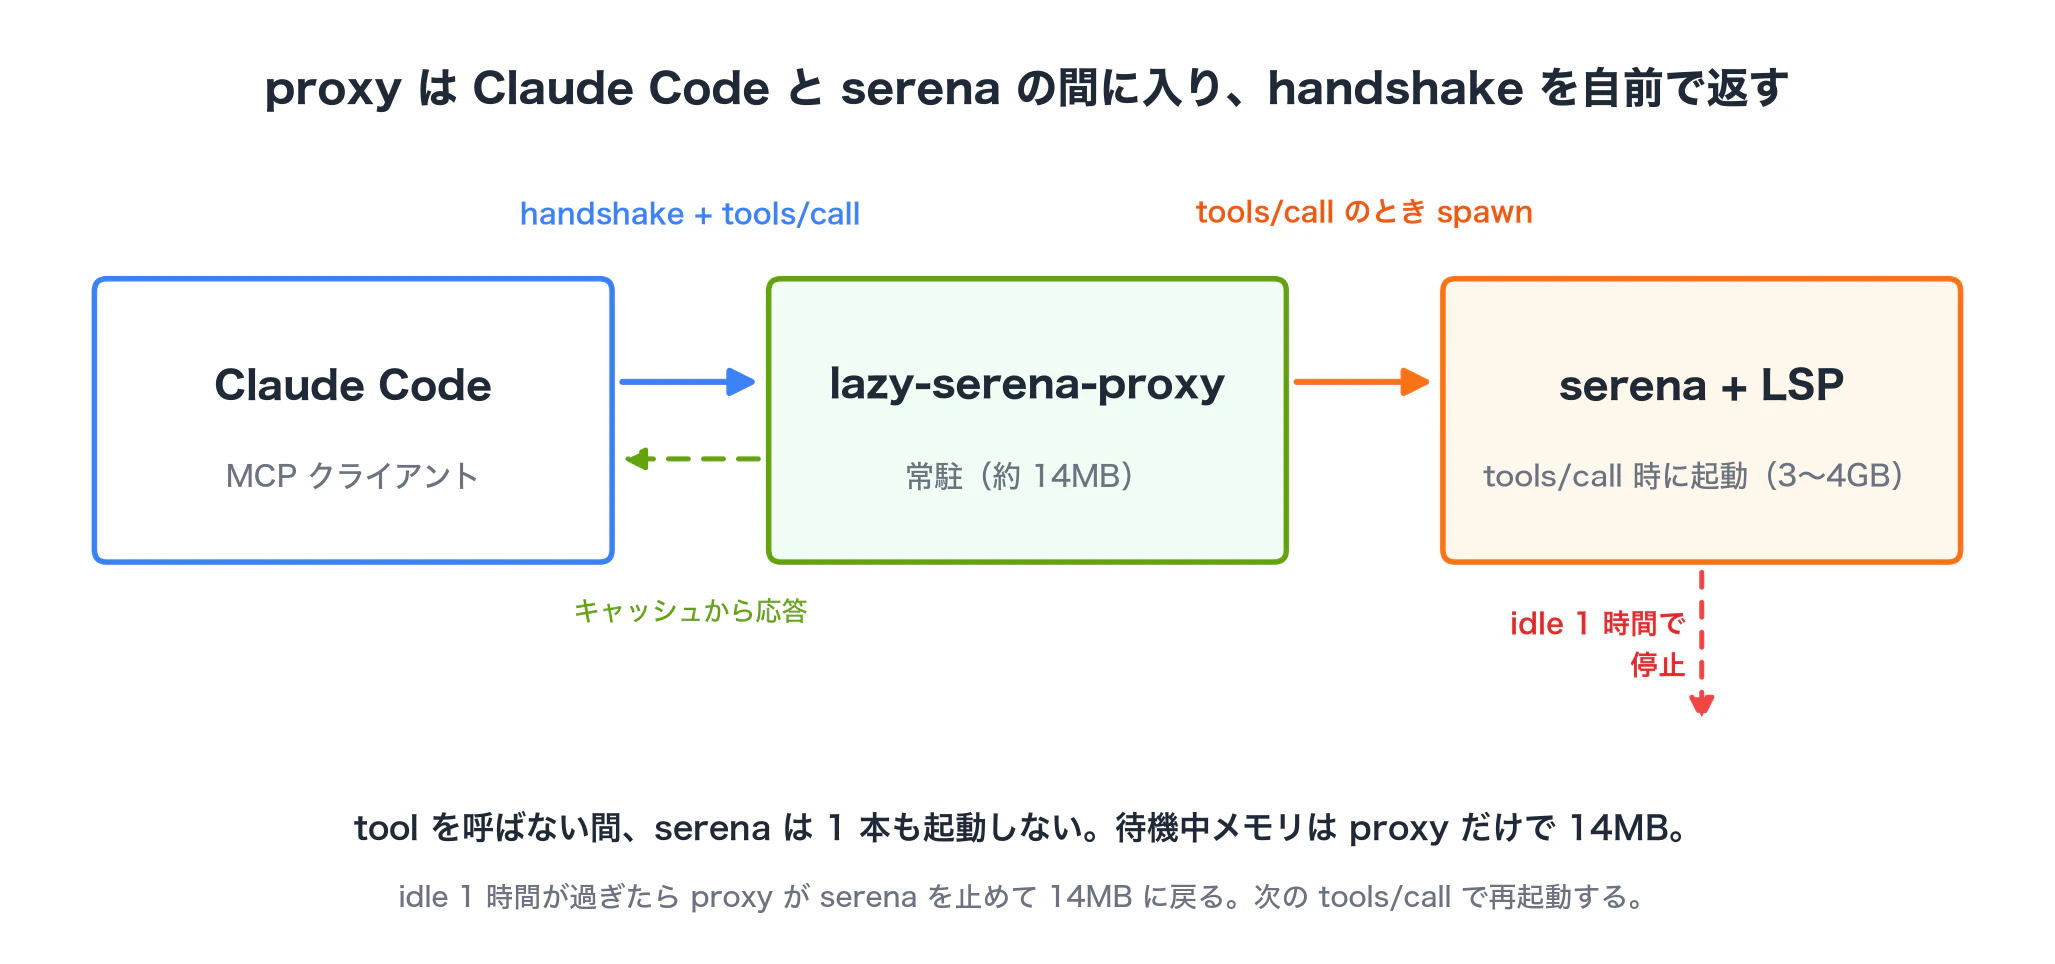
MCP の起動時にクライアントとサーバがやり取りする一連のメッセージを、ここでは handshake と呼びます。
proxy がこの handshake を全部自前で返せれば、serena を立ち上げずに済みます。
同じ方向性の OSS として mcp-snooze もあります。
ただし公開から 4 日・star 1・配布バイナリ未署名で、proxy が通信全体を見える位置に入ることを考えると、信頼性の裏付けが足りないと判断して自作にしました。
3. 設計で潰した罠と、実機で露呈した罠
実装に入る前に設計書を 1 本書いて、自分で見直しました。
この時点でプロセス管理と並行処理の分野に、放っておくと lazy 化が成立しない罠が潜んでいることに気づきます。
プロトコルの罠だけは、PoC で実機ログを見るまで気づけませんでした。
3-1. プロセス管理(SIGTERM は孫まで届かない)
proxy が serena を止めるとき、親プロセスを止めるだけでは子孫が残ります。
素直な実装でよく踏む罠です。
罠
proxy は serena を subprocess で起動し、idle 時に kill します。
素直に書くと proc.terminate()、つまり親プロセスに SIGTERM を送るコードですが、ここに落とし穴があります。
実行コマンドは uvx --from git+... serena start-mcp-server ... で、実際に動くのは uvx の下に serena、serena の下に LSP が並ぶ 3 階層構造だからです。
uvx                         (親、Claude Code が起動した PID)
 └ serena (Python)
    ├ ruby-lsp
    ├ tsserver
    ├ pyright
    └ ...(LSP 複数本)
SIGTERM の宛先は uvx で止まり、serena と LSP の孫は孤児として生き残ってしまいます。
実測では、2 セッション分で LSP が合計 69 本動いていました。
親プロセスだけ止めても、この 69 本が丸ごと残って、待機中メモリは下がりません。
uvx は、Python パッケージを一時環境にインストールして実行する uv のサブコマンドです(pipx run 相当)。
実装パターン
対策はシンプルで、プロセスグループを分けて起動し、グループごと kill します。
proc = subprocess.Popen(
    cmd,
    stdin=subprocess.PIPE,
    stdout=subprocess.PIPE,
    stderr=stderr_log_file,
    start_new_session=True,  # 新しいプロセスグループを作る
)

# 停止するとき: グループ全体に SIGTERM
os.killpg(proc.pid, signal.SIGTERM)
try:
    proc.wait(timeout=3)
except subprocess.TimeoutExpired:
    os.killpg(proc.pid, signal.SIGKILL)
ポイントは start_new_session=True です。
これで子プロセスが新しいセッションリーダーになり、os.killpg(pid, sig) でグループ全体にシグナルが届きます。
3 秒待っても止まらない場合は SIGKILL で引き剥がして、孫の LSP まで確実に止めます。
stderr を subprocess.PIPE のままにして誰も読まないと、serena のログがパイプで詰まって応答が止まります(macOS では約 64KB で詰まります)。
stderr はログファイルに直接書かせるのが安全です。
3-2. プロトコル(initialize だけキャッシュしても足りない)
v1 設計では「initialize と tools/list をキャッシュし、他は転送」でした。
これで tool を呼ばない間は serena が起動しないはずでした。
ところが実装して Claude Code 実機で動かしたら、tool を呼ばないセッションでも serena が立ち上がっていました。
罠
v1 の方針を 1 枚にすると、こうです。
| method | v1 の扱い | 結果 |
|---|---|---|
initialize |
キャッシュから応答 | serena 起動しない |
tools/list |
キャッシュから応答 | serena 起動しない |
| その他全部 | serena に転送 | 届いた瞬間に serena が起動 |
proxy のログに受信順を出して確かめると、最初に届くのは server/discover(MCP 2026-07-28 版の問い合わせ)でした。
v1 はこの method を知らないので、素直に serena へ転送してしまい、その瞬間に serena が起動していました。
これでは lazy の意味がありません。
Claude Codeが起動時に送るメッセージの順は、順にこうなっていました。
server/discoverinitializenotifications/initializedtools/listprompts/listresources/list
つまり initialize だけキャッシュしても足りず、前の server/discover と後ろの各 list のいずれかが serena に届けば起動してしまうということです。
実装パターン
対策として、handshake の全メッセージを proxy 側でさばきます。

-
server/discoverには{"error": {"code": -32601, "message": "Method not found"}}を返します。
Claude Code は未サポートだと見て、従来の handshake に自動で切り替わります -
initialize/tools/list/prompts/list/resources/list/resources/templates/listはキャッシュから応答します -
notifications/initializedは notification(応答不要)なので、proxy が受け取って捨てます -
pingは proxy 自身が応答します(serena に転送しません) -
tools/callが来たときに初めて serena を spawn します。
spawn 直後、proxy は serena へinitializeとnotifications/initializedを送り直します。
そのあとtools/callを転送します
キャッシュのキーは、何を含めるかで性能も正しさも変わります。
今回は sha256(argv + PATH + protocolVersion) にしました。
| 要素 | 含める? | 理由 |
|---|---|---|
argv(起動コマンドと引数) |
○ | project(=--project の値)が違えば tool 一覧が違う |
PATH 環境変数 |
○ | PATH 次第で起動する serena や LSP が変わる(rbenv や mise が絡む) |
クライアント要求 protocolVersion
|
○ | version 次第でキャッシュした応答の形が合わなくなる |
実行時の cwd
|
× |
--project は絶対パスで指定するので cwd は結果に影響しない。含めると、別ディレクトリから叩くだけでキャッシュミスする |
キャッシュが存在しないときは、その場で serena を 1 回起動して handshake を実行し、応答を保存します。
「キャッシュがないならエラーで終了する」設計にしてしまうと、Claude Code からそのサーバが使えなくなるからです。
3-3. 並行処理(同期ループは通知を取り落とす)
proxy が serena に tool を転送した後も、クライアント側は別のメッセージを送ってきますし、serena 側からも通知が流れてきます。
両方向のメッセージを同時にさばけないと、途中で動かなくなります。
罠
v1 は、クライアントから届いたリクエストを serena に転送したら、応答の id が一致するまでループで待つ構成でした。
タイムアウトは 60 秒。
一見シンプルですが、この構成だと応答 id を待つループに入っている間、他のメッセージが届いても捨ててしまいます。
で、こんな症状が出ました。
- serena から届く
notifications/progressを途中で捨てる(進捗が UI に出ない) - クライアントから届く
notifications/cancelledを転送できない(tool 実行中に止められない) - Rails 系の初回 indexing(約 85 秒、普通の起動時)を途中で止める手段がない
- idle 判定のタイミングと重なると、indexing 途中で kill → 再起動のループに陥る
「待つ」ことに特化した構成だと、同時に起きる他のことに対応できないんですね。
実装パターン
そこで、役割ごとに独立したスレッドを立てて、通知を取り落とさない構造にします。
| スレッド | 役割 | 主な入力 | 主な出力 |
|---|---|---|---|
| stdin reader | クライアントのメッセージを読み、method で振り分ける(notifications/cancelled が来たらすぐ serena へ転送) |
proxy の stdin | spawn 要求 / cache 応答 / forward / cancel 転送 |
| spawner | serena を起動する。起動中に届いたメッセージを queue にためる | 起動要求 | 起動完了通知、queue の順次フラッシュ |
| forwarder | serena の stdout を 1 行ずつ読み、notifications/progress や list_changed も含めてそのままクライアントへ流す |
serena の stdout | proxy の stdout |
| idle watcher | 最終活動時刻を監視し、idle 時間を超えたら serena を止める(§3-1 のプロセスグループ kill を呼ぶ) | 時計 + 活動時刻 | kill 指示 |
ポイントは、方向の違うメッセージを別々のスレッドで扱うことです。
クライアント → serena 方向は stdin reader が cancel を転送し、serena → クライアント方向は forwarder が progress を流します。
これで 2 つの向きがお互いをブロックしません。
もう一つの工夫は idle watcher 側にあって、tool 実行中は「処理中のリクエストあり」と判定して停止を抑止するようにしてあります。
その代わり、proxy 側の時間制限はなくして、タイムアウトの判断は Claude Code 側に任せました。
serena の起動は数秒〜数十秒かかります。
起動中に届いたメッセージを spawner が queue にためておかないと、起動完了と同時に大量のメッセージが流れて順序が狂います。
起動完了後に queue を順次フラッシュする設計にしているのはこのためです。
4. 33GB → 148MB、空き 41% → 83%
3 つの罠を実装パターンで塞いだ proxy で、実際に待機中メモリはどこまで下がったか見ていきます。
比較の数字と条件
全 10 サーバを proxy 経由に切り替え、キャッシュを事前に作って Claude Code を再起動した結果がこちらです。
| 項目 | 導入前 | 導入後 |
|---|---|---|
| serena 系の物理 footprint(待機中) | 33.0GB | 148MB |
| システム全体の空きメモリ | 41% | 83% |
| swapout 回数 | 約 89 万回 | 計測していない |
ただし、この表には注意書きが要ります。
導入前は 2 セッション × 10 project = 20 プロセスの合計で、導入後は 1 セッションに統合して proxy だけが 10 本待機している状態です。
つまり proxy 導入のタイミングでセッション運用も見直したので、見出しの「33GB → 148MB」には「2 セッション → 1 セッション」のセッション統合効果も混ざっています。
proxy 1 個あたりの常駐メモリは 14MB 前後なので、同じ 2 セッションのまま proxy だけ導入した場合でも、serena 系合計は約 300MB 以下に収まる見積もりです。
桁は変わらない範囲に収まります。
運用面でも、tool を呼んだ project だけ serena が立ち上がり、使い終われば 1 時間後に自動で止まります。
proxy が常駐してリクエストを受けるので、Claude Code 側からは「普段どおり使える」状態を保てます。
初回起動の時間(Rails 85 秒)
一方で、万能ではありません。
初回の 1 回だけは、serena の起動と indexing の時間がそのまま出ます。
- web 系 serena の最初の
find_symbol: 約 6 秒 - Rails 系 serena の最初の
find_symbol: 約 85 秒
Rails 系の 85 秒は ruby-lsp のインデックス作成そのものの時間なので、proxy 側ではどうにもなりません。
使い始めるタイミングで一息入れる前提になります。
その代わり idle を 1 時間にしているので、同じセッションで繰り返し使う分には起動は 1 回で済みます。
他の MCP サーバに同じ発想を適用するとき
serena に特化した話に見えますが、「使うときだけ起動する」発想は重い stdio MCP サーバ全般に通じます。
実際に適用の判断に使っているチェックは 3 つあります。
- 待機中の重さを物理 footprint で測る(1 本あたり 500MB 以上なら検討の価値あり)
-
handshake に未知 method が混ざらないか確認する(混ざるなら proxy で
-32601を返す仕様を書き足す) - 初回起動の数十秒が許容される運用か(短い対話で何度も切り替えると、待機のつらさが先に来る)
5. おわりに
今から思えば、きっかけは「空きメモリが減っている」だけでした。
RSS で測って「大したことない」と見積もっていたのが、物理 footprint で測り直して初めて 10 倍の差が見えた。
そこから先は、方式比較・設計・実装・検証と流れが自然に決まっていきました。
次に重たそうな MCP サーバを足すときは、まず top -l 1 -stats pid,mem で待機中の重さを測ります。
そのうえで .mcp.json に入れています。