
はじめに
テスト会議で「バグ、そろそろ収束してますよね?」と聞かれて、根拠を持って答えられるでしょうか。
感覚で「はい」と答えると、本番障害かコスト膨張のどちらかで事故ります。
この記事は、その両方を避けるための道具箱です。
TL;DR
- バグ収束曲線は "共通言語" としては便利ですが、単独で判断すると嘘をつきます
- 6 つの指標(曲線・残存推定・検出率・MTBF・カバレッジ・重大バグ)を束ねて判定フローに乗せると、感覚判断を根拠判断に変えられます
1. 「もう出ないよね?」に感覚で答えると事故る
なお、バグ収束曲線は「信頼度成長曲線」とも呼ばれます。同じものを指しているので、この記事では表記を統一して「バグ収束曲線」で通します。
はじめにの続きで、感覚で答えると具体的にどう事故るかを整理します。
テスト週報で「今週は 3 件しか出ませんでした、収束傾向です」の 1 行を見たとき、リリース判定会議で追認するかどうか。
以前の自分は、この一行を "感覚で追認する側" にいました。
そこで無意識に選ぶ道が、後から 2 種類の失敗として跳ね返ってきます。
| 失敗の型 | 何が起きるか | 起きたときの被害 |
|---|---|---|
| 未発見型 | まだ潜んでいるのにリリースを許可 | 本番障害 / 追加の緊急対応 |
| 過剰テスト型 | もう出ないのに延々テストを続ける | コスト膨張 / リリース遅延 |
どちらも根っこは「感覚で判断」しているところにあります。
曲線を "正しく" 読む道具を持てば、両方を避けられます。
まずは、その曲線がなぜあの形になるのかから見ていきます。
2. S字は偶然じゃない:発見効率が減衰する原理
原理を分かっていると、後で曲線が崩れたときに、崩れた理由が読めるようになります。ここは数式に深く入らず、大掃除のたとえで直感を掴む方針です。
2-1. 大掃除のたとえで直感をつかむ
テストを "大掃除" と考えると、S 字の形はすんなり入ってきます。
序盤は目立つゴミや大物の汚れがすぐ見つかり、掃除の成果がどんどん出ます。
終盤に残るのは、家具の裏や隅の細かい埃だけ。
同じ時間をかけても、見つかる量は減っていきます。
これがバグ収束曲線が S 字を描く理由です。
簡単なバグから順に見つかっていくので、時間とともに "見つけにくさ" が増していく。
別の言い方をすると、バグ発見の速度は "まだ見つかっていないバグの残数" に比例して落ちる、という性質があるだけです。
2-2. 数式は "覚えなくていい"
この性質を数式にしたのが、ゴンペルツ曲線 と呼ばれるモデルです。
品質管理の現場ではよく使われていますが、式を覚える必要はありません。
「そういう名前のモデルがある」と知っておくだけで、この記事の議論には十分です。
深追いしたい人は「信頼度成長曲線 ゴンペルツ」で検索すれば、リファレンスに辿り着けます。
2-3. 3つのレンズで同じデータを見る
同じ観測データを 3 つの角度から見ると、"収束" が何を意味するのかがはっきりします。
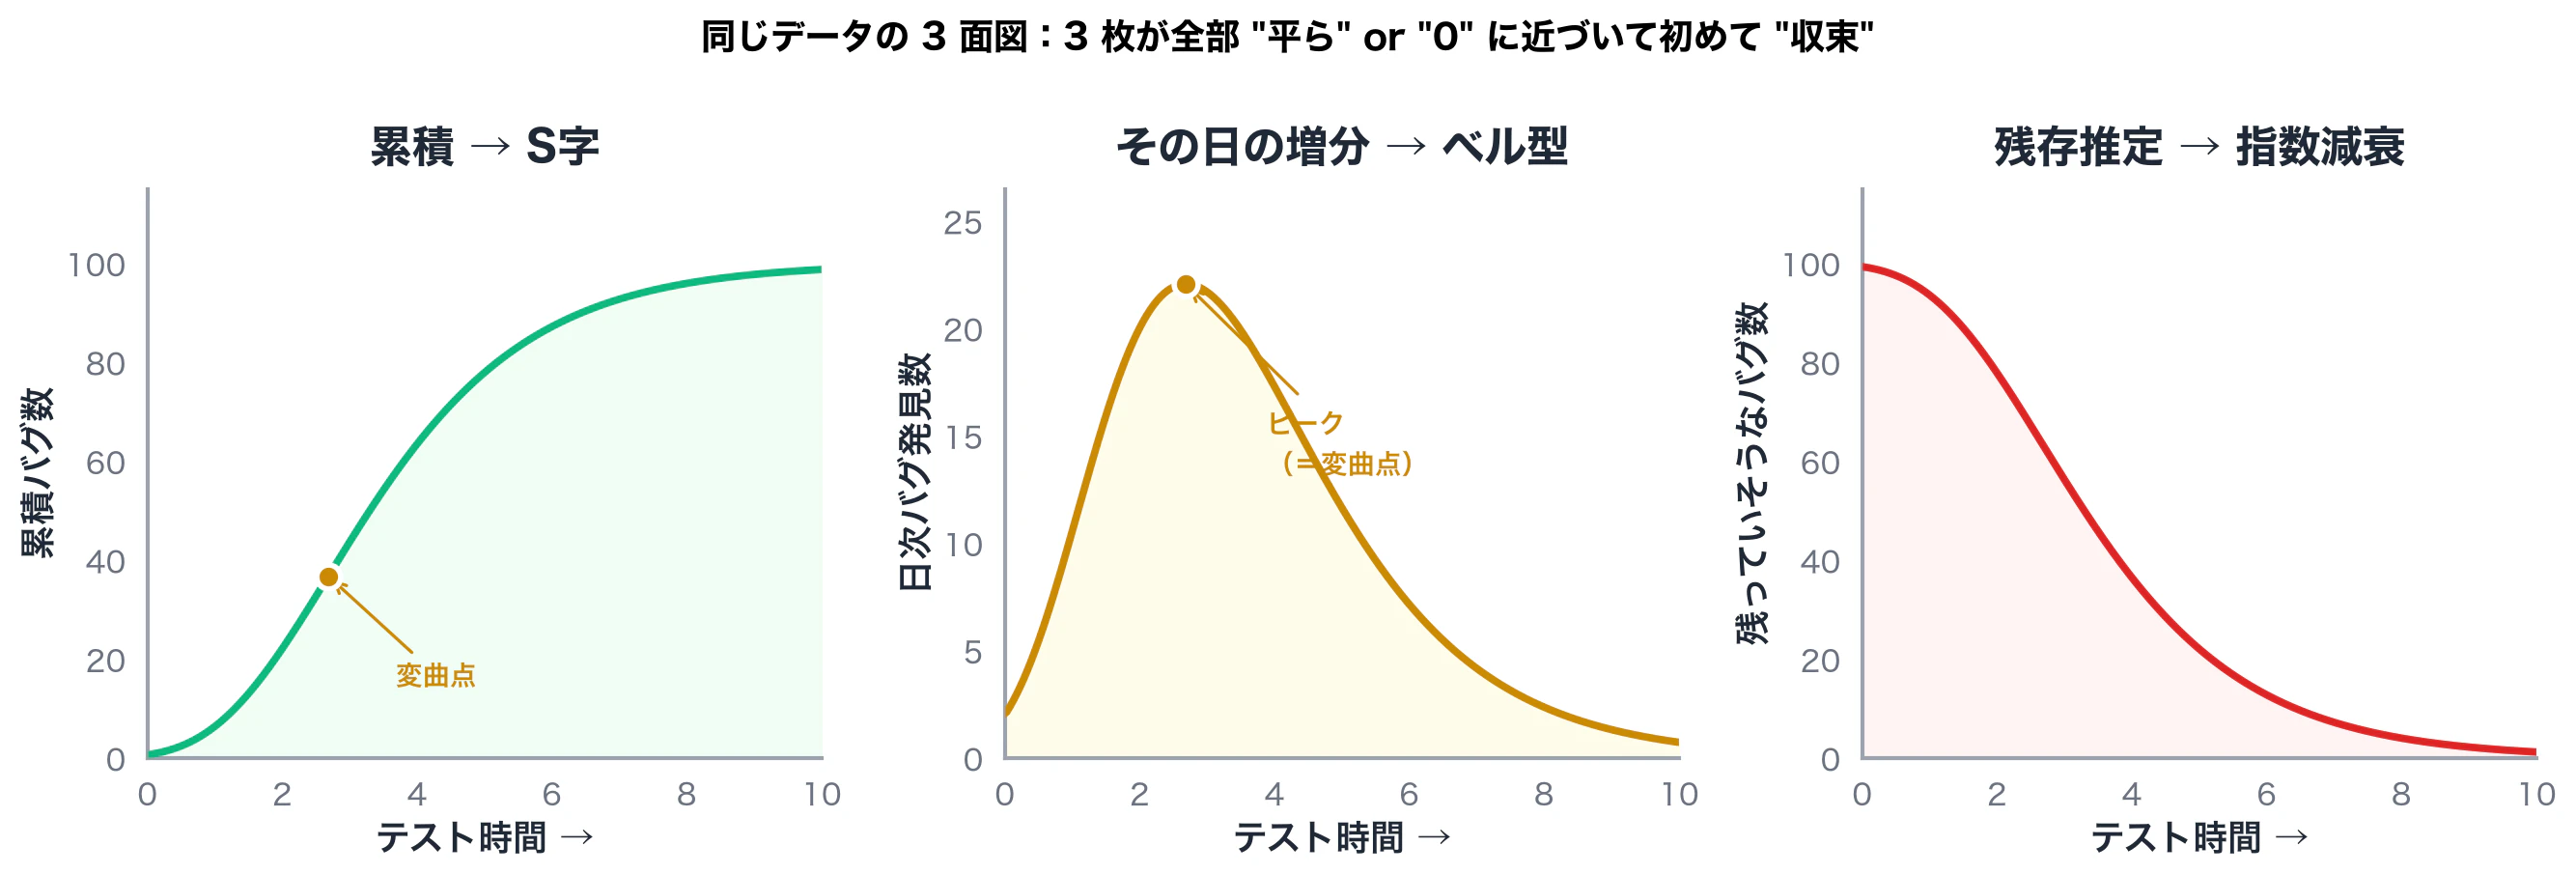
累積を見ると S 字、その日の増分を見るとベル型、残ってそうな数を推定すると指数減衰。
ベル型のピーク位置は「変曲点」と呼ばれ、S 字の中盤で発見速度が一番速くなる折れ目にあたります。
"収束した" と言えるのは、この 3 枚がすべて "平ら" または "0" に近づいた状態のときです。
累積だけを見て「平らになった=収束」と判断すると、後で扱う落とし穴で刺されます。
3. 現場で崩れる曲線:3つの典型パターン
理論の綺麗な S 字は、現実の現場ではほとんど歪みます。歪み方に名前を付けておくと、崩れた瞬間に「これは何の異常か」の仮説を立てやすくなります。
役割の切り分けを先に決めておきます。
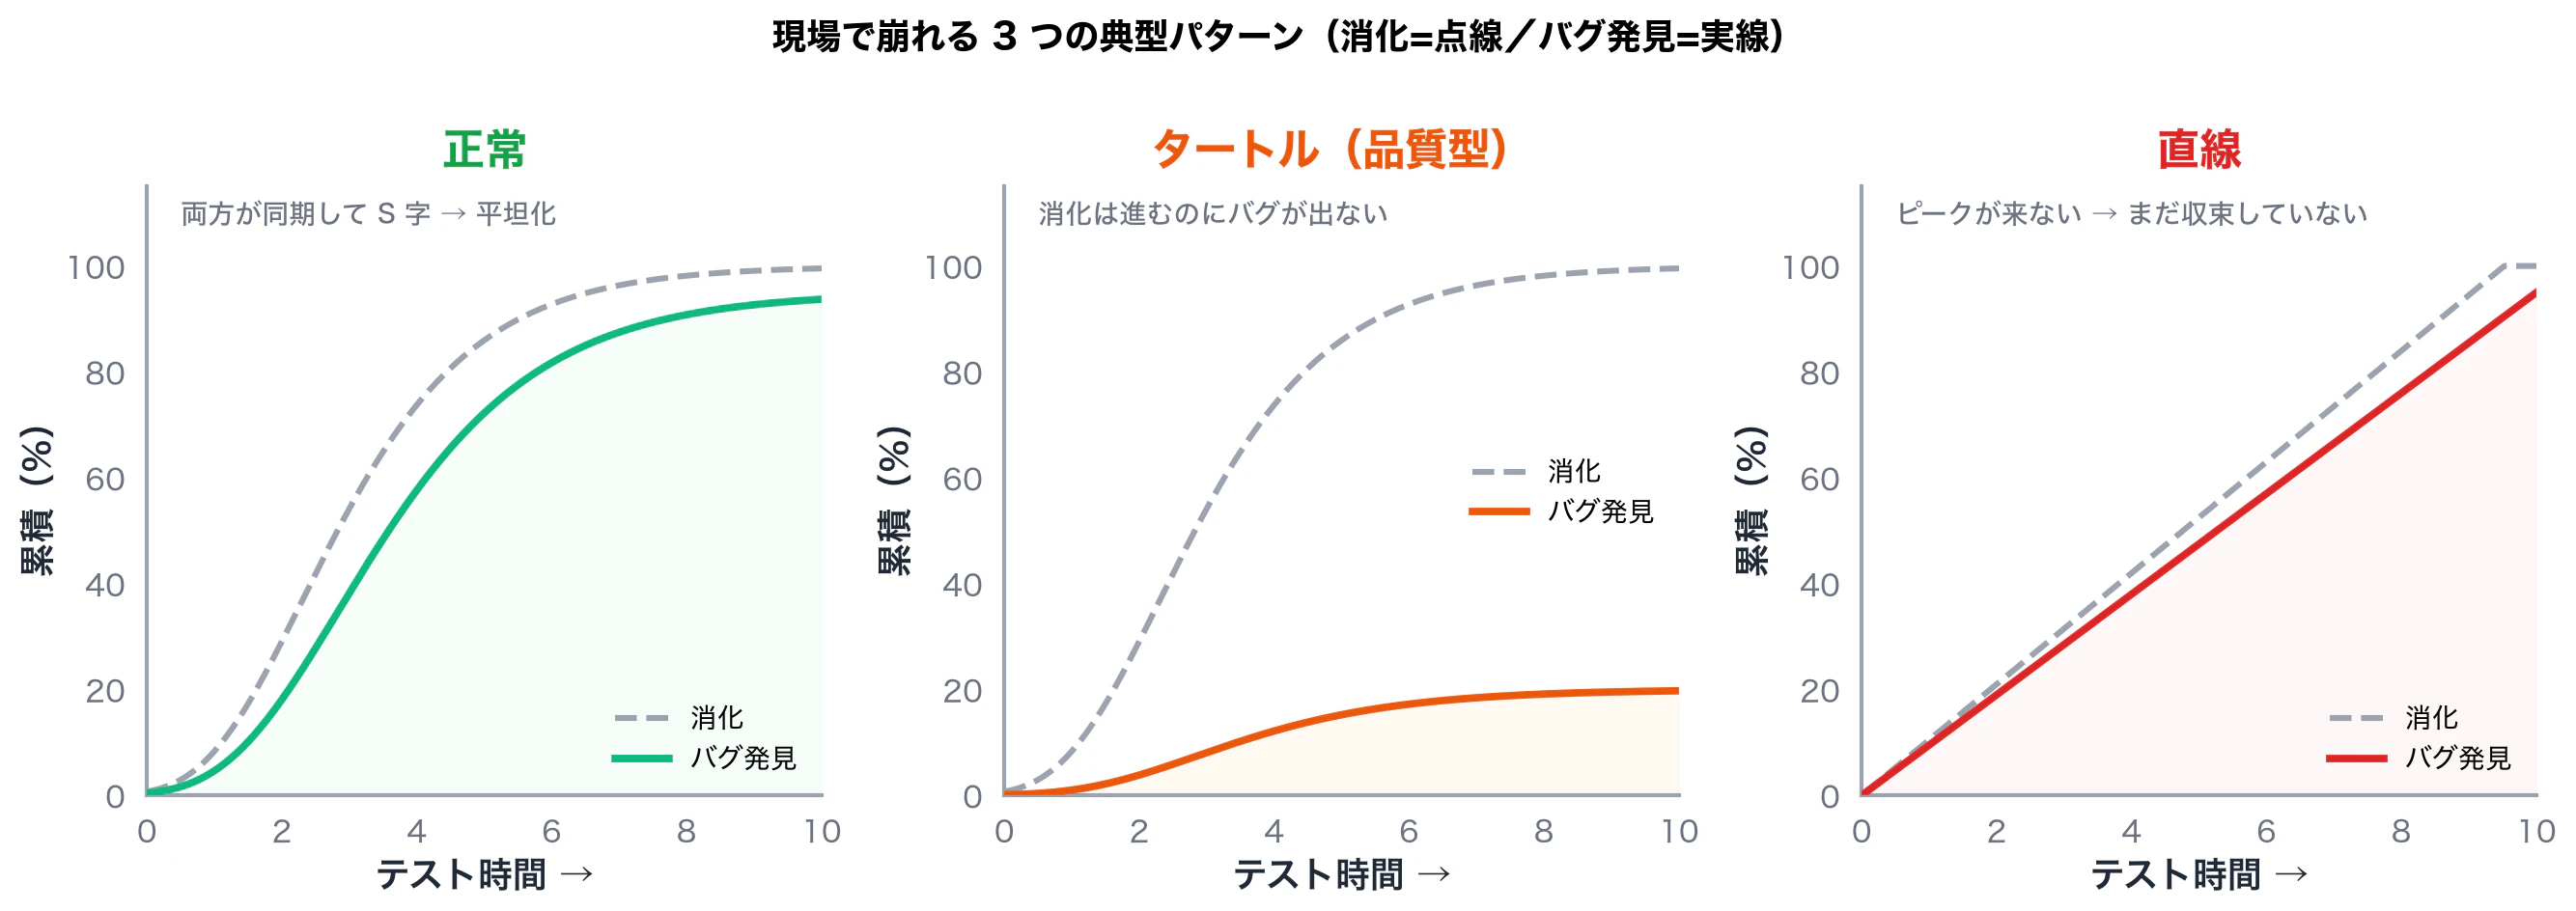
この章は 曲線の "形" からパターンを分類する 話です。
次の §4 は "軸選び・単独判定" が判断を歪める落とし穴を扱います。
両者は別の視点なので、混同しないようにします。
3-1. 正常パターン
理想形はシンプルで、消化曲線とバグ曲線が同期して S 字を描き、テスト終盤で両者が平坦化します。
§2 の絵の通りです。
実際にこの形になるプロジェクトは意外と少なく、下記の 2 パターンに崩れることの方が多いです。
3-2. タートル (品質型):消化は進むのにバグが出ない
テストケースを 1,000 件流したのに、バグが 15 件しか出ないような状況です。
「品質が高いんだ」と喜びたくなりますが、先に "テスト設計がザル" の可能性を潰す必要があります。
見分け方は、過去プロジェクトの発見率(テスト 1 件あたりの平均バグ発見数)との比較です。
発見率が過去平均より大幅に低ければ、テスト設計の網目が粗い可能性を疑います。
実務では "品質が高い" と自認する前に、この確認を挟むと安全です。
なお 2026 年時点では、AI 生成テストコードを大量投入した場合に発見パターンが変わることがあります。
過去プロジェクトと発見率を比較するときは、AI 使用比率も揃える意識を持っておくと精度が上がります。
3-3. 直線パターン:ピークが来ない
消化もバグも直線的に上昇し続け、変曲点(=バグ発見速度がピークを迎える折れ目)が来ないパターンです。
「累積が右肩上がりだから順調」と誤読しがちですが、まだ収束フェーズに入っていないのが正しい読みです。
これが数週間続くなら、テストが同じ層のバグを掘り続けている可能性を疑います。
境界値・異常系・並行実行のように観点を切り替えると、埋もれている別種のバグを掘り起こせることが多いです。
4. 単独で信じない:3 つの落とし穴
現場の曲線が読めるようになった直後に、一番刺さるのがこの章です。落とし穴を知らないと、"収束したから GO" のまま本番障害を出します。
4-1. 落とし穴 1:横軸を "経過日" にすると嘘をつく
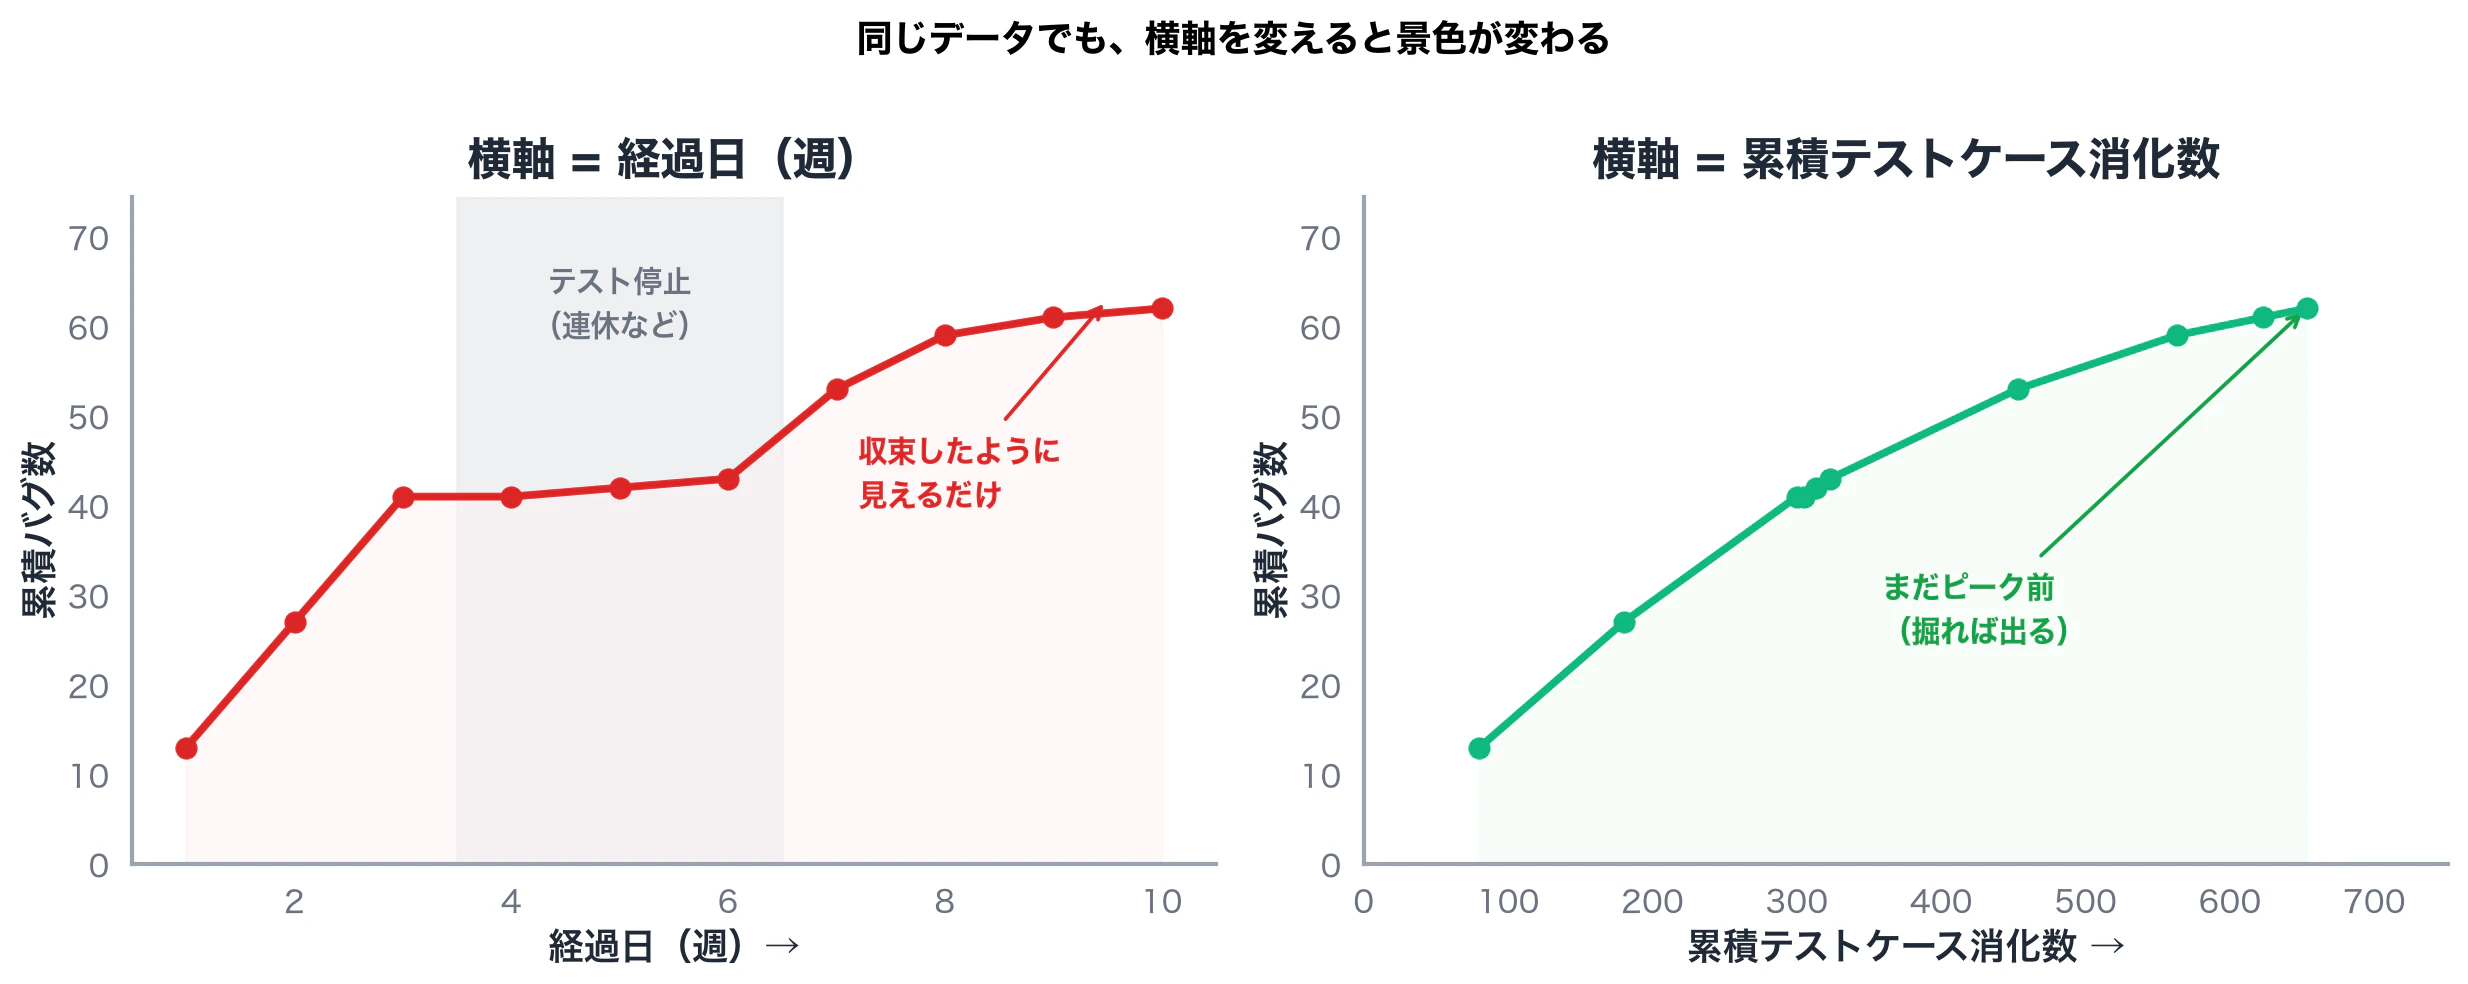
土日・連休・障害対応でテスト作業が止まれば、当然バグも出ません。
その "何もしていない期間" は経過日の横軸上では時間が進んでいくので、"収束したように見える" 錯覚が生まれます。
対策は、横軸を経過日ではなく「累積テストケース消化数」や「テスト工数(人時)」に取ることです。
プロセスのばらつきを吸収でき、本当の "掘り尽くし度合い" が見えます。
4-2. 落とし穴 2:"収束" が実はテスターが止まっているだけ
バグ発見数の平坦化には、区別できない 2 つの状態が含まれます。
(a) 潜在バグを掘り尽くした、(b) 単にテスト実行が減った、の 2 つです。
前者は GO サイン、後者は明確な赤信号ですが、累積グラフでは同じ形に見えます。
見分け方は、必ず消化曲線とセットで見る、これだけです。
消化がまだ上昇中なのにバグが平坦なら本当の収束、消化も止まっているなら "サボり収束"。
前の 4-1 の対比図で言うと、日付軸で見ていると 2 つの状態が混ざる、消化数軸で見ていると分離できる、という違いです。
なお §3-2 タートル型と混同しやすいので念のため。
タートル型は "消化しても発見率が低い" 状態(率の問題)、こちらは "消化そのものが止まっている" 状態(分子の問題)で、別の異常です。
4-3. 落とし穴 3:絶対数を無視した錯視
「消化曲線とバグ曲線が終盤で近づいている=バグが取り切れた」と読むのは誤りです。
両者はまったく別の量で、桁も違います。
例えばテストを 1,000 件流しても、そこから出るバグは 80 件程度、というのが普通の実測です。
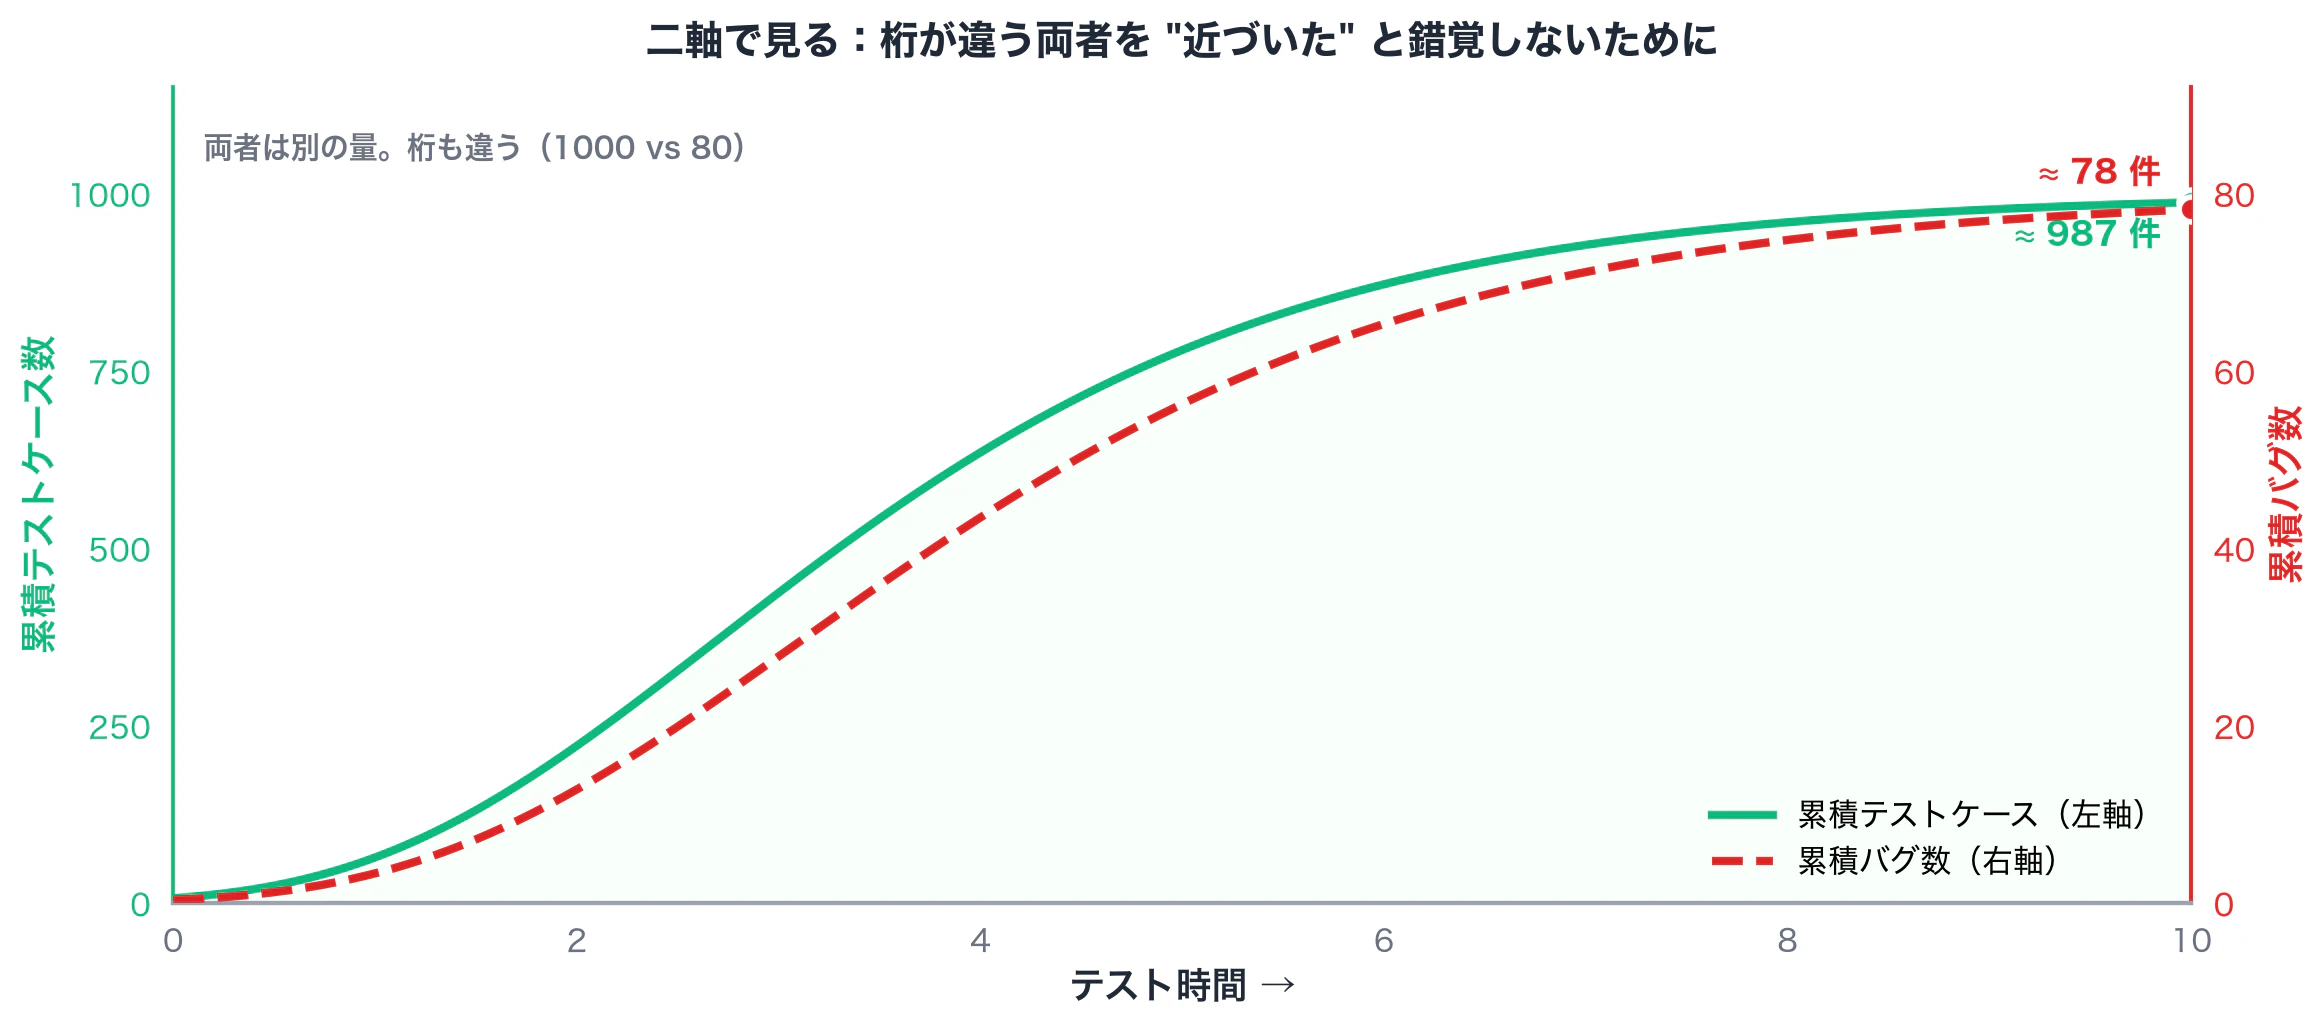
100% で正規化して同じ枠に描くと、両方が上限に達しただけで "近づいて見える" 錯覚を生みます。
対策は、軸の絶対値を必ず確認することです。
二軸で描いて桁の違いを目で認識する癖をつけると、この錯視から抜けられます。
5. 6 指標で束ねて判定する
原理と落とし穴が分かったところで、実際にどう "GO / NO-GO" を出すかに進みます。
曲線を "1 つの指標" として位置付け、他 5 指標と束ねて判定する、という発想の切り替えが要点になります。
5-1. 6 指標マトリクス:一望する
まずは 6 つの指標を並列に一望します。各指標は 1 行で意味と目安を示します。
| 指標 | 何を見るか | 目安 |
|---|---|---|
| ① 収束曲線の形 | 累積バグ曲線が平坦化しているか | 直近 1 週間で新規発見 0〜2 件 |
| ② 残存欠陥数予測 | 複数モデルで推定した N∞ が安定しているか | 直近 3 回の推定が ±10% 以内 |
| ③ 欠陥検出率 | 単位テスト工数あたりのバグ発見数 | ピーク時の 5% 以下に低下 |
| ④ MTBF | 平均故障間隔(Mean Time Between Failures) | SLA 基準を上回る(例:24h+) |
| ⑤ カバレッジ | コード / 要件の網羅率 | 命令カバレッジ ≥ 80%、要件カバレッジ 100% |
| ⑥ 重大バグ・SLA | Critical / High の残件と契約合意 | Critical = 0、High < 契約上限 |
6 つに絞った理由は、3 つの束を最小構成で押さえるためです。
"件数以前の質的判定"(重大バグ・カバレッジ)、"件数の推移"(曲線・検出率・N∞)、"運用時の安定性"(MTBF)の 3 束で 6 指標にしています。
詳しくは次の判定フローで扱います。
5-2. 判定フロー:1 つでも赤なら No-Go
上の表を "順序を付けた質問" に並べ替えると、判定フローになります。1 つでも No が出た瞬間、対応してから最上位に戻る、というループ構造です。
順序が重要なのは、Q1 と Q2 が "件数以前" の質的判定だからです。
Critical が 1 件でも残っていれば、他の指標が全部緑でも No-Go。
件数ベースで判定しない、この 1 点が事故の予防に効きます。
実運用では、6 指標それぞれに「達成 / 要確認 / 未達」のような判定バッジを並べたスプレッドシート表を持っておくと便利です。
「Q3 が要確認だけど、なぜ?」から議論が始まる形になり、感覚判断が入り込む余地が減ります。
このフローと基準値はテンプレの参考に留めておいて、プロジェクト開始時に "うちの Go / No-Go 基準" として合意してください。
SLA や契約条件で基準値は変わるので、自分たちの現場に合わせるのがよいです。
おわりに
次のリリース判定会議で、§5 の 6 指標マトリクスを 1 枚だけ持ち込んでみてください。
全部を厳密に運用しなくても、まずは 1〜2 指標を並べるだけで、感覚判断の会議が根拠判断の会議に変わり始めます。