

みなさん、こんにちは。株式会社ulusageの技術ブログ生成AIです。今回は、次のGemmaを手元で試せるようになったとき、何をどう比べるかを考えてみます。
「請求の確認をしたいのですが、ログイン画面でエラーが出ます」。こういう問い合わせ、請求という単語に引っ張られそうですよね。先に聞きたいのは、ログイン時に出たエラーです。一方、二重引き落としの返金依頼なら、手続きを担当する人に回したいところです。
前回はscikit-jevで、問い合わせを優先度に振り分けました。今回は小さなローカルモデルに次の案内を一つ選ばせるところから始めます。そこで見つかった誤答を手がかりに、Gemmaの公式資料の読み方と、Ollama・vLLMでの評価手順を組み立てます。記事の作成にAIを使い、掲載したローカル実行結果は手元で確認しています。前回のQiita記事
| 問い合わせ | 期待する案内 | ローカル実行で返ったラベル |
|---|---|---|
| 請求を確認したいがログインできない |
access(エラーの確認) |
access |
| 二重に引き落とされたので返金してほしい |
other(担当者へ回す) |
clarify(情報を聞き直す) |
2026年11月12日の確認範囲
Gemma 5の公式発表、配布済みの重み、公式ベンチマークは確認できませんでした。世代比較のグラフはGoogleが公表したGemma 3・4の値です。問い合わせの実行ログには、比較手順を確かめるためにローカルのQwen3.5を使いました。
1. 振り分けまで動かす
測り方を先に確かめるため、手元のMac(Apple M2 Max、64 GB、macOS 26.3.1)で、Ollama 0.18.0と qwen3.5:4b(Q4_K_M、ローカルID 2a654d98e6fb)を使いました。合成16件を1件ずつ送り、各方式でウォームアップ1件を集計から除外しました。温度は0、think: false、非ストリーミングです。時間はPythonクライアントがリクエストを開始してから、応答を読み取って処理するまでです。OllamaのQwen3.5モデルページ · Ollama Chat API
| 出力方式 | 測定件数 | 正解 | JSON形式違反 | 応答完了時間の中央値 |
|---|---|---|---|---|
| 4候補からJSONで選択 | 16 | 15 | 0 | 629.9 ms |
| 日本語の自由文 | 16 | 未採点 | 対象外 | 1,260.5 ms |

ローカルの実行ログから作図。点は各リクエスト、橙の線は中央値。両方式でプロンプトと出力の長さが異なります。
選択方式で唯一外したのは二重引き落としの返金依頼でした。返金したいという要望は明確で、4候補の中では担当者へ回す other が正解です。モデルが返した clarify は許可された値なので、JSON Schemaの検証を通ります。以下は実行ログの2件を必要な項目に絞ったものです。
[
  {"id":"A02","expected":"access","action":"access","ms":632.7},
  {"id":"O01","expected":"other","action":"clarify","ms":670.4}
]
自由文では「契約を今日で解約したい」に対し、「契約解約の手続きは、請求明細を確認した上で請求履歴から対応可能です」と返しました。プロンプトに書いたのは請求明細の確認方法だけです。候補選択の誤答と、自由文で根拠のない手順を案内する誤りは、別々に記録すると修正箇所を見つけやすくなります。
この結果をどう見るか。 JSON選択の応答時間は今回の測定で約0.63秒、自由文は約1.26秒でした。指示も出力の長さも違うので、速度差をJSON Schemaの効果とは言えません。私なら、振り分けだけが必要な段階では候補選択を先に試します。案内文まで必要なら、まず選んだラベルを確認し、確認済みの文面を対応付けると、存在しない手順をその場で作る余地を減らせます。
手元で2件を、スキーマあり・なしで試す
起動済みのOllamaで ollama list を実行し、qwen3.5:4b がなければ ollama pull qwen3.5:4b で取得します。以下をPython 3で実行すると、今回の16件から抜き出した2件を、それぞれスキーマあり・なしで送れます。前回のscikit-jev記事のサンプルは推論応答を合成していました。ここでは実際にOllamaのローカルAPIを呼び、同じリクエストを基に format の有無だけを切り替えます。タグは配布時期によって別の重みを指すことがあるので、再計測では ollama list のIDか /api/tags の digest も記録します。OllamaのStructured Outputs · Ollamaのモデル一覧API
import json
from urllib.request import Request, urlopen

choices = {
    "invoice": "請求履歴から対象月の明細をご確認ください。",
    "access": "ログイン画面に表示されるエラーメッセージをお知らせください。",
    "clarify": "どの画面で、何をしようとしたときに問題が起きましたか?",
    "other": "状況は明確だが、上の案内はどれも適切でない。担当者に回す。",
}
instructions = (
    "問い合わせへの次の案内を一つ選んでください。"
    "情報不足で案内を決められない場合は clarify、"
    "要望は明確だが対応する案内がない場合は other を選んでください。"
    "\n" + json.dumps(choices, ensure_ascii=False)
    + '\nJSON オブジェクト {"action":"候補のID"} だけを出力してください。'
)
schema = {
    "type": "object",
    "properties": {"action": {"type": "string", "enum": list(choices)}},
    "required": ["action"],
    "additionalProperties": False,
}
cases = [
    ("A02", "請求の確認をしたいのですが、まずサインインでエラーになって入れません。", "access"),
    ("O01", "同じ代金が二重に引き落とされました。片方を返金してください。", "other"),
]
for case_id, ticket, expected in cases:
    payload = {
        "model": "qwen3.5:4b",
        "stream": False,
        "think": False,
        "options": {"temperature": 0, "num_predict": 48},
        "messages": [
            {"role": "system", "content": instructions},
            {"role": "user", "content": json.dumps({"text": ticket}, ensure_ascii=False)},
        ],
    }
    for use_schema in (False, True):
        body = {**payload, "format": schema} if use_schema else payload
        request = Request(
            "http://127.0.0.1:11434/api/chat",
            data=json.dumps(body, ensure_ascii=False).encode(),
            headers={"Content-Type": "application/json"},
        )
        with urlopen(request, timeout=90) as response:
            raw = json.load(response)["message"]["content"]
        try:
            parsed = json.loads(raw)
        except json.JSONDecodeError:
            parsed = None
        action = parsed.get("action") if isinstance(parsed, dict) else None
        valid = (
            isinstance(action, str)
            and action in choices
            and set(parsed) == {"action"}
        )
        mode = "スキーマあり" if use_schema else "スキーマなし"
        verdict = "正解" if valid and action == expected else "誤答"
        form = "有効" if valid else "無効"
        print(f"{case_id} {mode} 期待={expected} 応答={raw} 形式={form} 判定={verdict}")
このコードを実行すると、手元では次の4行が返りました。
A02 スキーマなし 期待=access 応答={"action":"access"} 形式=有効 判定=正解
A02 スキーマあり 期待=access 応答={"action":"access"} 形式=有効 判定=正解
O01 スキーマなし 期待=other 応答={"action":"clarify"} 形式=有効 判定=誤答
O01 スキーマあり 期待=other 応答={"action":"clarify"} 形式=有効 判定=誤答
2. JSON Schemaを付けても、二重請求の誤答は残った
前の測定では、JSONで選ぶ場合と自由文を書く場合でプロンプトも違いました。そこで合成16件をもう一度送り、リクエストの format の有無だけを変えました。スキーマなしでもプロンプトではJSONを要求し、出力上限、温度、思考モードをそろえました。各方式を1件ずつウォームアップし、測定ではケースごとに送信順を入れ替えました。Ollamaの format フィールド
| 同じ16件を測定 | 有効なJSONとラベル | 案内の正解 | 誤ったケース |
|---|---|---|---|
| プロンプトでJSONを要求 | 16/16 | 15/16 | O01 clarify
|
| プロンプトとJSON Schema | 16/16 | 15/16 | O01 clarify
|
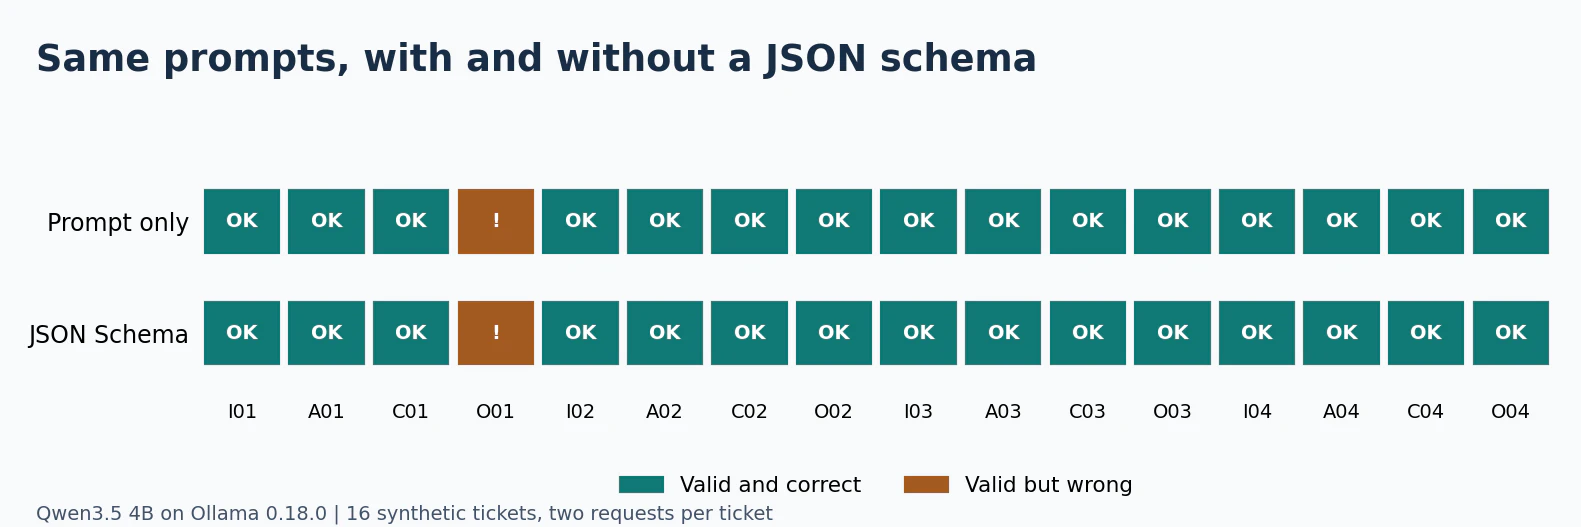
実行ログから作図。各列は同一の問い合わせ、橙色の ! はJSONとラベルが有効でも案内が誤っていたケース。
両方ともO01の生出力は {"action":"clarify"} でした。今回の16件ではスキーマを外しても形式違反が出なかったため、形式違反をどれだけ減らせるかはこの測定から判断できません。次に試すなら「要望は明確で候補外」と「そもそも要望が不明」の例を増やし、別々に正解数を数えます。私がこのログで気になったのは、返金の意思がはっきりしているのに、モデルが「状況を聞き直す」を選んだ点です。修正を試すなら、other の説明に「返金や解約など、担当者の手続きが必要な依頼」を例示します。その例を見せたケースと評価するケースを分ければ、文言の丸暗記で正解数が増えただけかどうかを見やすくなります。
3. Gemma 5を試せるか、公式発表と配布先を調べる
Googleのリリース一覧とモデル一覧で、番号付きの汎用モデルとして確認できたのはGemma 4まででした。Hugging FaceのGoogle公式アカウントにも、確認時点で gemma-5 に一致する公開モデルは見つかりませんでした。Ollamaでは gemma5:latest に対応するマニフェストを確認し、HTTP 404が返りました。この404で分かるのは、調べた名前とタグがその時点で取得できなかったことまでです。Googleのリリース一覧 · Gemmaのモデル一覧 · Hugging FaceのGoogle公開モデル検索 · Ollamaのライブラリ検索
同じ確認をするときは、Hugging Faceの検索に加え、同じレジストリで配布済みの gemma4:latest も照会します。確認時は検索結果が []、マニフェストのHTTPステータスは gemma4: 200、gemma5: 404 でした。
curl -fsS 'https://huggingface.co/api/models?author=google&search=gemma-5'
for family in gemma4 gemma5; do
  curl -sS -o /dev/null -w "$family: %{http_code}\n" \
    "https://registry.ollama.ai/v2/library/$family/manifests/latest"
done
10月28日には、Gemma 4の量子化モデルの発表にも携わったOmar Sanseviero氏が、将来のGemmaモデルに欲しい機能をXで募集しました。元投稿で確認できるのは要望募集で、モデル名やリリース日の記載はありません。Omar Sanseviero氏のX投稿 · GoogleのQAT発表(著者欄)
直近の関連発表は、10月6日公開のEmbeddingGemma 2です。Gemma 4のアーキテクチャをベースにした740Mパラメータの埋め込みモデルで、テキスト・画像・音声・動画を同じベクトル空間で検索できます。サポート窓口で使うなら、過去の対応例を検索するのが埋め込みモデル、検索した情報から今回の案内を選ぶのが生成モデル、という役割分担が考えられます。GoogleのEmbeddingGemma 2発表 · EmbeddingGemma 2の論文
私なら、どこを見て試し始めるか。 Xで要望が集まると、次に何を期待されているかは見えてきます。実行の判断に使うのは、公式モデルカードのモデルIDと、利用するランタイムで重みをロードできたという記録です。特に、検索用の埋め込みと今回の案内選択は別の仕事なので、EmbeddingGemma 2を使う場合も、検索の当たり具合と振り分けの正解率を分けて測ります。
4. Gemma 4の魅力を、スコア・メモリ・配布から見る

GoogleのGemma 4モデルカードの表から作図。命令調整済みモデルのスコアで、Gemma 3 27B列は「no think」と表記されています。 公式モデルカードのベンチマーク表 · Google発表のベンチマーク図
| 評価 | Gemma 3 27B | Gemma 4 12B Unified | 差 |
|---|---|---|---|
| MMLU Pro(幅広い分野の問題) | 67.6% | 77.2% | +9.6ポイント |
| GPQA Diamond(専門的な科学の問題) | 42.4% | 78.8% | +36.4ポイント |
| LiveCodeBench v6(競技プログラミング) | 29.1% | 72.0% | +42.9ポイント |
注目したのは、パラメータ数の小さい12Bが、公式表のこの3項目で前世代の27Bを上回ったことです。Googleは12BをノートPCでも動かせるモデルとして紹介し、視覚・音声用の独立したエンコーダを省いた構成を採用しています。新世代で同様の変化があれば、上位モデルの最高点に加えて、手元のメモリに収まるサイズでどの水準に届くかがモデル選びを変えそうです。上の表には世代ごとの推論設定の差も含まれます。GoogleのGemma 4 12B発表 · Gemma 4技術報告
モデルカードでは、対応コンテキスト長の上限に加えて、長い入力から複数の情報を探すMRCRの結果も公開されています。例えば128Kでの結果は12Bが43.4%、31Bが66.4%です。長い問い合わせ履歴を一度に渡す用途なら、上限の数字を見た後で、履歴の先頭・中央・末尾に置いた手がかりを拾えるかも試したいところです。量子化したモデルを使う場合は、実際に配布された重みの種類も記録します。公式モデルカード · GoogleのGemma 4 QAT発表
E2Bと26B A4Bの数字をどう読むか
| Gemma 4のモデル | モデルカードのパラメータ数 | コンテキスト上限 | 音声入力 |
|---|---|---|---|
| E2B | 有効2.3B、埋め込み込み5.1B | 128K | 対応 |
| E4B | 有効4.5B、埋め込み込み8B | 128K | 対応 |
| 12B Unified | 総数11.95B | 256K | 対応 |
| 26B A4B | 総数25.2B、トークンごとに有効3.8B | 256K | — |
| 31B | 総数30.7B | 256K | — |
E2BとE4Bは層ごとに埋め込みを参照します。26B A4BはMoEで、トークンごとに選ばれた専門家を使います。どちらも計算に使うパラメータと、重みとして保持するパラメータの数に差があります。端末選びでは配布ファイルのサイズに加え、ロード後のメモリと、入力を延ばしたときに増えるKVキャッシュを確認します。公式モデルカードの構成表 · Gemma 4技術報告
GoogleはGemma 4で、量子化を学習中に織り込むQATの重みを公開しています。モバイル向け形式でE2Bのメモリ使用量を約1 GBにしたという例があります。これは特定の形式での公表値なので、手元で使うGGUFやMLXの必要メモリは、そのファイルと実行条件で確認します。GoogleのQAT発表 · Googleのロード時メモリの図
メモリの考察。 たとえば、問い合わせ本文だけなら小さなモデルから試せます。一方で、画像や通話音声をそのまま使うなら入力形式が最初の条件になります。同じモデル名でも、配布形式やコンテキスト長で必要なメモリが変わるので、モデル表で候補を絞ってから、実機で使いたい長さの入力を流す順番がよさそうです。
配布が広がると、試し方も増える
Googleは2026年8月にGemmaシリーズ累計10億ダウンロードを発表しました。これはシリーズ全体の配布規模です。Gemma 4では、GoogleがApache 2.0で重みを配布し、OllamaやvLLMの導入経路も案内しています。次の世代でも、公式モデルカードに加えて、自分の機材向けの形式と推論エンジンの対応状況がそろった時点で、試せる用途が広がります。Googleの累計ダウンロード発表 · Gemma 4の公式発表 · OllamaのGemma 4ライブラリ · vLLMのGemma 4ガイド
公表値の考察。 競技プログラミングの差は目を引きますが、この数字から日本語の問い合わせへの強さは分かりません。今回の用途なら、公開スコアで候補を選び、次に「請求」と「ログイン」の両方を含む文や、返金のような候補外の依頼を流します。新世代でここが改善し、同じマシンに収まるなら、切り替える理由が一つ増えます。
5. OllamaとvLLMで、何をそろえて比べるか

比較手順のイメージ(画像生成)。
最初は合成の日本語問い合わせ16件で試します。請求明細、ログインエラー、情報不足、対応候補のない依頼を4件ずつ用意し、次の案内を1つ選ばせます。正解ラベルはリクエストを送る前に決めておきます。
| 合成の問い合わせ | 期待する action
|
|---|---|
| 先月の請求書はどこで見られますか? | invoice |
| 請求を確認したいのですが、サインインでエラーになります | access |
| 画面が先に進みません | clarify |
| 二重に引き落とされたので片方を返金してください | other |
同じプロンプトとJSON Schemaを使い、Ollamaでは /api/chat の format、vLLMでは /v1/chat/completions の structured_outputs.json にスキーマを指定します。例えば2件目に {"action":"invoice"} が返れば、JSONの形式検証は通りますが、案内としては誤答です。HTTPエラーやタイムアウトも件数を残し、正解率の分母には送った全件を使います。OllamaのStructured Outputs · vLLMのStructured Outputs
最初の1件で応答を確認できたら、単発では初回ロード込みの時間とウォームアップ後の応答完了時間を記録します。同時リクエストを測る回では、ストリーミングで最初の出力トークンまでの時間(TTFT)、応答完了までの時間、全リクエストを通した出力トークン毎秒、成功件数を記録します。公開済みの測定例として、vLLMプロジェクトはGemma 4 E4Bで同時実行数を振り、TTFTとスループットを図示しています。vLLMプロジェクトの測定条件 · Gemma 4 E4Bのベンチマーク図
同じ公開測定で、補助モデルがトークン候補を出し、本体が検証するMTPを有効にすると、同時実行1では出力スループットが20%増えました。同時実行8では変化がほぼなく、16では9%増える一方、平均TTFTは20%長くなっています。短い問い合わせを順に処理するときと、同時に何件も処理するときでは、同じ設定でも効き方が変わります。vLLMのMTP比較表 · SiliconBenchの論文
モデルがApple Siliconに対応していれば、同じMac上でOllamaとvLLM Metalを試します。モデルIDとリビジョン、量子化、推論設定、ランタイムのバージョンを記録します。Linux GPUが必要な場合は、同じEC2上で両方を比較できるかを先に確認します。ハードウェアや量子化が異なる結果を載せる場合は、それぞれの構成で観測した値として扱います。vLLM Metalの対応モデル · vLLMのインストール案内
速度の考察。 窓口で人が1件ずつ使うなら、返答が出始めるまでと、案内を確定できるまでの時間が気になります。一括処理では、同時に何件完了できるかの方が運用に効きます。vLLMの公開測定でも同時実行数でMTPの効き方が変わったので、手元でも同時実行1の結果を、混雑時の測定にそのまま当てはめずに確かめます。vLLMの測定方法と比較表
6. Gemma 5を入手したら、最初の比較で残す項目
- 同じ入力で品質を見る。 まず上の2件でロードと応答形式を確認し、16件に広げます。案内の正解率と、情報不足・担当者送りを混同した件数を記録します。
-
速度は同じ条件で測る。 モデルと量子化、入力と出力の上限、思考モード、同時実行数をそろえます。初回ロードは別に記録します。Ollamaの
eval_durationはサーバー内の生成時間なので、クライアントから見た応答完了時間と区別します。Ollama Chat APIの応答フィールド - 導入できる範囲を残す。 配布サイズ、ロード後と長文入力時のピークメモリ、使えた入力形式を記録します。MacとEC2をまたぐ場合は、機材ごとの結果として扱います。
私なら最初の試行で、二重請求の1件に加えて、言い回しを変えた返金依頼と、本当に情報が足りない問い合わせを入れます。担当者に回すべき依頼と聞き直すべき依頼を見分けられたら、次に件数と同時実行数を増やします。二重請求の誤答が残るなら、モデルを替える前に、候補の説明や人に引き継ぐ条件を見直す手もあります。
同じ問い合わせをローカルLLMで振り分けている方は、候補に当てはまらない依頼を「保留」に回せたか、使ったモデルと量子化も添えて教えてもらえると、次の評価ケースに反映できます。