
NILIM2.0 を Docker + gfortranで再構成する続き:Step 5 Weir / Orifice / Gate / Pump / CulvertをNode / Reach河道網へ追加する
はじめに
前回のStep 4では、NILIM2.0の河道計算をNode / Reachで扱えるように整理し、合流・分岐、独立Node水位、水位依存貯留、局所損失、循環河道網、時間ステップ内のPicard反復まで拡張しました。
Step 5では、その河道網へ水理構造物を追加します。
今回追加したのは次の5種類です。
- Weir:堰
- Orifice:オリフィス
- Gate:ゲート
- Pump:ポンプ
- Culvert:カルバート
河道計算を書き換えて構造物を埋め込むのではなく、Step 4 r010までの計算経路は残し、2つのNode間で流量を受け渡す独立した水理構造物レイヤーとして追加しました。

Step 5 r001ではgraph formatをv7へ上げ、構造物流量をNode収支とPicard反復の両方へ組み込んでいます。
Step 5でやりたかったこと
実際の河道や排水路を考えると、Node / Reachだけでは足りません。
例えば、次のような施設があります。
上流水路
   │
   ├── 堰
   ├── 水門
   ├── オリフィス
   ├── ポンプ
   └── カルバート
   │
下流水路
さらに、今後雨水調整池を扱う場合にも、流入口や放流口として同じ構造物が必要になります。
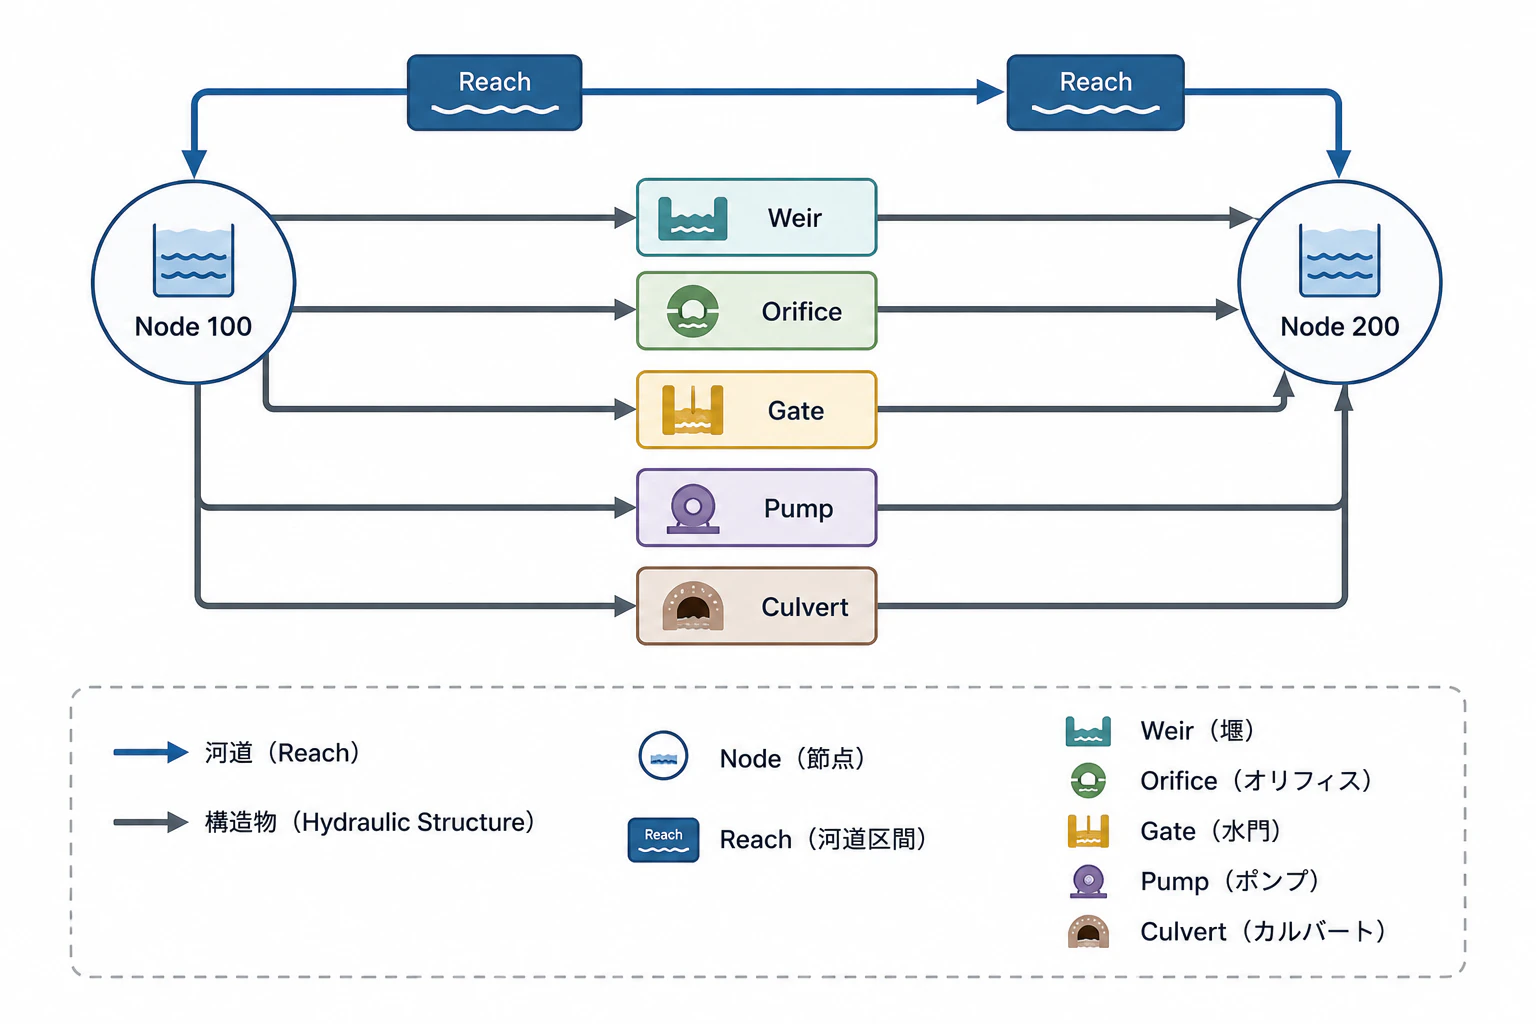
そこでStep 5では、構造物をReachの内部へ直接埋め込まず、Node間接続として扱うことにしました。
Reach A
   │
 Node 100
   │
 [Structure]
   │
 Node 200
   │
Reach B
Reach途中に構造物がある場合は、そこでReachを分割してNodeを追加します。
この形にしておくと、河道計算と構造物計算の責務を分けられます。既存のReach計算を壊さずに構造物を増やせることも、この構成を選んだ理由です。
Step 4 r010の計算経路は残す
今回も、既存コードを一気に書き換える方法は取りませんでした。
Step 5用に次のファイルを分けています。
source/
├── NILIM20_step5_r001_real4_linux.for
├── river_network_topology_step5_linux.for
├── river_network_solver_step5.for
├── river_network_structures.for
└── common20.inc
NILIM20_step5_r001_real4_linux.forはStep 4 r010のmonolithic本体とbyte-identicalです。
また、graph-v1~v6の数値ルーチンも決定しています。

新しい機能を追加した結果、以前のケースの数値結果が変わってしまうと、どこで差が入ったのか分からなくなります。
そのためStep 5では、新機能のテストと既存経路の回帰比較を同時に行うようにしています。
graph format v7
Step 4 r010のgraph-v6に、水理構造物を追加したのがgraph-v7です。
先頭は次の形式です。
7
NNODE NREACH NSTRUCT
max_iterations stage_tolerance_m flow_tolerance_m3s relaxation
Node、Node貯留曲線、Reachの後に、NSTRUCT件の構造物を並べます。
構造物レコードは次の16項目です。
id type up_node dn_node
crest_or_invert width height coefficient opening_fraction
diameter length manning_n loss_k capacity on_stage off_stage
実際にはriver_network_graph.datを手作業で編集せず、CSVから生成します。
nodes_v7.csv
node_storage_curves.csv
reaches_v7.csv
loop_solver.csv
structures.csv
        │
        ▼
build_river_network_graph_v7.py
        │
        ▼
river_network_graph.dat
生成コマンドは次です。
./scripts/prepare_river_network_v7.sh \
  tests/regression/hydraulic_structures/case16_all_structures
structures.csv
構造物入力はstructures.csvへまとめました。
structure_id,structure_type,upstream_node_id,downstream_node_id,crest_or_invert_m,width_m,height_m,coefficient,opening_fraction,diameter_m,length_m,manning_n,loss_k,capacity_m3s,on_stage_m,off_stage_m
101,WEIR,100,200,30.90,0.05,0,1.5,0,0,0,0,0,0,0,0
102,ORIFICE,100,200,30.70,0.02,0.02,0.62,0,0,0,0,0,0,0,0
103,GATE,100,200,30.70,0.02,0.04,0.62,0.50,0,0,0,0,0,0,0
104,PUMP,100,200,0,0,0,0,0,0,0,0,0,0.001,30.95,30.75
105,CULVERT,100,200,30.70,0,0,0,0,0.03,10.0,0.013,1.0,0,0,0
型コードは次のように固定しています。
| code | type |
|---|---|
| 1 | WEIR |
| 2 | ORIFICE |
| 3 | GATE |
| 4 | PUMP |
| 5 | CULVERT |
Python側では、CSVを読み込むだけでなく、Fortran実行前に入力値を検査します。
例えば次のような入力は生成段階で止めます。
- 存在しないNodeを参照している
-
structure_idが重複している - Weirの幅が0以下
- Orifice / Gateの流量係数が
0 < Cd <= 1を外れている - Gate開度が0~1を外れている
- Pump容量が0以下
- Pumpの
on_stage <= off_stage - Culvertの径、延長、Manning粗度が0以下
Fortranを起動してから入力ミスで落ちるより、CSV生成時点で原因が分かるようにしています。
構造物流量の符号
構造物流量の正方向は、すべて共通で次のようにしました。
upstream_node_id → downstream_node_id
正のQstructureなら、Node収支では、
upstream Node    -Qstructure
downstream Node  +Qstructure
とします。

受動構造物で逆流した場合はQstructureそのものが負になります。
そのため逆流専用の収支式を別に持たなくても、同じ-Q / +Qの処理で水量を保存できます。
Step 5 r001では構造物自身に貯留量を持たせていません。貯留は接続Node側で管理します。
5種類の水理構造物
Weir
Weirは広頂堰型の関係式を使います。
自由越流では、
Q = C B h^(3/2)
です。
-
C:越流係数 -
B:越流幅 -
h:高水位側の堰頂上水深
両側水位が堰頂を超えている場合は、下流水位による潜り越流低減を入れています。
また、高水位側が反転すれば流量符号も反転します。
通常
Node A  ──→ Weir ──→ Node B

逆水位差
Node A  ←── Weir ←── Node B
テストでは、自由越流、潜り越流、逆流をそれぞれ確認しています。
Orifice
Orificeは矩形開口として扱います。
単純な、
Q = Cd A sqrt(2gΔH)
だけではなく、開口が部分的に水没している場合も扱えるよう、開口高さ方向に静水圧水頭を積分しています。
上流水面
~~~~~~~~~~~~
    │
    │  開口
    │ ┌────┐
    │ │    │
────┴─┴────┴── 開口底

下流水位によって
・両側水没部分
・下流側が大気開放の部分
を分けて積分
これによって、開口の一部だけが水没しているケースでも、底部水頭を開口全体へ掛ける近似にしないようにしています。
逆水位差では逆流します。
Gate
Gateの基本式はOrificeと同じです。
違いは、開口高にopening_fractionを掛ける点です。
effective opening height
    = height_m × opening_fraction
例えば、
opening_fraction = 0.0  → 全閉
opening_fraction = 0.5  → 半開
opening_fraction = 1.0  → 全開
です。
Step 5 r001では、解析中に開度を変更する制御はまだ入れていません。1回の計算中は固定開度です。
水位や時刻に応じたゲート操作は、今後の拡張項目にしています。
Pump
Pumpは、まず固定容量モデルから入れました。
ON時は、
Q = capacity_m3s
OFF時は、
Q = 0
です。
制御にはON/OFF水位のヒステリシスを持たせています。
OFF → ON
upstream stage >= on_stage

ON → OFF
upstream stage <= off_stage
例えば、
on_stage  = 30.95 m
off_stage = 30.75 m
なら、30.75~30.95mの間では直前の状態を保持します。

さらに、Pump状態は水理サブステップの開始時に決め、そのサブステップ内のPicard反復中は固定します。
反復途中のわずかな水位差でON/OFFが交互に切り替わるのを避けるためです。
現時点ではQ-Hポンプ曲線や複数台制御は入れていません。
Culvert
Culvertは円形断面を対象にしています。
高水位側の水深から、
A : 濡れ断面積
P : 潤辺
R = A / P : 径深
を計算し、Manning摩擦と局所損失を合わせます。
関係式は次の形です。
ΔH = Q|Q| [ n²L/(A²R^(4/3)) + K/(2gA²) ]
-
n:Manning粗度 -
L:延長 -
K:入口・出口などをまとめた局所損失係数
水深が管径未満なら円弧断面として濡れ面積と潤辺を求め、満管相当なら円形断面全体を使います。
Culvertも受動構造物なので、逆水位差では逆流します。
ただし、これは集中型のエネルギー損失モデルです。長大管路をSaint-Venant方程式で解く管路ソルバではありません。
Picard反復へ構造物流量を組み込む
Step 4 r010では、循環河道網でNode水位とReach端点流量を時間ステップ内で反復していました。
Step 5では、その反復へ構造物流量も追加しました。
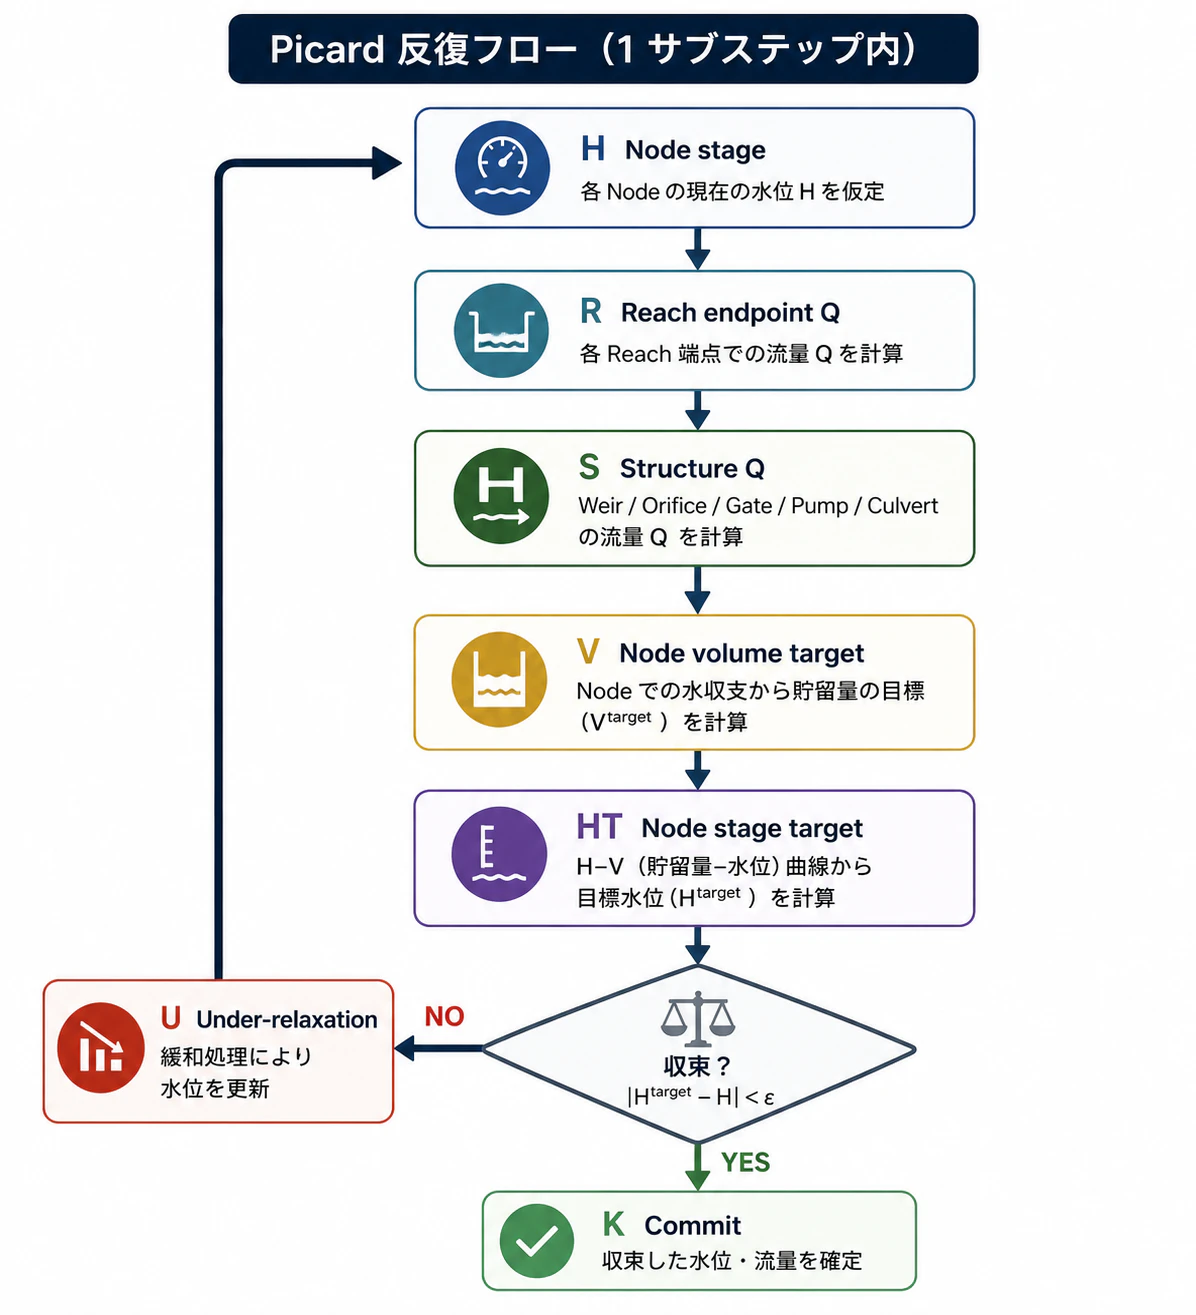
Nodeの目標体積は、
Vnew = Vbase + Qnet × dt
で求めます。
ここでQnetには、
- Reachからの流入・流出
- Weir / Orifice / Gate / Pump / Culvertの流量
を含めます。
収束判定は、
max |ΔH| <= stage_tolerance_m
max |ΔQ| <= flow_tolerance_m3s
です。
ΔQにはReach端点流量だけでなく、構造物流量の変化も含めます。
最大反復回数までに収束しない場合は、未収束値をそのまま採用せず、
STOP 83
で停止します。
one-passも残す
max_iterations=1の場合は、内部反復を行わないone-pass経路になります。
現在Node水位
   ↓
Reach Q + Structure Q
   ↓
Node体積更新
   ↓
Node水位更新
互換性確認や簡易ケースには使えますが、非線形構造物とNode水位を内部反復で整合させない点はPicard経路と異なります。
出力ファイル
構造物専用の診断出力として、
river_hydraulic_structures.dat
を追加しました。
列は次の通りです。
time_s
structure_id
type
up_node
dn_node
pump_state
up_stage_m
dn_stage_m
q_up_to_dn_m3s
これを見ると、各出力時刻について、
- 上下流Node水位
- 流量の向き
- PumpのON/OFF
- 構造物別流量
を確認できます。
計算結果そのものへ使うファイルではなく、回帰試験や水理状態の確認用です。
Python側の入力生成
Step 5の入力生成は、
tools/build_river_network_graph_v7.py
で行います。
主な流れは次の通りです。

Python側にはmodule / class / function単位でdocstringを付けています。
また、Step 5の静的検査にASTによるdocstringチェックを追加しました。今後Pythonファイルを追加してdocstringを書き忘れた場合は、配布前検証で検出されます。
Python files: 39
module docstring missing: 0
class docstring missing: 0
function / method docstring missing: 0
Fortran側も、Step 5で追加したgraph-v7と水理構造物コードを中心に、流量符号、単位、Node収支、Pump状態の固定タイミング、反復収束の意図が追えるようコメントを補っています。
Step 4 r010までの固定数値ルーチンにはコメント目的でも手を入れていません。
テストケース
Step 5では、3つのgraph-v7ケースを用意しました。
tests/regression/hydraulic_structures/
├── case16_all_structures/
│   └── 5種類すべて + Picard反復
├── case17_v7_no_structures/
│   └── NSTRUCT=0 互換確認
└── case18_v7_onepass/
    └── max_iterations=1
case16_all_structuresでは、2 Node / 4 Reachの河道網に5種類すべてを配置しています。
水理式はFortran本体を直接テストする
構造物流量のテストでは、Pythonに同じ式を書いただけで「一致した」とはしていません。
source/river_network_structures.forと小さなFortran driverを実際にgfortranでコンパイルし、RN_STRUCTURE_FLOW_VALUESを直接呼び出します。
確認している内容は次の通りです。
WEIR
  自由越流
  潜り越流
  逆流

ORIFICE
  自由流出
  潜り状態
  逆流

GATE
  開状態
  全閉

PUMP
  OFF
  ON
  deadband保持
  OFFへの復帰

CULVERT
  正流
  逆流

Node収支
  upstream -Q
  downstream +Q
この方法なら、テストコードのPython式だけが正しくてFortran実装が違っていた、という状態を避けられます。
Step 5専用検証
配布判定用のスクリプトは、
./scripts/run_step5_hydraulic_structures_validation.sh
です。
14段階で確認します。
1.  Step5 static source checks
2.  input / formula unit tests
3.  5構造物graph-v7再生成
4.  0構造物graph-v7再生成
5.  one-pass graph-v7再生成
6.  r010 / Step5 build
7.  r010 graph-v6基準実行
8.  Step5 graph-v6互換比較
9.  graph-v7 NSTRUCT=0互換比較
10. 5構造物graph-v7実行
11. runtime invariant検証
12. 構造物による水理解の変化確認
13. one-pass実行
14. 意図的未収束でSTOP 83確認
今回の検証結果は次の通りです。
STEP5 STATIC CHECK: PASS
HYDRAULIC STRUCTURE INPUT TEST: PASS
HYDRAULIC STRUCTURE FORMULA TEST: PASS
STEP 5 R001 HYDRAULIC STRUCTURES VALIDATION: PASS
5種類を同時に入れた60分ケースでは、
structure output rows   300
                        = 5 structures × 60 output times

Node continuity error   max 0.000e+00 m3/s

Picard substeps         3600 / 3600 converged
maximum iterations      10
となりました。
one-passケースは、
Node continuity residual max = 1.219e-04 m3/s
でした。
また、意図的に収束条件を厳しくして反復回数を2回へ制限したケースでは、
status = 83
STOP 83
になることを確認しています。
Step 4 r010との互換性
新しい構造物が動いても、既存計算が変わっていたら困ります。
そこでStep 5では、Step 4 r010のgraph-v6ケースを両方のバイナリで実行し、出力を比較しています。
Step4 r010 graph-v6
        │
        ├── 実行
        │
        ▼
   reference results

Step5 r001 graph-v6
        │
        ├── 実行
        │
        ▼
   Step5 results
        │
        ▼
     byte比較
次を含む対象ファイルがbyte-identicalでした。
CRSS.DOC
qh_kan.dat
qh_man.dat
river_network_summary.dat
river_node_balance.dat
river_node_continuity.dat
river_node_state.dat
river_node_local_loss.dat
river_node_loop_solver.dat
さらにgraph-v7で、
NSTRUCT = 0
とした場合も、graph-v6と水理出力が一致することを確認しています。
つまり、graph-v7を追加しただけで構造物を使わなければ、従来の水理計算へ影響を与えない構成です。
ビルド
ローカルでStep 5をビルドする場合は、
chmod +x scripts/*.sh
./scripts/build_step5_linux.sh
です。
生成物は、
bin/nilim20_step5_r001
です。
今回のローカルStep 5専用検証は、
GNU Fortran (Debian 14.2.0-19) 14.2.0
で実行しています。
Docker Compose
Docker側はUbuntu 24.04を基準にしています。
初版では、WORKDIR /workspaceで作られた/workspace自体がroot所有のまま残り、非rootユーザーからbin/を作れない問題がありました。
mkdir: cannot create directory ‘bin’: Permission denied
COPY --chownだけではWORKDIRで先に作られたディレクトリ本体の所有権までは変わらないため、fix001では/workspaceの所有権を実行ユーザーへ移しています。あわせて、環境チェックでは既存ディレクトリへの書き込みだけでなく、/workspace直下に新しいディレクトリを作成できるところまで確認するようにしました。
通常の確認は次の順で行います。
./scripts/docker_build.sh
./scripts/docker_test.sh
./scripts/docker_fast.sh
Step 5の水理構造物だけを検証する場合は、次を実行します。
./scripts/docker_compose.sh \
  --profile test \
  run --rm step5
プロジェクト全体の回帰まで含める場合は、最後に次を実行します。
./scripts/docker_full_validation.sh
Ubuntu 24.04実機でStep 5を確認
fix001は、Ubuntu 24.04の実機環境でもDocker Composeから実行しました。コンテナ内のコンパイラは次のバージョンです。
GNU Fortran (Ubuntu 13.3.0-6ubuntu2~24.04.1) 13.3.0
実行したコマンドは次です。
./scripts/docker_compose.sh \
  --profile test \
  run --rm step5
14段階の検証は最後までエラーなく完了しました。
[1/14]  Step5 static source checks                         PASS
[2/14]  Step5 input/formula unit tests                    PASS
[3/14]  regenerate all-structure graph-v7                 PASS
[4/14]  regenerate zero-structure graph-v7                PASS
[5/14]  regenerate graph-v7 one-pass structure case       PASS
[6/14]  build frozen-compatible r010 and Step5             PASS
[7/14]  r010 graph-v6 reference                           PASS
[8/14]  Step5 graph-v6 compatibility                      PASS
[9/14]  graph-v7 zero-structure hydraulic equivalence     PASS
[10/14] run graph-v7 with all five structure types        PASS
[11/14] hydraulic-structure runtime invariants             PASS
[12/14] verify structures change hydraulic solution       PASS
[13/14] graph-v7 one-pass structure runtime               PASS
[14/14] graph-v7 non-convergence fail-fast                PASS

STEP 5 R001 HYDRAULIC STRUCTURES VALIDATION: PASS
既存のgraph-v6については、Step 4 r010とStep 5 r001の主要出力がbyte-identicalになりました。さらにgraph-v7でNSTRUCT=0とした場合も、graph-v6との水理結果が一致しています。
R010 GRAPH-V6 -> STEP5 R001 GRAPH-V6 COMPATIBILITY: PASS
STEP5 GRAPH-V6 -> GRAPH-V7 ZERO-STRUCTURE HYDRAULIC REGRESSION: PASS
GRAPH-V7 ZERO-STRUCTURE COMPATIBILITY: PASS
5種類の水理構造物を同時に入れたケースでは、5構造物×60出力時刻で300行の構造物診断値が出力されました。Picard反復を使った計算では3600サブステップすべてが収束し、Nodeの連続式残差も0になっています。
structure output rows       300
Node continuity residual    0.000e+00 m3/s
Picard hydraulic substeps   3600 / 3600 converged
maximum iterations          10
構造物を入れないケースとの比較では、Node水位にも実際に差が出ています。
Node 100: final-stage difference = -0.000116350 m
Node 200: final-stage difference = +0.000122070 m

STEP5 HYDRAULIC STRUCTURE RESPONSE EFFECT: PASS
max_iterations=1のone-pass経路も完走しています。このケースでは内部反復を行わないため、連続式残差はPicardケースより大きくなりますが、想定した経路として正常に終了しました。
Node continuity residual max = 1.219e-04 m3/s
また、意図的に収束しない条件を与えたケースでは、未収束のまま計算を続けず、STOP 83で停止することも確認しました。
status = 83
STOP 83
これで、Step 5については静的検査やローカル実行だけでなく、Ubuntu 24.04上のDocker Compose環境でもWeir / Orifice / Gate / Pump / Culvertを含む14段階検証が最後までPASSしたことを確認できました。
現時点で入れていないもの
Step 5 r001では、まず5種類をNode収支へ安全につなぐところまでに絞っています。
未実装なのは次の部分です。
Gate
  ・時系列開度
  ・水位連動操作
  ・自動制御

Pump
  ・Q-H曲線
  ・下流水位による揚程変化
  ・複数台の台数制御
  ・停止遅延

Culvert
  ・非円形断面
  ・長大管路のSaint-Venant計算
この範囲を最初から全部入れるより、固定条件の構造物で水収支と反復計算を確認してから広げた方が原因を追いやすいと考えています。
次は雨水調整池へつなげる
次に追加したいのは雨水調整池です。
Step 5でWeir / Orifice / Gate / Pump / Culvertを独立したNode間構造物にしたので、調整池は次のように組み立てられます。
調整池側に、
H-A曲線
H-V曲線
初期水位
上限水位
を持たせれば、Step 4で追加した水位依存Node貯留と今回の水理構造物をそのまま利用できます。
その後、1D河道と2D氾濫原の水交換を整理すれば、調整池設置前後の浸水低減効果まで同じモデルで比較できる形に近づきます。
まとめ
Step 5 r001では、Step 4 r010までのNode / Reach河道網を残したまま、graph-v7として次の5種類を追加しました。
Weir
Orifice
Gate
Pump
Culvert
今回特に重視したのは、構造物の種類を増やすことよりも、
構造物流量
   ↓
Node収支
   ↓
Node水位
   ↓
Reach流量
   ↓
Picard反復
という計算経路へ無理なく組み込むことでした。
既存graph-v1~v6は固定し、graph-v6とのbyte regression、NSTRUCT=0での互換比較、Node水収支、逆流、Pumpヒステリシス、収束・未収束までテストしています。
次の段階では、このStep 5を土台にして雨水調整池のH-A / H-Vモデルを追加していきます。
参考のために、ZIPファイルを置いておきますので、ダウンロードして活用してください。
参考資料
- 前回の記事:NILIM2.0をgfortranで再構成し、Node / Reach型の河道網へ広げる
- 国土技術政策総合研究所 水害研究室 - NILIM2.0 ダウンロードページ
- NILIM2.0 マニュアル(PDF)
- 国総研資料 第202号「都市域氾濫解析モデル活用ガイドライン(案)-都市浸水-」
- Docker Engine - Ubuntuへのインストール
- Docker Compose