
Fortran 2018でGPUを使う ― DO CONCURRENTとOpenACCで2次元差分計算を高速化する【Part 1】
はじめに
Fortranで数値計算を行っていると、計算時間をもう少し短くできないかと考えることがあります。格子数を増やしたり、計算期間を長くしたり、複数の条件を比較したりすると、同じ処理を何度も実行することになるためです。
これまでFortranの高速化として、SIMDによるベクトル化、OpenMPによる共有メモリ並列化、MPIによる分散メモリ並列化などを取り上げてきました。今回はその続きとして、Fortran 2018のコードをNVIDIA GPUで動かす方法を試します。
題材は2次元の拡散方程式です。河川・洪水氾濫解析そのものではありませんが、格子ごとに周囲の値を読み取って新しい値を計算するという点では、数値シミュレーションの基本的な計算パターンを含んでいます。
いきなり大きな計算プログラムをGPUへ移すのではなく、まず小さな計算でCPU版とGPU版の結果を照合し、計算時間を測れるところまで進めます。
今回扱うのは、次の2方式です。
-
DO CONCURRENT:標準Fortranの構文を使い、対応するコンパイラでGPU実行します。 - OpenACC:指示文を追加し、GPUで処理する範囲とデータ転送を指定します。
DO CONCURRENTはFortran 2008で導入された機能で、Fortran 2018でも使用できます。ただし、Fortran 2018だから自動的にGPUが使われるわけではありません。GPU実行に対応するコンパイラとオプションが必要です。
本記事の検証状況(2026年10月10日)
付属のr001サンプルについて、gfortranでのCPUコンパイルと実行、2方式の計算結果の比較を確認しています。nvfortranによるGPUコンパイル、GPU実行、GPU性能測定は未実施です。以下のGPUコマンドは、実機で検証するための手順として示します。GPUが何倍高速だったといった未測定の数値は掲載しません。
1. FortranでGPUを利用する方法
FortranからGPUを使うためには、いくつかの選択肢があります。
| 方法 | コードの書き方 | 主な特徴 | 最初の学習難易度 |
|---|---|---|---|
DO CONCURRENT |
標準Fortranの並列反復構文 | 既存ループの独立性を明示できます | 低 |
| OpenACC |
!$acc指示文 |
ループのGPU化とデータ領域を明示できます | 低〜中 |
| OpenMP Target |
!$omp targetなど |
OpenMPのGPUオフロードを利用します | 中 |
| CUDA Fortran | CUDA Fortran拡張 | GPUのメモリや実行方式を細かく制御できます | 高 |
この表の「難易度」は学習の入りやすさの目安です。どの方法が最速になるかは、計算内容、配列の扱い、GPU、コンパイラによって異なります。
最初に試すなら、標準構文のDO CONCURRENTが分かりやすい方法です。一方、時間ステップを数百回、数千回と繰り返す数値計算では、CPUとGPUの間で何度もデータを転送しないようにする必要があります。この点はOpenACCで確認しやすいため、今回は両方を実装します。
1.1 CPUとGPUはどのように役割を分けるのか
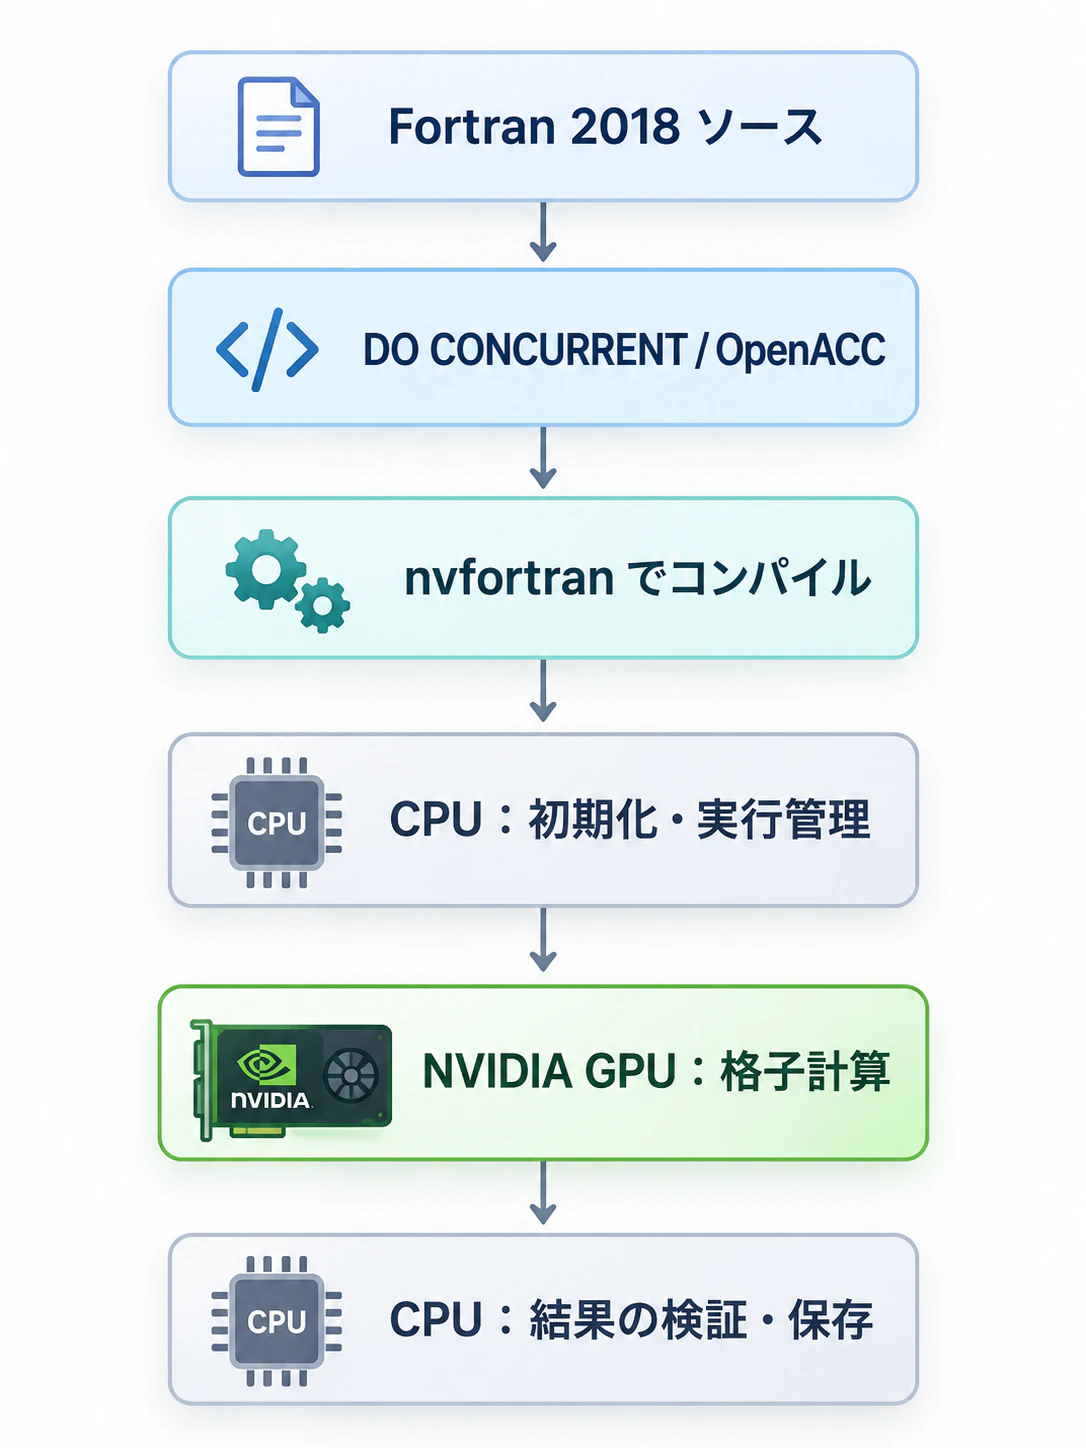
一般に、プログラム全体がGPU上で動くわけではありません。入力データの読み込み、実行条件の管理、出力ファイルの保存などはCPU側に残し、反復計算の多い部分をGPUに担当させます。
もう一つ重要なのが、データの置き場所です。

計算自体が速くても、毎ステップで巨大な配列を往復させてしまうと、データ転送が高速化の妨げになります。GPUへのオフロードと、GPU上へのデータ保持は分けて考えることが大切です。
1.2 Fortran 2018への対応について
nvfortranはDO CONCURRENTのGPU実行、OpenACC、OpenMP、CUDA Fortranをサポートしています。ただし、NVIDIA HPC SDKがFortran 2018の全機能への完全準拠を保証しているという意味ではありません。公式資料でも、言語機能の対応状況はコンパイラごとに案内されています。既存のFortran 2018ソースを移植する際は、使っている言語機能を個別に確認してください。
2. 今回の計算モデル:2次元拡散方程式
今回の例では、次の2次元拡散方程式を扱います。
\frac{\partial u}{\partial t}
= D\left(\frac{\partial^2u}{\partial x^2}+\frac{\partial^2u}{\partial y^2}\right)
ここで、$u$は格子上の値、$D$は拡散係数です。時間方向に前進差分、空間方向に中心差分を用いると、格子幅が$x$方向・$y$方向で等しい場合は次の形になります。
u_{i,j}^{n+1}=u_{i,j}^{n}
+\alpha\left(
 u_{i-1,j}^{n}+u_{i+1,j}^{n}
+u_{i,j-1}^{n}+u_{i,j+1}^{n}-4u_{i,j}^{n}
\right)
\alpha=\frac{D\Delta t}{\Delta x^2}
今回のサンプルでは$\alpha=0.1$とし、格子の外周をゼロに固定します。初期条件は中央の1格子のみ1.0、それ以外は0.0です。
この陽解法の安定条件は、今回の等間隔格子では概ね$\alpha\leq 1/4$です。今回は安定条件を満たす設定にしています。ただし、これは拡散方程式の条件であり、浅水流方程式などの安定条件をそのまま表すものではありません。
2.1 なぜ配列を2つ用意するのか
重要なのは、現時刻の値uだけを読み、新時刻の値vに書き込むことです。
! 現時刻の配列uを読み、次時刻の配列vを更新します。
v(i,j) = u(i,j) + alpha * ( &
    u(i-1,j) + u(i+1,j) + &
    u(i,j-1) + u(i,j+1) - &
    4.0_real64 * u(i,j))
同じ配列uを書き換えながら隣接要素を読んでしまうと、格子の計算順序によって結果が変わる可能性があります。GPUでは多数の格子が並列に計算されるため、この違いは特に問題になります。
今回はJacobi型の更新として、読み込み側と書き込み側の配列を分離します。
2.2 Fortranの配列の並びにも注意する
Fortranは列優先(column-major)の配列配置を採用しています。2次元配列u(i,j)では、通常iが変化する方向の要素がメモリ上で連続します。
OpenACC版では次のようにiを内側のループにしています。
do j = 2, ny-1
    do i = 2, nx-1
        ! i方向の格子を連続して参照します。
    end do
end do
GPUで効率よくメモリへアクセスするためには、配列の格納順序とアクセスパターンを意識する必要があります。
3. 実行環境とサンプルの構成
今回は、Ubuntu 24.04を中心に、Windows 11 + WSL2 Ubuntu 24.04からも試せる構成にします。Docker Desktopは前提とせず、Docker EngineとComposeを使います。
| 項目 | 内容 |
|---|---|
| OS | Ubuntu 24.04、またはWindows 11 + WSL2 Ubuntu 24.04 |
| GPU | NVIDIA GPU(例:GeForce RTX 4060 Ti 16GB) |
| CPU用コンパイラ | gfortran |
| GPU用コンパイラ | NVIDIA HPC SDK 26.9 のnvfortran
|
| コンテナ | Docker Engine + Docker Compose |
| GPUコンテナ連携 | NVIDIA Container Toolkit |
| 言語 | 標準FortranのDO CONCURRENTと、OpenACC指示文 |
RTX 4060 TiのCompute Capabilityは8.9です。GPUアーキテクチャを明示したい場合は、nvfortranで-gpu=cc89を指定できます。他のGPUを使う場合は、そのGPUに合う設定へ変更してください。
3.1 ディレクトリ構成
付属するr001のサンプルは、次のようになっています。
fortran2018_gpu_starter/
├── compose.yaml
├── README.md
├── TEST_RESULTS.md
├── src/
│   ├── demo_common.f90
│   ├── stencil_do_concurrent.f90
│   └── stencil_openacc.f90
└── scripts/
    ├── check_cpu.sh
    ├── check_gpu.sh
    └── compare_results.py
demo_common.f90は、入力パラメータ、初期条件、実行時間の計算、結果の検証などを両方式で共通化したものです。同じ初期条件で比べなければ、高速化の評価にならないためです。
また、長いソースを読みやすくするため、以下ではファイルごとに開閉式で掲載します。
4. 先にCPUで動作確認する
GPUへ移す前に、数値計算そのものが正しい形で動くか確認します。
Ubuntuで、次のコマンドを実行します。
sudo apt update
sudo apt install -y gfortran python3

cd fortran2018_gpu_starter
bash scripts/check_cpu.sh
このスクリプトは、両実装をCPU上でコンパイルし、同じ条件で実行して、結果を比較します。
scripts/check_cpu.sh(クリックして展開)
#!/usr/bin/env bash
# Check that both implementations produce the same result on a CPU.
set -euo pipefail
cd "$(dirname "$0")/.."
mkdir -p build

# Run with bounds checking: the numerical kernels themselves are not modified.
gfortran -std=f2018 -O2 -g -Wall -Wextra -fcheck=all \
  src/demo_common.f90 src/stencil_do_concurrent.f90 -o build/dc_cpu
gfortran -std=f2018 -O2 -g -Wall -Wextra -fcheck=all \
  src/demo_common.f90 src/stencil_openacc.f90 -o build/acc_cpu

./build/dc_cpu 96 96 60 | tee build/dc_cpu.log
./build/acc_cpu 96 96 60 | tee build/acc_cpu.log

python3 scripts/compare_results.py build/dc_cpu.log build/acc_cpu.log
gfortran -std=f2018は、Fortran 2018の言語モードを指定するものです。ただし、このコマンドでGPU実行されるわけではありません。
OpenACC版もgfortranで-fopenaccを付けずにコンパイルしているため、!$acc行は通常のコメントとして扱われ、計算ループがCPUで実行されます。これを基準動作の確認に利用します。
4.1 実際に確認した結果
2026年10月19日に、次の条件についてCPU動作と結果の一致を確認しました。
| 格子数 | 時間ステップ数 | 確認結果 |
|---|---|---|
| 5 × 5 | 1 | PASS |
| 95 × 117 | 70 | PASS |
| 96 × 96 | 60 | PASS |
| 256 × 256 | 80 | PASS |
96×96格子、60ステップの実行では、両方式ともMASSは約1.0、CENTREは約0.013322764968595でした。ログの最後にCOMPARE=PASSが表示されます。
COMPARE MASS: PASS
COMPARE CENTRE: PASS
COMPARE=PASS
この比較は総和と中央格子の値を照合した簡易チェックです。全格子の配列差、全ステップの保存量、GPUとCPUの一致を保証するものではありません。実際のシミュレーションへ拡張する際には、検査項目を増やします。
5. DO CONCURRENTを使った実装
最初はDO CONCURRENT版です。
5.1 通常のDOとの違い
通常の2重ループは次のようになります。
do j = 2, ny-1
    do i = 2, nx-1
        v(i,j) = u(i,j) + alpha * ( &
            u(i-1,j) + u(i+1,j) + &
            u(i,j-1) + u(i,j+1) - &
            4.0_real64 * u(i,j))
    end do
end do
これをDO CONCURRENTで書くと、次の形になります。
do concurrent (j = 2:ny-1, i = 2:nx-1)
    v(i,j) = u(i,j) + alpha * ( &
        u(i-1,j) + u(i+1,j) + &
        u(i,j-1) + u(i,j+1) - &
        4.0_real64 * u(i,j))
end do
DO CONCURRENTは、個々の反復が互いに独立しているという意図を示す構文です。単にDOをDO CONCURRENTに置き換えれば正しく並列化できる、という意味ではありません。別の反復が変更するデータを参照するループなどには、そのまま適用できません。
今回のループは各反復がuを読み、互いに異なるv(i,j)へ書き込むため、並列化しやすい形になっています。
5.2 時間ステップごとの配列の交換
更新した後は、vを次のステップのuとして使います。今回のDO CONCURRENT版は、Fortranのmove_allocで配列の割り当て先を交換しています。
call move_alloc(u, temporary)
call move_alloc(v, u)
call move_alloc(temporary, v)
これは、配列の全要素をコピーせずに割り当ての所有権を移す操作です。GPU上での実際のメモリ管理はコンパイラや実行モードに依存しますが、CPU側で大きな配列を毎回コピーする処理は避けられます。
5.3 プログラム全体
src/stencil_do_concurrent.f90(クリックして展開)
! Standard Fortran DO CONCURRENT implementation of a 2-D diffusion stencil.
!
! A loop's iterations are independent because every iteration reads the
! current field u and writes only its own element of the next field v.
! This is critical: modifying u in-place would create data races and would
! NOT be a valid DO CONCURRENT transformation of a Jacobi time step.
!
! CPU: gfortran -std=f2018 -O3 src/demo_common.f90 \
!                src/stencil_do_concurrent.f90 -o dc_cpu
! GPU: nvfortran -O3 -stdpar=gpu -Minfo=stdpar src/demo_common.f90 \
!                src/stencil_do_concurrent.f90 -o dc_gpu
program stencil_do_concurrent
  use, intrinsic :: iso_fortran_env, only : real64, int64
  use demo_common, only : read_problem_size, initialize_field, &
                          print_result, clock_seconds
  implicit none

  real(real64), parameter :: alpha = 0.1_real64
  real(real64), allocatable :: u(:,:), v(:,:), temporary(:,:)
  integer :: nx, ny, steps, i, j, step
  integer(int64) :: start_ticks, finish_ticks, ticks_per_second
  real(real64) :: elapsed, mass_probe

  call read_problem_size(nx, ny, steps)
  allocate(u(nx, ny), v(nx, ny))
  call initialize_field(u, v)

  call system_clock(start_ticks, ticks_per_second)
  do step = 1, steps
    ! Read only u, write only v.  Fortran stores u(i,j) with i contiguous.
    ! nvfortran -stdpar=gpu can offload this standard Fortran construct.
    do concurrent (j = 2:ny-1, i = 2:nx-1)
      v(i,j) = u(i,j) + alpha * (u(i-1,j) + u(i+1,j) &
                                + u(i,j-1) + u(i,j+1) &
                                - 4.0_real64 * u(i,j))
    end do

    ! Swap allocatable array ownership in constant time instead of copying
    ! nx*ny numbers on the CPU after every time step.
    ! Both buffers retain zero-valued boundaries for the entire simulation.
    call move_alloc(u, temporary)
    call move_alloc(v, u)
    call move_alloc(temporary, v)
  end do

  ! Summing u on the host forces a result read/synchronization before timing
  ! stops. This approximates total wall time, including managed-memory costs.
  mass_probe = sum(u)
  call system_clock(finish_ticks)
  elapsed = clock_seconds(start_ticks, finish_ticks, ticks_per_second)
  call print_result('DO_CONCURRENT', u, elapsed)
  print '(a,es24.16)', 'MASS_SYNC=', mass_probe

  deallocate(u, v)
end program stencil_do_concurrent
5.4 GPU用にコンパイルする
nvfortranが使える環境では、次のコマンドでコンパイルできます。
nvfortran -O3 -stdpar=gpu -Minfo=stdpar \
    src/demo_common.f90 src/stencil_do_concurrent.f90 \
    -o build/dc_gpu
主なオプションは次の通りです。
| オプション | 目的 |
|---|---|
-O3 |
最適化を有効にします |
-stdpar=gpu |
標準並列構文をGPU向けにコンパイルします |
-Minfo=stdpar |
並列化についてのコンパイラ診断を表示します |
-gpu=cc89 |
RTX 4060 Tiなど、Compute Capability 8.9を明示するときに使用します |
-Minfo=stdparの出力を確認し、目的のループがGPU実行の対象になっているか調べます。コマンドが成功したことだけで、GPU上で高速に動作したと判断しないようにします。
なお、-stdpar=gpuはCPUとGPUのメモリの扱いをコンパイラ側で支援します。Linuxネイティブ環境とWSL2ではメモリ機能に違いがあるため、後ほど示すOpenACC版とも比較します。
6. OpenACCを使った実装
DO CONCURRENTでGPU実行を試した次は、配列をGPU側に置いて複数の時間ステップを続けて計算する方法です。
OpenACCの指示文は、Fortranでは!$accから始まります。OpenACCを有効にしないコンパイルではコメントとして扱われるため、元のFortranの計算式を大きく変更しなくても導入しやすいという利点があります。
6.1 どこにデータを置くか指定する
今回のサンプルは、次のデータ領域を使用します。
!$acc data copy(u) create(v)

! ここでGPU上のu、vを使って時間ステップを繰り返します。

!$acc end data
copy(u)は、領域へ入るときにuをGPUへ転送し、領域から出るときに更新後のuをCPUへ戻す指定です。create(v)はGPU側に作業配列を確保する指定で、入出力時の不要な転送を避けます。
ただし、create(v)ではGPU側の初期値が自動的にゼロになるとは限りません。今回のプログラムは内部格子のvを使用前に全て書き込む構成で、外周格子はuのみから読むようにしています。未初期化の作業配列を安易に参照してはいけません。
6.2 格子計算の並列化
GPUに渡すループは次のように指定します。
!$acc parallel loop collapse(2) present(u, v)
do j = 2, ny-1
    do i = 2, nx-1
        v(i,j) = u(i,j) + alpha * ( &
            u(i-1,j) + u(i+1,j) + &
            u(i,j-1) + u(i,j+1) - &
            4.0_real64 * u(i,j))
    end do
end do
!$acc end parallel loop
collapse(2)は2重ループをまとめて並列化する指定です。present(u,v)は、対象配列がすでにGPU上に存在していることを前提として使います。
今回のOpenACC版では、計算結果vをGPU上のuへコピーするループも実行します。動きが分かりやすい代わりに、1ステップ当たりGPUカーネルを2回実行する構成です。これは学習用の実装であり、最適化の余地があります。
6.3 プログラム全体
src/stencil_openacc.f90(クリックして展開)
! OpenACC implementation of the same 2-D diffusion problem.
!
! All time steps execute with u and v resident on the GPU inside DATA.
! We intentionally do two stencil/assignment kernels per time step: the
! first computes a new field and the second copies it on the GPU. This
! makes the data movement easy to reason about for a first example.
! More advanced designs can swap device buffers instead of copying.
!
! CPU: gfortran -std=f2018 -O3 src/demo_common.f90 \
!                src/stencil_openacc.f90 -o acc_cpu
! GPU: nvfortran -O3 -acc -Minfo=accel src/demo_common.f90 \
!                src/stencil_openacc.f90 -o acc_gpu
program stencil_openacc
  use, intrinsic :: iso_fortran_env, only : real64, int64
  use demo_common, only : read_problem_size, initialize_field, &
                          print_result, clock_seconds
  implicit none

  real(real64), parameter :: alpha = 0.1_real64
  real(real64), allocatable :: u(:,:), v(:,:)
  integer :: nx, ny, steps, i, j, step
  integer(int64) :: start_ticks, finish_ticks, ticks_per_second
  real(real64) :: elapsed, mass_probe

  call read_problem_size(nx, ny, steps)
  allocate(u(nx, ny), v(nx, ny))
  call initialize_field(u, v)

  call system_clock(start_ticks, ticks_per_second)

  ! copy(u): CPU -> GPU once and GPU -> CPU once for the entire simulation.
  ! create(v): allocate workspace only on GPU; no pointless host transfer.
  !$acc data copy(u) create(v)
  do step = 1, steps
    ! COLLAPSE(2) exposes both spatial loops to GPU execution.
    ! i is the innermost loop for contiguous Fortran memory access.
    !$acc parallel loop collapse(2) present(u, v)
    do j = 2, ny-1
      do i = 2, nx-1
        v(i,j) = u(i,j) + alpha * (u(i-1,j) + u(i+1,j) &
                                  + u(i,j-1) + u(i,j+1) &
                                  - 4.0_real64 * u(i,j))
      end do
    end do
    !$acc end parallel loop

    ! Copy interior values on the device.  Boundaries remain zero.
    !$acc parallel loop collapse(2) present(u, v)
    do j = 2, ny-1
      do i = 2, nx-1
        u(i,j) = v(i,j)
      end do
    end do
    !$acc end parallel loop
  end do
  !$acc end data

  ! Leaving the DATA region synchronizes and copies final u to the host.
  ! Use the same host read as the DO CONCURRENT program before stopping time.
  mass_probe = sum(u)
  call system_clock(finish_ticks)
  elapsed = clock_seconds(start_ticks, finish_ticks, ticks_per_second)
  call print_result('OPENACC', u, elapsed)
  print '(a,es24.16)', 'MASS_SYNC=', mass_probe

  deallocate(u, v)
end program stencil_openacc
6.4 コンパイル方法
nvfortran -O3 -acc -Minfo=accel \
    src/demo_common.f90 src/stencil_openacc.f90 \
    -o build/acc_gpu
| オプション | 目的 |
|---|---|
-acc |
OpenACCを有効にします |
-Minfo=accel |
GPU化された領域などの診断情報を表示します |
-O3 |
最適化を有効にします |
-Minfo=accelの出力から、GPUカーネルが生成されているか、不要なデータ転送が行われていないかを確認します。
6.5 2方式の違いを整理する
| 比較項目 | DO CONCURRENT版 | OpenACC版 |
|---|---|---|
| 計算式 | 5点差分 | 同じ5点差分 |
| 並列化の指定 | do concurrent |
!$acc parallel loop |
| 配列の扱い |
move_allocで交換 |
GPU上でvからuへコピー |
| GPUメモリの制御 | コンパイラの標準並列機能に依存 |
data領域で明示 |
| 主な学習目的 | 標準構文からのGPUオフロード | データ常駐と転送制御 |
重要なのは、この2本は物理条件と差分式をそろえていますが、メモリアクセス量やGPUカーネル数まで一致させた性能比較用プログラムではないということです。測定時間の大小をそのままDO CONCURRENTとOpenACCの優劣にはできません。
7. 共通モジュールと結果検証
共通モジュールは、初期条件と評価条件をそろえるためのものです。real64を使用し、CPUとGPUの比較では倍精度計算を前提としています。
src/demo_common.f90(クリックして展開)
! Fortran 2018-compatible support code for the 2-D heat-diffusion demo.
!
! The two solvers share the same initialization and result validation.
! This makes it possible to compare the CPU, DO CONCURRENT and OpenACC
! implementations under exactly the same physical and numerical conditions.
module demo_common
  use, intrinsic :: iso_fortran_env, only : real64, int64, error_unit
  implicit none
  private

  public :: read_problem_size, initialize_field, print_result, clock_seconds

contains

  !> Read an optional grid size and number of steps from the command line.
  !! Usage: ./demo [nx [ny [steps]]]
  !! A square grid with one nonzero initial cell is used by default.
  subroutine read_problem_size(nx, ny, steps)
    integer, intent(out) :: nx, ny, steps
    integer :: argc

    nx = 256
    ny = 256
    steps = 80
    argc = command_argument_count()

    if (argc > 3) then
      write(error_unit, '(a)') 'Usage: ./demo [nx [ny [steps]]]'
      error stop 1
    end if

    if (argc >= 1) call parse_positive_arg(1, nx)
    if (argc >= 2) call parse_positive_arg(2, ny)
    if (argc >= 3) call parse_positive_arg(3, steps)

    if (nx < 5 .or. ny < 5 .or. steps < 1) then
      write(error_unit, '(a)') 'nx, ny must be >=5 and steps >=1.'
      error stop 1
    end if
  end subroutine read_problem_size

  !> Validate and parse one integer command-line argument.
  subroutine parse_positive_arg(index, number)
    integer, intent(in) :: index
    integer, intent(out) :: number
    integer :: status
    character(len=80) :: arg

    call get_command_argument(index, arg, status=status)
    if (status /= 0) error stop 'Cannot read an argument.'
    read(arg, *, iostat=status) number
    if (status /= 0) error stop 'Arguments must be integers.'
  end subroutine parse_positive_arg

  !> Set homogeneous Dirichlet (zero-value) boundaries and one hot cell.
  !! This is deliberately simple so the GPU versions do the same work.
  subroutine initialize_field(u, v)
    real(real64), intent(out) :: u(:,:), v(:,:)
    integer :: nx, ny

    nx = size(u, dim=1)
    ny = size(u, dim=2)
    if (any(shape(u) /= shape(v))) error stop 'Different grid shapes.'

    u = 0.0_real64
    v = 0.0_real64
    u((nx+1)/2, (ny+1)/2) = 1.0_real64
  end subroutine initialize_field

  !> Calculate wall time from two SYSTEM_CLOCK samples.
  !! The caller synchronizes GPU results before providing t1.
  pure function clock_seconds(t0, t1, rate) result(seconds)
    integer(int64), intent(in) :: t0, t1, rate
    real(real64) :: seconds

    seconds = real(t1 - t0, real64) / real(rate, real64)
  end function clock_seconds

  !> Perform elementary numerical checks and print comparable outputs.
  !! Total mass should never increase significantly for this stable stencil
  !! with zero boundaries (alpha=0.1); it is not forced to equal one when
  !! diffusion reaches the boundaries.
  subroutine print_result(tag, u, elapsed)
    character(len=*), intent(in) :: tag
    real(real64), intent(in) :: u(:,:), elapsed
    real(real64) :: mass, centre, smallest, largest
    integer :: nx, ny

    nx = size(u, dim=1)
    ny = size(u, dim=2)
    mass = sum(u)
    centre = u((nx+1)/2, (ny+1)/2)
    smallest = minval(u)
    largest = maxval(u)

    if (smallest < -1.0e-10_real64 .or. largest > 1.0_real64 + 1.0e-10_real64) &
      error stop 'Unstable or invalid result: range check failed.'
    if (mass < -1.0e-10_real64 .or. mass > 1.0_real64 + 1.0e-8_real64) &
      error stop 'Unstable or invalid result: mass check failed.'

    print '(a)', 'METHOD=' // trim(tag)
    print '(a,es24.16)', 'MASS=', mass
    print '(a,es24.16)', 'CENTRE=', centre
    print '(a,f12.6)', 'SECONDS=', elapsed
    print '(a)', 'CHECK=PASS'
  end subroutine print_result

end module demo_common
検証では主に次の値を確認します。
-
MASS:配列全体の値の総和です。 -
CENTRE:中央格子の値です。 -
SECONDS:プログラムが計測した経過時間です。 -
CHECK:値の範囲と総和に対する簡易チェック結果です。
外周をゼロとする条件では、拡散が境界へ到達した後にMASSが減少することはあります。そのため、このサンプルでは総和が初期値1.0から増えていないかを主に検査しています。質量保存を厳密に検証する実用的な流れの計算とは、評価条件が異なります。
7.1 Pythonによる結果の照合
compare_results.pyでは、2本のプログラムが出力したMASSとCENTREを許容誤差付きで比較します。
math.isclose(x, y, rel_tol=1.0e-10, abs_tol=1.0e-12)
浮動小数点計算は、CPUとGPUで演算順序や最適化が異なることがあります。数値計算では、文字列やビット列の完全一致ではなく、問題に応じた誤差基準で比較する必要があります。
scripts/compare_results.py(クリックして展開)
"""Compare the reproducibility of two Fortran solver output logs.

This script checks scalar diagnostics, not array-by-array agreement.  More
thorough production validation should also compare full state arrays and
mass-balance residuals at each step.
"""

from __future__ import annotations

import math
import pathlib
import sys


def parse_output(path: pathlib.Path) -> dict[str, float | str]:
    """Parse KEY=VALUE records from one Fortran program log."""
    values: dict[str, float | str] = {}
    for line in path.read_text(encoding="utf-8").splitlines():
        if "=" not in line:
            continue
        key, value = line.split("=", 1)
        key, value = key.strip(), value.strip()
        if key in {"MASS", "CENTRE"}:
            values[key] = float(value)
        elif key in {"CHECK", "METHOD"}:
            values[key] = value
    return values


def main() -> None:
    """Exit nonzero for unstable runs or divergent physical diagnostics."""
    if len(sys.argv) != 3:
        raise SystemExit("usage: compare_results.py log_a log_b")
    a = parse_output(pathlib.Path(sys.argv[1]))
    b = parse_output(pathlib.Path(sys.argv[2]))
    if a.get("CHECK") != "PASS" or b.get("CHECK") != "PASS":
        raise SystemExit(f"Solver check failed: {a} {b}")
    for key in ("MASS", "CENTRE"):
        x = float(a[key])
        y = float(b[key])
        if not math.isclose(x, y, rel_tol=1.0e-10, abs_tol=1.0e-12):
            raise SystemExit(f"MISMATCH {key}: {x} vs {y}")
        print(f"COMPARE {key}: PASS ({x:.12e} vs {y:.12e})")
    print("COMPARE=PASS")


if __name__ == "__main__":
    main()
実務で使用する前には、全格子の最大絶対誤差、相対誤差、時間ステップごとの保存量・残差、境界条件の適用状況も検証する必要があります。
8. Docker Engine + ComposeでGPUを使う
ここからはNVIDIA GPUが利用できる環境での実行方法です。ホストOSにHPC SDKを直接導入する方法もありますが、今回はコンパイラやライブラリの組み合わせを固定しやすいコンテナを使います。
図3:Windows 11 + WSL2の場合の実行構成
Ubuntu 24.04をPCへ直接インストールしている場合は、最上段のWindows・WSL2を通常のUbuntuホストに置き換えてください。
8.1 ホスト側でGPUを確認する
まず、ホスト側で次のコマンドを確認します。
nvidia-smi
docker version
docker compose version
WSL2の場合は、Windows側にWSL2対応のNVIDIAドライバが必要です。WSL2内へ別のLinux GPUドライバを上書きインストールしないようにします。ネイティブUbuntuの場合は、対応するLinux用NVIDIAドライバを導入します。
nvidia-smiが表示されたら、DockerからGPUが見えるか確認します。
docker run --rm --gpus all ubuntu:24.04 nvidia-smi
このコマンドが通らない場合は、Fortranをコンパイルする前にDockerとGPUの連携を確認してください。
8.2 NVIDIA Container Toolkitが未設定の場合
NVIDIA Container Toolkitが入っていない場合は、公式インストールガイドに従って導入します。以下はすでにツールがインストールされている場合のDocker設定手順です。
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
nvidia-ctk自体がない場合は、先に公式ガイドにあるリポジトリ設定とパッケージのインストールが必要です。Docker Engineをrootlessモードで運用している場合は手順が異なるため、同ガイドのrootless向け設定を参照してください。
8.3 Composeファイル
今回はHPC SDK 26.9の開発用コンテナを使います。cuda_multiイメージは大容量なので、保存領域とダウンロード量に注意してください。使用可能なCUDA版は、ホストのドライバにも依存します。
compose.yaml(クリックして展開)
# GPU access requires a compatible NVIDIA driver and NVIDIA Container Toolkit
# on the host or WSL2 environment. See the README for prerequisite checks.
services:
  nvhpc:
    image: nvcr.io/nvidia/nvhpc:26.9-devel-cuda_multi-ubuntu24.04
    working_dir: /work
    volumes:
      - .:/work
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
    stdin_open: true
    tty: true
    command: bash
このComposeファイルでは、ホスト側の作業ディレクトリを/workへマウントし、GPUをコンテナへ公開します。
8.4 GPUコンパイルと実行
cd fortran2018_gpu_starter

# まずコンテナからGPUが見えるか確認します。
docker compose run --rm nvhpc nvidia-smi

# コンパイラのバージョンを確認します。
docker compose run --rm nvhpc nvfortran --version

# 両方式をGPU向けにコンパイルし、簡易検証を実行します。
docker compose run --rm nvhpc bash scripts/check_gpu.sh
scripts/check_gpu.sh(クリックして展開)
#!/usr/bin/env bash
# Run this only on a configured host/container with nvfortran and NVIDIA GPU.
set -euo pipefail
cd "$(dirname "$0")/.."
mkdir -p build

# Target architecture is detected automatically from the installed GPU.
# For RTX 4060 Ti, adding -gpu=cc89 is optional.
nvfortran -O3 -stdpar=gpu -Minfo=stdpar \
  src/demo_common.f90 src/stencil_do_concurrent.f90 -o build/dc_gpu
nvfortran -O3 -acc -Minfo=accel \
  src/demo_common.f90 src/stencil_openacc.f90 -o build/acc_gpu

# Smaller default run is a functional check, not a credible benchmark.
./build/dc_gpu 256 256 80 | tee build/dc_gpu.log
./build/acc_gpu 256 256 80 | tee build/acc_gpu.log
python3 scripts/compare_results.py build/dc_gpu.log build/acc_gpu.log

printf '%s\n' 'For performance measurements try: 2048 2048 500'
スクリプトは256 × 256格子、80ステップで実行します。これはGPUが利用できるかを確認する小さなテストであり、性能評価に適したサイズとは限りません。
コンテナ内にpython3がない場合は、比較スクリプトを動かすためにPython 3を用意してください。また、コンテナのCUDA版とホストのドライバが合わない場合は、公式に提供されている適合するイメージを選んでください。
GPU上での動作は本記事の作成環境ではまだ確認できていません。 実行時にはコンパイラ出力と実行ログを確認し、エラーの有無、GPU利用状況、計算結果を記録してください。
9. 速度を比較するときに確認したいこと
GPUプログラムが実行できたら、格子数を増やして測定します。
# 上記のGPUチェックでコンパイルされた実行ファイルを使用します。
docker compose run --rm nvhpc bash -lc './build/dc_gpu 2048 2048 500'
docker compose run --rm nvhpc bash -lc './build/acc_gpu 2048 2048 500'
各プログラムのSECONDSが計測値です。ただし、次の理由から1回実行した秒数だけで性能を結論付けないようにします。
- 初回実行にはGPUランタイムの初期化や、メモリの準備が含まれる場合があります。
- 小さな格子では、GPUカーネル起動やデータ転送の負担が目立ちます。
-
DO CONCURRENT版はメモリ管理をコンパイラに任せていますが、OpenACC版はGPU上に配列を保持しています。 - OpenACC版には毎ステップ
vからuへのGPU上のコピーがあり、2方式のメモリアクセス量は同じではありません。 - RTX 4060 Tiなどの一般向けGPUは、倍精度(FP64)の計算で必ずしも高い性能を発揮するとは限りません。
9.1 CPUの速度を測る場合
前述のcheck_cpu.shは境界チェックを含む正しさの確認用です。その実行時間をGPUとの性能比較に使わないようにします。CPUの比較対象には、同じ格子数・時間ステップ数で最適化した実行ファイルを別に用意します。
mkdir -p build

gfortran -std=f2018 -O3 \
    src/demo_common.f90 src/stencil_do_concurrent.f90 \
    -o build/dc_cpu_release

./build/dc_cpu_release 2048 2048 500
このCPU版は主に単体CPU実行の基準として使います。gfortranがDO CONCURRENTを必ず複数CPUスレッドで並列実行するとは限りません。OpenMP CPU版やSIMD版との比較も行うなら、別の実装として実行条件を明記します。
9.2 速度向上率の計算
同じ計算条件と同じ測定範囲で得た時間を使い、次のように計算します。
$$
\mathrm{Speedup}=\frac{T_{\mathrm{CPU}}}{T_{\mathrm{GPU}}}
$$
例えば、CPUが10秒、GPUが2秒であれば5倍です。これは計算式の説明用の例であり、本記事のGPU測定結果ではありません。
測定時には、CPU・GPUの機種、使用したコンパイラ、最適化フラグ、倍精度か単精度か、格子数、時間ステップ数、初期化やデータ転送を含むかを一緒に記録します。
| 指標 | 記録内容 |
|---|---|
| 環境 | OS、GPU名、GPUドライバ、コンパイラ版 |
| 問題の規模 |
nx、ny、steps
|
| 計算精度 |
real64など |
| CPU時間 | 最適化したCPU版の経過秒数 |
| GPU時間 | GPU版の経過秒数 |
| 正しさ | 計算結果の差、範囲チェック、保存量 |
| プロファイル | GPUカーネル時間、データ転送時間 |
9.3 データ転送が遅いのか、計算が遅いのか
OpenACCの場合は、次のように環境変数を指定して簡易的なタイミング情報を取得できます。
docker compose run --rm -e NVCOMPILER_ACC_TIME=1 nvhpc \
    bash -lc './build/acc_gpu 2048 2048 500'
NVCOMPILER_ACC_TIMEはNVIDIA HPC CompilersのOpenACC向け診断機能です。GPUカーネルとデータ転送の時間を確認する際の手掛かりになります。さらに細かく解析する場合は、利用環境でサポートされるNsight Systemsなどのプロファイラを検討します。
9.4 配列がGPUメモリをどの程度使うのか
今回の実装は、少なくともuとvの2つの倍精度配列を使用します。配列本体の容量は、概ね次のようになります。
$$
M= n_x\times n_y\times 8;\mathrm{bytes}\times 2
$$
| 格子数 | 2配列の容量(概算) |
|---|---|
| 256 × 256 | 1 MiB |
| 1024 × 1024 | 16 MiB |
| 2048 × 2048 | 64 MiB |
| 4096 × 4096 | 256 MiB |
これは配列2個の本体だけを数えた概算であり、ランタイム、追加作業配列、Managed Memoryの管理負担などは含みません。実際の洪水解析では水深、流量、地盤高、粗度、計算補助配列などが増えるため、GPUメモリの見積もりは別に必要です。
10. WSL2とNVIDIA GPUを使うときの注意
Windows 11のWSL2でもGPU計算を試せますが、ネイティブUbuntuと同じ挙動・性能になるとは限りません。
特に、CUDAのManaged Memory / Unified Memoryには環境ごとの対応範囲があります。NVIDIAのWSL向け資料では、フル機能のManaged Memoryに制限があることが説明されています。DO CONCURRENTを使う場合は、コンパイラのメモリモードや実行時の挙動を確認する必要があります。
一方、OpenACCではdata領域を明示できるため、何をGPUへ渡し、何をCPUへ戻すかが比較的把握しやすくなります。
なお、Dockerコンテナでnvidia-smiが表示されたことは、GPUの公開を確認する一歩に過ぎません。コンパイルした計算カーネルが実際にGPUで動いているかどうかは、-Minfoの診断や実行時の計測で確認してください。
11. 洪水氾濫解析などのFortranプログラムへ応用するには
今回の5点差分は入門用ですが、数値シミュレーションに共通する考え方を確認できます。
河道計算や2次元氾濫解析へ応用する場合は、処理を分解してGPU化しやすい場所を探します。
| 計算処理 | GPU化の考え方 | 注意点 |
|---|---|---|
| 2次元格子の状態量更新 | 格子単位に並列化しやすい候補です | 隣接参照と時刻更新の分離が必要です |
| 格子面の流束計算 | 面ごとの計算を並列化する候補です | 面の共有データと書き込み競合に注意します |
| 水深・流速の更新 | 計算量が大きい場合に候補になります | 安定条件、負の水深、保存則を検証します |
| 1D河道のNode–Reach処理 | 接続構造を整理した後で検討します | 分岐・合流の依存関係があります |
| 1D–2Dの流量交換 | 交換点や接続面の整理が必要です | 複数の格子への同時書き込みに注意します |
| ファイル入出力 | 基本的にCPU側に残します | GPUとCPUの転送回数を少なくします |
特に河川・洪水解析では、単に計算が速くなっただけでは十分ではありません。GPU化の前後で、流量・水位・浸水深だけでなく、水収支、境界条件、負の水深の発生、各時刻の残差を検証する必要があります。
並列化しやすいからといって、数値解法の更新順序を無条件に変えてはいけません。 元の計算方法で守っていた保存則や離散化の意味が変わってしまう可能性があります。
12. よくある疑問
Q1. DO CONCURRENTにすれば必ずGPUで動きますか?
いいえ。構文自体は標準Fortranですが、GPUへオフロードするにはコンパイラの対応とオプションが必要です。gfortranで通常コンパイルした場合、今回のDO CONCURRENTが自動的にNVIDIA GPUで実行されることはありません。
Q2. nvccではFortranをそのままコンパイルできますか?
一般にnvccはCUDA C/C++向けです。今回のFortranソースはnvfortranでコンパイルします。CUDA Fortranを使う場合も、NVIDIA HPC SDKのFortranコンパイラを利用します。
Q3. OpenACCのほうが必ず速いですか?
そうとは限りません。今回のOpenACC版には各ステップで配列をコピーする処理があります。また、DO CONCURRENT版とOpenACC版ではメモリ管理の仕組みも違います。まず計算結果をそろえ、その後に転送時間とカーネル時間を調べます。
Q4. すべての配列を単精度にすれば速くなりますか?
単精度はメモリ使用量が少なく、GPUによっては高速化しやすい場合があります。ただし、洪水や水理計算では水位差、累積流量、水収支などの精度に影響する可能性があります。real64を一律にreal32へ変更するのではなく、感度解析と基準計算との照合が必要です。
Q5. GPUでCPUより遅くなった場合は失敗ですか?
小さい問題では十分にあり得ます。格子数を変え、初回起動の負担とデータ転送、カーネル実行時間を分けて見ます。高速化対象が計算量の小さいループなら、GPUへ移さずCPUに残した方がよいこともあります。
Q6. WSL2 Ubuntu 24.04での注意点はありますか?
Windows 11 + WSL2で実行する場合、Windows側に対応するNVIDIAドライバが必要です。WSL2内部にLinux用NVIDIAディスプレイドライバを追加インストールしてはいけません。
Docker Engine側にNVIDIA Container Toolkitが未設定なら、公式手順に従って設定します。
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
また、WSL2ではUnified Memoryの機能に制約があります。このため、DO CONCURRENTのGPU版は、コンパイルできても実行時の制約や性能低下が起きる可能性があります。OpenACC版も併せて検証するのが適切です。
13. まとめと次のステップ
今回は、Fortran 2018で記述できるDO CONCURRENTと、OpenACCを使ったGPUオフロードの方法を取り上げました。2次元拡散方程式を例に、CPUで結果を確認し、GPUでコンパイル・検証するための構成を整理しました。
実際の数値計算で重要になるのは、並列化するループそのものだけでなく、GPUメモリへのデータの置き方、時間ステップ間の配列更新、CPU版との精度比較です。
次回のPart 2では、今回のOpenACC版が毎ステップ実行しているGPU上の配列コピーを見直し、ダブルバッファリングなどで余分なメモリアクセスを減らします。そのうえで、CPU最適化版・DO CONCURRENT版・OpenACC最適化版について、同じ問題・同じ測定条件で速度と精度を比べていく予定です。
実際の洪水解析などに適用する際は、その後に境界条件、保存則、1D–2D連成部分の依存関係を確認しながら対象を広げるのがよいと考えています。
参考資料
本記事のコンパイラオプション、GPUコンテナ、CUDA/WSL2の制約は、以下の公式資料を参照しました(2026年10月10日確認)。
-
NVIDIA HPC Compilers User's Guide 26.9 —
DO CONCURRENT、OpenACC、-stdpar、GPUメモリ管理、計測方法 - NVIDIA HPC SDK 26.9 Documentation — HPC SDKの構成とコンパイラ対応範囲
- NVIDIA HPC SDK Container Guide 26.9 — NGCの開発用コンテナ
- NVIDIA NGC:HPC SDK 26.9 開発用コンテナ — 本記事で用いたタグ
- Docker Docs:GPU support in Compose — ComposeのGPU予約設定
- NVIDIA Container Toolkit:Installation Guide — DockerからNVIDIA GPUを使用する設定
- NVIDIA CUDA on WSL User Guide — WSL2でのGPU利用と制約
- NVIDIA CUDA GPU Compute Capability — RTX 4060 TiのCompute Capability
- ソース一式は
fortran2018_gpu_starter_r001.zipにまとめています。配布サイトからダウンロードしてください。