
結論(3 行)
- 順位・構成比・累積構成比・ABC 区分は、kSQL でもウィンドウ関数(
RANK/SUM() OVER ())で 1 文に書けます- v3.81.0 以降はウィンドウ関数を集計と同じ SELECT に書け、結果を同じ SELECT の式にも使えます(
CASE条件の中は元が CTE なら v3.83.0 以降)。公開時の v3.77.0 では書けず、「集計する段 → ウィンドウを列に出す段 → その列で割る・区分する段」の 3 段の CTE にしていました。段ごとに値を確かめたいときは今もこの形です- 累積には
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROWを明示し、ORDER BYはタイまで決める。既定のRANGEは同額の行に同じ累計を載せます(警告が出ます)
前回(第 2 回: 期間で集計する)の末尾で LAG を使いました。今回はウィンドウ関数を正面から扱います。題材は売上の ABC 分析です。
課題
案件管理(APP4149)の売上を顧客管理(APP4148)の会社別に集計し、売上の大きい順に並べて、構成比と累積構成比を出し、累積 80% までを A、95% までを B、残りを C に分けたい。
kintone の一覧では、並べ替えまではできますが、構成比も累積も出せません。
標準 SQL ならこう書く
PostgreSQL でも、ここでは会社別集計を base へ分けます。ただし、その次の SELECT ではウィンドウ関数を算術式や ROUND の中へ直接書けるため、順位・構成比・累積構成比を 1 段で計算できます。
WITH base AS (
  SELECT c.name, SUM(d.amount) AS total
  FROM deals d JOIN customers c ON d.customer_id = c.id
  GROUP BY c.name
)
SELECT name, total,
       RANK() OVER (ORDER BY total DESC) AS rnk,
       ROUND(total * 100.0 / SUM(total) OVER (), 1) AS share,
       ROUND(SUM(total) OVER (ORDER BY total DESC, name ROWS UNBOUNDED PRECEDING) * 100.0 / SUM(total) OVER (), 1) AS cum_share
FROM base
ORDER BY total DESC, name
kSQL でも、この形はそのまま書けます(v3.81.0〜)。違いは ROWS UNBOUNDED PRECEDING の省略形が使えず ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW と書く点だけです。公開時の v3.77.0 では「ウィンドウ関数を式の中で使う」ができず、次の 3 段の CTE に分けていました。3 段版は、段ごとに値を確かめたいときの書き方として今も有効です。
WITH base AS (
  SELECT a.会社名, SUM(b.売上) AS 売上合計
  FROM APP4149 AS b JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
  GROUP BY a.会社名
)
SELECT 会社名, 売上合計,
       RANK() OVER (ORDER BY 売上合計 DESC) AS 順位,
       ROUND(売上合計 * 100.0 / SUM(売上合計) OVER (), 1) AS 構成比,
       ROUND(SUM(売上合計) OVER (ORDER BY 売上合計 DESC, 会社名
                               ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
             * 100.0 / SUM(売上合計) OVER (), 1) AS 累積構成比
FROM base
ORDER BY 売上合計 DESC, 会社名
kSQL で段ごとに確かめる — 3 段の CTE
WITH base AS (
  SELECT a.会社名, a.顧客ランク, COUNT(*) AS 案件数, SUM(b.売上) AS 売上合計
  FROM APP4149 AS b
  INNER JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
  GROUP BY a.会社名, a.顧客ランク
), ranked AS (
  SELECT 会社名, 顧客ランク, 案件数, 売上合計,
         RANK() OVER (ORDER BY 売上合計 DESC) AS 順位,
         SUM(売上合計) OVER () AS 総計,
         SUM(売上合計) OVER (
           ORDER BY 売上合計 DESC, 会社名
           ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
         ) AS 累計
  FROM base
)
SELECT 順位, 会社名, 顧客ランク, 案件数, 売上合計,
       CASE WHEN 総計 = 0 THEN 0 ELSE ROUND(売上合計 * 100.0 / 総計, 1) END AS 構成比,
       CASE WHEN 総計 = 0 THEN 0 ELSE ROUND(累計 * 100.0 / 総計, 1) END AS 累積構成比,
       CASE WHEN 総計 = 0 THEN 'C'
            WHEN 累計 * 100.0 / 総計 <= 80 THEN 'A'
            WHEN 累計 * 100.0 / 総計 <= 95 THEN 'B'
            ELSE 'C' END AS 区分
FROM ranked
ORDER BY 売上合計 DESC, 会社名
| 順位 | 会社名 | 顧客ランク | 案件数 | 売上合計 | 構成比 | 累積構成比 | 区分 |
|---|---|---|---|---|---|---|---|
| 1 | 株式会社サイボウズ商事 | A | 5 | 20,700,000 | 25.3 | 25.3 | A |
| 2 | 株式会社キントーンシステムズ | A | 3 | 15,550,000 | 19.0 | 44.3 | A |
| 3 | 株式会社倉本インターナショナル | B | 2 | 13,600,000 | 16.6 | 60.9 | A |
| 4 | 篠村食品株式会社 | B | 2 | 9,050,000 | 11.1 | 72.0 | A |
| 5 | 株式会社テクノロジーサービス | D | 1 | 7,200,000 | 8.8 | 80.8 | B |
| 6 | 株式会社橘川ケミカル | B | 1 | 6,700,000 | 8.2 | 89.0 | B |
| 7 | 平川ファイナンスサービス株式会社 | A | 1 | 5,400,000 | 6.6 | 95.6 | C |
| 8 | 橋本ネットワーク通信株式会社 | C | 1 | 3,600,000 | 4.4 | 100.0 | C |
| 9 | サイボウズ物産株式会社 | A | 3 | 0 | 0.0 | 100.0 | C |
| 9 | 株式会社サイボウズ物産 | A | 1 | 0 | 0.0 | 100.0 | C |
上の値は手元環境の初期サンプルデータ(案件 20 件・売上合計 81,800,000。順位 9 の 2 社は売上合計が 0 になる検証用レコード)での結果です。自分の環境では会社や金額が異なります。
表では割合の桁を揃えるため小数第 1 位まで表記し、金額にカンマを入れています。プラグインの素の結果では 19.0 は 19、100.0 は 100 のように末尾の 0 が省略され、金額もカンマ無しです。
手入力の顧客ランクと、売上から機械的に出した ABC 区分がずれているのが見えます。ランク D の会社が B 区分、ランク A の会社が C 区分です。この突き合わせ自体が ABC 分析の使いどころで、SQL 1 文で毎回出せるようになります。
段の役割
| 段 | すること | 公開時(v3.77.0)の制約 |
|---|---|---|
base |
JOIN して集計し、粒度を会社別に決める | 集計とウィンドウは同じ SELECT に書けなかった(v3.81.0〜は書ける) |
ranked |
ウィンドウを列として出すだけ。式で包まない | ウィンドウ結果は同じ SELECT の式に使えなかった(v3.81.0〜は使える) |
| 最終 SELECT | 出た列を使って割る・丸める・区分する | ここではウィンドウ関数ではなく、実体化した列に対する通常の式として書ける |
この分け方は公開時の制約への対処でしたが、段ごとに値を確かめられる利点は v3.81.0 以降も変わりません。第 2 回の LAG で 5 段になったのも同じ理由でした。
段ごとに確かめる — 一時テーブルで 3 文に
CTE 1 文が読みにくければ、段をそのまま一時テーブルにして ; 区切りの 3 文にできます。結果は同じ 10 行です(実測)。プラグインも Dashboard もバッチを実行でき、Dashboard は最後の文の結果を描きます。
CREATE TEMP TABLE #base AS
SELECT a.会社名, a.顧客ランク, COUNT(*) AS 案件数, SUM(b.売上) AS 売上合計
FROM APP4149 AS b
INNER JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
GROUP BY a.会社名, a.顧客ランク;

CREATE TEMP TABLE #ranked AS
SELECT 会社名, 顧客ランク, 案件数, 売上合計,
       RANK() OVER (ORDER BY 売上合計 DESC) AS 順位,
       SUM(売上合計) OVER () AS 総計,
       SUM(売上合計) OVER (
         ORDER BY 売上合計 DESC, 会社名
         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       ) AS 累計
FROM #base;

SELECT 順位, 会社名, 顧客ランク, 案件数, 売上合計,
       CASE WHEN 総計 = 0 THEN 0 ELSE ROUND(売上合計 * 100.0 / 総計, 1) END AS 構成比,
       CASE WHEN 総計 = 0 THEN 0 ELSE ROUND(累計 * 100.0 / 総計, 1) END AS 累積構成比,
       CASE WHEN 総計 = 0 THEN 'C'
            WHEN 累計 * 100.0 / 総計 <= 80 THEN 'A'
            WHEN 累計 * 100.0 / 総計 <= 95 THEN 'B'
            ELSE 'C' END AS 区分
FROM #ranked
ORDER BY 売上合計 DESC, 会社名
利点は、段が 1 文ずつ独立することです。末尾に SELECT * FROM #ranked を足せば、総計や累計が列として出ている途中の状態をそのまま見られます。CTE では途中段を単独で取り出せません。
一方、次の 2 点は CTE 版で確認してください。EXPLAIN のウィンドウのフレーム行(次節)は CTE の段には出ますが、CREATE TEMP TABLE の計画には「一時テーブル参照」としか出ません。また、既定フレーム RANGE の警告(後述の落とし穴)は SELECT には付きますが、ウィンドウを CREATE TEMP TABLE … AS SELECT の中に書いた場合には結果に付きません(v3.77.0・MCP で実測)。
境界条件を決めておく
-
総計が 0 のとき。 全社の売上が未入力または 0 なら
売上合計 * 100.0 / 総計は 0 除算でNaNになります(kSQL のゼロ除算はエラーではなくNaN)。上の SQL はCASE WHEN 総計 = 0で構成比を 0、区分を C にしています。売上 0 の会社を ABC の対象から外す業務ルールなら、baseにHAVING SUM(b.売上) > 0を足す形でもよく、どちらにするかは記事の SQL のように先に決めておきます -
同額の会社が境界をまたぐとき。 この SQL は会社名で順番を確定するため、同額の会社でも 80% や 95% の境界をまたげば別区分になります。同額の会社を必ず同じ区分にしたい場合は、後述の
RANGEで同額を一群として扱うなど、別の業務ルールが必要です
差分 — 公開時(v3.77.0)は何が同じ SELECT に書けなかったか
集計とウィンドウ
-- v3.77.0 時点は NG(v3.81.0 以降は通る): GROUP BY と同じ SELECT にウィンドウを書く
SELECT a.会社名, SUM(b.売上) AS 売上合計,
       RANK() OVER (ORDER BY SUM(b.売上) DESC) AS 順位
FROM APP4149 AS b INNER JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
GROUP BY a.会社名
ParseError: フィールド名またはテーブル名が必要です(位置 62、トークン: 「SUM」)
OVER の中で集計関数を参照する形は、v3.77.0 では解析できませんでした。v3.81.0 以降はこの例がそのまま通り、OVER の中でグループキー・集計の別名・集計式・GROUPING() を参照できます。集計を base に切り出す書き方も引き続き使えます。
集計から ABC 区分までを 1 つの SELECT に書くと次の形です(v3.81.0〜)。結果は 3 段版と同じ 10 行です。
SELECT RANK() OVER (ORDER BY SUM(b.売上) DESC) AS 順位,
       a.会社名, a.顧客ランク, COUNT(*) AS 案件数, SUM(b.売上) AS 売上合計,
       CASE WHEN SUM(SUM(b.売上)) OVER () = 0 THEN 0
            ELSE ROUND(SUM(b.売上) * 100.0 / SUM(SUM(b.売上)) OVER (), 1) END AS 構成比,
       CASE WHEN SUM(SUM(b.売上)) OVER () = 0 THEN 0
            ELSE ROUND(SUM(SUM(b.売上)) OVER (ORDER BY SUM(b.売上) DESC, a.会社名
                                              ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                       * 100.0 / SUM(SUM(b.売上)) OVER (), 1) END AS 累積構成比,
       CASE WHEN SUM(SUM(b.売上)) OVER () = 0 THEN 'C'
            WHEN SUM(SUM(b.売上)) OVER (ORDER BY SUM(b.売上) DESC, a.会社名
                                        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                 * 100.0 / SUM(SUM(b.売上)) OVER () <= 80 THEN 'A'
            WHEN SUM(SUM(b.売上)) OVER (ORDER BY SUM(b.売上) DESC, a.会社名
                                        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                 * 100.0 / SUM(SUM(b.売上)) OVER () <= 95 THEN 'B'
            ELSE 'C' END AS 区分
FROM APP4149 AS b
INNER JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
GROUP BY a.会社名, a.顧客ランク
ORDER BY 売上合計 DESC, a.会社名
SUM(SUM(b.売上)) OVER () は「グループごとの合計を、さらに全グループで合計する」の意味で、集計の上にウィンドウを重ねる標準 SQL の書き方です。同じウィンドウ式を何度書いても評価は 1 回です。
同じ内容を CTE で分けてから 1 段で書くなら次の形です。集計を base に置き、次の SELECT でウィンドウを式と CASE の条件の中に書きます(CASE の条件の中は v3.83.0〜)。
WITH base AS (
  SELECT a.会社名, a.顧客ランク, COUNT(*) AS 案件数, SUM(b.売上) AS 売上合計
  FROM APP4149 AS b
  INNER JOIN APP4148 AS a ON b.顧客No_ = a.顧客No
  GROUP BY a.会社名, a.顧客ランク
)
SELECT RANK() OVER (ORDER BY 売上合計 DESC) AS 順位, 会社名, 顧客ランク, 案件数, 売上合計,
       CASE WHEN SUM(売上合計) OVER () = 0 THEN 0
            ELSE ROUND(売上合計 * 100.0 / SUM(売上合計) OVER (), 1) END AS 構成比,
       CASE WHEN SUM(売上合計) OVER () = 0 THEN 0
            ELSE ROUND(SUM(売上合計) OVER (ORDER BY 売上合計 DESC, 会社名
                                          ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                       * 100.0 / SUM(売上合計) OVER (), 1) END AS 累積構成比,
       CASE WHEN SUM(売上合計) OVER () = 0 THEN 'C'
            WHEN SUM(売上合計) OVER (ORDER BY 売上合計 DESC, 会社名
                                    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                 * 100.0 / SUM(売上合計) OVER () <= 80 THEN 'A'
            WHEN SUM(売上合計) OVER (ORDER BY 売上合計 DESC, 会社名
                                    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
                 * 100.0 / SUM(売上合計) OVER () <= 95 THEN 'B'
            ELSE 'C' END AS 区分
FROM base
ORDER BY 売上合計 DESC, 会社名
ウィンドウ結果と式
第 2 回で見たとおり、ROUND(SUM(x) OVER (), 1) や 件数 - LAG(件数) OVER (...) は v3.77.0 では ParseError でした。v3.81.0 以降は通ります(CASE の条件の中に直接書く形は、元が CTE のとき v3.83.0 以降。上の 2 つの SQL がその例です)。
ranked に 総計 と 累計 を列として出しておけば、最終段では 累計 * 100.0 / 総計 を CASE の条件の中にも書けます。段を分けるときは今もこの形です。
100.0 と ROUND
100.0 は、割合を計算していることを読み手に示す慣習として書いています。kSQL の算術は倍精度演算なので、100 と書いても整数除算にはなりません(7 / 2 は 3.5)。
ROUND(x, 1) で表示用に小数第 1 位へ丸めます。結果は 72 のように末尾の 0 が落ちて表示されるので、表示桁を揃えたいならダッシュボード側の書式で行います。
仕組み — EXPLAIN はウィンドウのフレームを表示する
[cte: ranked]
  mode:          FULL_SCAN
  window 総計: SUM OVER ()
    frame: PARTITION ENTIRE
  window 累計: SUM OVER (ORDER BY 売上合計 DESC, 会社名 ASC)
    frame: ROWS UNBOUNDED PRECEDING AND CURRENT ROW
  complete input: required (onLimit=truncate disabled)
  complete input reason: WINDOW_ORDER, AGGREGATE_WINDOW
ウィンドウは全件をインメモリで評価するので、常に FULL_SCAN で、完全入力が必要です(complete input reason: WINDOW_ORDER, AGGREGATE_WINDOW)。取得上限に達したら、部分的な順位や累計を返さずエラーになります。
frame: 行を見れば、累計が ROWS で評価されるか既定の RANGE かが分かります。既定のときは (既定) が付きます。
なお base の JOIN は第 1 回のとおり案件を FROM に置いてあるので、顧客側は join key prefilter: runtime candidate です。CTE の中でも結合キーの絞り込みは効きます。
落とし穴 — 既定の RANGE は同額の行に同じ累計を載せる
ROWS BETWEEN ... を書かずに SUM(売上合計) OVER (ORDER BY 売上合計 DESC) とすると、既定のフレームは RANGE になります。
RANGE は「ORDER BY の値が同じ行」を 1 つのグループとして扱い、グループ末尾の累計を全行に載せます。同額の会社が 2 社あると、両方に 2 社分足した累計が入り、累積構成比が飛びます。
実行すると警告が出ます。
累計 は既定フレーム(RANGE)で評価されます。ORDER BY の値が同じ行はすべて同じ値になります。
行ごとの値が必要なら ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW を明示するか、
ウィンドウの各パーティション内で、ORDER BY の値の組が入力行を一意に識別するとクエリ構造または
保証済みのデータ制約から確認できる場合に限り、この警告は無視できます。…
対処は 2 つで、両方やります。
-
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROWを明示する。 行ごとの累計になる -
ORDER BYをタイまで決める。ORDER BY 売上合計 DESC, 会社名のように、その表の中で一意になる列を足す。CTE には$idが無いので、元の集約キー(ここでは会社名)を使う。これが無いと同額の行の累計の割り当てが実行ごとに変わりうる
手元のデータでは同額は売上 0 の 2 社だけなので、RANGE でも累計は変わりません。同額かつ売上が 0 ではない会社が 2 社以上ある環境で、ROWS と RANGE の違いが表れます。「今は同額が無いから大丈夫」は、データが増えたときに静かに壊れる典型なので、最初から ROWS で書いておきます。
ただし RANGE の「同額を一群として扱う」は常に欠点ではありません。同額の会社を必ず同じ区分に入れたい ABC 分析なら、むしろ RANGE の挙動が望ましい場合があります。そのときは警告の意味を理解したうえで既定のままにし、ORDER BY にタイブレークを付けません。どちらにするかは業務ルールで決め、記事の本線は行ごとの累計(ROWS)にしています。
RANK と ROW_NUMBER
同額の 2 社は RANK で同じ 9 位になり、次の順位が飛びます(1, 1, 3 の規則)。連番が欲しいなら ROW_NUMBER() OVER (ORDER BY 売上合計 DESC, 会社名)、飛ばしたくないなら DENSE_RANK() です。ORDER BY を省くと RANK は全行 1 になります。
発展 — 明細+総計を 1 結果にする ROLLUP
ABC とは別の問い「会社別の明細に合計行を 1 つ足したい」は、GROUP BY ROLLUP で 1 文になります。
SELECT
  CASE WHEN GROUPING(会社名) = 1 THEN '合計' ELSE 会社名 END AS 会社名,
  COUNT(*) AS 案件数,
  SUM(売上) AS 売上合計,
  SUM(CASE WHEN 商談フェーズ = '受注' THEN 売上 ELSE 0 END) AS 受注済売上
FROM APP4149
GROUP BY ROLLUP(会社名)
ORDER BY GROUPING(会社名), 売上合計 DESC
| 会社名 | 案件数 | 売上合計 | 受注済売上 |
|---|---|---|---|
| 株式会社サイボウズ商事 | 5 | 20,700,000 | 8,100,000 |
| 株式会社キントーンシステムズ | 3 | 15,550,000 | 9,300,000 |
| …(10 社) | |||
| 合計 | 20 | 81,800,000 | 40,800,000 |
- 総計行の
会社名は空文字になるので、GROUPING(会社名) = 1でラベルを付けます。実データの空セルと区別するにはGROUPING(会社名) AS gを列に出します -
ORDER BY GROUPING(会社名), …で明細を先、総計を末尾に置けます - 階層小計は
ROLLUP(地域, 会社名)、出す段を選ぶならGROUPING SETS、全組み合わせならCUBE - 制約: grouping の項目は物理フィールドのみ(式・別名・CTE 列は不可)。ウィンドウ関数との併用は v3.81.0 以降は可。公開時の v3.77.0 では併用不可で、ABC の表と総計行を別のペイン(別の SQL)に分けていました
明細に順位と構成比を付けたまま合計行を足すなら、PARTITION BY GROUPING(会社名) で明細と合計を別の区画にします(v3.81.0〜)。合計行は自分だけの区画なので順位 1・構成比 100 になり、明細の構成比の分母には合計行が入りません。
SELECT
  CASE WHEN GROUPING(会社名) = 1 THEN '合計' ELSE 会社名 END AS 会社名,
  COUNT(*) AS 案件数,
  SUM(売上) AS 売上合計,
  RANK() OVER (PARTITION BY GROUPING(会社名) ORDER BY SUM(売上) DESC) AS 順位,
  ROUND(SUM(売上) * 100.0 / SUM(SUM(売上)) OVER (PARTITION BY GROUPING(会社名)), 1) AS 構成比
FROM APP4149
GROUP BY ROLLUP(会社名)
ORDER BY GROUPING(会社名), 売上合計 DESC
| 会社名 | 案件数 | 売上合計 | 順位 | 構成比 |
|---|---|---|---|---|
| 株式会社サイボウズ商事 | 5 | 20,700,000 | 1 | 25.3 |
| 株式会社キントーンシステムズ | 3 | 15,550,000 | 2 | 19.0 |
| …(10 社) | ||||
| 合計 | 20 | 81,800,000 | 1 | 100.0 |
PARTITION BY を付けずに SUM(SUM(売上)) OVER () と書くと、合計行の分まで分母に入って明細の構成比が半分になります。区画を切るのはそのためです。構成比のように PARTITION BY GROUPING(...) を式の中に書く形は v3.83.0 では内部エラーになり、B191 で修正しました(次の版から。順位のように列として出す形は v3.81.0 から通ります)。
落とし穴のまとめ
- 集計とウィンドウは同じ SELECT に書ける(v3.81.0〜)。 公開時の v3.77.0 では書けず、集計を CTE に切り出していた。段ごとに確かめたいときは今も切り出す
-
ウィンドウ結果は同じ SELECT の式に使える(v3.81.0〜。
CASE条件の中は元が CTE なら v3.83.0〜)。 公開時は列として出し、次の段で割る・丸める・CASEに使っていた -
累計は
ROWSを明示し、ORDER BYはタイまで決める。 既定RANGEは同額の行に同じ累計を載せる(警告が出る) -
OVER (...)とAS 別名は省略不可。 省略すると ParseError -
完全入力が必要。 順位・累計は 1 行欠けると全体がずれるため、上限到達時は部分結果ではなくエラーになる。上限は集約後の会社数(ここでは 10 行)ではなく、各物理アプリから取得する候補件数(案件 20 件・顧客の絞り込み取得分)に適用される。
EXPLAINでアプリごとのfetchを確認する(第 1 回) -
WHERE rn = 1は同じ SELECT では効かない。WHEREはウィンドウより先に評価される。CTE で段を分けてから絞る ROLLUPとウィンドウの併用は可(v3.81.0〜)。項目は物理フィールドのみ-
SUMは倍精度。 今回の売上合計 81,800,000 は、倍精度で整数を正確に表現できる安全整数の範囲(最大 9,007,199,254,740,991)内なので正確に扱えるが、大きな整数や小数を含む集計では表現誤差があり得る。構成比は表示用としてROUNDする -
ゼロ除算は
NaN。 総計 0 はCASE WHEN 総計 = 0で先に受ける
上の 1 つ目・2 つ目・7 つ目は v3.81.0(B184)と v3.83.0(B190)で kSQL 側が対応したものです。残りの項目(ROWS の明示とタイブレーク、OVER (...) と AS 別名、完全入力、WHERE rn = 1、倍精度、ゼロ除算)は v3.83.0 でも同じです。
運用に載せる
ABC の結果は列が多いので、無償版 kSQL Dashboard プラグイン では表のペインに置きます。SQL は上の 3 段 CTE をそのまま貼れます。
上位だけを棒グラフにするなら、base から ORDER BY 売上合計 DESC LIMIT 10 で 2 列(会社名・売上合計)を返す SQL を別ペインにします。
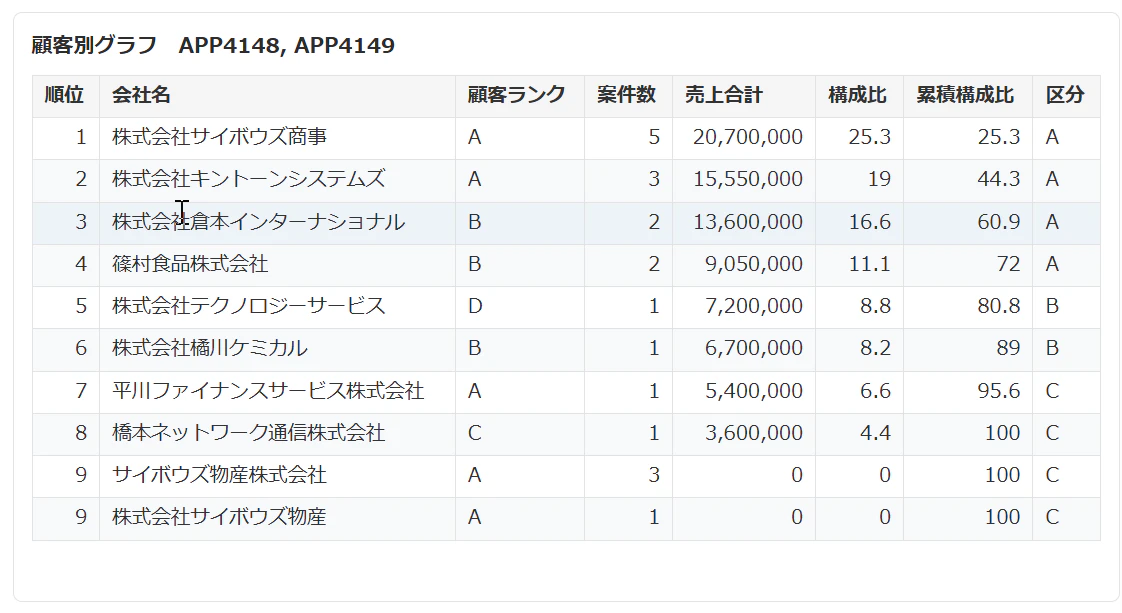
Dashboard の表ペインは金額にカンマを付けて表示します。割合の末尾の 0 が落ちる点(19.0 → 19)はプラグインと同じです。
SUM(x) OVER () で総計を全行に載せる書き方は、SET @total = (SELECT SUM(...)) の複文でも同じことができます。ただし CTE 1 文のほうが保存クエリにもダッシュボードにもそのまま載るので、単文で書けるならそちらです。
次回は第 4 回「データ品質を監査する」です。VALIDATE APPn で既存レコードのフォーム制約違反を洗い出し、重複と文字列の罠を扱います。
リポジトリ・ドキュメント:
- https://github.com/rex0220/kintone-sql-tools
- npm:
@rex0220/kintone-sql-tools(CLI / プラグイン / MCP サーバー同梱)