
結論(3 行)
- SFA パックの初期データは顧客 9 件・案件 20 件です。第 1 回の「上限 100 件で止まる」も第 3 回の完全入力も、この規模では体感できません。CSV を
IMPORTして検証用アプリを数百件にし、第 1〜5 回の SQL を流し直すのがこの回ですIMPORTは SQL にファイルパスを書きません。面(プラグインの「ファイルを選択」、CLI の--import-csv、MCP の inline)がソースを名前で渡したときだけ有効になります。BY NAMEでヘッダをフィールドコードに対応させ、ON DUPLICATEでレコード数と最終値を収束させ、VALIDATE ONLYで書き込み 0 回の事前検証ができます- 増量先は、サンプルデータ付きで別途追加した検証用の SFA パック。
IMPORTは書き込みです
前回(第 5 回: 安全に一括更新する)までの SQL は、私の環境では顧客 215 件で測っていました。この 215 件をどう作ったかが今回の内容です。読者は同じ手順で自分の検証環境を大きくし、第 1〜5 回を再測定できます。
課題
- 顧客管理の検証用アプリに、ランク・都道府県・業種を散らした顧客を 200 件足したい
- 取り込み前に不良行を止め、何度流しても増殖しない形にしたい
- 増やした後で、第 1 回の JOIN と第 3 回のウィンドウ関数が上限にどう当たるかを見たい
準備 — 検証用の SFA パックをもう一組追加する
IMPORT はレコードを書きます。SFA パックの顧客管理をそのまま使うと、前の回の答え合わせ(第 1 回の受注 8 件・ランク A 5 件・B 3 件、など)が崩れます。
kintone アプリストアから「SFA(営業支援)パック」を、サンプルデータを含めて検証用としてもう一組追加してください。顧客管理 9 件・案件管理 20 件と、その間のルックアップ関係(案件の 顧客No_ が顧客のレコード番号を指す)をまとめて保持できます。以下の APP4148 と APP4149 は、この検証用パックのアプリ番号へ読み替えてください。
顧客管理アプリだけを「ほかのアプリを再利用」で複製する方法は使えません。設定は引き継がれますがレコードは引き継がれず、複製先の顧客管理は空で始まります。さらに案件管理の 顧客No_ は元の顧客管理のレコード番号を指すので、複製先とは JOIN できません。
1. CSV を作る — GENERATE_SERIES で 200 行
表計算で作っても構いませんが、kSQL で作るとランクや都道府県の分布を SQL で制御できます。GENERATE_SERIES は連番も作れます。
WITH n AS (GENERATE_SERIES(1, 200) AS i)
SELECT CONCAT('サンプル株式会社 第', i, '支店') AS 会社名,
       CASE WHEN i % 4 = 0 THEN 'A' WHEN i % 4 = 1 THEN 'B' WHEN i % 4 = 2 THEN 'C' ELSE 'D' END AS 顧客ランク,
       CASE WHEN i % 3 = 0 THEN '東京都' WHEN i % 3 = 1 THEN '大阪府' ELSE '愛知県' END AS 都道府県,
       '製造業' AS 業種
FROM n
ORDER BY i
| 会社名 | 顧客ランク | 都道府県 | 業種 |
|---|---|---|---|
| サンプル株式会社 第1支店 | B | 大阪府 | 製造業 |
| サンプル株式会社 第2支店 | C | 愛知県 | 製造業 |
| サンプル株式会社 第3支店 | D | 東京都 | 製造業 |
| サンプル株式会社 第4支店 | A | 大阪府 | 製造業 |
レコード API は呼びません(records API: none)。この結果をファイルにするには、第 7 回で導入する CLI の --export-csv を使います。プラグインの結果表にはコピー機能が無いので、CLI 導入前なら画面の表を範囲選択して表計算ソフトに貼るか、最初から表計算ソフトで同じ列を作るほうが早いです。
ヘッダ行はフィールドコードにします(BY NAME で対応させるため)。会社名は重複禁止のキーなので、連番で一意にしてあります。
CSV は 2 つ用意します。
-
import_test.csv: 3 行。わざと不良行を混ぜ、VALIDATE ONLYと冪等性の確認に使う(次の 2 節・3 節) -
customers.csv: 生成した 200 行。実際の増量に使う(3 節の末尾)
会社名,顧客ランク,都道府県,業種
サンプル株式会社 第1支店,B,大阪府,製造業
サンプル株式会社 第2支店,C,愛知県,製造業
...
選択肢(顧客ランク A〜D、都道府県、業種)はフォームの選択肢に実在する値にします。実在しない値は次の VALIDATE ONLY で落ちます。
2. 取り込み前に検証する — IMPORT … VALIDATE ONLY
プラグインの実行画面のヘッダーにある「ファイルを選択」で CSV を選ぶと、拡張子を除いたファイル名がソース名になります(import_test.csv → import_test)。SQL にはその名前だけを書きます。
まず 3 行の import_test.csv で、構文と検証の動きを確かめます(スモークテスト)。
IMPORT INTO APP4148 (会社名, 顧客ランク, 都道府県, 業種)
FROM CSV import_test BY NAME
ON DUPLICATE (会社名)
CHECK WHEN 都道府県 = '' THEN '都道府県が空'
VALIDATE ONLY INTO #err;

SELECT 会社名, $err_field, $err_code, $err_message FROM #err
わざと不良行を 2 つ混ぜた 3 行の CSV で試した結果です。
| 会社名 | $err_field | $err_code | $err_message |
|---|---|---|---|
| 増量テスト 002 | 顧客ランク | ERR_CHOICE_INVALID | 顧客ランク に定義外の選択肢があります |
| (空) | 会社名 | ERR_KEY_EMPTY | UPSERT キー 会社名 は空にできません |
validatedRows: 3, validRows: 1, invalidRows: 2。ランク Z と、キーが空の行が落ち、書き込みは 0 回です。第 5 回の UPSERT … VALIDATE ONLY とまったく同じ流儀で、CHECK も付けられます。

ヘッダーの IMPORT CSV: import_test (UTF8) が、面から渡されたソース名と文字コードです。バッチの 1 文目のサマリ行に検証件数が出て、2 文目の #err が結果表になります。
IMPORT の各句の意味です。
| 句 | 意味 |
|---|---|
INTO APP4148 (列, …) |
取り込み先のフィールドコード |
FROM CSV customers |
面から渡されたソース名。パスは書かない |
BY NAME |
ヘッダ行をフィールドコードとして対応。cli-kintone の export 形式と互換。書き込み不可の既知列($id、作成者など)は無視、未知列は既定で拒否(IGNORE UNKNOWN COLUMNS で無視) |
ON DUPLICATE (会社名) |
キーが一致すれば更新、無ければ挿入(UPSERT)。無いと常に挿入 |
ENCODING SJIS |
Shift_JIS の CSV を読む。既定は UTF-8(BOM 可) |
SELECT code, CAST(amount AS NUMBER) AS 金額 |
BY NAME の代わりに、位置指定の列を式で変換して取り込む |
NO HEADER COLUMNS (…) |
ヘッダ無し CSV |
3. 取り込む
スモークテスト: 3 行で冪等性を見る
不良行を直した import_test.csv で、まず同じ VALIDATE ONLY を流して 3 行とも合格することを確かめます。

合格したら VALIDATE ONLY を外して同じ文を実行します。プラグインでは確認ダイアログに件数が出ます。
IMPORT INTO APP4148 (会社名, 顧客ランク, 都道府県, 業種)
FROM CSV import_test BY NAME
ON DUPLICATE (会社名)
UPSERT insertedCount: 3 updatedCount: 0
同じ CSV をもう一度流すと、ON DUPLICATE (会社名) が効いて更新に回ります。
UPSERT insertedCount: 0 updatedCount: 3
何度流してもレコード数は増えず、最終的な値も同じ状態に収束します。 ただし、2 回目も既存 3 件を更新しているため、更新日時や通知などの副作用まで止まるわけではありません。第 5 回の分類では「値は冪等だが、副作用は冪等ではない」形です。副作用まで止めたいなら、第 5 回のように「変わる行だけ」を一時テーブルで選んでから書きます。
ON DUPLICATE を付けない IMPORT は常に INSERT として動きます。この SFA パックでは会社名が重複禁止なので、同じ CSV の再実行は重複エラーになります。重複禁止でないフィールドをキー相当として扱っているアプリでは、同じデータが増殖します。
スモークテストの 3 件は、確認が済んだら DELETE FROM APP4148 WHERE 会社名 IN ('増量テスト 001', '増量テスト 002', '増量テスト 003') で消しておきます(手元でも削除済み)。
本番の増量: 200 行
同じ文のソース名を customers に変えて、200 行の customers.csv を取り込みます。
IMPORT INTO APP4148 (会社名, 顧客ランク, 都道府県, 業種)
FROM CSV customers BY NAME
ON DUPLICATE (会社名)
新しい検証用パックへ取り込んだ場合の想定結果は、1 回目が挿入 200・更新 0、2 回目が挿入 0・更新 200 です。取り込み後の件数は原本 9 件と合わせて 209 件になります。
SELECT COUNT(*) AS 顧客件数 FROM APP4148 -- 209
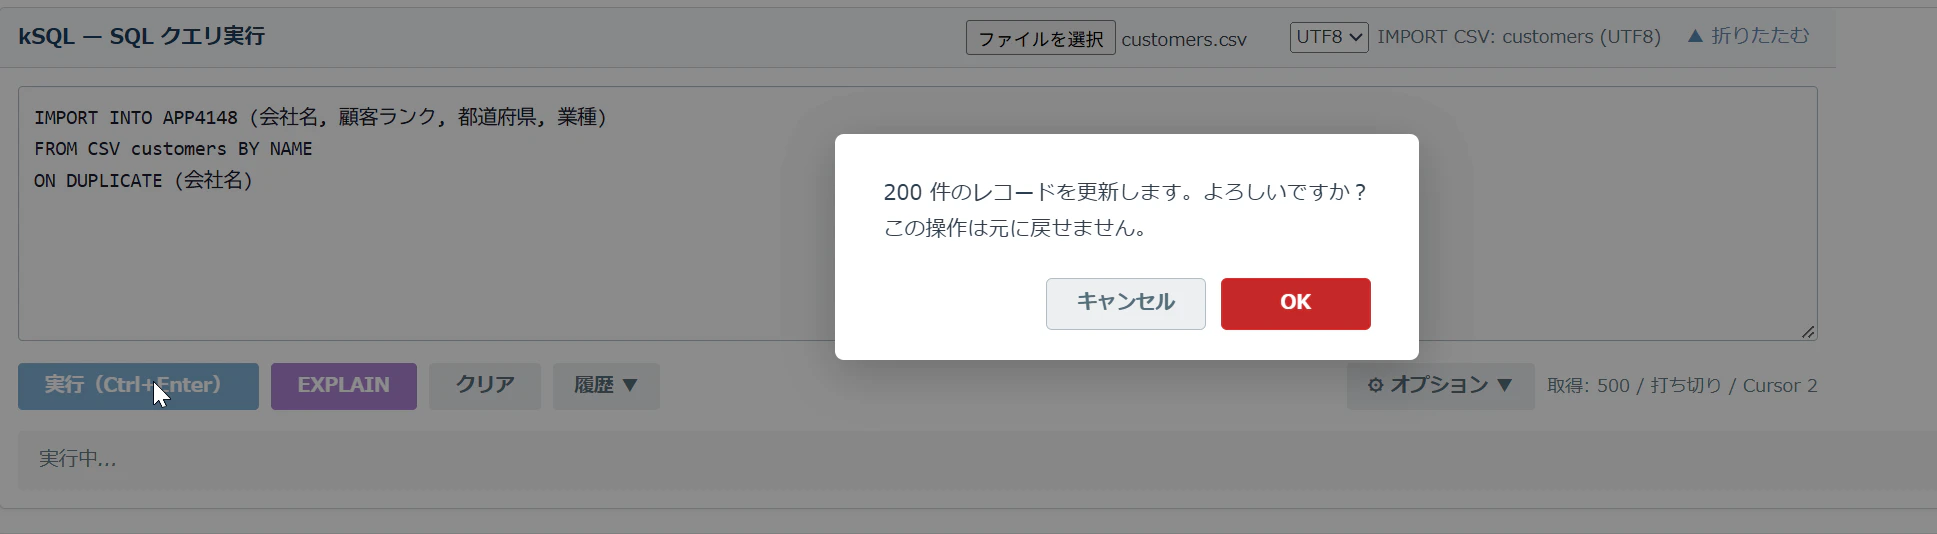
手元の環境は、この記事のために 200 件を取り直してはいません。以前に同じ形で増量した 200 件(サンプル株式会社 第 N 支店)に検証用のレコードが数件加わり、215 件になっています。そのため手元で customers.csv を流すと、確認ダイアログは挿入ではなく「200 件のレコードを更新します」になります(ON DUPLICATE が既存の 200 件に一致するため)。結果表を載せているのは 3 行のスモークテストだけです。
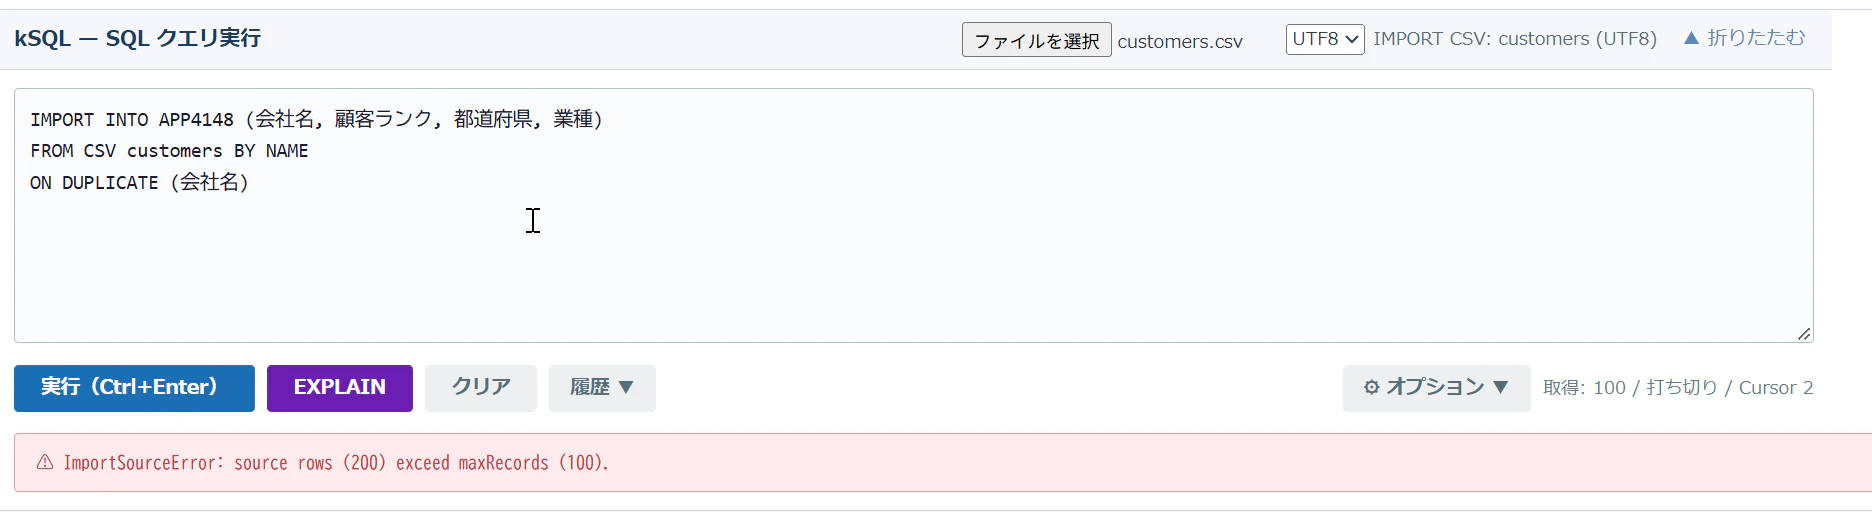
取り込み行数にも上限があります。最大取得件数を 100 に下げて同じ 200 行を流すと、読み込みの段で止まり、書き込みは 0 回です(図のヘッダー右の「取得: 100」がこの設定。初期値は 3,000 で、手元は普段 500 にしています)。上限の決まり方は面ごとに違います(落とし穴)。
EXPLAIN を見ると、IMPORT にはソース内のキー重複を書き込み前に検査する段があります。
IMPORT UPSERT INTO APP4148
  source:        CSV customers
  mapping:       BY_NAME
  key:           会社名
  disposition:   fail-fast
  writesKintone: true
  duplicateKey:  preflight before lookup/write (requires load)
第 5 回で「通常の UPSERT … SELECT にはソース内重複の事前検査が無い」と書きましたが、IMPORT にはあります。CSV に同じ会社名が 2 行あれば、書き込み 0 で文全体が止まります。
不良行を隔離して残りを流したいなら、VALIDATE ONLY の代わりに ON ERROR SKIP INTO #err REJECT LIMIT n です(第 5 回と同じ意味論)。
4. 増やした環境で測り直す
200 件を入れると顧客管理は 209 件(原本 9 件 + 200 件)になります。手元は検証用のレコードが数件多く 215 件で、以下の実測はその環境のものです。この状態で、第 1〜5 回の主張を確かめます。
第 1 回: FROM の順で成否が変わる
顧客ランク別の受注額(第 1 回の SQL)を、プラグインの「⚙ オプション → 取得」の「最大取得件数」を下げて実行します。
| 最大取得件数 | 顧客を FROM に | 案件を FROM に |
|---|---|---|
| 3,000(既定) | 成功 | 成功 |
| 100 | エラー(顧客 215 件 > 100) | 成功 |
| 10 | エラー | 成功(案件 8 件+顧客 8 件以下) |
9 件の環境では顧客 9 件・受注案件 8 件なので、どちらの向きでも上限 10 件で成功し、差が見えません。200 件を足して初めて「結合キーによる絞り込みが効く向き」が成否の差として現れます。
第 1 回: LEFT JOIN は上限に掛かりやすい
顧客起点の LEFT JOIN(案件の無い顧客を含める形)は、顧客 215 件を丸ごと取るので上限 100 件で止まります。「顧客を先に一時テーブルへ絞る」の 2 文(第 1 回)に直し、顧客を 100 件未満まで絞れば通ります。たとえば顧客ランクを A だけにすると、生成分 50 件と初期データ分に絞られます。A と B の両方では、生成分だけで 100 件あり、さらに初期データの A・B が加わるため 100 件を超えます。そのため、上限 100 件では 1 文目が止まります。
第 2 回: 期間集計の取得量は変わらない
今回増やしたのは顧客管理だけなので、案件管理だけを読む月別集計は 20 件のままです。相対日付の押し下げや 0 埋めの結果は変わりません。案件側の規模を増やした性能測定は、この回の対象外です。
第 3 回: ウィンドウ関数は完全入力
ABC 分析の 3 段 CTE は、base の JOIN で案件を FROM にしているので、上限 100 件で通ります(顧客は結合キーで絞られ、案件は 20 件)。上限 10 件にすると、集約後は 10 行しか無いのに FetchAllLimitError になります(実測。案件 20 件が上限を超えるため)。ウィンドウ関数は集約後の行数ではなく、その前の各アプリの取得件数で上限に当たります(第 3 回の落とし穴)。base を顧客起点に書き換えると、上限 100 件でも顧客 215 件で止まります。
v3.81.0 以降は第 3 回の集計とウィンドウを 1 つの SELECT に書けますが、集計ウィンドウが完全入力を要る点は同じで、上限の判定も変わりません。
第 4 回: 監査の対象件数
VALIDATE APP4148 は 215 件を全件取得します。上限を 100 件にすると、監査は部分結果を返さずエラーになります(実測: FetchAllLimitError: 取得件数が上限(100 件)を超えました。onLimit=truncate は無効化されるため)。監査対象を WHERE 作成日時 >= … で絞るか、上限を上げます。
第 5 回: 一括更新の件数ゲート
第 4 回で見つけた表記ゆれを書き戻す UPDATE … FROM に、dmlMaxRows を対象件数より小さく設定すると、書き込み前に止まります。200 件を対象にした更新は、ASSERT (SELECT COUNT(*) FROM #fix) BETWEEN 1 AND 300 のように上限を明示してから流します。
落とし穴
-
IMPORTは書き込み。 原本ではなく、サンプルデータ付きで別途追加した検証用の SFA パックへ。取り込み前にVALIDATE ONLYを行い、本実行ではON DUPLICATEを付けて、レコード数と最終値が再実行で収束する形にする。再実行でも既存行は更新されるため、更新に伴う副作用には注意する -
ソースは面が渡す。 SQL にパスを書けない。プラグインは「ファイルを選択」、CLI は
--import-csv name=path、MCP は inline。1 ソース 10 MiB まで -
BY NAMEのヘッダはフィールドコード。 ラベルではない(第 0 回)。未知列は既定で拒否 -
取り込み行数の上限は面で違う。 プラグインは「最大取得件数」(初期 3,000)、CLI は
--max-records(既定 500)。MCP では通常の書き込み IMPORT はdmlMaxRowsを基準に解決し、VALIDATE ONLYとON ERROR SKIPは runtime のmaxRecordsを使う -
選択系の値はフォームの選択肢に実在すること。 実在しない値は
ERR_CHOICE_INVALID -
ON DUPLICATEのキーは書き込み可能な一意フィールド。$idは不可。キーが空の行はERR_KEY_EMPTY -
サブテーブルの取り込みは面が限られる。 JSON のネスト配列は新規 INSERT または
ON DUPLICATE付き UPSERT に対応し、既存レコードではサブテーブルを全置換する。CSV の*形式はIMPORT UPDATE専用で全置換。MCP はサブテーブルの書き込みを常に拒否する - 添付ファイルは取り込めない。 cli-kintone を使う
-
Shift_JIS の CSV は
ENCODING SJIS。 逆に kSQL から Shift_JIS で書き出す話は第 7 回
運用に載せる
検証用アプリの増量は一度きりなので、プラグインで手動実行すれば十分です。
定期的に外部 CSV を取り込む運用(--import-csv でファイルを渡し、ON ERROR SKIP で不良行を隔離し、終了コードで検知する)は CLI の役割で、第 7 回で扱います。
次回は第 7 回「CLI を導入して定期運用に載せる」です。ここまでプラグインで済ませてきた作業を、ファイル書き出し・環境切替・自動実行のためにコマンドラインへ移します。
リポジトリ・ドキュメント:
- https://github.com/rex0220/kintone-sql-tools
- npm:
@rex0220/kintone-sql-tools(CLI / プラグイン / MCP サーバー同梱)