
AWS EC2のCPU高負荷をCloudWatch・EventBridge・SSMで自動調査してメール通知する仕組みを作ってみた
はじめに
前回の記事では、AWS上のWebサーバーで発生した高負荷を調査するため、Linuxの情報やApacheのアクセスログを収集するスクリプトを作成しました。
今回はその続編として、作成したスクリプトをAWSのサービスと連携し、障害調査の自動実行を目指します。
アラート検知後の調査では、CPU使用率やロードアベレージ、メモリ使用状況に加え、Apacheのアクセスログからアクセス数やアクセス元IPアドレスなどを確認することがあります。
そこで今回は、CloudWatchでCPU高負荷を検知した際に、AWS Systems Manager(SSM)で障害調査スクリプトを自動実行し、調査レポートをメール通知する仕組みを構築しました。
実際にEC2へ負荷をかけ、アラーム検知からレポート受信まで検証しています。
1. 構成
| サービス | 役割 |
|---|---|
| EC2 | 調査対象サーバー |
| CloudWatch | CPU使用率の監視・アラーム検知 |
| EventBridge | ALARM状態への遷移を検知 |
| Systems Manager | Run Commandによる調査スクリプトの実行 |
| SNS | 調査レポート・アラーム通知 |
| k6 | 負荷試験 |
2. 検証環境
| 項目 | 内容 |
|---|---|
| リージョン | ap-northeast-3(大阪) |
| OS | Amazon Linux 2023 |
| インスタンスタイプ | t3.micro |
| vCPU / メモリ | 2 vCPU / 約1GiB |
| Webサーバー | Apache HTTP Server |
| PHP | PHP-FPM |
| 負荷試験ツール | k6 |
調査対象のEC2とは別に負荷試験用EC2を用意し、k6からHTTPリクエストを送信します。
3. 障害調査スクリプト
今回作成したスクリプトは2つです。
incident-check.sh
サーバーの状態やApacheアクセスログを調査し、レポートを生成します。
主な調査項目は以下です。
| 分類 | 調査内容 |
|---|---|
| サーバー負荷 | ロードアベレージ、CPU、メモリ、ディスク |
| プロセス | CPU使用率上位プロセス |
| リソース履歴 | sarによるCPU・ロードアベレージの推移 |
| Apacheアクセス | 総アクセス数、1分ごとのアクセス数 |
| アクセス分析 | 接続元IP、URL、User-Agent、HTTPステータス、HTTPメソッド |
アクセスログは以下を解析します。
/var/log/httpd/access_log
調査レポートは以下に保存します。
/var/log/incident-check/
ファイル名には調査日時を含め、実行ごとに別ファイルとして保存します。
incident_YYYYMMDD_HHMMSS.log
incident-report-mail.sh
こちらは、調査スクリプトを実行し、生成したレポートをSNS経由でメール通知するためのスクリプトです。
incident-report-mail.sh
        │
        ▼
incident-check.sh
        │
        ▼
調査レポート生成
        │
        ▼
SNSへ送信
        │
        ▼
メール通知
4. CloudWatchアラームの設定
EC2のCPU使用率を監視するCloudWatchアラームを作成しました。
検証時の設定は以下のとおりです。
| 項目 | 設定 |
|---|---|
| メトリクス | CPUUtilization |
| 統計 | Average |
| しきい値 | 30%超過 |
| 期間 | 5分 |
| データポイント | 1 out of 1 |
| 欠落データの処理 | 欠落データとして処理 |
今回はEC2の基本モニタリングを使用しています。
アラームの状態変化はSNS経由でメール通知します。
- ALARM:CPU使用率がしきい値を超過
- OK:CPU使用率がしきい値以下に回復

5. EventBridgeとSSMの連携
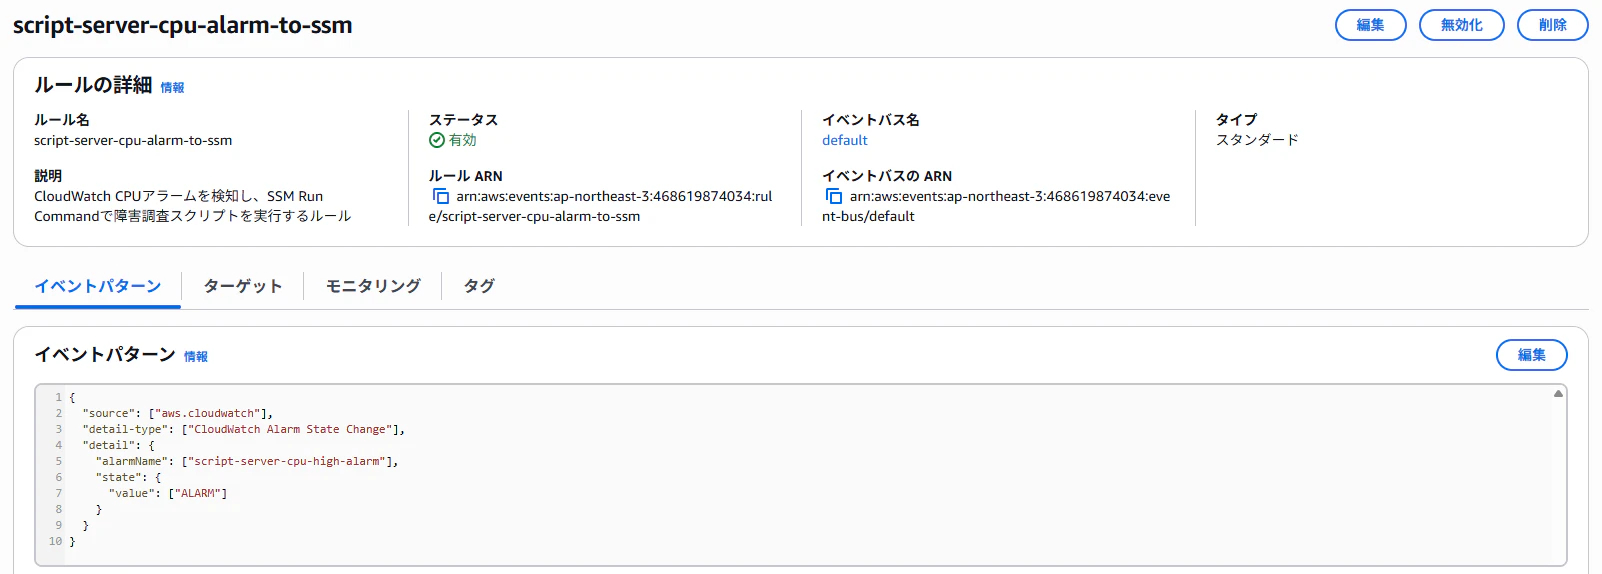
CloudWatchアラームがALARM状態になった際に、EventBridgeからSSM Run Commandを実行するように設定しました。
EventBridgeのイベントパターン
{
  "source": ["aws.cloudwatch"],
  "detail-type": ["CloudWatch Alarm State Change"],
  "detail": {
    "alarmName": ["script-server-cpu-high-alarm"],
    "state": {
      "value": ["ALARM"]
    }
  }
}
対象のアラームがALARM状態になった場合のみ、後続の処理を実行します。
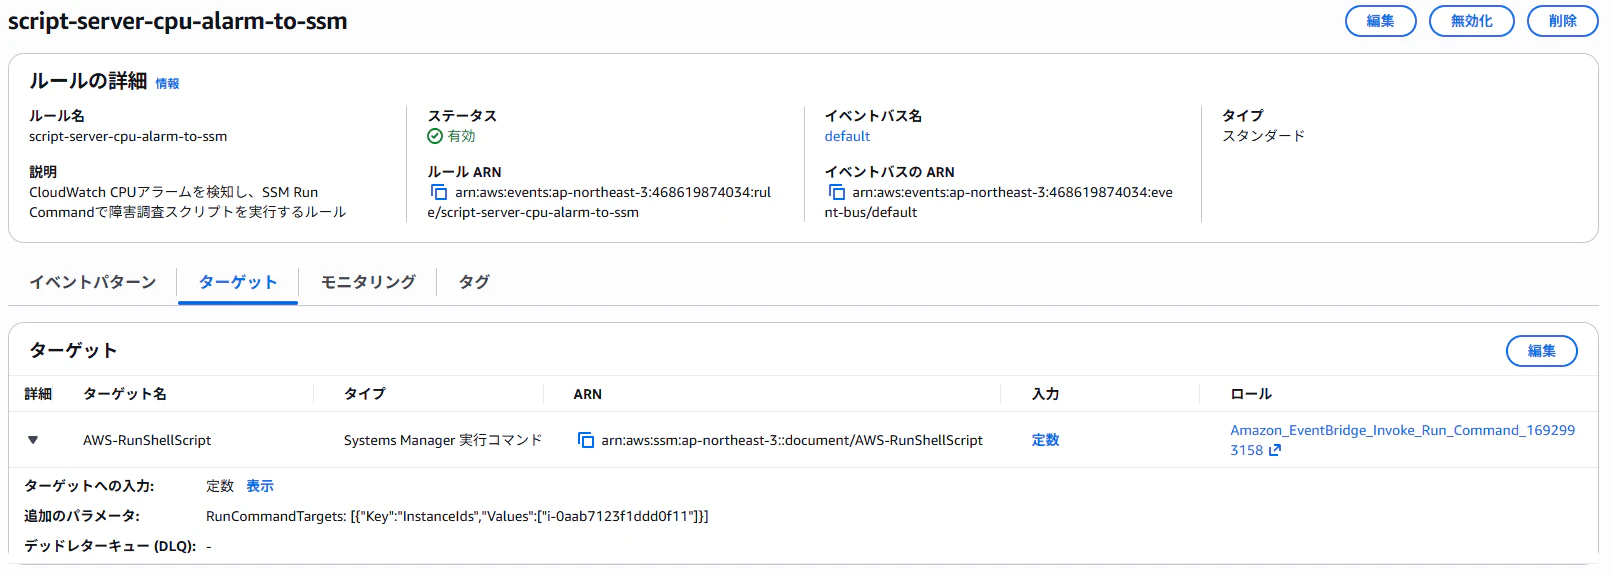
SSM Run Command
EventBridgeのターゲットには、AWS-RunShellScript を指定しました。
実行するコマンドは以下です。
{
  "executionTimeout": ["3600"],
  "commands": [
    "/usr/local/bin/incident-report-mail.sh"
  ]
}
これにより、CloudWatchアラームを起点にEC2上で調査スクリプトを実行します。
6. 実際に負荷をかけて検証する
設定完了後、k6を使用してEC2へHTTPリクエストを送信しました。

CloudWatchアラームの検知
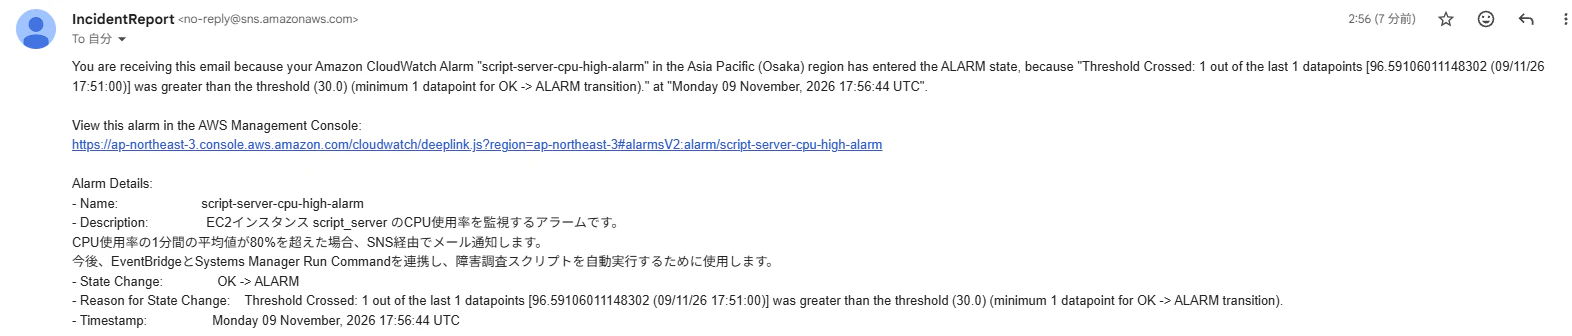
負荷試験中にCPU使用率がしきい値を超過し、CloudWatchアラームがALARM状態へ遷移しました。
通知メールでは、CPU使用率が約96.59%となり、設定した30%のしきい値を超過したことを確認できました。
SSMによる自動調査
EventBridgeがALARM状態への遷移を検知し、SSM Run Commandが実行されました。
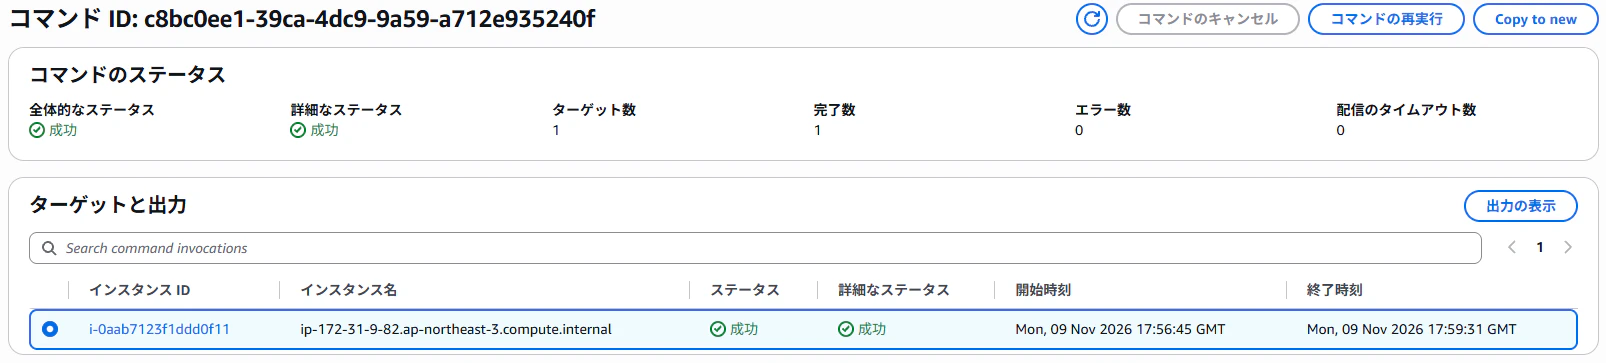
その後、調査スクリプトが起動し、レポートがメールで届きました。

調査レポート
今回の負荷試験で受信したレポートでは、以下の情報を確認できました。
ロードアベレージ
1分平均 / 5分平均 / 15分平均 : 6.41 / 3.05 / 1.29
Apacheアクセス状況では、k6からのアクセスが集計されていました。
接続元IP       : 13.208.38.137
総アクセス数   : 773712件
リクエスト     : GET /
ステータス     : 200
User-Agent     : Grafana k6/2.3.0
CPU使用状況だけでなく、Apacheのアクセス数やアクセス元IP、URLなども確認できることを確認しました。
これらの情報を組み合わせることで、アクセス集中の有無や、負荷発生時のサーバーの状態を把握するための手がかりになります。
OK通知
負荷試験終了後、CPU使用率が低下し、CloudWatchアラームがOK状態へ回復しました。
OK状態への遷移についても、SNS経由でメール通知されることを確認しました。

7. 検証中に発生した問題
INSUFFICIENT_DATA
最初の検証では、CloudWatchアラームが INSUFFICIENT_DATA 状態になることがありました。
EC2の基本モニタリングでは、CPU使用率のメトリクスが5分間隔で提供されます。そのため、負荷試験の実行タイミングや評価期間によっては、アラームの評価に必要なデータが揃わない場合があります。
今回はアラームの評価期間を5分に設定し、再検証しました。
SSM Run Commandの失敗
高負荷時には、SSM Run Commandが以下のエラーで失敗することもありました。
document process failed unexpectedly:
ipc messaging received timeout signal
高負荷時にSSMの処理がタイムアウトした可能性がありますが、原因は断定できていません。
その後、EC2を再起動し、SSMからコマンドを実行できる状態に戻しました。
8. 検証結果
| 検証項目 | 結果 |
|---|---|
| CPU高負荷の検知 | 成功 |
| CloudWatchのALARM通知 | 成功 |
| EventBridgeによるイベント検知 | 成功 |
| SSM Run Commandの実行 | 成功 |
| 障害調査スクリプトの実行 | 成功 |
| 調査レポートのメール通知 | 成功 |
| CloudWatchのOK通知 | 成功 |
実際に負荷をかけた状態で、CloudWatchのアラーム検知から調査レポートの受信まで、一連の動作を確認できました。
おわりに
今回は、CloudWatchでCPU高負荷を検知した際に、EventBridgeとSSM Run Commandを連携させて障害調査を自動実行する仕組みを構築しました。
CPU使用率やロードアベレージに加え、Apacheのアクセスログも解析することで、負荷発生時のサーバーやアクセス状況を確認できるレポートを作成しました。
障害発生時に必要な情報を自動で取得することで、初動調査の効率化につなげられることを確認できました。