
はじめに
ゲームをサービスする上で、近接ブルーザー、遠距離魔法使い、スピード型アサシンなど、多様なキャラクターが登場し、それぞれの特性に合わせてプレイすることは非常に重要です。もしゲームAI(ボット)やNPCを強化学習(RL)で実装しようとした場合、これら多様なキャラクターの特性をどのように学習させるべきでしょうか?
本記事では、多数のキャラクターを制御する際に直면する現実的な課題と、それを FiLM (Feature-wise Linear Modulation

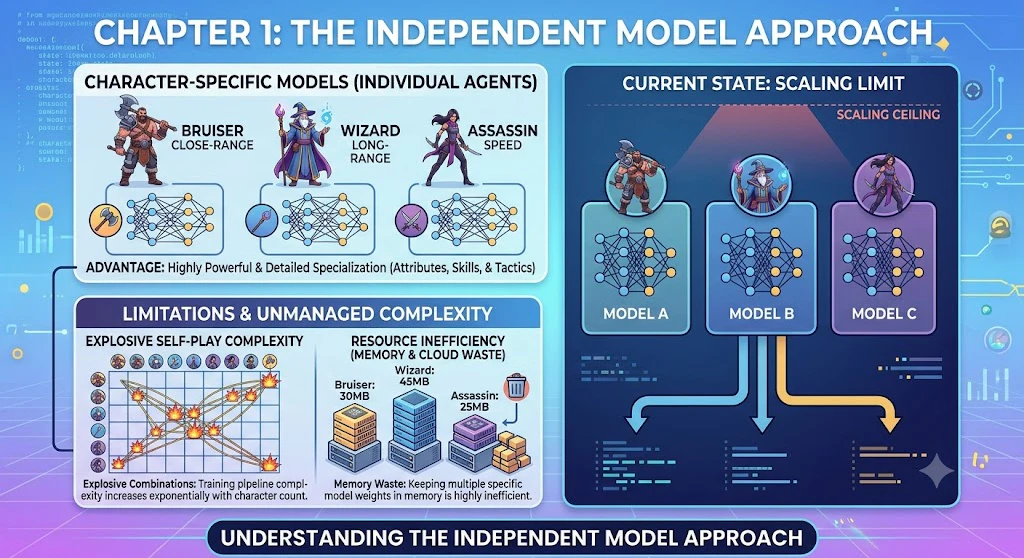
キャラクターごとに専用モデルを作成する場合(独立モデル方式)
最も直感的な方法は、キャラクターごとに個別のニューラルネットワークモデルを構築することです。
メリット
- キャラクターごとにそれぞれの特性(強み、弱み、スキルセット)を非常に強力かつ緻密に実装できます。
デメリット(限界)
Self-Playの複雑度の爆発:
- 今後の性能向上のためにキャラクター間でSelf-Play(自己対戦)を行うと仮定してみましょう。キャラクターの数が増えるにつれてマッチアップの組み合わせの数が幾何級数的に増加し、学習パイプラインが手に負えなくほど複雑になります。
リソース管理の非効率性:
- キャラクターごとに数十MB単位のモデル重みを個別にメモリにロードする必要があるため、実際のゲームクライアントやサーバー環境においてリソースの無駄遣いが非常に激しくなります。
単一のモデルで複数のキャラクターをコントロールする場合(単一モデル方式)
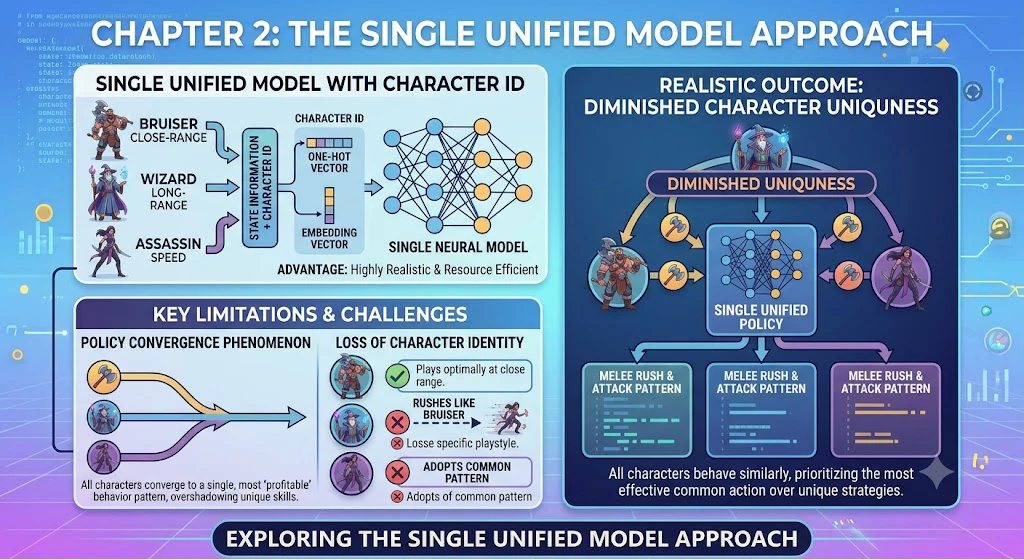
実際のサービス環境と効率性を考慮すると、1つのモデルですべてのキャラクターを制御するのが最も現実的です。
一般的なアプローチ: モデルが現在操作しているキャラクターを識別できるように、状態(State)情報にキャラクターIDをOne-hotエンコーディングやEmbeddingベクトルの形式で追加して学習させます。
デメリット(限界):
- ポリシー収束(Policy Convergence)現象: この方式を使用すると、「最も強い、またはスコアを獲得しやすいキャラクターの行動様式」へと全体の方針(ポリシー)が収束してしまいつつある可能性が非常に高くなります。結果として、遠距離キャラクターが近距離キャラクターのように突撃して戦うなど、キャラクター固有の個性を活かすことが難しくなります。
解決策:FiLM(Feature-wise Linear Modulation)の導入
単一モデルの効率性を確保しつつキャラクターごとの個性を活かすため、画像処理やVQA(Visual Question Answering)などの条件付き(Conditional)処理でよく使用されるFiLM構造をRLネットワークに導入してみました。

FiLMは簡単に言うと、与えられた条件(ここでは「現在操作しているキャラクターの情報」)に基づいて、ニューラルネットワークの中間層の特徴量(Feature Map)に対してスケーリング(Scaling)とシフト(Shifting)を行う役割を果たします。つまり、キャラクターが切り替わるたびに、単一ニューラルネットワーク内部の演算の重みの流れをそのキャラクターに合わせて柔軟に調節する仕組みです。
適用結果と体感(実験結果)
FiLM構造を適用して強化学習を進めた結果、目に見えてドラマチックなプレイスタイルの変化を確認することができました。
特性に合わせたプレイ: 近接キャラクターを操作させると、相手の隙を突いて積極的に突撃し、インファイトを実行します。
相手に応じた柔軟な対処: 単に自分のキャラクターの特性だけに固執するのではなく、対戦相手が遠距離型なのか近距離型なのかによって全く異なる距離調整や、趣向を凝らしたプレイスタイルを見せてくれました。まるで実際のプレイヤーのように相性を理解して戦っているような印象を受けました。
おわりに
結論として、多様な特性を持つエージェントたちを学習させる際、モデル統合の効率性とキャラクター固有の個性という2つのメリットを両方とも手に入れたい場合、FiLMの導入は非常に素晴らしい選択肢です。マルチエージェント環境や多様な条件付きアクションが必要なRL環境を構築されている方に、この方法論が役立つことを願っています。