
はじめに
最近、VLA (Vision-Language-Action) モデルがロボット工学の分野で大きな注目を集めています。 ふと、エンジニアとして一つの素朴な疑問が浮かびました。
「もし今、この巨大なVLAモデルを、我が家のロボットに直接接続したらどうなるだろう?」
結論から言えば、おそらくロボットはパニックに陥るか、物理的に転倒してしまうでしょう。
なぜVLA直結ではうまくいかないのか?
理由はシンプルで、「脳(AI)」と「身体(ロボット)」の動作周波数における致命的なミスマッチがあるからです。
脳 (VLA) は推論速度が遅く、抽象的です。また、物理法則を無視した幻覚(Hallucination)を見ることもあります。 対して身体 (Robot) は0.001秒(1kHz)単位での精密かつ安全な制御を要求します。
このギャップを埋めるためには、脳と身体の間に「脊髄」のような役割を果たすミドルウェアが必要です。具体的には、強化学習(RL)の柔軟な判断力と、ルールベース(Rule-Based)の堅牢性を組み合わせたハイブリッドシステムです。
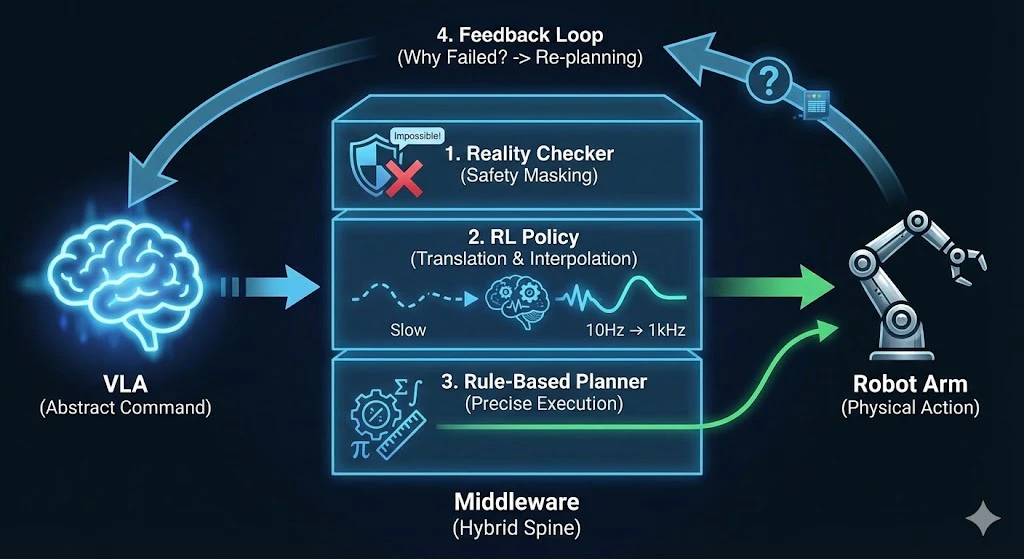
提案:ハイブリッド・ミドルウェアの4層構造
-
Reality Checker (安全装置) VLAが生成したコマンドが「物理的に実行可能か」を一次検査します。もしVLAが物理法則を無視した危険な命令(例:可動域外への移動)を出した場合、実行前に「それは不可能です(Action Masked)」と遮断します。
-
RL Policy (状況判断・補間) ここが核心部分です。RLは直接アームを動かすのではなく、VLAの抽象的な命令を具体的な制御パラメータに翻訳する「熟練した助手」として機能します。「今は速度を落とすべき」「この角度からアプローチした方が安全」といった判断を行い、10Hz程度のVLAの指令を1kHzの滑らかな軌道(Trajectory)に補間します。
-
Rule-Based Planner (精密実行) RLが決定した戦略に基づき、実際のロボットアームは数学的に検証されたモーションプランニング(IK, PID制御など)によって動かされます。これにより、RL特有の確率的な挙動を抑制し、1000Hzの制御ループ内での絶対的な安定性を担保します。
-
Feedback Loop (学習と再計画) もしアクションが失敗した場合(例:特異点による到達不能)、単にエラーを吐くのではなく、「なぜ失敗したか(Why)」という物理的な理由をVLAにフィードバックします。これにより、VLAはコンテキストを理解し、再計画(Re-planning)を行うことが可能になります。
おわりに
実際の社会実装はさらに複雑でしょうが、「賢い脳(VLA)」と「頑強な身体(ルールベース)」を繋ぐ架け橋となるのは、「柔軟な判断力を持った脊髄(RL)」であると確信しています。
VLA時代のロボット制御において、皆様はどのようなアプローチが有効だと考えますか? ぜひコメントで議論できれば幸いです。